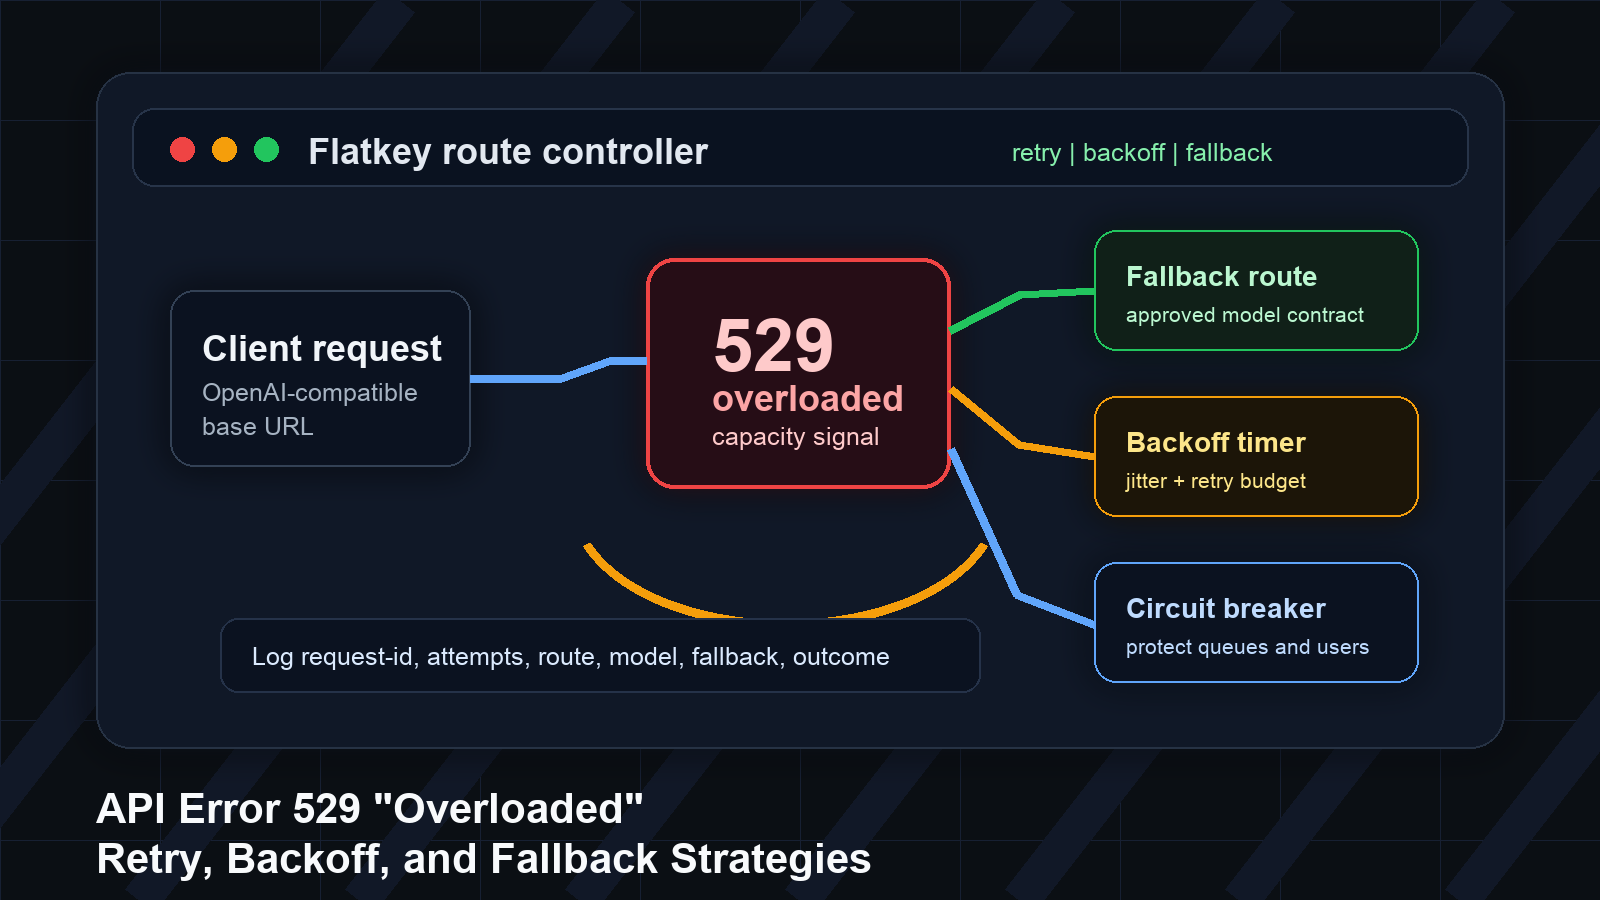
Se os seus logs de produção mostrarem 529 overloaded_error, o provedor está a dizer que a API está temporariamente sobrecarregada. Na documentação da API Claude da Anthropic, 529 - overloaded_error significa "A API está temporariamente sobrecarregada", e a documentação observa que erros 529 podem acontecer durante picos de tráfego entre todos os utilizadores.
Isso faz com que Erro de API 529 "Sobrecarga": estratégias de retry, backoff e fallback seja diferente de um pedido malformado, de uma chave de API inválida ou de um problema normal de quota. A primeira resposta não deve ser "alterar o prompt" ou "comprar mais quota". A primeira resposta deve ser um playbook controlado de fiabilidade: classificar a falha, voltar a tentar apenas dentro de um orçamento, proteger os utilizadores de tempestades de retries e decidir quando um caminho de fallback é mais seguro do que esperar.
Este guia foi escrito para equipas de produto e de plataforma de IA que executam cargas de trabalho LLM, agent ou multimodais em produção. Ele fornece uma matriz prática de ação para erros, um orçamento de retry, um padrão de backoff e um fluxo de decisão de fallback que pode copiar para um runbook de incidentes.
Resposta rápida
Para Erro de API 529 "Sobrecarga": estratégias de retry, backoff e fallback, use esta política padrão:
- Trate
529 overloaded_errorcomo um sinal transitório de capacidade do provedor, e não como um bug de validação do cliente. - Volte a tentar pedidos idempotentes ou apenas de leitura com backoff exponencial e jitter.
- Respeite
retry-afterquando o provedor o enviar. - Pare após um pequeno orçamento de retries, normalmente duas ou três tentativas para tráfego interativo.
- Não volte a tentar cegamente chamadas de ferramentas não idempotentes, ações de escrita, compras, emails ou qualquer coisa que possa ter causado efeitos colaterais.
- Abra um circuit breaker quando os 529 se agruparem por provedor, modelo, endpoint ou região.
- Use fallback apenas quando o modelo alternativo puder satisfazer o mesmo contrato de produto.
- Registe
request-id, modelo, rota, contagem de retries, resultado final e impacto visível para o utilizador.
Em outras palavras: volte a tentar por pouco tempo, reduza a pressão do sistema, faça failover quando a equivalência for aceitável e pare quando o pedido já não for seguro de repetir.
Porque acontece o Erro de API 529 Overloaded
529 overloaded_error é uma condição de capacidade. Normalmente significa que o seu pedido chegou ao provedor, mas o lado do provedor está demasiado ocupado para o atender naquele momento. A Anthropic documenta isto separadamente de 429 rate_limit_error. Essa distinção importa:
| Família de erro | Significado típico | Ação inicial do responsável |
|---|---|---|
400, 401, 403, 404 |
Problema de pedido, credenciais, permissões ou nome do modelo | Corrija o pedido; não volte a tentar sem alterações |
429 |
Limite de taxa, limite de aceleração ou teto de gastos | Reduza a velocidade, inspecione a quota e retry-after, altere o formato do tráfego |
500, 502, 503, 504 |
Falha do provedor ou falha de rede/do lado do servidor | Volte a tentar com backoff exponencial se for seguro |
529 overloaded_error |
Provedor sobrecarregado por tráfego elevado | Volte a tentar com backoff, depois ative circuit breaker ou fallback |
Uma 529 pode aparecer durante um pico de tráfego em toda a provedora, mesmo que sua própria carga de trabalho não tenha feito nada incomum. Mas, se você estiver lançando um novo recurso, executando um lote ou enviando um enxame repentino de agentes, também deve verificar se a sua subida de tráfego causou pressão local ou comportamento de limitação por aceleração.
Matriz de Ação por Erro
Use esta matriz antes de alterar o código em pânico.
| Sinal nos logs | Fazer retry? | Aplicar backoff? | Fazer fallback? | O que registrar |
|---|---|---|---|---|
| Uma única 529 em uma solicitação de chat somente leitura | Sim, brevemente | Sim, com jitter | Não na primeira falha | request-id, modelo, rota, tentativa |
| 529s repetidas para um modelo | Sim, até o orçamento expirar | Sim | Sim, se a alternativa for compatível com o contrato | modelo de fallback, gate de qualidade, impacto no usuário |
| 529s em todas as rotas da Claude | Limitado | Sim | Talvez, somente para rota não-Claude aprovada | status da provedora, estado do circuito |
| 529 após saída parcial de streaming | Normalmente sem retry transparente | Sem replay cego | Parar ou pedir ao usuário para regenerar | tokens parciais, último evento, cópia visível ao usuário |
| 529 durante execução de ferramenta | Só se a ferramenta for idempotente | Sim | Não até que os efeitos colaterais sejam reconciliados | nome da ferramenta, chave de idempotência, estado externo |
| 529 durante lote em segundo plano | Sim, mais lentamente | Sim, janela mais ampla | Sim, se o SLA exigir isso | idade da fila, idade da repetição, contagem descartada |
| 529 mais deadline do usuário excedido | Não | Não | Talvez, se ainda for útil | classe de timeout, motivo do fallback |
Esta é a parte que a maioria das páginas genéricas de erro omite: um modelo sobrecarregado não é apenas um status HTTP. É uma decisão de produto sobre trabalho duplicado, latência, qualidade de saída e confiança do usuário.
Uma Política Segura de Retry Para 529
Comece com orçamentos de retry separados para cargas de trabalho interativas e em segundo plano.
| Carga de trabalho | Primeira política sugerida |
|---|---|
| Chat ou autocomplete voltado ao usuário | 2 retries, limitados abaixo do timeout voltado ao usuário |
| Etapa de planejamento do agente | 2-3 retries, parar antes que a execução da ferramenta fique obsoleta |
| Resumo em segundo plano | 3-5 retries, com consciência da fila e backoff mais amplo |
| Avaliação em lote | Retry a partir da fila com limites de idade e tratamento de dead-letter |
| Chamada de ferramenta do lado de escrita | Retry apenas com proteção de idempotência e reconciliação |
A forma mais simples de retry é backoff exponencial com jitter:
function backoffMs(attempt: number) {
  const base = 250;
  const cap = 8_000;
  const exponential = Math.min(cap, base * 2 ** attempt);
  const jitter = Math.floor(Math.random() * exponential * 0.4);
  return exponential + jitter;
}
Use valores pequenos para produtos interativos. Uma mensagem de chat que faz retry por 60 segundos pode ser tecnicamente resiliente, mas ainda assim parecer quebrada para o usuário. Para filas em segundo plano, use uma janela de backoff mais ampla e preserve o item de trabalho para processamento posterior, em vez de sobrecarregar a provedora.
Respeite o Retry-After, mas não dependa dele
Algumas APIs enviam cabeçalhos retry-after para limites de taxa ou falhas transitórias. A documentação da Anthropic diz que os SDKs oficiais fazem retry de falhas transitórias com backoff exponencial, duas vezes por padrão, e respeitam retry-after quando presente. O seu próprio controlador deve fazer o mesmo quando você contorna ou encapsula o SDK.
Mas não construa uma política que só funcione quando retry-after existir. Uma resposta 529 pode nem sempre vir com um tempo de espera útil. Seu controlador de fallback ainda precisa de:
- um valor máximo de tentativas,
- um orçamento máximo de tempo de execução,
- um circuit breaker por rota,
- um limite de idade da fila,
- e um modo final de falha visível ao usuário.
Evite tempestades de retry
A pior resposta à sobrecarga do provedor é o tráfego de retry sincronizado. Se cada worker tentar novamente imediatamente, você transforma um incidente do provedor em um incidente maior.
Adicione estes controles:
| Controle | Por que isso importa |
|---|---|
| Jitter | Impede que todos os clientes tentem novamente no mesmo instante |
| Limites de concorrência por rota | Evita que um modelo sobrecarregado consuma todos os slots de worker |
| Orçamento de retry | Impede loops infinitos e gastos inesperados |
| Circuit breaker | Tira falhas repetidas do caminho crítico |
| Backpressure da fila | Desacelera os produtores quando os consumidores não conseguem avançar |
| Estado visível ao usuário | Informa aos usuários quando o sistema está tentando novamente ou degradado |
As orientações de retry-with-backoff da AWS fazem o mesmo ponto operacional: retries ajudam falhas transitórias, mas retry demais pode aumentar a contenção e a degradação do serviço.
Quando usar fallback em vez de retry
Fallback não é o mesmo que retry. Um retry pede à mesma rota que tente novamente. Um fallback muda a rota, o provedor, o modelo, a região ou a capacidade.
Use fallback quando todas as quatro condições forem verdadeiras:
- A rota principal está falhando repetidamente com 529 ou erros transitórios relacionados.
- O usuário ou a carga de trabalho ainda se beneficia de uma resposta após a latência adicional.
- A rota alternativa atende ao mesmo contrato de produto.
- A requisição ainda não produziu saída parcial nem efeitos colaterais incertos.
Use um contrato de rota como este:
task: support_reply_draft
primary:
  model: claude-sonnet-current
  max_attempts: 2
  retry_on: [529, 500, 502, 503, 504, timeout]
  backoff: exponential_jitter
fallback:
  model: approved-general-chat-model
  allowed_when:
    - no_partial_stream_output
    - no_write_side_tool_executed
    - response_schema_compatible
    - latency_budget_remaining_ms > 3000
stop:
  user_message: "O modelo está sobrecarregado. Tente novamente em instantes."
log:
  fields:
    - request_id
    - route
    - model
    - retry_count
    - fallback_used
    - final_status
Se o seu produto depende do comportamento exato do modelo, do formato de chamada de ferramenta, da política de citações, do comportamento de segurança ou de um recurso de contexto longo, o fallback entre modelos pode ser pior do que uma falha clara. Para essas cargas de trabalho, fazer fallback para o mesmo provedor/modelo em outra rota é mais seguro do que fazer fallback para uma família de modelos diferente.
Para a arquitetura mais ampla por trás desta decisão, combine esta página de erro com o playbook de produção de roteamento de fallback de API LLM da Flatkey e o playbook de fluxo de trabalho da estratégia de fallback de modelo. Esses guias cobrem o padrão de controlador mais amplo; esta página permanece focada na resposta 529 de sobrecarga.
Regras de idempotência para 529
A segurança do retry depende da idempotência. A orientação da AWS destaca que as operações devem ser idempotentes quando você faz retry com backoff; caso contrário, atualizações parciais podem corromper o estado. A orientação de erros de baixo nível da Stripe faz o mesmo ponto para erros de rede e servidor: solicitações falhas ou अस्पष्ट podem deixar o cliente sem certeza se o servidor recebeu ou executou a solicitação.
Para produtos de IA, aplique essa regra a ferramentas e efeitos colaterais:
| Operation | Safe 529 retry? | Notes |
|---|---|---|
| Generate a draft answer | Usually | Duplicate text is acceptable if you replace the old attempt |
| Stream a response after tokens started | Risky | The user may see duplicated or inconsistent output |
| Read a document | Usually | Use request IDs for traceability |
| Send an email | No, unless idempotent | Use an idempotency key and external-state reconciliation |
| Create a ticket | Only with idempotency | Reuse the same operation ID |
| Charge a card | No blind retry | Reconcile with payment provider before repeating |
| Execute a browser or agent action | Usually not blind | Check what the agent already did |
A regra prática é simples: se uma solicitação repetida puder criar estado externo duplicado, não permita que um wrapper genérico de retry assuma esse controle.
Limites do circuit breaker
Um circuit breaker transforma sobrecarga repetida em uma decisão temporária de roteamento. Você não precisa de um sistema complexo para começar.
Use uma política como:
- Abra o circuito quando os 529s excederem 20% das tentativas para uma rota ao longo de dois minutos e pelo menos 20 solicitações tiverem sido tentadas.
- Mantenha o circuito aberto por 60-180 segundos para tráfego interativo.
- Envie um pequeno número de solicitações de teste antes de fechar o circuito.
- Redefina lentamente; não envie toda a fila de volta para a rota de uma vez.
- Acompanhe o estado do circuito por provedor, modelo, família de endpoint e região quando possível.
Os circuit breakers são especialmente importantes para sistemas de agentes porque os agentes geralmente fazem retry em várias camadas: SDK do modelo, biblioteca de orquestração, worker de job e loop de comando do usuário. Conte cada camada ou você pode multiplicar acidentalmente seu orçamento de retry.
Checklist de observabilidade
Para cada incidente 529, registre evidências suficientes para responder a quatro perguntas: o que falhou, por que houve retry, se ocorreu fallback e o que o usuário viu.
| Campo | Por que importa |
|---|---|
request_id ou cabeçalho de solicitação do provedor |
Necessário para suporte e busca no lado do provedor |
model e provider |
Agrupa falhas por rota |
endpoint_family |
Chat, batch, imagem, vídeo, embeddings, chamada de ferramenta |
attempt_number |
Detecta multiplicação oculta de retries |
retry_after_ms |
Confirma se a orientação do provedor foi seguida |
backoff_ms |
Ajuda a identificar tempestades de retry |
fallback_route |
Mostra quando a qualidade ou o custo podem ser diferentes |
partial_output_started |
Evita repetição insegura |
tool_side_effect_state |
Evita ações externas duplicadas |
user_visible_outcome |
Separa falhas recuperadas de sessões quebradas |
As equipes da Flatkey podem usar o mesmo padrão com https://router.flatkey.ai/v1: roteie por meio de uma única base URL compatível com OpenAI, mantenha a seleção de modelo explícita e revise os logs de uso após o incidente. O guia de início rápido da Flatkey documenta a chave compartilhada, o catálogo de modelos, a base URL do roteador e os Logs de Uso como os lugares para verificar o tráfego de solicitações e os custos.
Se você ainda estiver separando o tratamento de limite de taxa do tratamento de sobrecarga, use o guia de limites de taxa de LLM para a política de 429/RPM/TPM e o guia de métricas de API de roteamento de IA para relatórios de confiabilidade.
Como a Flatkey se encaixa em um plano de recuperação para 529
A Flatkey não deve ser tratada como uma forma de fingir que a sobrecarga não pode acontecer. Os provedores de modelos upstream ainda podem estar ocupados. O papel útil de um gateway é o controle operacional:
- Uma única base URL compatível com OpenAI para o tráfego de modelos.
- Um catálogo compartilhado de modelos para candidatos de fallback aprovados.
- Um único registro de uso e custo para retries e falhas recuperadas.
- Mudanças mais rápidas na política de roteamento sem reescrever cada cliente de aplicação.
- Uma trilha de auditoria mais limpa quando as equipes de produto, plataforma e finanças revisarem o incidente.
Para uma equipe de produção, isso costuma ser mais valioso do que um loop de retry maior. Um loop de retry maior pode esconder incidentes até que se tornem caros. Uma política roteada torna a sobrecarga visível e controlada.
Runbook de produção para o erro de API 529
Copie isto para o seu processo de incidente:
- Confirme a classe do erro:
529 overloaded_error, provedor, modelo, endpoint, timestamp e ID da requisição. - Verifique se a requisição era apenas leitura, streaming ou do lado de escrita.
- Aplique o orçamento de retries da rota com backoff exponencial e jitter.
- Interrompa os retries se a requisição produzir saída parcial ou efeitos colaterais incertos.
- Abra um circuit breaker se os 529s se concentrarem na mesma rota de provedor/modelo.
- Faça fallback somente para uma rota aprovada com comportamento compatível de saída, segurança, latência e custo.
- Exiba uma mensagem voltada ao usuário quando o orçamento de latência expirar.
- Revise a contagem de retries, a contagem de fallbacks, as requisições recuperadas, as requisições com falha e as evidências de prevenção de duplicidade após o incidente.
FAQ
API Error 529 é o mesmo que 429?
Não. Na documentação da Anthropic, 529 significa que a API está temporariamente sobrecarregada, enquanto 429 é um erro de limite de taxa. Trate 529 como sobrecarga do provedor e 429 como um problema de taxa/cota/padrão de tráfego até que seus logs provem o contrário.
Devo tentar novamente o API Error 529?
Sim, mas apenas dentro de um orçamento e somente quando a requisição for segura para repetir. Use backoff exponencial com jitter, respeite retry-after quando presente e pare quando saída parcial ou efeitos colaterais externos tornarem a repetição insegura.
Quantos retries devo usar para erros 529 overloaded?
Para recursos interativos de IA, comece com dois retries e um prazo rígido de wall-clock. Jobs em segundo plano podem usar mais retries, mas devem usar limites de idade da fila, tratamento de dead-letter e circuit breakers.
Devo alternar modelos automaticamente após um 529?
Somente quando o modelo de fallback puder atender ao mesmo contrato de produto. Se o comportamento específico do modelo, ferramentas, schema, política de segurança ou comprimento de contexto importarem, o fallback pode exigir uma ação visível ao usuário de "gerar novamente com outro modelo" em vez de uma troca transparente.
O que devo mostrar aos usuários durante um incidente 529?
Use uma linguagem simples e temporária: "O modelo está sobrecarregado. Estamos tentando novamente por um momento." Se o orçamento de retries expirar, ofereça um botão de tentar novamente ou uma alternativa degradada. Não exponha detalhes internos do provedor, a menos que seus usuários sejam desenvolvedores que precisem dessas informações.
Recomendação Final
O plano mais seguro de API Error 529 "Overloaded": Retry, Backoff, and Fallback Strategies não é um único loop while retry. É uma política de rota: tente novamente sobrecarga transitória por pouco tempo, faça backoff com jitter, proteja trabalhos não idempotentes, acione circuit breaker em falhas repetidas e faça fallback somente quando a rota alternativa preservar o contrato do usuário.
Se sua equipe já opera mais de um modelo ou provedor, coloque essa política por trás de um único gateway. Com o Flatkey, você pode apontar clientes compatíveis com OpenAI para https://router.flatkey.ai/v1, manter candidatos de fallback em um único catálogo de modelos e revisar falhas recuperadas em Usage Logs após o lançamento.
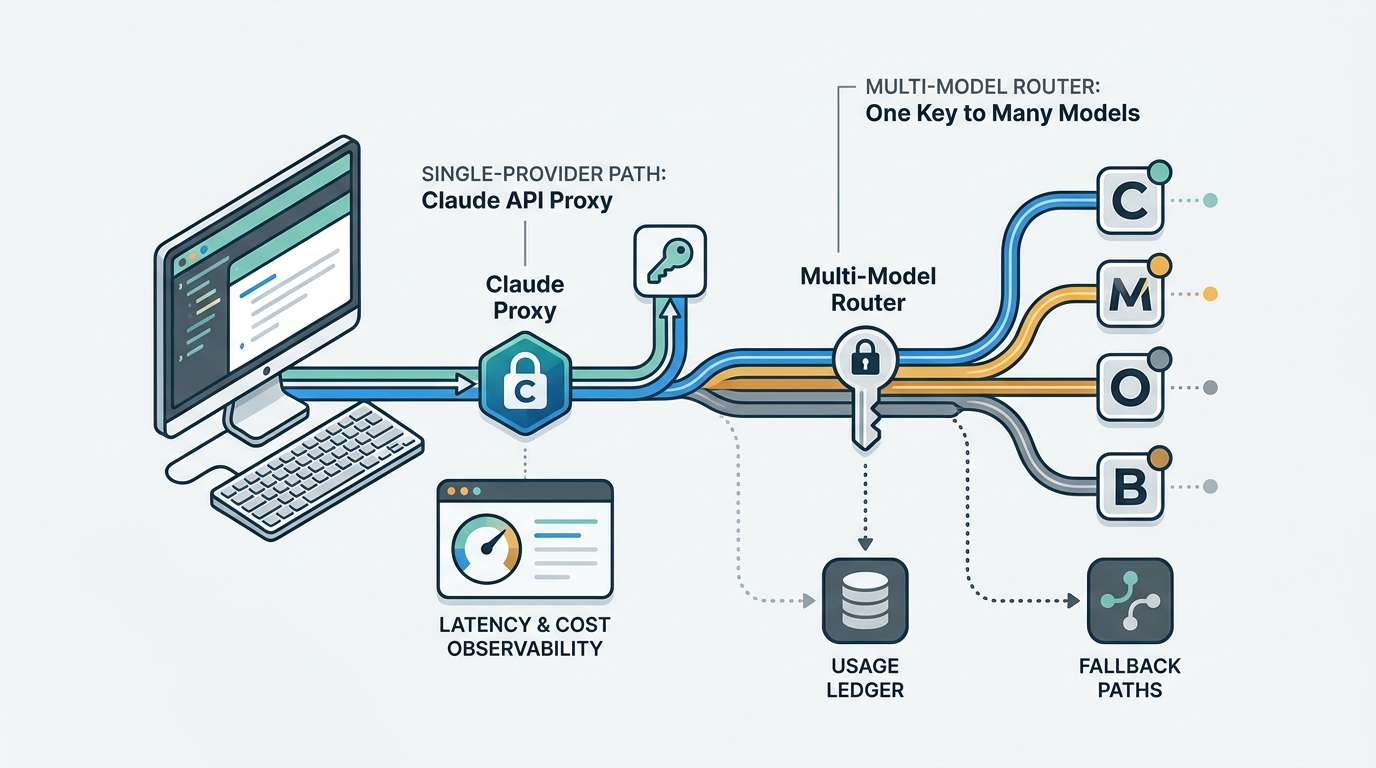
Comece com o Flatkey API quickstart se você precisar de um caminho para a primeira chamada, ou compare opções de roteamento no nível da carga de trabalho em Claude API proxy vs multi-model router.
Fontes verificadas
- Erros da API do Anthropic Claude: https://platform.claude.com/docs/en/api/errors
- AWS Prescriptive Guidance, padrão retry with backoff: https://docs.aws.amazon.com/prescriptive-guidance/latest/cloud-design-patterns/retry-backoff.html
- Tratamento avançado de erros e idempotência da Stripe: https://docs.stripe.com/error-low-level
- Índice da documentação da Flatkey: https://docs.flatkey.ai/index.md
- Quickstart da Flatkey: https://docs.flatkey.ai/quickstart.md
- Visão geral do produto Flatkey:
/Users/solveainc/.11agents/flatkey/knowledge_base/information/what-we-do/product-overview.md - Estratégia de marketing da Flatkey:
/Users/solveainc/.11agents/flatkey/knowledge_base/marketing/strategy.md