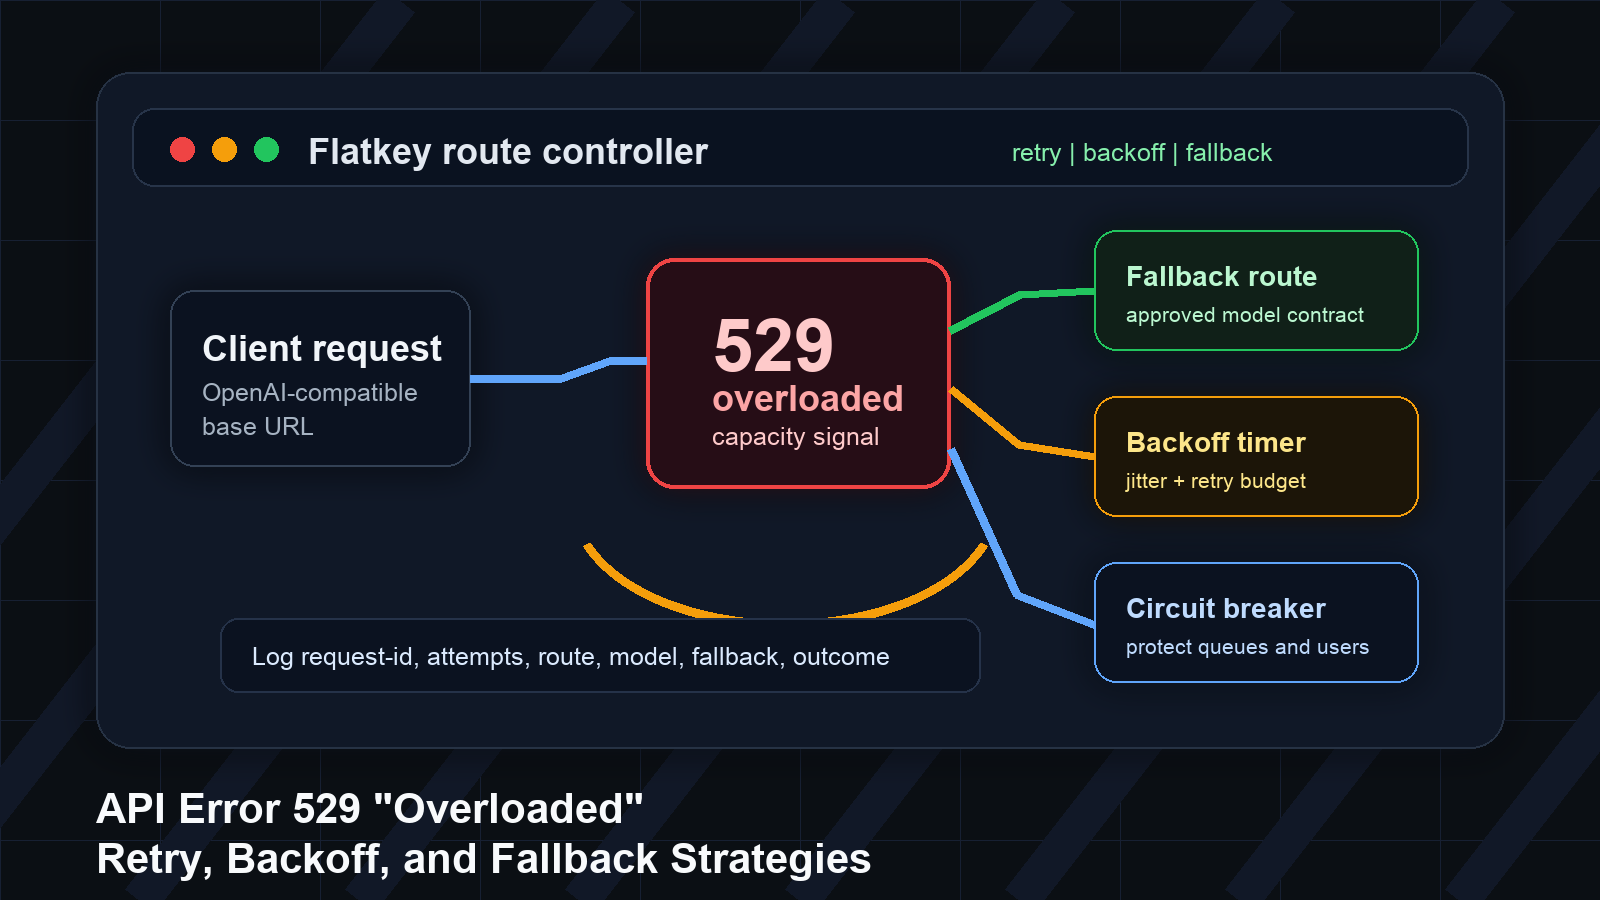
Si tus registros de producción muestran 529 overloaded_error, el proveedor te está indicando que la API está temporalmente sobrecargada. En la documentación de la API Claude de Anthropic, 529 - overloaded_error significa "La API está temporalmente sobrecargada", y la documentación señala que los errores 529 pueden ocurrir durante picos de tráfico entre todos los usuarios.
Eso hace que Error de API 529 "Sobrecargado": estrategias de reintento, backoff y fallback sea diferente de una solicitud mal formada, una clave de API incorrecta o un problema normal de cuota. La primera respuesta no debería ser "cambiar el prompt" ni "comprar más cuota". La primera respuesta debe ser un plan de fiabilidad controlada: clasificar el fallo, reintentar solo dentro de un presupuesto, proteger a los usuarios de tormentas de reintentos y decidir cuándo una ruta de fallback es más segura que esperar.
Esta guía está escrita para equipos de producto y plataforma de IA que ejecutan cargas de trabajo de LLM, agentes o multimodales en producción. Te ofrece una matriz práctica de errores y acciones, un presupuesto de reintentos, un patrón de backoff y un flujo de decisión de fallback que puedes copiar en un runbook de incidentes.
Respuesta rápida
Para Error de API 529 "Sobrecargado": estrategias de reintento, backoff y fallback, usa esta política predeterminada:
- Trata
529 overloaded_errorcomo una señal transitoria de capacidad del proveedor, no como un error de validación del cliente. - Reintenta solicitudes idempotentes o de solo lectura con backoff exponencial y jitter.
- Respeta
retry-aftercuando el proveedor lo envíe. - Deténte después de un pequeño presupuesto de reintentos, normalmente dos o tres intentos para tráfico interactivo.
- No reintentes a ciegas llamadas a herramientas no idempotentes, acciones de escritura, compras, correos electrónicos o cualquier cosa que pueda haber causado efectos secundarios.
- Abre un circuit breaker cuando los 529 se agrupen por proveedor, modelo, endpoint o región.
- Haz fallback solo cuando el modelo alternativo pueda satisfacer el mismo contrato del producto.
- Registra
request-id, modelo, ruta, recuento de reintentos, resultado final e impacto visible para el usuario.
En otras palabras: reintenta brevemente, reduce la presión sobre el sistema, realiza failover cuando la equivalencia sea aceptable y detente cuando la solicitud ya no sea segura de repetir.
Por qué ocurre el error de API 529 Sobrecargado
529 overloaded_error es una condición de capacidad. Normalmente significa que tu solicitud llegó al proveedor, pero el lado del proveedor está demasiado ocupado para atenderla en ese momento. Anthropic documenta esto por separado de 429 rate_limit_error. Esa distinción importa:
| Familia de error | Significado típico | Primera acción del responsable |
|---|---|---|
400, 401, 403, 404 |
Problema de solicitud, credenciales, permisos o nombre del modelo | Corrige la solicitud; no la reintentes sin cambios |
429 |
Límite de velocidad, límite de aceleración o tope de gasto | Reduce la velocidad, inspecciona la cuota y retry-after, cambia la forma del tráfico |
500, 502, 503, 504 |
Fallo del proveedor o del lado del servidor/red | Reintenta con backoff exponencial si es seguro |
529 overloaded_error |
Proveedor sobrecargado por alto tráfico | Reintenta con backoff, luego aplica circuit breaker o fallback |
Una 529 puede aparecer durante un pico de tráfico en todo el proveedor incluso si tu propia carga de trabajo no hizo nada inusual. Pero si estás lanzando una nueva función, ejecutando un lote o enviando un enjambre repentino de agentes, también deberías comprobar si la subida de tráfico provocó presión local o comportamiento de límite de aceleración.
Matriz de error-acción
Usa esta matriz antes de cambiar el código en pánico.
| Señal en los registros | ¿Reintentar? | ¿Backoff? | ¿Fallback? | Qué registrar |
|---|---|---|---|---|
| Una sola 529 en una solicitud de chat de solo lectura | Sí, brevemente | Sí, con jitter | No en el primer fallo | request-id, modelo, ruta, intento |
| 529 repetidas para un modelo | Sí, hasta que se agote el presupuesto | Sí | Sí, si la alternativa es compatible con el contrato | modelo de fallback, control de calidad, impacto en el usuario |
| 529 en todas las rutas de Claude | Limitado | Sí | Quizá, solo a una ruta no Claude aprobada | estado del proveedor, estado del circuito |
| 529 después de salida parcial en streaming | Normalmente no hay reintento transparente | No repetir en ciego | Detener o pedir al usuario que regenere | tokens parciales, último evento, copia visible para el usuario |
| 529 durante la ejecución de una herramienta | Solo si la herramienta es idempotente | Sí | No hasta que se reconcilien los efectos secundarios | nombre de la herramienta, clave de idempotencia, estado externo |
| 529 durante un lote en segundo plano | Sí, más lentamente | Sí, ventana más amplia | Sí, si el SLA lo requiere | edad de la cola, edad del reintento, recuento descartado |
| 529 más tiempo de espera del usuario superado | No | No | Quizá, si todavía es útil | clase de timeout, motivo del fallback |
Esta es la parte que la mayoría de las páginas de error genéricas omiten: un modelo sobrecargado no es solo un estado HTTP. Es una decisión de producto sobre trabajo duplicado, latencia, calidad de salida y confianza del usuario.
Una política de reintento segura para 529
Empieza con presupuestos de reintento separados para cargas de trabajo interactivas y en segundo plano.
| Carga de trabajo | Política inicial sugerida |
|---|---|
| Chat o autocompletado de cara al usuario | 2 reintentos, limitados por debajo del timeout visible para el usuario |
| Paso de planificación del agente | 2-3 reintentos, detener antes de que la ejecución de herramientas quede obsoleta |
| Resumido en segundo plano | 3-5 reintentos, con conocimiento de la cola y un backoff más amplio |
| Evaluación por lotes | Reintentar desde la cola con límites de edad y manejo de dead-letter |
| Llamada a herramienta en el lado de escritura | Reintentar solo con protección de idempotencia y reconciliación |
La forma de reintento más simple es un backoff exponencial con jitter:
function backoffMs(attempt: number) {
  const base = 250;
  const cap = 8_000;
  const exponential = Math.min(cap, base * 2 ** attempt);
  const jitter = Math.floor(Math.random() * exponential * 0.4);
  return exponential + jitter;
}
Usa valores pequeños para productos interactivos. Un mensaje de chat que reintenta durante 60 segundos puede ser técnicamente resiliente, pero aun así sentirse roto para el usuario. Para las colas en segundo plano, usa una ventana de backoff más amplia y conserva el elemento de trabajo para procesarlo más tarde en lugar de machacar al proveedor.
Respeta Retry-After, pero no dependas de él
Algunas APIs envían encabezados retry-after para límites de tasa o fallos transitorios. La documentación de Anthropic indica que los SDK oficiales reintentan los fallos transitorios con backoff exponencial, dos veces por defecto, y respetan retry-after cuando está presente. Tu propio controlador debería hacer lo mismo cuando omitas o envuelvas el SDK.
Pero no construyas una política que solo funcione cuando exista retry-after. Una respuesta 529 no siempre llegará con un tiempo de espera útil. Tu controlador de fallback aún necesita:
- un valor máximo de intentos,
- un presupuesto máximo de tiempo de reloj,
- un circuit breaker por ruta,
- un límite de antigüedad de la cola,
- y un modo final de fallo visible para el usuario.
Evita tormentas de reintentos
La peor respuesta a una sobrecarga del proveedor es el tráfico de reintentos sincronizado. Si cada worker reintenta de inmediato, conviertes un incidente del proveedor en un incidente mayor.
Añade estos controles:
| Control | Por qué importa |
|---|---|
| Jitter | Evita que todos los clientes reintenten al mismo instante |
| Límites de concurrencia por ruta | Evita que un modelo sobrecargado consuma todas las plazas de worker |
| Presupuesto de reintentos | Detiene bucles infinitos y gastos inesperados |
| Circuit breaker | Saca los fallos repetidos del camino crítico |
| Backpressure de la cola | Reduce la velocidad de los productores cuando los consumidores no pueden avanzar |
| Estado visible para el usuario | Indica a los usuarios cuándo el sistema está reintentando o degradado |
La guía de AWS sobre retry-with-backoff plantea el mismo punto operativo: los reintentos ayudan ante fallos transitorios, pero demasiados reintentos pueden aumentar la contención y la degradación del servicio.
Cuándo hacer fallback en lugar de reintentar
Fallback no es lo mismo que reintento. Un reintento le pide a la misma ruta que lo intente de nuevo. Un fallback cambia la ruta, el proveedor, el modelo, la región o la capacidad.
Usa fallback cuando las cuatro condiciones sean verdaderas:
- La ruta principal está fallando repetidamente con 529 u otros errores transitorios relacionados.
- El usuario o la carga de trabajo siguen beneficiándose de una respuesta después de la latencia añadida.
- La ruta alternativa cumple el mismo contrato de producto.
- La solicitud no ha producido ya salida parcial ni efectos secundarios inciertos.
Usa un contrato de ruta como este:
task: support_reply_draft
primary:
  model: claude-sonnet-current
  max_attempts: 2
  retry_on: [529, 500, 502, 503, 504, timeout]
  backoff: exponential_jitter
fallback:
  model: approved-general-chat-model
  allowed_when:
    - no_partial_stream_output
    - no_write_side_tool_executed
    - response_schema_compatible
    - latency_budget_remaining_ms > 3000
stop:
  user_message: "The model is overloaded. Please retry in a moment."
log:
  fields:
    - request_id
    - route
    - model
    - retry_count
    - fallback_used
    - final_status
Si tu producto depende del comportamiento exacto del modelo, del formato de las tool calls, de la política de citas, del comportamiento de seguridad o de una función de contexto largo, el fallback entre modelos puede ser peor que un fallo claro. Para esas cargas de trabajo, hacer fallback al mismo proveedor/modelo en otra ruta es más seguro que hacerlo a una familia de modelo diferente.
Para la arquitectura más amplia detrás de esta decisión, combine esta página de error con el manual de producción de enrutamiento de fallback para API LLM de Flatkey y el manual de flujo de trabajo de la estrategia de fallback de modelos. Esas guías cubren el patrón de controlador más amplio; esta página se centra en la respuesta 529 de sobrecarga.
Reglas de idempotencia para 529
La seguridad del reintento depende de la idempotencia. La guía de AWS señala que las operaciones deben ser idempotentes cuando reintente con backoff; de lo contrario, las actualizaciones parciales pueden corromper el estado. La guía de errores de bajo nivel de Stripe plantea el mismo punto para errores de red y servidor: las solicitudes fallidas o poco claras pueden dejar al cliente con incertidumbre sobre si el servidor recibió o ejecutó la solicitud.
Para productos de IA, aplique esa regla a las herramientas y a los efectos secundarios:
| Operación | ¿Reintento seguro de 529? | Notas |
|---|---|---|
| Generar una respuesta borrador | Normalmente | El texto duplicado es aceptable si reemplaza el intento anterior |
| Transmitir una respuesta después de que hayan empezado los tokens | Arriesgado | El usuario puede ver una salida duplicada o inconsistente |
| Leer un documento | Normalmente | Use IDs de solicitud para trazabilidad |
| Enviar un correo electrónico | No, a menos que sea idempotente | Use una clave de idempotencia y conciliación del estado externo |
| Crear un ticket | Solo con idempotencia | Reutilice el mismo ID de operación |
| Cobrar una tarjeta | No reintentar a ciegas | Concilie con el proveedor de pagos antes de repetir |
| Ejecutar una acción de navegador o agente | Normalmente no a ciegas | Compruebe qué hizo ya el agente |
La regla práctica es simple: si una solicitud repetida podría crear un estado externo duplicado, no permita que un wrapper genérico de reintentos lo gestione.
Umbrales del circuit breaker
Un circuit breaker convierte una sobrecarga repetida en una decisión temporal de enrutamiento. No necesita un sistema complejo para empezar.
Use una política como:
- Abra el circuito cuando los 529 superen el 20% de los intentos para una ruta durante dos minutos y se hayan intentado al menos 20 solicitudes.
- Mantenga el circuito abierto durante 60-180 segundos para tráfico interactivo.
- Envíe un pequeño número de solicitudes de prueba antes de cerrar el circuito.
- Restablezca lentamente; no envíe toda la cola de vuelta a la ruta de una vez.
- Rastree el estado del circuito por proveedor, modelo, familia de endpoint y región cuando sea posible.
Los circuit breakers son especialmente importantes para los sistemas de agentes porque los agentes a menudo reintentan en varias capas: SDK del modelo, biblioteca de orquestación, worker de trabajos y bucle de comando del usuario. Cuente cada capa o podría multiplicar accidentalmente su presupuesto de reintentos.
Lista de verificación de observabilidad
Para cada incidente 529, registre suficiente evidencia para responder cuatro preguntas: qué falló, por qué se reintentó, si ocurrió fallback y qué vio el usuario.
| Campo | Por qué importa |
|---|---|
request_id o encabezado de solicitud del proveedor |
Necesario para soporte y búsqueda del lado del proveedor |
model y provider |
Agrupa los fallos por ruta |
endpoint_family |
Chat, batch, imagen, video, embeddings, llamada de herramienta |
attempt_number |
Detecta la multiplicación oculta de reintentos |
retry_after_ms |
Confirma si se siguió la guía del proveedor |
backoff_ms |
Ayuda a encontrar tormentas de reintentos |
fallback_route |
Muestra cuándo la calidad o el costo pueden diferir |
partial_output_started |
Evita una repetición insegura |
tool_side_effect_state |
Evita acciones externas duplicadas |
user_visible_outcome |
Separa los fallos recuperados de las sesiones rotas |
Los equipos de Flatkey pueden usar el mismo patrón con https://router.flatkey.ai/v1: enrutar a través de una única URL base compatible con OpenAI, mantener explícita la selección del modelo y revisar los registros de uso después del incidente. La guía de inicio rápido de Flatkey documenta la clave compartida, el catálogo de modelos, la URL base del router y los registros de uso como los lugares para verificar el tráfico de solicitudes y el costo.
Si todavía estás separando el manejo de límites de tasa del manejo de sobrecarga, usa la guía de límites de tasa de LLM para la política 429/RPM/TPM y la guía de métricas de API de enrutamiento de IA para la elaboración de informes de fiabilidad.
Cómo encaja Flatkey en un plan de recuperación ante 529
Flatkey no debe tratarse como una forma de fingir que la sobrecarga no puede ocurrir. Los proveedores de modelos upstream aún pueden estar ocupados. El papel útil de una pasarela es el control operativo:
- Una única URL base compatible con OpenAI para el tráfico de modelos.
- Un catálogo compartido de modelos para candidatos de fallback aprobados.
- Un solo registro de uso y costos para reintentos y fallos recuperados.
- Cambios más rápidos en la política de enrutamiento sin reescribir cada cliente de aplicación.
- Un rastro de auditoría más limpio cuando los equipos de producto, plataforma y finanzas revisen el incidente.
Para un equipo de producción, esto suele ser más valioso que un bucle de reintentos más grande. Un bucle de reintentos más grande puede ocultar incidentes hasta que se vuelven costosos. Una política enrutada hace que la sobrecarga sea visible y controlada.
Runbook de producción para el error de API 529
Copia esto en tu proceso de incidentes:
- Confirme la clase de error:
529 overloaded_error, proveedor, modelo, endpoint, marca temporal e ID de solicitud. - Compruebe si la solicitud era de solo lectura, en streaming o de escritura.
- Aplicar el presupuesto de reintentos de la ruta con backoff exponencial y jitter.
- Detenga los reintentos si la solicitud produjo salida parcial o efectos secundarios inciertos.
- Abra un circuit breaker si los 529 se agrupan en la misma ruta de proveedor/modelo.
- Haga fallback solo a una ruta aprobada con comportamiento compatible de salida, seguridad, latencia y coste.
- Mostrar un mensaje para el usuario cuando expire el presupuesto de latencia.
- Revise el conteo de reintentos, el conteo de fallbacks, las solicitudes recuperadas, las solicitudes fallidas y la evidencia de prevención de duplicados después del incidente.
FAQ
¿Es el error de API 529 lo mismo que 429?
No. En la documentación de Anthropic, 529 significa que la API está temporalmente sobrecargada, mientras que 429 es un error de límite de tasa. Trate 529 como una sobrecarga del proveedor y 429 como un problema de tasa/cuota/patrón de tráfico hasta que sus registros demuestren lo contrario.
¿Debería reintentar el error de API 529?
Sí, pero solo dentro de un presupuesto y solo cuando la solicitud sea segura de repetir. Use backoff exponencial con jitter, respete retry-after cuando esté presente y deténgase cuando la salida parcial o los efectos secundarios externos hagan que la repetición no sea segura.
¿Cuántos reintentos debo usar para los errores 529 de sobrecarga?
Para funciones de IA interactivas, empiece con dos reintentos y una fecha límite estricta de reloj en tiempo real. Los trabajos en segundo plano pueden usar más reintentos, pero deben usar límites de antigüedad en cola, manejo de dead-letter y circuit breakers.
¿Debería cambiar automáticamente de modelo después de un 529?
Solo cuando el modelo de fallback pueda satisfacer el mismo contrato de producto. Si el comportamiento específico del modelo, las herramientas, el esquema, la política de seguridad o la longitud del contexto importan, el fallback puede necesitar una acción visible para el usuario de "regenerar con otro modelo" en lugar de un cambio transparente.
¿Qué debería mostrar a los usuarios durante un incidente 529?
Use un lenguaje simple y temporal de estado: "El modelo está sobrecargado. Estamos reintentando brevemente." Si el presupuesto de reintentos expira, ofrezca un botón de reintento o una alternativa degradada. No exponga detalles internos del proveedor a menos que sus usuarios sean desarrolladores que necesiten esa información.
Recomendación final
El plan más seguro para Error de API 529 "Sobrecargado": estrategias de reintento, backoff y fallback no es un único bucle while retry. Es una política de ruta: reintente brevemente la sobrecarga transitoria, aplique backoff con jitter, proteja el trabajo no idempotente, active el circuit breaker ante fallos repetidos y haga fallback solo cuando la ruta alternativa preserve el contrato del usuario.
Si su equipo ya ejecuta más de un modelo o proveedor, ponga esa política detrás de una sola pasarela. Con Flatkey, puede apuntar a clientes compatibles con OpenAI a https://router.flatkey.ai/v1, mantener los candidatos de fallback en un catálogo de modelos único y revisar los fallos recuperados en los registros de uso después del lanzamiento.
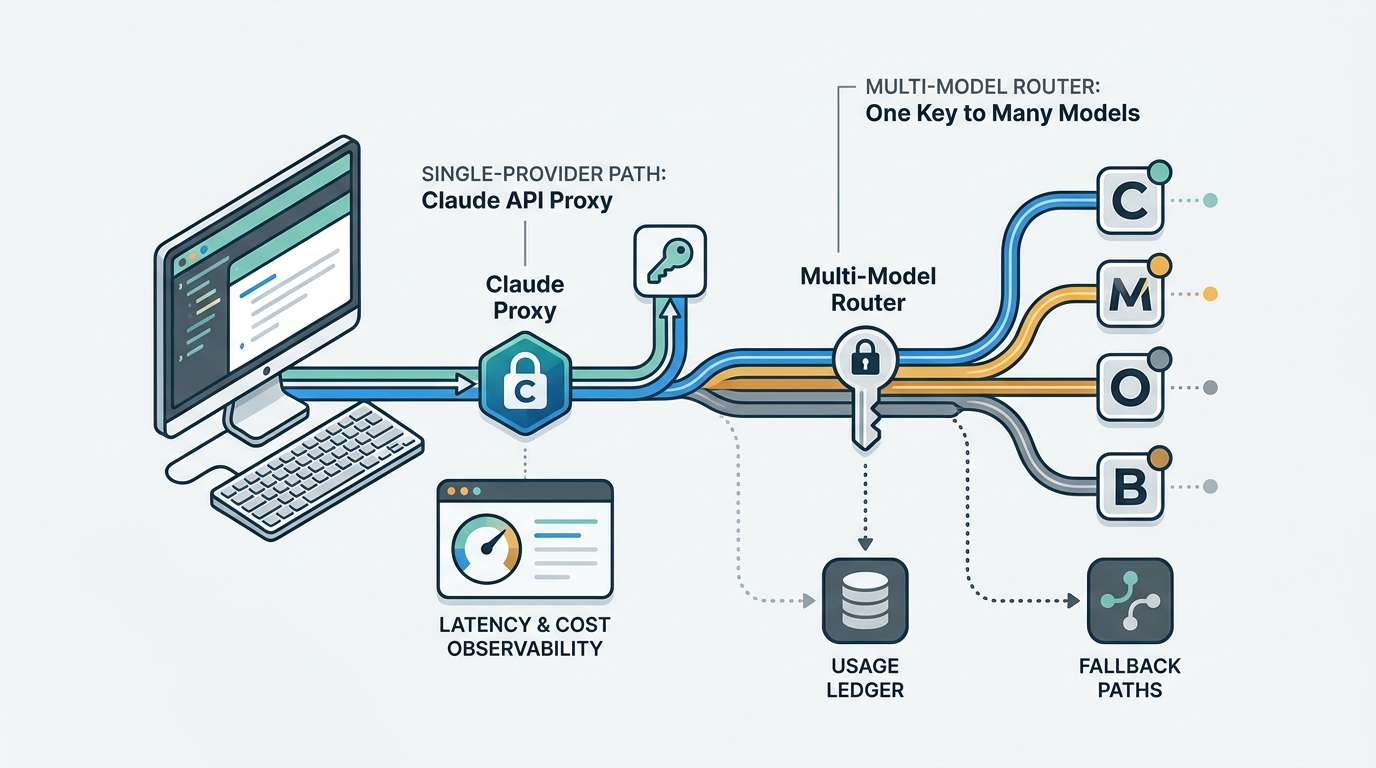
Empiece con el inicio rápido de la API de Flatkey si necesita una ruta para la primera llamada, o compare las opciones de enrutamiento a nivel de carga de trabajo en proxy de la API de Claude vs router multimodelo.
Fuentes consultadas
- Errores de la API Claude de Anthropic: https://platform.claude.com/docs/en/api/errors
- Prescriptive Guidance de AWS, patrón de reintento con backoff: https://docs.aws.amazon.com/prescriptive-guidance/latest/cloud-design-patterns/retry-backoff.html
- Gestión avanzada de errores e idempotencia de Stripe: https://docs.stripe.com/error-low-level
- Índice de documentación de Flatkey: https://docs.flatkey.ai/index.md
- Inicio rápido de Flatkey: https://docs.flatkey.ai/quickstart.md
- Descripción general del producto Flatkey:
/Users/solveainc/.11agents/flatkey/knowledge_base/information/what-we-do/product-overview.md - Estrategia de marketing de Flatkey:
/Users/solveainc/.11agents/flatkey/knowledge_base/marketing/strategy.md