Serving mit langem Kontext macht GPU-Speicher letztlich zu einem Planungsproblem. Eine Anfrage kann ihren ersten Turn abschließen, aber KV-Zustand zurücklassen, dessen Neuberechnung teuer ist und der aktuell nicht auf der GPU benötigt wird. KV-Cache-Offload bezeichnet die Technik, wiederverwendbare Cache-Blöcke von der schnellen GPU-Ebene in eine größere, langsamere Ebene zu verschieben—üblicherweise zunächst in den Host-RAM—und sie nur dann wieder zurückzustufen, wenn eine spätere Anfrage sie wiederverwenden kann.
Das Ziel ist nicht, langsamen Speicher wie HBM erscheinen zu lassen. Das Ziel besteht darin, die teure GPU-KV-Kapazität für das aktive Working Set zu reservieren und gleichzeitig hochwertige Präfixe andernorts verfügbar zu halten. Dadurch ist KV-Cache-Offload besonders nützlich, wenn Ihr Traffic lange Kontexte und eine nennenswerte Wiederverwendung aufweist: wiederkehrende System-Prompts, RAG-Gerüste, Multi-Turn-Sitzungen oder wiederholte Dokumentpräfixe.
Dieser Leitfaden zeigt, wie Sie entscheiden, ob Tiering geeignet ist, wie die aktuellen vLLM-Steuerelemente zusammenspielen, was TensorRT-LLM für Host-Speicher-Offload bietet und wie Sie die Änderung testen, ohne einen GPU-Out-of-Memory-Fehler gegen einen Tail-Latency-Vorfall einzutauschen.
Die kurze Antwort
Verwenden Sie KV-Cache-Offload als kontrollierte Erweiterung der Präfixwiederverwendung—nicht als standardmäßige Speicherlösung.
| Traffic-Muster | Beginnen Sie mit | Warum |
|---|---|---|
| Wiederholte lange System-Prompts oder RAG-Präfixe | GPU-Präfix-Caching, dann CPU-Offload-Pilotprojekt | Eine spätere Anfrage kann ein zwischengespeichertes Präfix wiederverwenden, statt es neu zu berechnen. |
| Langlebige interaktive Sitzungen mit inaktiven Phasen | GPU- plus CPU-Warm-Tier | Inaktiver Kontext kann den GPU-Speicher verlassen und dabei wiederherstellbar bleiben. |
| Überwiegend einmalige, einzigartige Prompts | Zuerst GPU-Kapazität und Admission Control | Ein Cache-Block ohne künftige Wiederverwendung erzeugt beim Offload nur zusätzlichen Transferaufwand. |
| Knapper GPU-Speicher, aber Host-RAM verfügbar | Kleines CPU-Offload-Experiment | Offload kann Platz für aktive KV-Blöcke schaffen, doch die Heraufstufungskosten müssen innerhalb des SLO bleiben. |
| Bedarf an einer persistenten niedrigeren Ebene | CPU-Primärebene plus getestete sekundäre Ebene | Eine sekundäre Ebene kann die Vorhaltezeit verlängern, ist jedoch kein Ersatz für eine schnelle aktive Ebene. |
Die wichtige Einschränkung ist die Lokalität. Wenn ein ausgelagerter Block wiederverwendet wird, muss er in den GPU-Speicher zurückkehren, bevor Attention ihn verwendet. Dieser Transferpfad ist Teil des Latenzbudgets der Anfrage.
Was eine KV-Cache-Ebene tatsächlich speichert
Während der autoregressiven Generierung erzeugen Attention-Schichten Key- und Value-Tensoren für verarbeitete Tokens. Das Beibehalten dieser Tensoren ermöglicht es dem Server, die bereits gesehenen Präfixe bei einem späteren Decodierungsschritt oder bei einer kompatiblen Präfixwiederverwendung nicht erneut berechnen zu müssen. In TensorRT-LLM wird der KV-Cache als Pools von Blöcken dargestellt, die Zustand für eine feste Token-Anzahl enthalten; die Dokumentation beschreibt außerdem die Wiederverwendung über Anfragen hinweg, priorisierte Vorhaltung und Host-Speicher-Offload. TensorRT-LLM KV Cache System
Ein praktischer Serving-Stack hat üblicherweise drei mögliche Speichertemperaturen:
| Ebene | Typische Rolle | Stärke | Kosten |
|---|---|---|---|
| GPU HBM | Heißer, aktiver Prefill- und Decode-Zustand | Niedrigste Zugriffslatenz | Kleinste und teuerste Kapazität |
| CPU DRAM | Warme, wiederverwendbare Blöcke | Deutlich größere Kapazität; kann als erstes Offload-Ziel dienen | Die Heraufstufung zur GPU verursacht zusätzliche Transferzeit |
| Dateisystem- oder Objekt-Ebene | Kalte, vorgehaltene Blöcke | Persistente oder gemeinsam genutzte Kapazität | Höchste Abrufkosten und mehr operative Fehlermodi |
Der vLLM-Offloading-Leitfaden beschreibt die Reihenfolge ausdrücklich: Sein Multi-Tier-Design verwendet die CPU als primäre Ebene, und Transfers zwischen GPU und einer sekundären Ebene werden über diese CPU-Ebene geleitet. Mit anderen Worten: Ein Treffer in der kalten Ebene ist kein direkter GPU-Lesevorgang. vLLM KV Offloading Usage Guide
              promote on a usable cache hit
Request ──> GPU HBM  <──────────────────── CPU DRAM
              │                                ▲
              │ evict completed, reusable      │ stage
              ▼                                │
          active GPU cache  ─────────────> secondary storage
                 hot                     warm / cold
Dieses vllm kv cache offload diagram ist bewusst einfach gehalten: Nur die GPU-Ebene sollte sich jederzeit auf dem kritischen Compute-Pfad befinden. CPU- und Speicherebenen sollten einer messbaren Wiederverwendungsrichtlinie dienen.
KV-Cache-Offload ist nicht dasselbe wie Modellgewichts-Offload
Diese Unterscheidung verhindert eine überraschend häufige Fehlkonfiguration:
- KV-Cache-Offload verschiebt durch Anfragen erzeugten Attention-Zustand. Er verändert primär den für aktiven Kontext verfügbaren Speicher und den Wiederverwendungspfad.
- Modellgewichts-Offload verschiebt Modellparameter. In vLLM ist die Steuerung
--cpu-offload-gbunter Modellgewichts-Offloading dokumentiert und kann bei jedem Model-Forward-Pass CPU-GPU-Transferaufwand hinzufügen. vLLM serve arguments
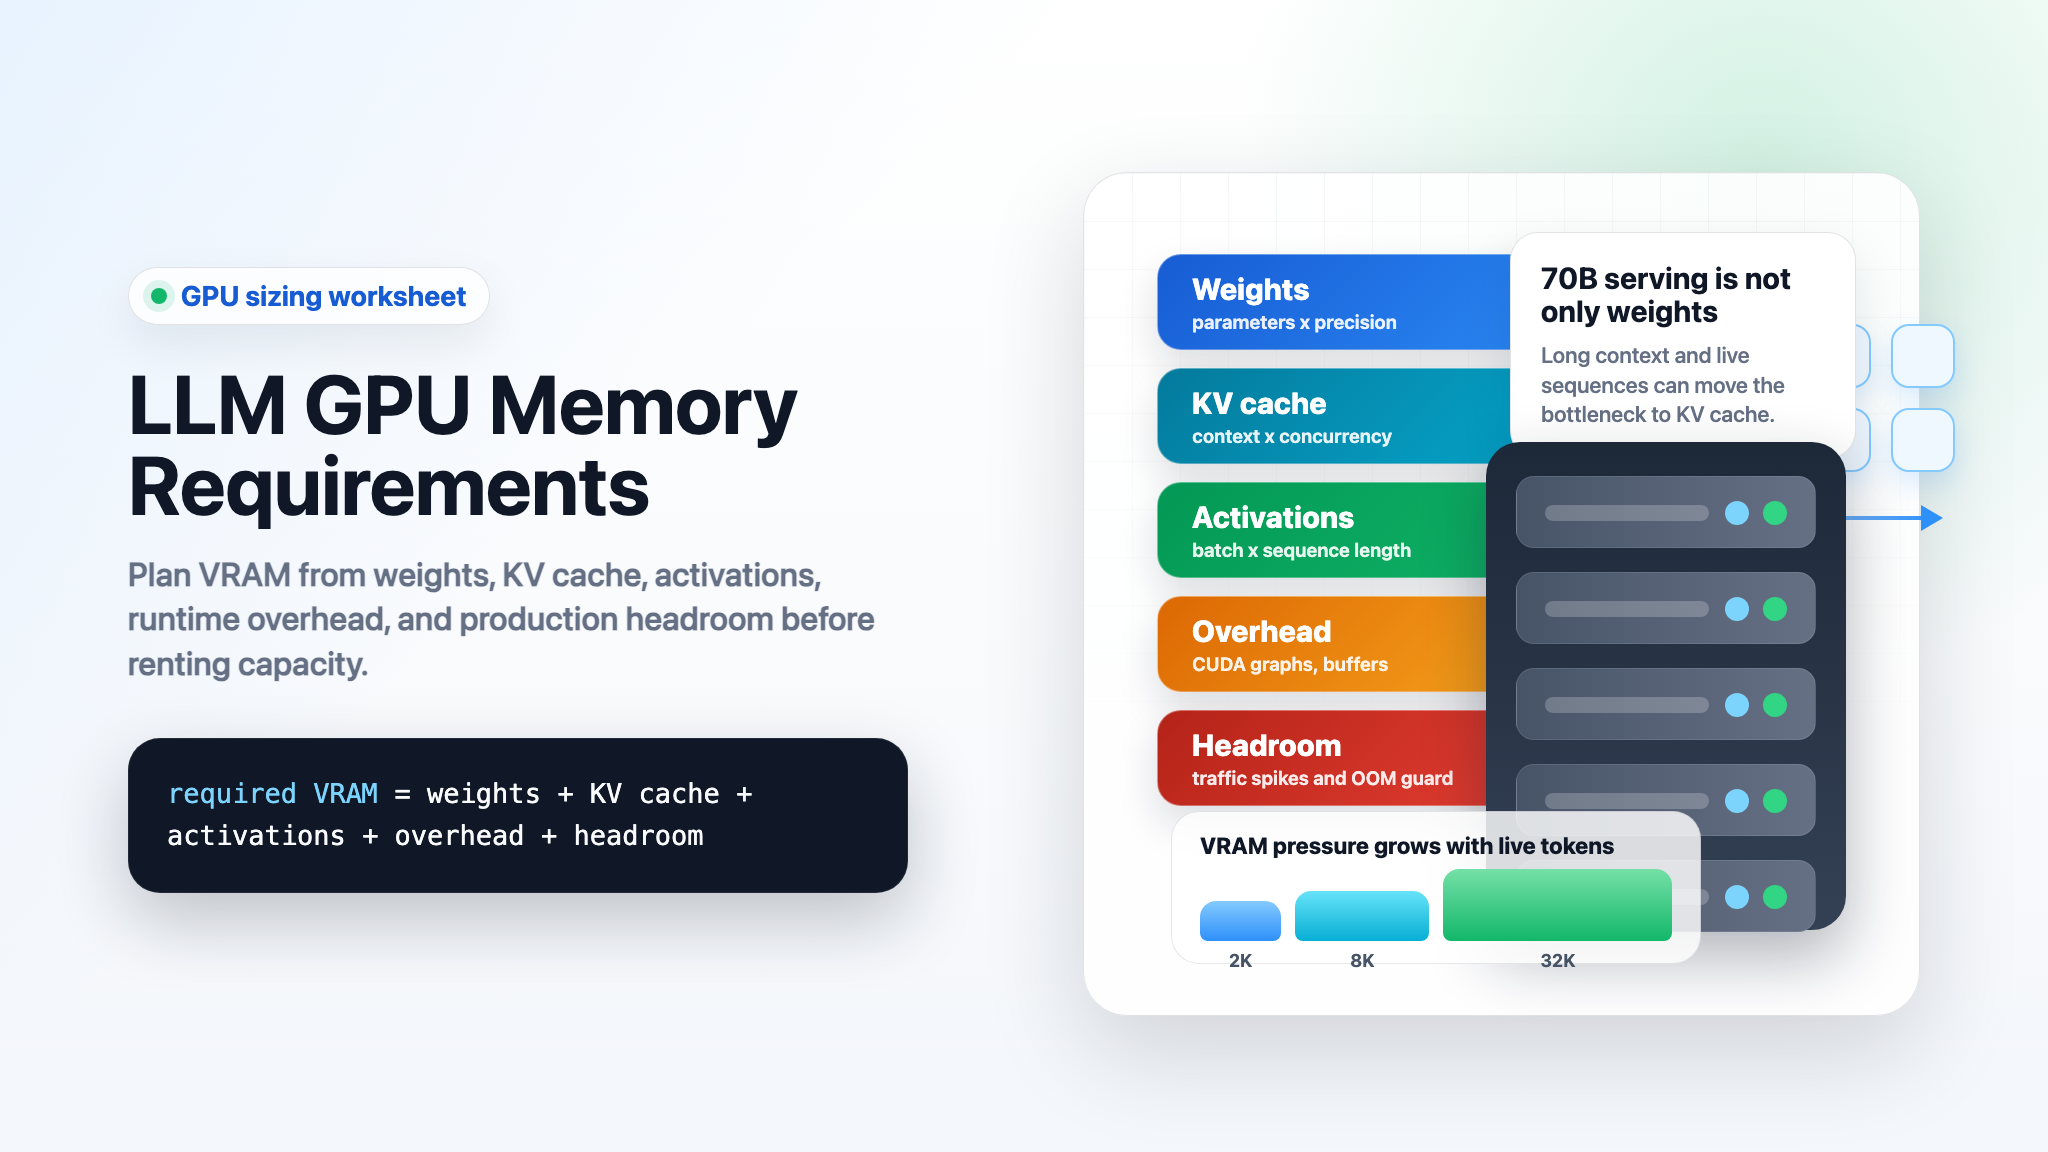
Gehen Sie nicht davon aus, dass eine Einstellung, mit der ein Modell geladen werden kann, auch mehr nutzbare KV-Kapazität schafft. Trennen Sie zunächst das Budget für Modellgewichte, Runtime-Workspace und KV-Cache; entscheiden Sie dann, ob es sich lohnt, inaktive KV-Blöcke außerhalb des GPU-Speichers vorzuhalten.
vLLM KV-Cache-Offload: Beginnen Sie mit dem nativen CPU-Pfad
Für die aktuelle vLLM-CLI lautet das relevante vllm kv cache offload flag --kv-offloading-size. Laut der offiziellen CLI-Referenz ist dies die Größe des KV-Offload-Puffers in GiB; bei einer Tensor-Parallelität von mehr als eins ist die Größe die Summe über die tensorparallelen Ränge. Offloading ist deaktiviert, wenn die Option nicht gesetzt ist. Das zugehörige --kv-offloading-backend unterstützt das native CPU-Backend und LMCache. vLLM-Serve-Argumente
Verwenden Sie einen begrenzten Pilotversuch, statt die Host-Ebene auf den gesamten verfügbaren RAM auszulegen:
vllm serve <your-model> \
  --gpu-memory-utilization 0.85 \
  --kv-offloading-size 16 \
  --kv-offloading-backend native
Das Beispiel zeigt die Form eines Experiments, keine universelle Einstellung. Der richtige Wert hängt vom Cache-Layout des Modells, der Kontextlänge, der Tensor-Parallel-Konfiguration, den verfügbaren Host-RAM-Reserven, dem Request-Mix und dem Latenzziel ab. Fixieren Sie die vLLM-Image-Version und führen Sie vor dem Einsatz von Flags in der Produktion vllm serve --help in diesem Image aus; die Serving-Konfiguration entwickelt sich schnell weiter.
Der native Pfad eignet sich für einen ersten vllm kv cache offload cpu-Versuch, weil er die Tiering-Frage eingrenzt: Kann eine warme CPU-Ebene genügend nützliche Blöcke vorhalten, um die Zulassung zu verbessern oder GPU-Cache-Churn zu vermeiden, ohne das Verhalten bei p95 und p99 zu verschlechtern?
Cache-Zulassung vor Cache-Kapazität wählen
Mehr vorgehaltene Blöcke bedeuten nicht zwangsläufig mehr nützliche Blöcke. Beantworten Sie vor der Vergrößerung des Offload-Puffers vier Fragen:
- Welche Präfixe werden zwischen Requests geteilt?
- Wie lange nach ihrer Erstellung werden diese Präfixe erneut verwendet?
- Wie groß ist ein nützlicher Block im Verhältnis zu Ihrem Host-Übertragungsbudget?
- Welche Blöcke sollten direkt verworfen werden, weil ihre Wiederverwendungswahrscheinlichkeit zu gering ist?
Wenn der Workload die ersten beiden Fragen nicht anhand von Traces beantworten kann, beginnen Sie mit der Messung der Präfix-Wiederverwendung auf der GPU. Eine CPU-Ebene kann warmen Cache-Zustand bewahren; sie kann keine Wiederverwendung für vollständig einzigartige Prompts erzeugen.
Einen vLLM-Tiering-Pfad erst nach dem CPU-Pilotversuch aufbauen
vLLMs OffloadingConnector ist der Weg zu einer primären CPU-Ebene plus optionalen sekundären Ebenen. Der offizielle Leitfaden beschreibt CPUOffloadingSpec für eine einzelne CPU-Ebene und TieringOffloadingSpec für eine primäre CPU-Ebene mit einer oder mehreren sekundären Ebenen. Er dokumentiert außerdem LRU und ARC als integrierte Optionen für Eviction-Policies. vLLM-Leitfaden zur Nutzung von KV-Offloading
Folgendes ist eine originalgetreue Konfigurationsform aus dem dokumentierten Multi-Tier-Beispiel. Ersetzen Sie Modell, Pfade, Blockgröße, Bytes und Thread-Anzahlen erst, nachdem Sie sie auf Ihrem eigenen Host getestet haben:
vllm serve <your-model> \
  --kv-transfer-config '{
    "kv_connector": "OffloadingConnector",
    "kv_role": "kv_both",
    "kv_connector_extra_config": {
      "spec_name": "TieringOffloadingSpec",
      "cpu_bytes_to_use": 10737418240,
      "block_size": 16,
      "eviction_policy": "lru",
      "secondary_tiers": [
        {
          "type": "fs",
          "root_dir": "/mnt/kv_cache",
          "n_read_threads": 32,
          "n_write_threads": 16
        }
      ]
    }
  }'
Drei betriebliche Details sind wichtiger als das Kopieren des Snippets:
cpu_bytes_to_useist die gesamte Reservierung der CPU-Ebene über alle Worker hinweg, nicht ein vager Vorschlag an das Betriebssystem. Planen Sie Budget für den Prozess, das Betriebssystem, den Storage-Page-Cache und alle gemeinsam platzierten Dienste ein.- Die konfigurierte Block- oder Chunk-Größe legt die I/O-Einheit fest. Sehr kleine Chunks können den Metadaten- und Scheduling-Overhead erhöhen; sehr große Chunks können Bytes übertragen, die ein Request nicht benötigt. Testen Sie beides mit realen Präfixlängen.
- Eine sekundäre Ebene liegt hinter der CPU. Wenn die CPU-Ebene zu klein oder ausgelastet ist, kann zusätzliche Filesystem-Kapazität zwar mehr Daten vorhalten, ohne jedoch die Latenz eines späteren Hits zu verbessern.
Das Ziel von vllm kv cache offload ist daher nicht, „alles vorzuhalten“. Es ist, „die Blöcke mit einem plausiblen, zeitnahen Wiederverwendungspfad vorzuhalten“.
TensorRT-LLM-KV-Cache-Offload in den Host-Speicher
TensorRT-LLM stellt dieselbe Grundidee über seine KV-Cache-Konfiguration bereit. Laut Dokumentation reserviert host_cache_size Host-Speicher für Offloading, hat standardmäßig den Wert null und ermöglicht es, dass ein Block wiederverwendbar bleibt, bis er später aus dem Host-Speicher entfernt wird. Bei Wiederverwendung wird der Block zurück in den GPU-Speicher kopiert. TensorRT-LLM KV Cache System
Achten Sie bei einem tensorrt-llm kv cache offload host memory-Rollout neben der Kapazität auch auf die Aufbewahrungsrichtlinie:
| TensorRT-LLM-Steuerung | Zu überprüfen |
|---|---|
host_cache_size |
Das Byte-Budget ist bewusst gewählt und lässt Host-Speicher-Reserven übrig. |
| Block-Priorität / Aufbewahrungsrichtlinie | Häufig wiederverwendete Prompt-Bereiche werden vor entbehrlichen Daten vorgehalten. |
secondary_offload_min_priority |
Blöcke mit niedriger Priorität können den Host-Offload umgehen und direkt verworfen werden, wodurch vermeidbarer Host-Traffic reduziert wird. |
| Request-übergreifende Block-Wiederverwendung | Die Wiederverwendung bleibt aktiviert und ist getrennt von Scheduler-Schätzungen beobachtbar. |
TensorRT-LLM dokumentiert zum Zeitpunkt der Erstellung einen Standardwert von 35 für secondary_offload_min_priority. Betrachten Sie dies als versionsabhängigen Standardwert, nicht als Richtlinienempfehlung: Ein Schwellenwert sollte den beobachteten Wiederverwendungswert und die Übertragungskosten für Ihren Service widerspiegeln.
Eine Rollout-Methode, die die Latenz schützt
Aktivieren Sie nicht während eines Kapazitätsvorfalls eine kalte Ebene und erklären Sie den Erfolg, sobald der OOM-Fehler ausbleibt. Führen Sie stattdessen eine kontrollierte Abfolge aus:
- Erfassen Sie eine reine GPU-Basislinie. Zeichnen Sie die Kontextlängenverteilung, Parallelität, Zeit bis zum ersten Token, Inter-Token-Latenz, End-to-End-p50/p95/p99, Präfix-Wiederverwendungsrate und das GPU-KV-Eviction-Verhalten auf.
- Reservieren Sie tatsächlich verfügbaren Host-Spielraum. Berücksichtigen Sie Laufzeit-Overhead und das Betriebssystem; dimensionieren Sie einen CPU-Cache nicht allein anhand von Momentaufnahmen des freien Speichers.
- Aktivieren Sie eine kleine CPU-Ebene. Halten Sie Modell, Batch-Richtlinie, Traffic-Profil und SLO-Warnungen stabil, während Sie eine Cache-Dimension ändern.
- Vergleichen Sie die Qualität der Treffer, nicht nur ihre Anzahl. Unterscheiden Sie GPU-Treffer, CPU-Promotions, Promotions aus der kalten Ebene und Fehlschläge, die eine Neuberechnung auslösen.
- Untersuchen Sie die Tail-Latenz unter Konkurrenzlast. Führen Sie gemischte lange/kurze Anfragen und einen Parallelitätsanstieg aus. Ein Ergebnis, das nur Mittelwerte betrachtet, verbirgt Übertragungswarteschlangen.
- Fügen Sie eine sekundäre Ebene nur hinzu, wenn der Aufbewahrungswert dies rechtfertigt. Testen Sie Cache-Verlust, Speicherdruck, Neustartverhalten und Promotion-Spitzen, bevor Sie sie breit ausrollen.
- Legen Sie eine Rollback-Regel fest. Zum Beispiel: Deaktivieren Sie die neueste Ebene, wenn p99 für die Zeit bis zum ersten Token oder die Inter-Token-Latenz das vereinbarte Budget über ein anhaltendes Zeitfenster hinweg überschreitet.
Der vLLM-Leitfaden dokumentiert Konfigurations- und Offload-Metriken, einschließlich Konfigurationsinformationen und Signalen zur CPU-Cache-Nutzung. Verwenden Sie sie zusammen mit Anwendungstraces; eine Cache-Metrik ohne Latenz auf Anfrageebene erschwert die Unterscheidung zwischen einer wertvollen Promotion und Übertragungs-Overhead. vLLM KV Offloading Usage Guide
Fehlermodi, die Sie von vornherein vermeiden sollten
| Fehlermodus | Wie er aussieht | Bessere Reaktion |
|---|---|---|
| Alle Cache-Blöcke als wertvoll behandeln | CPU-Ebene füllt sich, Promotions nehmen zu, Latenz verschlechtert sich | Aufnahme und Aufbewahrung nach Wiederverwendungsnachweisen steuern, nicht allein nach Erstellungsreihenfolge. |
| Gewichts-Offload mit KV-Cache-Offload verwechseln | Modell wird geladen, aber die Parallelität bei langem Kontext bleibt schlecht | Budgets für Gewichte, KV, Workspace und Sicherheitsreserven getrennt planen. |
| Host-RAM überbelegen | Der Host beginnt, Speicher zurückzugewinnen, oder colocierte Services werden instabil | Ein festes Budget reservieren und unter realistischer Konkurrenzlast Lasttests durchführen. |
| Eine sekundäre Ebene zu früh hinzufügen | Mehr vorgehaltene Bytes, keine nennenswerte SLO-Verbesserung | Zuerst die Wiederverwendung der CPU-Ebene nachweisen; anschließend die kalte Ebene unabhängig testen. |
| Übertragungstopologie ignorieren | Gutes Laborergebnis, schlechtes p99 auf gemeinsam genutztem Node | Auf genau der GPU-, CPU-, PCIe/NVLink-Topologie und dem Speicherpfad benchmarken, die in der Produktion verwendet werden. |
| Cache-Verhalten vor Operatoren verbergen | Ein Vorfall wirkt wie zufällige Latenzvarianz | Ebenenspezifische Signale für Treffer, Promotions, Evictions, Kapazität und Fehler bereitstellen. |
Wann KV-Cache-Offload die falsche Optimierung ist
Verzichten Sie vorerst auf KV-Cache-Offload, wenn:
- GPU-Speicher nicht der begrenzende Faktor ist.
- Prompts fast alle einzigartig sind, sodass vorgehaltene Präfixe nicht wiederverwendet werden.
- Ihr primäres SLO eine sehr niedrige Tail-Latenz ist und nicht nachgewiesen werden kann, dass der Übertragungspfad darin liegt.
- Host-DRAM oder Speicher bereits umkämpfte Produktionsressourcen sind.
- Präfix-Caching, Batching, Kontextlimits, Modellauswahl oder Cache-Quantisierung noch nicht bewertet wurden.
In diesen Fällen kann der sinnvollere erste Schritt eine Überprüfung des GPU-Speicherbudgets, eine andere Kontextrichtlinie oder eine Änderung der Serving-Architektur sein. Informationen zu Topologie- und Parallelitätsentscheidungen finden Sie unter vLLM Multi-GPU Inference, vLLM vs SGLang und TensorRT-LLM vs vLLM.
FAQ
Reduziert KV-Cache-Offload den GPU-Speicherverbrauch?
Er kann den Druck durch wiederverwendbare inaktive KV-Blöcke reduzieren, indem diese aus der GPU-Ebene verschoben werden. Er beseitigt nicht die Notwendigkeit eines GPU-residenten Caches für aktive Attention-Arbeit, und ein wiederverwendeter ausgelagerter Block muss vor der Nutzung zurückpromotet werden.
Was ist das vLLM-KV-Cache-Offload-Flag?
In der aktuellen vLLM-CLI-Dokumentation aktiviert --kv-offloading-size bei entsprechender Einstellung einen KV-Offload-Puffer, während --kv-offloading-backend das Backend auswählt. Prüfen Sie die genauen Flags in Ihrer festgelegten vLLM-Version. vLLM serve arguments
Ist eine Dateisystemebene ein direkter GPU-Cache?
Nein. vLLM dokumentiert die CPU als primäre Ebene seiner Multi-Tier-Implementierung; Übertragungen zwischen GPU und einer sekundären Ebene werden über CPU-Speicher geleitet. Deshalb müssen Tests der sekundären Ebene den vollständigen Promotion-Pfad umfassen.
Ist KV-Cache-Offload besser als der Kauf einer größeren GPU?
Sie lösen unterschiedliche Einschränkungen. Eine größere GPU kann die heiße Arbeitsmenge ohne Promotion-Overhead vergrößern. Offload kann mit bestehender GPU-Kapazität nützlichen warmen oder kalten Zustand vorhalten. Vergleichen Sie beides anhand der gemessenen Wiederverwendung des Workloads, des Latenz-SLO, des Betriebsaufwands und der Gesamtkosten für das Serving.
Fazit: KV-Cache-Offload als Cache-Richtlinie betrachten, nicht als Kapazitätstrick
Das stärkste Design für KV-Cache-Offload hält aktive Zustände auf der GPU, reserviert CPU-Speicher für belegte warme Wiederverwendung und fügt eine Cold-Tier nur hinzu, wenn die Aufbewahrung nach Messung von Übertragungskosten und Fehlerbehandlung weiterhin wertvoll ist. Beginnen Sie mit einem begrenzten CPU-Pilotprojekt, instrumentieren Sie Heraufstufungen und Latenz nach Tier und übernehmen Sie nur die Richtlinie, die ein Produktions-SLO verbessert – nicht lediglich die Menge des vorgehaltenen Caches.
Wenn die Betriebskosten eines selbst gehosteten Serving-Stacks den Grad an Kontrolle überwiegen, den Ihre Workload benötigt, vergleichen Sie ein GPU-Cloud-Deployment mit einer Modell-API oder erkunden Sie Flatkey Compute, bevor Sie sich auf eine größere Flotte festlegen.