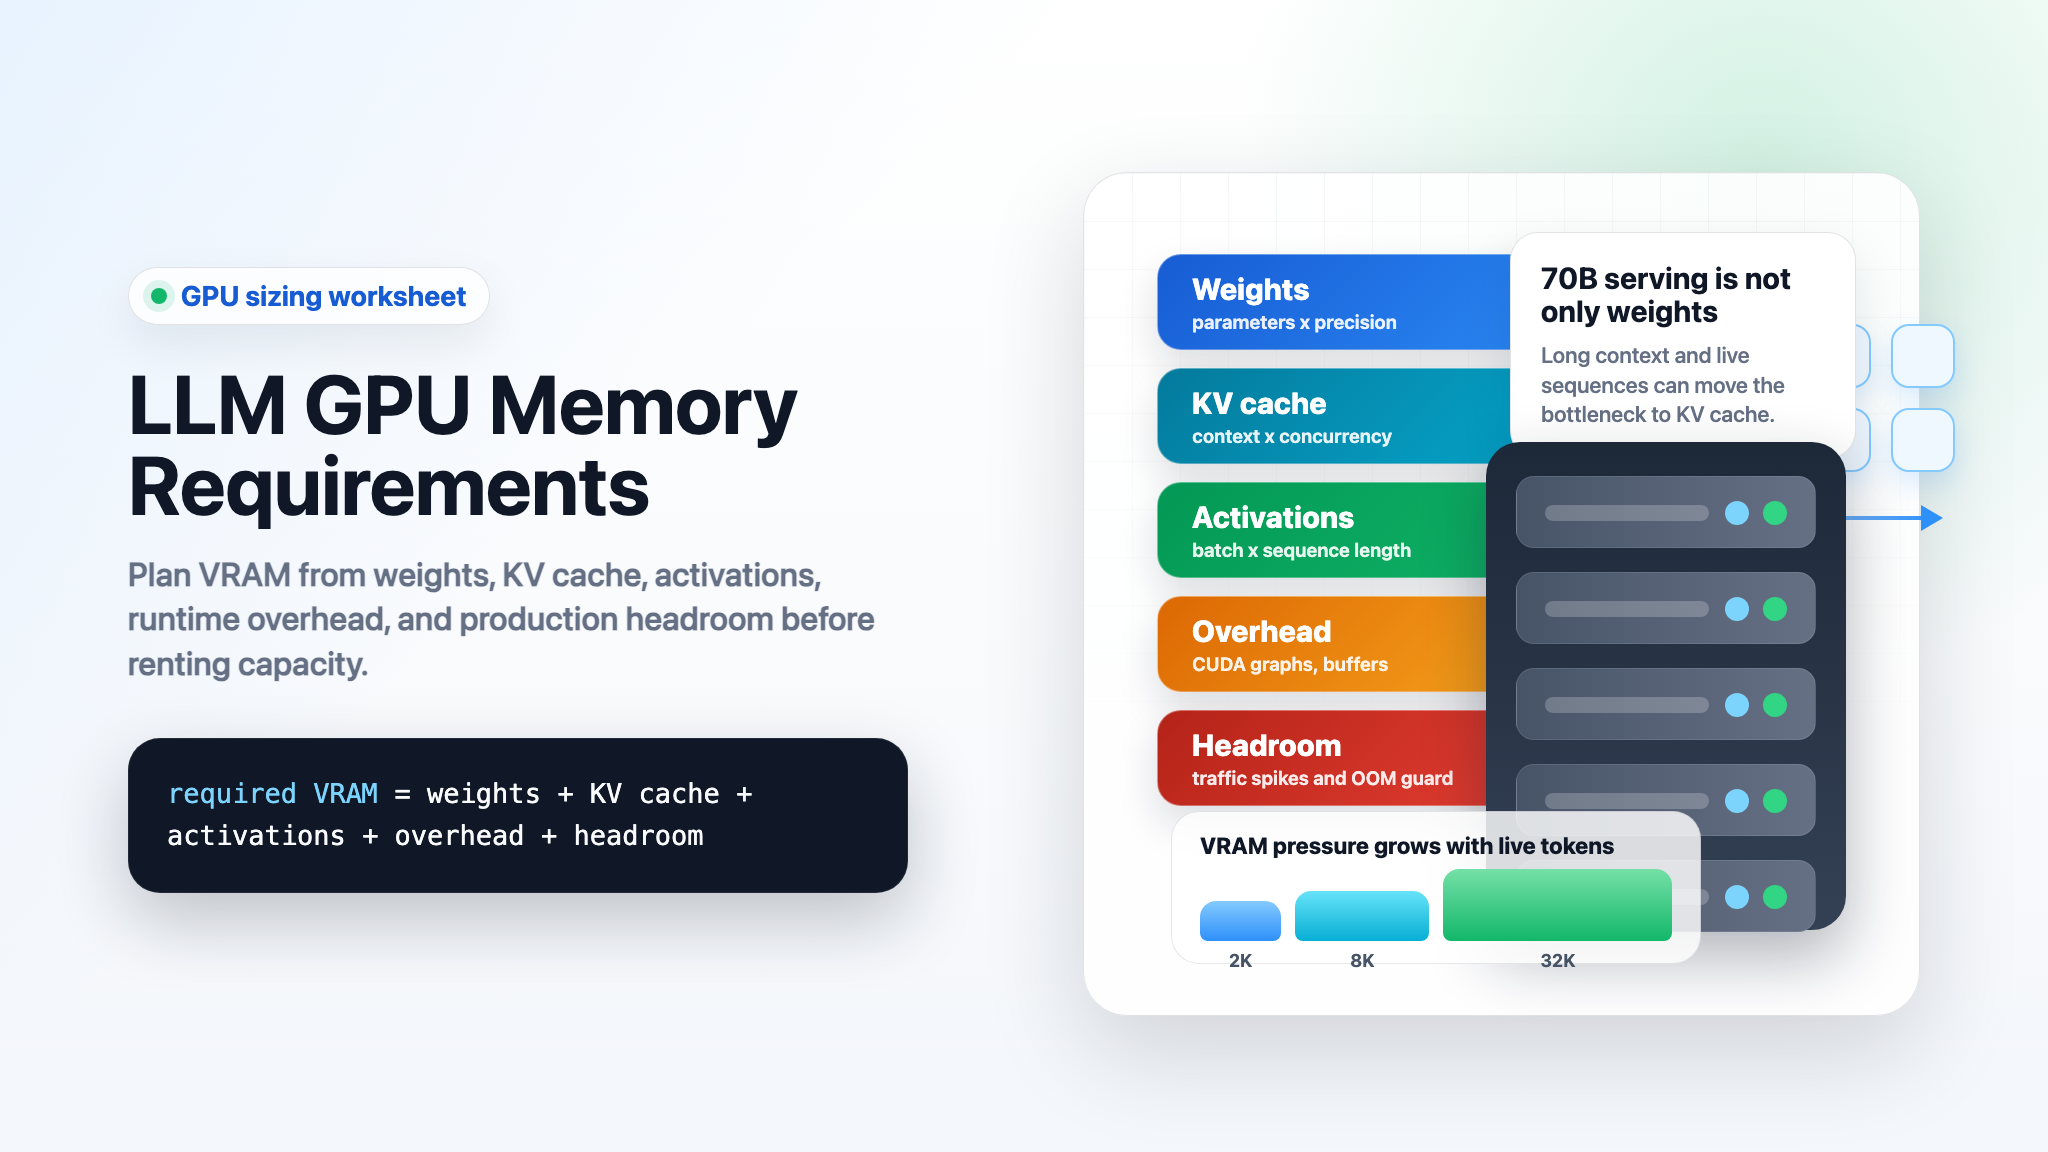
O serving de contexto longo acaba por transformar a memória da GPU num problema de agendamento. Um pedido pode terminar a sua primeira interação, mas deixar para trás um estado KV que é dispendioso de recalcular e que não é necessário na GPU neste momento. O descarregamento da cache KV é a técnica de mover blocos de cache reutilizáveis da camada rápida da GPU para uma camada maior e mais lenta — normalmente, primeiro para a RAM do host — e depois promovê-los de volta apenas quando um pedido posterior os puder reutilizar.
O objetivo não é fazer com que o armazenamento lento se comporte como HBM. O objetivo é reservar a dispendiosa capacidade de KV da GPU para o conjunto de trabalho ativo, mantendo prefixos de elevado valor disponíveis noutro local. Isto torna o descarregamento da cache KV mais útil quando o seu tráfego tem contextos longos e reutilização significativa: prompts de sistema recorrentes, estruturas de RAG, sessões com várias interações ou prefixos de documentos repetidos.
Este guia mostra como decidir se a estratificação é adequada, como os controlos atuais do vLLM se articulam, o que o TensorRT-LLM disponibiliza para descarregamento para memória do host e como testar a alteração sem trocar uma falha de falta de memória da GPU por um incidente de latência de cauda.
A resposta rápida
Utilize o descarregamento da cache KV como uma extensão controlada da reutilização de prefixos — não como uma solução de memória predefinida.
| Padrão de tráfego | Comece por | Motivo |
|---|---|---|
| Prompts de sistema longos ou prefixos de RAG repetidos | Cache de prefixos na GPU e, depois, piloto de descarregamento para CPU | Um pedido posterior pode reutilizar um prefixo em cache em vez de o recalcular. |
| Sessões interativas de longa duração com períodos de inatividade | Camada quente de GPU + CPU | O contexto inativo pode sair da memória da GPU, mantendo-se recuperável. |
| Prompts maioritariamente únicos e de uma só utilização | Primeiro, capacidade da GPU e controlo de admissão | Um bloco de cache sem reutilização futura apenas acrescenta trabalho de transferência quando é descarregado. |
| Memória da GPU limitada, mas RAM do host disponível | Pequena experiência de descarregamento para CPU | O descarregamento pode criar espaço para blocos KV ativos, mas o custo de promoção tem de permanecer dentro do SLO. |
| Necessidade de uma camada inferior durável | Camada primária de CPU mais uma camada secundária testada | Uma camada secundária pode prolongar a retenção, mas não substitui uma camada ativa rápida. |
A restrição importante é a localidade. Quando um bloco descarregado é reutilizado, tem de regressar à memória da GPU antes de a atenção o utilizar. Esse caminho de transferência faz parte do orçamento de latência do pedido.
O que uma camada de cache KV realmente armazena
Durante a geração autorregressiva, as camadas de atenção produzem tensores de chave e valor para os tokens processados. Reter esses tensores permite ao servidor evitar recalcular o prefixo já visto numa etapa posterior de descodificação ou numa reutilização de prefixo compatível. No TensorRT-LLM, a cache KV é representada como pools de blocos que guardam estado para uma contagem fixa de tokens; a respetiva documentação também descreve a reutilização entre pedidos, a retenção priorizada e o descarregamento para memória do host. Sistema de Cache KV do TensorRT-LLM
Uma pilha prática de serving costuma ter três possíveis temperaturas de armazenamento:
| Camada | Função típica | Vantagem | Custo |
|---|---|---|---|
| HBM da GPU | Estado ativo e quente de prefill e descodificação | Menor latência de acesso | Capacidade mais pequena e mais dispendiosa |
| DRAM da CPU | Blocos reutilizáveis quentes | Capacidade muito maior; pode atuar como o primeiro destino de descarregamento | A promoção para a GPU acrescenta tempo de transferência |
| Sistema de ficheiros ou camada de objetos | Blocos frios retidos | Capacidade durável ou partilhada | Custo de recuperação mais elevado e mais modos de falha operacionais |
O guia de descarregamento do vLLM é explícito quanto à ordem: o seu design multicamada utiliza a CPU como camada primária, e as transferências entre a GPU e uma camada secundária são faseadas através dessa camada de CPU. Por outras palavras, um acerto na camada fria não é uma leitura direta da GPU. Guia de Utilização de Descarregamento de KV do vLLM
              promote on a usable cache hit
Request ──> GPU HBM  <──────────────────── CPU DRAM
              │                                ▲
              │ evict completed, reusable      │ stage
              ▼                                │
          active GPU cache  ─────────────> secondary storage
                 hot                     warm / cold
Este diagrama de descarregamento da cache KV do vllm é deliberadamente simples: apenas a camada da GPU deve permanecer sempre no caminho crítico de computação. As camadas de CPU e de armazenamento devem servir uma política de reutilização mensurável.
O descarregamento da cache KV não é o descarregamento dos pesos do modelo
Esta distinção evita uma configuração incorreta surpreendentemente comum:
- O descarregamento da cache KV move o estado de atenção criado pelos pedidos. Altera principalmente a memória disponível para o contexto ativo e o caminho de reutilização.
- O descarregamento dos pesos do modelo move os parâmetros do modelo. No vLLM, o controlo
--cpu-offload-gbestá documentado na secção de descarregamento de pesos do modelo e pode acrescentar trabalho de transferência entre CPU e GPU a cada passagem forward do modelo. Argumentos de serve do vLLM
Não presuma que uma definição que permite carregar um modelo também cria mais capacidade KV utilizável. Primeiro, separe o orçamento dos pesos do modelo, o espaço de trabalho do runtime e o orçamento da cache KV; depois, decida se vale a pena reter blocos KV inativos fora da memória da GPU.
Descarregamento da cache KV no vLLM: comece pelo caminho nativo da CPU
Para a CLI atual do vLLM, a flag de descarregamento de cache KV do vLLM relevante é --kv-offloading-size. A referência oficial da CLI indica que este é o tamanho do buffer de descarregamento de KV em GiB; quando o paralelismo de tensores é superior a um, o tamanho é o total entre os ranks de paralelismo de tensores. O descarregamento é desativado quando não está definido. A opção complementar --kv-offloading-backend suporta o backend de CPU nativo e o LMCache. argumentos de serviço do vLLM
Utilize um piloto limitado em vez de dimensionar a camada de host para toda a RAM disponível:
vllm serve <your-model> \
  --gpu-memory-utilization 0.85 \
  --kv-offloading-size 16 \
  --kv-offloading-backend native
O exemplo é uma configuração experimental, não uma definição universal. O valor correto depende da disposição do cache do modelo, do comprimento do contexto, da configuração de paralelismo de tensores, da margem de RAM do host, da combinação de pedidos e do objetivo de latência. Fixe a versão da imagem do vLLM e execute vllm serve --help nessa imagem antes de colocar flags em produção; a configuração de serving evolui rapidamente.
O caminho nativo é adequado para uma primeira avaliação de descarregamento de cache KV do vLLM para CPU, pois mantém a questão da estratificação restrita: uma camada quente de CPU consegue preservar blocos úteis suficientes para melhorar a admissão ou evitar a oscilação do cache da GPU sem piorar o comportamento de p95 e p99?
Escolha a admissão de cache antes da capacidade de cache
Mais blocos retidos não significam necessariamente mais blocos úteis. Antes de aumentar o buffer de descarregamento, responda a quatro perguntas:
- Que prefixos são partilhados entre pedidos?
- Quanto tempo após a criação esses prefixos são reutilizados?
- Qual é o tamanho de um bloco útil em relação ao seu orçamento de transferência do host?
- Que blocos devem ser diretamente removidos porque a probabilidade de reutilização é demasiado baixa?
Se a carga de trabalho não conseguir responder às duas primeiras perguntas a partir de traces, comece por medir a reutilização de prefixos na GPU. Uma camada de CPU pode preservar um estado de cache quente; não consegue criar reutilização para prompts totalmente únicos.
Crie um caminho de estratificação do vLLM apenas após o piloto de CPU
O OffloadingConnector do vLLM é o caminho para uma camada primária de CPU mais camadas secundárias opcionais. O guia oficial descreve CPUOffloadingSpec para uma única camada de CPU e TieringOffloadingSpec para uma camada primária de CPU com uma ou mais camadas secundárias. Também documenta LRU e ARC como opções integradas de política de expulsão. Guia de utilização do descarregamento de KV do vLLM
O seguinte é uma configuração fiel do exemplo documentado de várias camadas. Substitua o modelo, os caminhos, o tamanho do bloco, os bytes e as contagens de threads apenas depois de os testar no seu próprio host:
vllm serve <your-model> \
  --kv-transfer-config '{
    "kv_connector": "OffloadingConnector",
    "kv_role": "kv_both",
    "kv_connector_extra_config": {
      "spec_name": "TieringOffloadingSpec",
      "cpu_bytes_to_use": 10737418240,
      "block_size": 16,
      "eviction_policy": "lru",
      "secondary_tiers": [
        {
          "type": "fs",
          "root_dir": "/mnt/kv_cache",
          "n_read_threads": 32,
          "n_write_threads": 16
        }
      ]
    }
  }'
Três detalhes operacionais importam mais do que copiar o snippet:
cpu_bytes_to_useé a reserva total da camada de CPU entre os workers, não uma sugestão vaga para o sistema operativo. Faça o orçamento para o processo, o SO, o cache de páginas do armazenamento e quaisquer serviços colocados no mesmo host.- O tamanho de bloco ou chunk configurado define a unidade de E/S. Chunks muito pequenos podem aumentar a sobrecarga de metadados e agendamento; chunks muito grandes podem promover bytes de que um pedido não necessita. Teste ambos com comprimentos de prefixo reais.
- Uma camada secundária está a jusante da CPU. Se a camada de CPU for demasiado pequena ou estiver saturada, adicionar capacidade ao sistema de ficheiros pode reter mais dados sem melhorar a latência de um acerto posterior.
Por isso, o objetivo do descarregamento de cache KV do vLLM não é «reter tudo». É «reter os blocos com um caminho de reutilização plausível e atempado».
Descarregamento de cache KV do TensorRT-LLM para memória do host
O TensorRT-LLM expõe a mesma ideia básica através da configuração do seu cache KV. A documentação indica que host_cache_size aloca memória do host para descarregamento, tem predefinição zero e permite que um bloco permaneça reutilizável até ser posteriormente removido da memória do host. Na reutilização, o bloco é copiado de volta para a memória da GPU. Sistema de cache KV do TensorRT-LLM
Numa implementação de descarregamento de cache KV do TensorRT-LLM para memória do host, preste atenção à política de retenção, bem como à capacidade:
| Controlo do TensorRT-LLM | O que verificar |
|---|---|
host_cache_size |
O orçamento de bytes é intencional e deixa margem de memória no host. |
| Prioridade de bloco / política de retenção | As regiões de prompt reutilizadas frequentemente são retidas antes dos dados descartáveis. |
secondary_offload_min_priority |
Os blocos de baixa prioridade podem ignorar o descarregamento para o host e ser removidos diretamente, reduzindo o tráfego de host evitável. |
| Reutilização de blocos entre pedidos | A reutilização continua ativada e é observável separadamente das estimativas do agendador. |
O TensorRT-LLM documenta um valor padrão de secondary_offload_min_priority de 35 no momento da redação. Trate-o como um padrão versionado, não como uma recomendação de política: um limite deve refletir o valor de reutilização observado e o custo de transferência do seu serviço.
Um método de implantação que protege a latência
Não ative uma camada fria durante um incidente de capacidade e declare sucesso quando o OOM parar. Em vez disso, execute uma sequência controlada:
- Capture uma linha de base somente de GPU. Registre a distribuição de comprimento de contexto, concorrência, tempo até o primeiro token, latência entre tokens, p50/p95/p99 de ponta a ponta, taxa de reutilização de prefixos e comportamento de evicção do KV na GPU.
- Reserve uma margem real no host. Inclua a sobrecarga de runtime e o sistema operacional; não dimensione um cache de CPU apenas com base em snapshots de memória livre.
- Ative uma pequena camada de CPU. Mantenha estáveis o modelo, a política de lotes, o perfil de tráfego e os alertas de SLO enquanto altera uma dimensão do cache.
- Compare a qualidade dos acertos, não apenas a quantidade. Separe acertos na GPU, promoções da CPU, promoções da camada fria e falhas que acionam recomputação.
- Examine a latência de cauda sob contenção. Execute solicitações mistas longas/curtas e uma rampa de concorrência. Um resultado baseado apenas na média oculta filas de transferência.
- Adicione uma camada secundária somente se o valor de retenção a justificar. Teste perda de cache, pressão de armazenamento, comportamento de reinicialização e picos de promoção antes de implantá-la amplamente.
- Defina uma regra de reversão. Por exemplo: desative a camada mais recente quando o tempo p99 até o primeiro token ou a latência entre tokens ultrapassar o orçamento acordado por uma janela sustentada.
O guia do vLLM documenta métricas de configuração e descarregamento, incluindo informações de configuração e sinais de uso do cache de CPU. Use-as com rastreamentos da aplicação; uma métrica de cache sem latência no nível da solicitação dificulta distinguir uma promoção valiosa de saturação causada por transferências. Guia de uso do descarregamento de KV do vLLM
Modos de falha a evitar no projeto
| Modo de falha | Como se manifesta | Resposta melhor |
|---|---|---|
| Tratar todos os blocos de cache como valiosos | A camada de CPU enche, as promoções aumentam, a latência piora | Admita e retenha com base em evidências de reutilização, não apenas na ordem de criação. |
| Confundir descarregamento de pesos com descarregamento de cache KV | O modelo carrega, mas a concorrência de contexto longo continua ruim | Separe os orçamentos de pesos, KV, workspace e margem de segurança. |
| Comprometer excessivamente a RAM do host | O host começa a recuperar memória ou os serviços co-localizados se desestabilizam | Reserve um orçamento fixo e faça testes de carga sob contenção realista. |
| Adicionar uma camada secundária cedo demais | Mais bytes retidos, sem melhoria significativa de SLO | Primeiro comprove a reutilização da camada de CPU; depois teste a camada fria de forma independente. |
| Ignorar a topologia de transferência | Bom resultado em laboratório, p99 ruim em nó compartilhado | Faça benchmark na topologia exata de GPU, CPU, PCIe/NVLink e caminho de armazenamento usada em produção. |
| Ocultar o comportamento do cache dos operadores | Um incidente parece uma variação aleatória de latência | Exponha sinais específicos por camada de acertos, promoções, evicções, capacidade e erros. |
Quando o descarregamento de cache KV é a otimização errada
Por enquanto, não use o descarregamento de cache KV quando:
- A memória da GPU não é o limitador.
- Os prompts são quase todos únicos, portanto os prefixos retidos não são reutilizados.
- Seu SLO principal exige latência de cauda muito baixa e não é possível demonstrar que o caminho de transferência cabe dentro dele.
- A DRAM do host ou o armazenamento já é um recurso de produção disputado.
- O cache de prefixos, o processamento em lote, os limites de contexto, a seleção de modelo ou a quantização de cache ainda não foram avaliados.
Nesses casos, o primeiro passo mais adequado pode ser uma revisão do orçamento de memória da GPU, uma política de contexto diferente ou uma mudança na arquitetura de serving. Para escolhas de topologia e paralelismo, consulte Inferência multi-GPU com vLLM, vLLM vs SGLang e TensorRT-LLM vs vLLM.
Perguntas frequentes
O descarregamento de cache KV reduz o uso de memória da GPU?
Ele pode reduzir a pressão de blocos KV reutilizáveis inativos ao movê-los para fora da camada de GPU. Não elimina a necessidade de cache residente na GPU para o trabalho de atenção ativo, e um bloco descarregado reutilizado precisa ser promovido de volta antes do uso.
Qual é a flag de descarregamento de cache KV do vLLM?
Na documentação atual da CLI do vLLM, --kv-offloading-size ativa um buffer de descarregamento de KV quando definido, enquanto --kv-offloading-backend seleciona o backend. Verifique as flags exatas na versão fixada do vLLM. Argumentos de serve do vLLM
Uma camada de sistema de arquivos é um cache direto da GPU?
Não. O vLLM documenta a CPU como a camada primária de sua implementação multicamada; as transferências entre a GPU e uma camada secundária passam pela memória da CPU. Por isso, os testes da camada secundária devem incluir todo o caminho de promoção.
O descarregamento de cache KV é melhor do que comprar uma GPU maior?
Eles resolvem restrições diferentes. Uma GPU maior pode aumentar o conjunto de trabalho quente sem sobrecarga de promoção. O descarregamento pode reter estado útil morno ou frio com a capacidade de GPU existente. Compare ambos com base na reutilização medida da carga de trabalho, no SLO de latência, na carga operacional e no custo total de serving.
Conclusão: trate o descarregamento de cache KV como uma política de cache, não como um truque de capacidade
O design mais robusto de descarregamento de cache KV mantém o estado ativo na GPU, reserva memória da CPU para reutilização em estado quente respaldada por evidências e adiciona uma camada fria apenas quando a retenção continua valiosa depois que o custo de transferência e o tratamento de falhas são medidos. Comece com um piloto limitado na CPU, instrumente as promoções e a latência por camada e promova apenas a política que melhora um SLO de produção — não apenas a quantidade de cache retida.
Se o custo operacional de uma stack de serving auto-hospedada superar o controle de que sua carga de trabalho precisa, compare uma implantação em nuvem com GPU com uma API de modelo ou explore o Flatkey Compute antes de se comprometer com uma frota maior.