
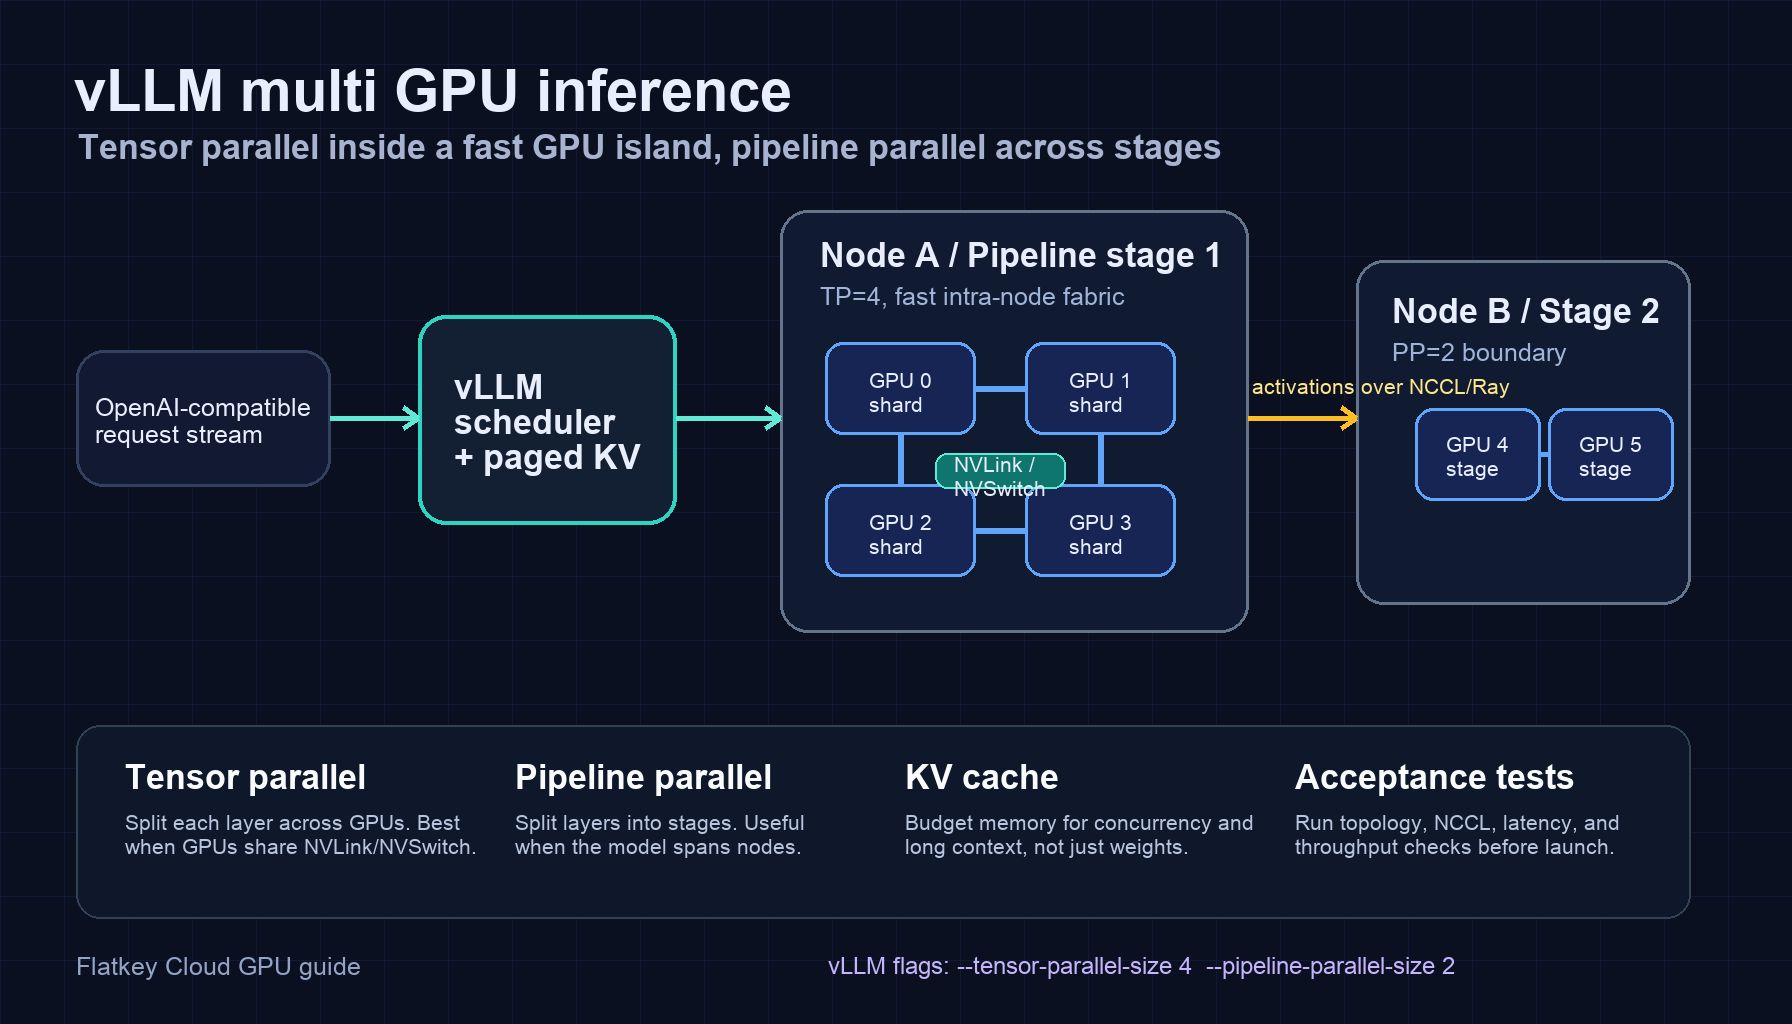
vLLM-Multi-GPU-Inferenz beginnt in der Regel aus einem von drei Gründen: Die Modellgewichte passen nicht auf eine GPU, der KV-Cache für den erforderlichen Kontext und die gewünschte Parallelität passt nicht auf eine GPU, oder eine GPU kann den von Ihnen benötigten Tokens-pro-Sekunde- und Time-to-First-Token-Wert nicht liefern. Das Setup ist nicht nur eine Entscheidung für --tensor-parallel-size. Sie müssen auch Tensor Parallelism, Pipeline Parallelism, das Executor-Backend und die physische GPU-Topologie aufeinander abstimmen.
Die Kurzfassung:
- Verwenden Sie zuerst Tensor Parallelism, wenn das Modell über GPUs innerhalb desselben schnellen GPU-Clusters passt, insbesondere bei einem 8-GPU-H100/H200/B200-Node mit NVLink oder NVSwitch.
- Fügen Sie Pipeline Parallelism hinzu, wenn das Modell mehrere Nodes überspannen muss oder wenn reines Tensor Parallelism zu viel Kommunikation zwischen Nodes verursacht.
- Betrachten Sie
tp * ppals die Anzahl der GPU-Worker, die von einer vLLM-Replica verwendet werden. - Führen Sie Benchmarks mit Ihrer echten Prompt-Länge, Ausgabelänge, Batch-Struktur und Modell-Quantisierung durch, bevor Sie das Setup als produktionsreif einstufen.
- Wenn Ihr Team nur einen OpenAI-kompatiblen Endpunkt und keine direkte Hardwarekontrolle benötigt, vergleichen Sie den GPU-Pfad mit einer verwalteten Modell-/API-Basislinie wie Flatkey, bevor Sie einen Cluster mieten und betreiben.
Dieser Leitfaden liefert ein praktisches vLLM-Multi-GPU-Inferenzbeispiel, ein Architekturdiagramm, Startbefehle und die Prüfungen, die schlechte Multi-GPU-Setups meist erkennen, bevor es die Nutzer tun.
vLLM Multi-GPU-Inferenzarchitektur
In vLLM verteilt Tensor Parallelism die Arbeit für jede Transformer-Schicht auf mehrere GPU-Worker. Pipeline Parallelism teilt die Modellschichten in Stufen auf, sodass unterschiedliche GPU-Gruppen verschiedene Teile des Modells ausführen. Für produktive Bereitstellungen wirken sich diese Entscheidungen nicht nur auf den Speicher aus: Sie verändern die kollektive Kommunikation, das Request-Scheduling, den Ausfallbereich und ob das Scale-out-Netzwerk zum Engpass wird.
Eine typische Ausgangsarchitektur ist:
| Ebene | Praktische Wahl | Warum das wichtig ist |
|---|---|---|
| API-Oberfläche | vllm serve mit dem OpenAI-kompatiblen Server |
Ermöglicht Anwendungsteams, OpenAI-ähnliche Clients beizubehalten und nur das Serving-Backend zu ändern. |
| Tensor-Parallel-Gruppe | Ein Node oder ein NVLink-/NVSwitch-Cluster | Tensor-Parallel-Schichten kommunizieren häufig, daher schaden langsame Verbindungen zwischen Nodes schnell. |
| Pipeline-Stufen | Aufteilung auf Node- oder Rack-Ebene, wenn das Modell nicht in einen Node passt | Pipeline Parallelism kann den Umfang der Kommunikation zwischen Nodes reduzieren, verglichen mit einer Tensor-Parallel-Gruppe über jede GPU hinweg. |
| Verteiltes Backend | Multiprocessing für einen Node, Ray wenn Multi-Node-Orchestrierung nötig ist | Halten Sie Single-Node-Serving einfach; verwenden Sie Ray, wenn Worker mehrere Maschinen umfassen müssen. |
| KV-Cache-Plan | Budget für Prompt-Länge, Ausgabelänge und Parallelität | Gewichte sind nur der Ausgangspunkt; Long-Context-Serving kann durch den KV-Cache begrenzt sein. |
| Abnahmetest | Topologie, NCCL, Kaltstart, TTFT, Durchsatz und Neustart nach Fehlern | Die meisten schlechten Deployments wirken zunächst in Ordnung, bis realistischer Traffic ankommt. |
Für einen angrenzenden Infrastrukturblick siehe den Leitfaden zur GPU-Cluster-Architektur. Für die Speicherdimensionierung verwenden Sie das Arbeitsblatt zu den GPU-Speicheranforderungen für LLMs, sobald es verfügbar ist.
Tensor Parallelism vs. Pipeline Parallelism in vLLM
Die nützlichste Entscheidungsregel ist einfach:
Verwenden Sie Tensor Parallelism innerhalb eines schnellen GPU-Clusters. Verwenden Sie Pipeline Parallelism, um langsamere Grenzen zu überbrücken.
Tensor Parallelism ist ein guter erster Schritt, wenn:
- das Modell zu groß für eine GPU ist, aber über 2, 4 oder 8 GPUs in einem Node passt;
- Ihr GPU-Node über hochbandbreite GPU-zu-GPU-Verbindungen verfügt;
- Latenz wichtig ist und jede Anfrage durch eine logische Modell-Replica laufen soll, ohne eine lange Pipeline-Blase;
- die Modellfamilie von der Tensor-Parallel-Ausführung in vLLM gut unterstützt wird.
Pipeline Parallelism wird nützlich, wenn:
- das Modell selbst nach Quantisierung oder geringerer Präzision nicht in einen einzelnen Node passt;
- eine Tensor-Parallel-Gruppe sonst zu häufig Ethernet oder InfiniBand überqueren würde;
- Sie möchten, dass jeder Node eine Stufe des Modells besitzt, statt dass jede Schicht an kollektivem Cross-Node-Verkehr teilnimmt;
- Sie den mit Pipeline-Stufen verbundenen Scheduling- und Bubble-Overhead tolerieren können.
Nehmen Sie nicht an, dass tp=8 immer besser ist als tp=4, oder dass pp=2 den Durchsatz automatisch verbessert. Für die vLLM-Multi-GPU-Inferenz hängt die richtige Form von Modellgröße, Speicherdruck, Interconnect, Sequenzlängen und davon ab, wie viel Batch-Parallelität Ihre Arbeitslast verkraften kann.
Beispiel für vLLM-Multi-GPU-Inferenz auf einem einzelnen Node
Beginnen Sie nach Möglichkeit mit einem einzelnen Node. Das ist einfacher zu debuggen, günstiger zu benchmarken und vermeidet Multi-Node-Netzwerke als erste Fehlerdomäne.
Beispiel: ein Server mit 4 GPUs, eine vLLM-Replica, Tensor-Parallel-Größe 4.
CUDA_VISIBLE_DEVICES=0,1,2,3 \
vllm serve meta-llama/Llama-3.1-70B-Instruct \
  --host 0.0.0.0 \
  --port 8000 \
  --tensor-parallel-size 4
Verwenden Sie diese Form, wenn ein Modell sauber über vier GPUs passt und der Node über schnelle GPU-zu-GPU-Kommunikation verfügt. Testen Sie bei einem 8-GPU-Node sowohl --tensor-parallel-size 4 als auch --tensor-parallel-size 8; die größere Gruppe kann mehr Speicherreserve bieten, aber auch zusätzlichen Kommunikationsaufwand verursachen.
Einfacher Smoke-Test:
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "meta-llama/Llama-3.1-70B-Instruct",
    "messages": [{"role": "user", "content": "Give me a one-sentence GPU health check."}],
    "max_tokens": 64
  }'
Wenn das fehlschlägt, gehen Sie noch nicht zu Multi-Node über. Beheben Sie zuerst den Model-Download, die CUDA-Sichtbarkeit, die NCCL-Sichtbarkeit, die Kompatibilität von Treiber und Runtime sowie den GPU-Speicherdruck.
Multi-Node-Beispiel mit Tensor- und Pipeline-Parallelismus
Wenn Sie mehr GPUs benötigen, als ein einzelner Knoten bereitstellen kann, halten Sie die Tensor-Parallel-Gruppe nach Möglichkeit innerhalb jedes Knotens und verwenden Sie dann Pipeline-Parallelismus über die Knoten hinweg.
Beispiel für die Zielstruktur:
- zwei Knoten;
- vier GPUs pro Knoten;
- Tensor-Parallel-Größe 4;
- Pipeline-Parallel-Größe 2;
- gesamte Worker:
4 * 2 = 8.
Konzeptioneller Start:
vllm serve meta-llama/Llama-3.1-405B-Instruct \
  --host 0.0.0.0 \
  --port 8000 \
  --tensor-parallel-size 4 \
  --pipeline-parallel-size 2 \
  --distributed-executor-backend ray
In einem echten Cluster starten Sie Ray auf dem Head-Node, verbinden die Worker-Knoten mit diesem Ray-Cluster, machen den Modellspeicher für alle Knoten erreichbar und bestätigen, dass alle Worker die beabsichtigte GPU-Anzahl sehen, bevor Sie den vLLM-Server starten. Fixieren Sie Ihre exakte vLLM-Version, das CUDA-Image, den Treiber-Branch und die Modellrevision im Runbook, damit ein späterer Neubau das Verhalten nicht stillschweigend verändert.
An diesem Punkt wird Infrastrukturqualität zu Produktqualität. Wenn der zweite Knoten über ein schwaches Netzwerk verbunden ist, wenn NCCL die falsche Schnittstelle auswählt oder wenn der Modell-Cache-Pfad langsam ist, sehen Benutzer das als Latenzschwankungen, lange Kaltstarts oder fehlgeschlagene Anfragen.
Backend-Auswahl: Multiprocessing oder Ray
Für die Unterstützung der vLLM-Multi-GPU-Inferenz verwenden Sie das einfachste Executor-Backend, das zur Bereitstellung passt:
| Bereitstellung | Empfohlenes Backend | Hinweise |
|---|---|---|
| Eine Maschine, mehrere GPUs | Multiprocessing oder der vLLM-Standard für Ihre Version | Einfacher zu betreiben; weniger bewegliche Teile. |
| Mehrere Maschinen | Ray | Erforderlich, wenn Worker über Knoten hinweg verteilt sind und Cluster-übergreifende Koordination benötigen. |
| Kubernetes-Multi-Node-Serving | Ray plus explizite Planung von Pods/Netzwerk/Speicher | Planung, Platzierung und Health Checks sichtbar machen, statt zu hoffen, dass der Serving-Prozess die richtigen GPUs findet. |
Die Backend-Wahl sollte nicht isoliert von der Topologie betrachtet werden. Wenn Sie Ray nur brauchen, weil das Modell zu groß für einen Server ist, lautet die nächste Frage, ob Pipeline-Parallelismus den Großteil der häufigen Kommunikation innerhalb jedes Knotens halten kann.
Speicherplanung, bevor Sie TP und PP wählen
Ein vLLM-Multi-GPU-Inferenzplan sollte den Speicher in dieser Reihenfolge budgetieren:
- Gewichte: Modellparameter nach Datentyp oder Quantisierung.
- KV-Cache: Prompt-Länge, Ausgabelänge, Batch-Konkurrenz und Cache-Datentyp.
- Laufzeit-Overhead: CUDA-Graphs, Allokatorverhalten, Kommunikationspuffer, Tokenizer/Server-Overhead und Sicherheitsreserve.
- Betriebliche Reserve: Rolling Restarts, Modell-Neuladen, Telemetrie und gelegentliche Prompt-Spitzen.
Tensor-Parallelismus verteilt Modellgewichte und einen Teil der Rechenarbeit auf mehrere GPUs, macht den Verkehr aber nicht kostenlos. Pipeline-Parallelismus kann den Speicherdruck pro Stage verringern, bringt aber Fragen der Stage-Ausbalancierung mit sich. Eine Pipeline-Stage mit höherem Speicherdruck oder langsameren Kernen wird zum Durchsatzlimit für die gesamte Replik.
Praktische Erstwahl:
| Modell-/Runtime-Situation | Erste TP/PP-Form zum Testen |
|---|---|
| 7B- oder 8B-Modell, gewöhnlicher Kontext | tp=1, eine GPU, Replikate horizontal skalieren |
| 32B-Modell, hohe Parallelität | tp=2 oder tp=4 auf einem Knoten |
| Modell der 70B-Klasse, BF16/FP16 | tp=4 oder tp=8 auf einem Knoten mit hohem Speicher |
| Sehr großes dichtes Modell über mehrere Knoten | tp=4, pp=2 oder tp=8, pp=2, abhängig von der Knotengröße |
| MoE-Modell | Prüfen Sie die vLLM-Anleitung zum Expert-Parallelismus separat; behandeln Sie MoE nicht standardmäßig wie ein dichtes Modell |
Die Tabelle ist ein Ausgangspunkt, kein Benchmark-Ergebnis. Ihre akzeptierten Ausgabekosten hängen von realen Prompts, realen Ausgaben, der Retry-Rate, dem Queueing-Verhalten und der Qualitätsakzeptanz ab.
Topologieprüfungen, die wichtig sind
Bevor Sie einen Multi-GPU-Endpoint veröffentlichen, sammeln Sie diese Fakten vom Provider oder von der Maschine:
nvidia-smi topo -m-Ausgabe für jeden Knoten;- ob GPUs innerhalb des Knotens NVLink oder NVSwitch gemeinsam nutzen;
- Netzwerk-Fabric zwischen den Knoten, einschließlich InfiniBand, RoCE, EFA oder Ethernet;
- NCCL-sichtbare Schnittstellen und ob der Traffic den vorgesehenen Pfad verwendet;
- Speicherpfad für Modellgewichte und ob mehrere Knoten von einer langsamen gemeinsamen Festplatte laden;
- GPU-Speicher, MIG-Status, Power Caps und Treiber-/CUDA-Versionen.
NVIDIA-DGX-H100/H200-Systeme sind beispielsweise als Acht-GPU-Systeme mit NVSwitch-/NVLink-GPU-zu-GPU-Konnektivität und 400-Gb/s-Netzwerkoptionen dokumentiert. Commodity-PCIe-Knoten können vLLM dennoch gut bedienen, aber Sie sollten ein anderes Kommunikationsprofil erwarten und entsprechend benchmarken.
Hintergrund zu Interconnects finden Sie unter NVLink vs NVSwitch. Für Beschaffung und Topologiebegrifflichkeiten im Cluster ist der Leitfaden zur Miete von GPU-Clustern eine nützliche Ergänzung.
Production-Abnahmetest
Führen Sie einen gestaffelten Test statt eines einzelnen Happy-Path-Prompts aus.
- Topologie-Test: speichern Sie
nvidia-smi topo -m, NIC-Inventar und die NCCL-Umgebung. - Cold-Load-Test: messen Sie die Zeit vom Containerstart bis zum ersten erfolgreichen Token.
- Test mit kurzem Prompt: geringe Prompt-Länge, moderate Ausgabelänge, erwartete Chat-Workload.
- Test mit langem Prompt: realistische Kontextlänge nahe Ihrer Produktanforderung.
- Concurrency-Sweep: erhöhen Sie die gleichzeitigen Anfragen, bis p95 Time-to-first-Token oder p95 Inter-Token-Latenz Ihr Limit überschreitet.
- Output-intensive Test: verwenden Sie Workloads, die lange Abschlüsse erzeugen, nicht nur Klassifikations-Prompts.
- Fehlertest: beenden Sie einen Worker-Prozess oder einen Knoten und verifizieren Sie, dass der Load Balancer die Replik entfernt.
- Neustart-Test: rollen Sie den vLLM-Prozess neu aus und bestätigen Sie, dass Model-Cache, Ray-Status und Health Checks sauber wiederhergestellt werden.
Verfolgen Sie mindestens diese Metriken:
| Metrik | Warum sie wichtig ist |
|---|---|
| Zeit bis zum ersten Token | Nutzer nehmen dies in Chat- und Agenten-Workflows sofort wahr. |
| Inter-Token-Latenz | Zeigt die Stabilität der Dekodierung nach dem Start der Generierung. |
| Tokens pro Sekunde pro Replik | Hilft beim Vergleich von TP/PP-Formen. |
| GPU-Speicherpuffer | Zeigt an, ob lange Kontextspitzen zu OOM führen werden. |
| Wartezeit in der Queue | Trennt Serving-Kapazität von Anwendungs-Latenz. |
| Fehler- und Retry-Rate | Verwandelt Infrastrukturinstabilität in reale Kosten. |
| Akzeptierte Ausgaberate | Vermeidet Optimierung für billige Tokens, die Nutzer ablehnen. |
Troubleshooting-Muster
Das Modell lädt, aber der Durchsatz ist mit mehr GPUs schlechter.
Die TP-Gruppe ist möglicherweise zu groß für die Topologie, oder der Workload hat möglicherweise nicht genug Parallelität, um die Kommunikation zu amortisieren. Testen Sie kleineres TP, mehr Replikate oder eine andere Batch-/Concurrency-Konfiguration.
Der Multi-Node-Start hängt.
Überprüfen Sie Ray-Mitgliedschaft, Firewall-Regeln, NCCL-Schnittstellenauswahl, Container-Netzwerk und ob jeder Node denselben Modellpfad erreichen kann. Debuggen Sie dies nicht zuerst auf der API-Ebene.
Eine GPU läuft in OOM, während andere noch Spielraum haben.
Achten Sie auf ungleichmäßige Pipeline-Stufen, unterschiedliche GPU-SKUs, Speicherfragmentierung oder ein Problem bei der Rank-Zuweisung. Bestätigen Sie, dass jeder Worker die beabsichtigte sichtbare GPU verwendet.
Latzenzspitzen bei langen Prompts.
KV-Cache-Druck, Prefill-Kosten und Scheduler-Queueing sind wahrscheinliche Ursachen. Testen Sie separate Prompt-Längen-Buckets, bevor Sie die Hardware ändern.
Der Endpunkt funktioniert im Terminal, schlägt aber hinter einem Load Balancer fehl.
Überprüfen Sie Streaming-Timeout, Idle-Timeout, Health-Check-Pfad, Limits für die Request-Body-Größe und ob der Load Balancer Verkehr an eine Replik sendet, bevor das Modell warm ist.
Wann Sie vLLM Multi-GPU-Inferenz nicht selbst betreiben sollten
vLLM zu betreiben ist die richtige Wahl, wenn Sie Kontrolle auf Modellebene, private Gewichte, benutzerdefinierte Kernel, kundenspezifische Quantisierung oder Experimente auf Hardware-Ebene benötigen. Es ist nicht automatisch die richtige Wahl, wenn die geschäftliche Anforderung einfach lautet: „Gebt unserer App eine zuverlässige OpenAI-kompatible API.“
Bevor Sie einen Multi-Node-GPU-Cluster mieten, vergleichen Sie den Self-Hosted-Ansatz mit einem verwalteten Modell-/API-Ansatz:
| Anforderung | vLLM auf GPUs selbst hosten | Verwaltete Modell-/API-Baseline |
|---|---|---|
| Benutzerdefinierte/private Gewichte | Sehr gute Passung | Meist nicht ausreichend |
| Hardware-Experimente | Sehr gute Passung | Nicht der Punkt |
| Schnelle Produktintegration | Mehr operativer Aufwand | Sehr gute Passung |
| Wechsel zwischen mehreren Modellen | Sie betreiben jeden Stack selbst | Ein Gateway kann den Zugang vereinfachen |
| Abrechnung und Nutzungstransparenz | Selbst bauen oder integrieren | Oft enthalten |
| Fehlerbehandlung | Liegt in Ihrer Verantwortung | Provider/Gateway übernimmt mehr davon |
Flatkey ist der Vergleichspunkt, wenn Sie einen einzigen OpenAI-kompatiblen Key, ein Guthaben und Zugriff auf offizielle Modellendpunkte möchten, ohne die GPU-Serving-Schicht selbst zu betreiben. Wenn direkte Hardware-Kontrolle nicht die Produktanforderung ist, benchmarken Sie gegen eine Modell-/API-Baseline, bevor Sie sich auf Cluster-Betrieb festlegen.
Häufig gestellte Fragen
Unterstützt vLLM Multi-GPU-Inferenz?
Ja. vLLM unterstützt Multi-GPU-Inferenz über Tensor Parallelism und Pipeline Parallelism, mit Executor-Optionen für Single-Node- und Multi-Node-Serving. Der genaue Unterstützungspfad hängt von Ihrer vLLM-Version, der Modellarchitektur, der GPU-Topologie und dem Deployment-Backend ab.
Was ist die beste Tensor-Parallel-Größe für vLLM?
Die beste Tensor-Parallel-Größe ist der kleinste TP-Wert, der genug Speicherpuffer und Durchsatz für Ihren Workload liefert. Beginnen Sie mit den GPUs in einem schnellen Node und benchmarken Sie dann tp=2, tp=4 oder tp=8 mit realen Prompt- und Ausgabe-Längen.
Wann sollte ich Pipeline Parallelism in vLLM verwenden?
Verwenden Sie Pipeline Parallelism, wenn das Modell oder der KV-Cache-Bedarf Sie über einen Node hinaus zwingt oder wenn es besser ist, Tensor-Parallel-Kommunikation innerhalb jedes Nodes zu halten, statt eine einzige cross-node TP-Gruppe aufzubauen.
Ist Ray für vLLM Multi-GPU-Serving erforderlich?
Ray ist typischerweise die praktische Wahl für Multi-Node-vLLM-Serving. Für einen Node kann ein Multiprocessing-Backend oder das Standard-Backend Ihrer vLLM-Version einfacher sein.
Woran erkenne ich, ob ein vLLM Multi-GPU-Inferenz-Setup produktionsreif ist?
Es ist erst dann produktionsreif, wenn Topologie-Checks, Cold-Load-Tests, realistische Prompt-/Concurrency-Benchmarks, Health Checks, Restart-Tests und das Fehlerverhalten dokumentiert sind. Eine einzelne erfolgreiche curl-Anfrage reicht nicht aus.


