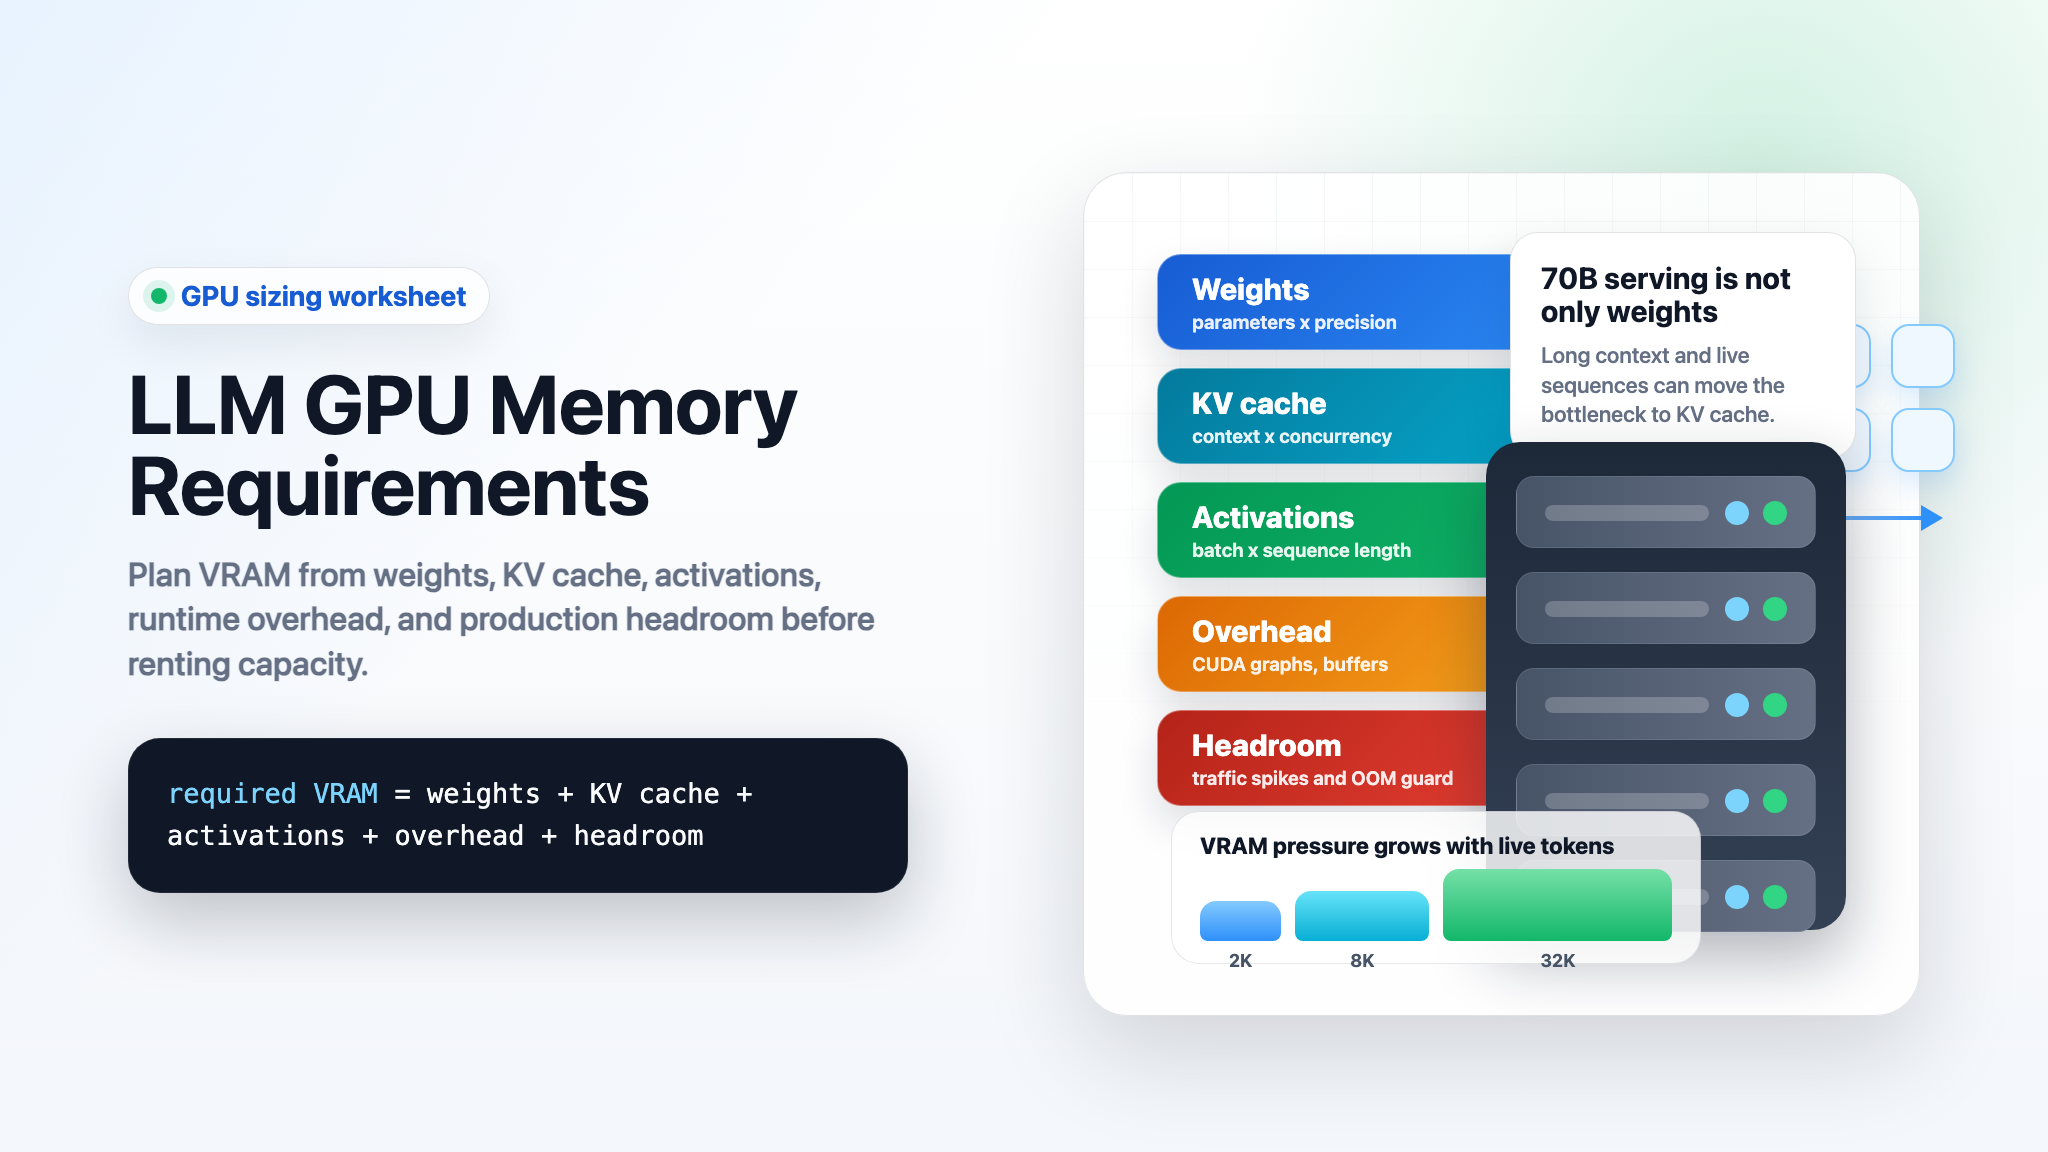
長文コンテキストのサービングでは、やがてGPUメモリがスケジューリングの問題になります。リクエストは最初のターンを完了しても、再計算にはコストがかかり、現時点ではGPU上で不要なKV状態を残す場合があります。KVキャッシュオフロードとは、再利用可能なキャッシュブロックを高速なGPU階層から、より大容量で低速な階層(通常はまずホストRAM)へ移動し、後続のリクエストで再利用できる場合にのみGPUへ戻す手法です。
目的は、低速ストレージをHBMのように見せることではありません。目的は、高価なGPUのKV容量をアクティブなワーキングセット用に確保しながら、高価値なプレフィックスを別の場所で利用可能な状態に保つことです。このため、KVキャッシュオフロードが最も有用なのは、トラフィックに長いコンテキストと意味のある再利用がある場合です。たとえば、繰り返されるシステムプロンプト、RAGの足場、マルチターンセッション、または反復されるドキュメントプレフィックスです。
このガイドでは、階層化が適切かどうかの判断方法、現在のvLLMコントロールの組み合わせ方、TensorRT-LLMがホストメモリオフロードで提供する機能、そしてGPUのメモリ不足障害をテールレイテンシのインシデントに置き換えることなく変更をテストする方法を説明します。
簡潔な回答
KVキャッシュオフロードは、デフォルトのメモリ対策としてではなく、プレフィックス再利用を制御可能な形で拡張するために使用してください。
| トラフィックパターン | まず始めること | 理由 |
|---|---|---|
| 繰り返される長いシステムプロンプトまたはRAGプレフィックス | GPUプレフィックスキャッシュ、その後CPUオフロードのパイロット | 後続のリクエストでは、キャッシュされたプレフィックスを再計算せずに再利用できます。 |
| 非アクティブ期間がある長時間のインタラクティブセッション | GPU + CPUウォーム階層 | 非アクティブなコンテキストはGPUメモリから退避できますが、復元可能な状態を維持できます。 |
| ほとんどがワンショットで一意のプロンプト | まずGPU容量とアドミッション制御 | 将来再利用されないキャッシュブロックは、オフロード時に転送処理を増やすだけです。 |
| GPUメモリは逼迫しているが、ホストRAMは利用可能 | 小規模なCPUオフロード実験 | オフロードはアクティブなKVブロック用の空きを作れますが、昇格コストはSLO内に収める必要があります。 |
| 永続的な下位階層が必要 | CPUのプライマリ階層とテスト済みのセカンダリ階層 | セカンダリ階層は保持期間を延長できますが、高速なアクティブ階層の代替ではありません。 |
重要な制約はローカリティです。オフロードされたブロックを再利用する際は、attentionが使用する前にGPUメモリへ戻す必要があります。この転送パスはリクエストのレイテンシ予算の一部です。
KVキャッシュ階層が実際に格納するもの
自己回帰生成では、attention層が処理済みトークンのキーおよびバリューテンソルを生成します。これらのテンソルを保持することで、サーバーは後続のデコードステップや互換性のあるプレフィックス再利用時に、すでに処理したプレフィックスを再計算せずに済みます。TensorRT-LLMでは、KVキャッシュは固定トークン数の状態を保持するブロックプールとして表現されます。そのドキュメントでは、リクエスト間での再利用、優先度付き保持、ホストメモリオフロードについても説明されています。TensorRT-LLM KV Cache System
実用的なサービングスタックには通常、3つのストレージ温度帯があります。
| 階層 | 一般的な役割 | 利点 | コスト |
|---|---|---|---|
| GPU HBM | ホットなアクティブのprefillおよびdecode状態 | 最も低いアクセスレイテンシ | 容量が最小で最も高価 |
| CPU DRAM | ウォームな再利用可能ブロック | はるかに大きい容量。最初のオフロード先として機能可能 | GPUへの昇格に転送時間が追加される |
| ファイルシステムまたはオブジェクト階層 | コールドな保持ブロック | 永続的または共有の容量 | 取得コストが最も高く、運用上の障害モードも多い |
vLLMのオフロードガイドでは、順序が明確に示されています。そのマルチ階層設計ではCPUをプライマリ階層として使用し、GPUとセカンダリ階層間の転送はこのCPU階層を経由して段階的に行われます。言い換えると、コールド階層のヒットはGPUによる直接読み取りではありません。vLLM KV Offloading Usage Guide
              利用可能なキャッシュヒット時に昇格
Request ──> GPU HBM  <──────────────────── CPU DRAM
              │                                ▲
              │ 完了済みで再利用可能なものを退避 │ ステージング
              ▼                                │
          アクティブGPUキャッシュ ─────────────> セカンダリストレージ
                 ホット                     ウォーム / コールド
このvllm kv cache offload diagramは意図的に単純化されています。常にクリティカルな計算パス上に置くべきなのはGPU階層だけです。CPUおよびストレージ階層は、測定可能な再利用ポリシーに従うべきです。
KVキャッシュオフロードはモデル重みのオフロードではない
この区別により、驚くほどよくある設定ミスを防げます。
- KVキャッシュオフロードは、リクエストによって作成されたattention状態を移動します。主に、アクティブなコンテキストで利用可能なメモリと再利用パスを変えます。
- モデル重みのオフロードは、モデルパラメータを移動します。vLLMでは、
--cpu-offload-gbコントロールはモデル重みのオフロードとして文書化されており、各モデルforward passにCPU-GPU間の転送処理を追加する可能性があります。vLLM serve arguments
モデルをロードできる設定が、使用可能なKV容量も増やすと想定しないでください。まずモデル重みの予算、ランタイムワークスペース、KVキャッシュの予算を分けて考え、そのうえで非アクティブなKVブロックをGPUメモリ外に保持する価値があるかを判断してください。
vLLM KVキャッシュオフロード: ネイティブCPUパスから始める
現在のvLLM CLIでは、該当するvllm kv cache offload flagは--kv-offloading-sizeです。公式CLIリファレンスによると、これはGiB単位のKVオフロードバッファサイズです。テンソル並列度が1を超える場合、このサイズはテンソル並列ランク全体の合計になります。未設定の場合、オフロードは無効です。併用する--kv-offloading-backendは、ネイティブCPUバックエンドとLMCacheをサポートします。vLLM serve arguments
ホスト層を利用可能なRAM全体に合わせてサイジングするのではなく、上限を設けたパイロットから始めてください。
vllm serve <your-model> \
  --gpu-memory-utilization 0.85 \
  --kv-offloading-size 16 \
  --kv-offloading-backend native
この例は実験時の構成例であり、汎用的な設定ではありません。適切な値は、モデルのキャッシュレイアウト、コンテキスト長、テンソル並列構成、ホストRAMの余裕、リクエストの構成、およびレイテンシ目標によって異なります。フラグを本番環境に導入する前にvLLMイメージのバージョンを固定し、そのイメージでvllm serve --helpを実行してください。サービング構成は急速に進化しています。
ネイティブパスは、階層化に関する検討対象を絞り込めるため、最初のvllm kv cache offload cpu検証に適しています。すなわち、CPUウォーム層は、有用なブロックを十分に保持してアドミッションを改善するか、あるいはp95およびp99の挙動を悪化させずにGPUキャッシュのチャーンを回避できるでしょうか。
キャッシュ容量より先にキャッシュアドミッションを選択する
保持ブロックを増やしても、必ずしも有用なブロックが増えるとは限りません。オフロードバッファを増やす前に、次の4つの質問に答えてください。
- どのプレフィックスがリクエスト間で共有されていますか。
- それらのプレフィックスは作成後どのくらいで再利用されますか。
- 有用なブロックは、ホスト転送予算に対してどの程度の大きさですか。
- 再利用される可能性が低すぎるため、どのブロックを完全に退避すべきですか。
ワークロードがトレースから最初の2つの質問に答えられない場合は、まずGPU上でプレフィックス再利用を測定してください。CPU層はウォームなキャッシュ状態を保持できますが、完全にユニークなプロンプトに対して再利用を生み出すことはできません。
CPUパイロット後にのみvLLMの階層化パスを構築する
vLLMのOffloadingConnectorは、CPUプライマリ層とオプションのセカンダリ層を実現するためのパスです。公式ガイドでは、単一のCPU層にはCPUOffloadingSpec、CPUプライマリ層と1つ以上のセカンダリ層にはTieringOffloadingSpecを説明しています。また、組み込みの退避ポリシーの選択肢としてLRUとARCも記載しています。vLLM KV Offloading Usage Guide
以下は、文書化されたマルチティアの例に忠実な構成例です。モデル、パス、ブロックサイズ、バイト数、スレッド数は、自身のホストでテストした後にのみ置き換えてください。
vllm serve <your-model> \
  --kv-transfer-config '{
    "kv_connector": "OffloadingConnector",
    "kv_role": "kv_both",
    "kv_connector_extra_config": {
      "spec_name": "TieringOffloadingSpec",
      "cpu_bytes_to_use": 10737418240,
      "block_size": 16,
      "eviction_policy": "lru",
      "secondary_tiers": [
        {
          "type": "fs",
          "root_dir": "/mnt/kv_cache",
          "n_read_threads": 32,
          "n_write_threads": 16
        }
      ]
    }
  }'
スニペットをコピーすることよりも、次の3つの運用上の詳細が重要です。
cpu_bytes_to_useは、ワーカー全体におけるCPU層の総予約量であり、OSに対する曖昧な提案ではありません。プロセス、OS、ストレージのページキャッシュ、および同居するサービスを考慮して予算を組んでください。- 構成したブロックまたはチャンクサイズがI/O単位を設定します。非常に小さなチャンクはメタデータおよびスケジューリングのオーバーヘッドを増やす可能性があり、非常に大きなチャンクはリクエストが必要としないバイトまで昇格させる可能性があります。実際のプレフィックス長を用いて両方をテストしてください。
- セカンダリ層はCPUの下流にあります。CPU層が小さすぎる、または飽和している場合、ファイルシステム容量を追加しても、より多くのデータを保持できるだけで、後続のヒット時のレイテンシが改善されない可能性があります。
したがって、vllm kv cache offloadの目的は「すべてを保持する」ことではありません。「もっともらしく、かつ適時に再利用される経路を持つブロックを保持する」ことです。
TensorRT-LLMのKVキャッシュをホストメモリへオフロードする
TensorRT-LLMは、KVキャッシュ構成を通じて同じ基本的な考え方を提供します。そのドキュメントによると、host_cache_sizeはオフロード用のホストメモリを割り当て、デフォルトはゼロであり、ホストメモリから後で退避されるまでブロックを再利用可能な状態に保ちます。再利用時には、ブロックがGPUメモリにコピーされ戻されます。TensorRT-LLM KV Cache System
tensorrt-llm kv cache offload host memoryを展開する際は、容量だけでなく保持ポリシーにも注意してください。
| TensorRT-LLMの制御項目 | 確認すべきこと |
|---|---|
host_cache_size |
バイト予算が意図したものであり、ホストメモリの余裕を残していること。 |
| ブロック優先度 / 保持ポリシー | 頻繁に再利用されるプロンプト領域が、破棄可能なデータより優先して保持されること。 |
secondary_offload_min_priority |
低優先度のブロックがホストへのオフロードをバイパスして直接退避可能であり、回避可能なホストトラフィックを削減できること。 |
| リクエスト間のブロック再利用 | 再利用が有効なままであり、スケジューラの推定値とは別に観測可能であること。 |
執筆時点で、TensorRT-LLM はデフォルトの secondary_offload_min_priority を 35 と文書化しています。これをポリシー上の推奨ではなく、バージョンに紐づくデフォルトとして扱ってください。しきい値は、サービスで観測された再利用価値と転送コストを反映すべきです。
レイテンシを守るロールアウト方法
キャパシティ障害の最中にコールド階層を有効化し、OOM が止まっただけで成功と判断してはいけません。代わりに、制御された手順で進めます。
- GPU のみのベースラインを取得する。 コンテキスト長の分布、同時実行数、最初のトークンまでの時間、トークン間レイテンシ、エンドツーエンドの p50/p95/p99、プレフィックス再利用率、GPU KV の退避挙動を記録します。
- 実際に必要なホスト側ヘッドルームを確保する。 ランタイムのオーバーヘッドとオペレーティングシステムを含めてください。空きメモリのスナップショットだけを基に CPU キャッシュをサイジングしてはいけません。
- 小規模な CPU 階層を有効化する。 キャッシュの 1 つの次元だけを変更する間、モデル、バッチポリシー、トラフィック形状、SLO アラートを安定させます。
- ヒット数だけでなくヒットの品質を比較する。 GPU ヒット、CPU からの昇格、コールド階層からの昇格、再計算をトリガーするミスを区別します。
- 競合下でのテールレイテンシを調べる。 長短のリクエストを混在させ、同時実行数を段階的に増やして実行します。平均値だけの結果では転送キューが隠れてしまいます。
- 保持価値が正当化できる場合にのみセカンダリ階層を追加する。 広範にロールアウトする前に、キャッシュ損失、ストレージ圧迫、再起動時の挙動、昇格バーストをテストします。
- ロールバックルールを設定する。 例: p99 の最初のトークンまでの時間またはトークン間レイテンシが、合意した予算を一定期間にわたり超過した場合は、最新の階層を無効化します。
vLLM ガイドには、設定情報や CPU キャッシュ使用量シグナルを含む、設定およびオフロードのメトリクスが記載されています。これらをアプリケーショントレースと併用してください。リクエストレベルのレイテンシがないキャッシュメトリクスでは、価値のある昇格と転送スラッシングを区別することが困難です。 vLLM KV Offloading Usage Guide
設計で排除すべき障害モード
| 障害モード | 現れ方 | より良い対応 |
|---|---|---|
| すべてのキャッシュブロックを価値があるものとして扱う | CPU 階層が埋まり、昇格が増加し、レイテンシが悪化する | 作成順だけでなく、再利用の根拠に基づいて受け入れと保持を行う。 |
| 重みのオフロードと KV キャッシュのオフロードを混同する | モデルはロードされるが、長文コンテキストの同時実行性は依然として低い | 重み、KV、ワークスペース、セーフティヘッドルームの予算を分ける。 |
| ホスト RAM を過剰に割り当てる | ホストがメモリ回収を開始する、または同居サービスが不安定になる | 固定予算を確保し、現実的な競合下で負荷テストを行う。 |
| セカンダリ階層を早すぎる段階で追加する | 保持バイト数は増えるが、意味のある SLO 改善がない | まず CPU 階層での再利用を実証し、その後コールド階層を独立してテストする。 |
| 転送トポロジを無視する | ラボでは良好な結果だが、共有ノードの p99 は低調 | 本番で使用する正確な GPU、CPU、PCIe/NVLink トポロジ、ストレージパスでベンチマークする。 |
| キャッシュの挙動を運用担当者から隠す | インシデントがランダムなレイテンシ変動に見える | 階層ごとのヒット、昇格、退避、容量、エラーのシグナルを公開する。 |
KV キャッシュオフロードが誤った最適化となる場合
以下の場合は、現時点では KV キャッシュオフロードを見送ってください。
- GPU メモリが制約要因ではない。
- プロンプトのほぼすべてが一意であり、保持したプレフィックスが再利用されない。
- 主な SLO が非常に低いテールレイテンシであり、転送パスがその範囲内に収まることを示せない。
- ホスト DRAM またはストレージがすでに競合する本番リソースである。
- プレフィックスキャッシュ、バッチ処理、コンテキスト制限、モデル選定、キャッシュ量子化がまだ評価されていない。
このような場合、まず行うべきより明確な手順は、GPU メモリ予算の見直し、別のコンテキストポリシー、またはサービングアーキテクチャの変更かもしれません。トポロジと並列化の選択については、vLLM Multi-GPU Inference、vLLM vs SGLang、および TensorRT-LLM vs vLLM を参照してください。
よくある質問
KV キャッシュオフロードは GPU メモリ使用量を削減しますか?
再利用可能で非アクティブな KV ブロックを GPU 階層から移動することで、その負荷を軽減できます。ただし、アクティブなアテンション処理には GPU 常駐キャッシュが依然として必要であり、オフロードされたブロックを再利用するには、使用前に再び昇格させる必要があります。
vLLM の KV キャッシュオフロードフラグとは何ですか?
現在の vLLM CLI ドキュメントでは、--kv-offloading-size を設定すると KV オフロードバッファが有効になり、--kv-offloading-backend でバックエンドを選択します。固定している vLLM リリースで正確なフラグを確認してください。 vLLM serve arguments
ファイルシステム階層は直接の GPU キャッシュですか?
いいえ。vLLM は、そのマルチ階層実装におけるプライマリ階層として CPU を文書化しています。GPU とセカンダリ階層間の転送は CPU メモリを経由してステージングされます。そのため、セカンダリ階層のテストには完全な昇格パスを含める必要があります。
KV キャッシュオフロードは、より大きな GPU を購入するより優れていますか?
これらは異なる制約を解決します。より大きな GPU は、昇格オーバーヘッドなしにホットなワーキングセットを増やせます。オフロードは、既存の GPU 容量で有用なウォームまたはコールドの状態を保持できます。ワークロードで測定した再利用、レイテンシ SLO、運用負荷、総サービングコストに照らして両方を比較してください。
結論:KVキャッシュオフロードは容量確保の手段ではなく、キャッシュポリシーとして扱う
最も強力なKV cache offload設計では、アクティブな状態をGPU上に維持し、CPUメモリは根拠に基づくウォームな再利用のために確保し、転送コストと障害処理を測定した後も保持に価値がある場合にのみコールド層を追加します。まずは制限付きのCPUパイロットから始め、層ごとの昇格とレイテンシを計測し、単に保持されるキャッシュ量ではなく、本番環境のSLOを改善するポリシーだけを採用してください。
セルフホスト型サービングスタックの運用コストがワークロードに必要な制御を上回る場合は、より大規模なフリートにコミットする前に、GPUクラウドデプロイメントとモデルAPIを比較する、またはFlatkey Computeを詳しく見ることを検討してください。