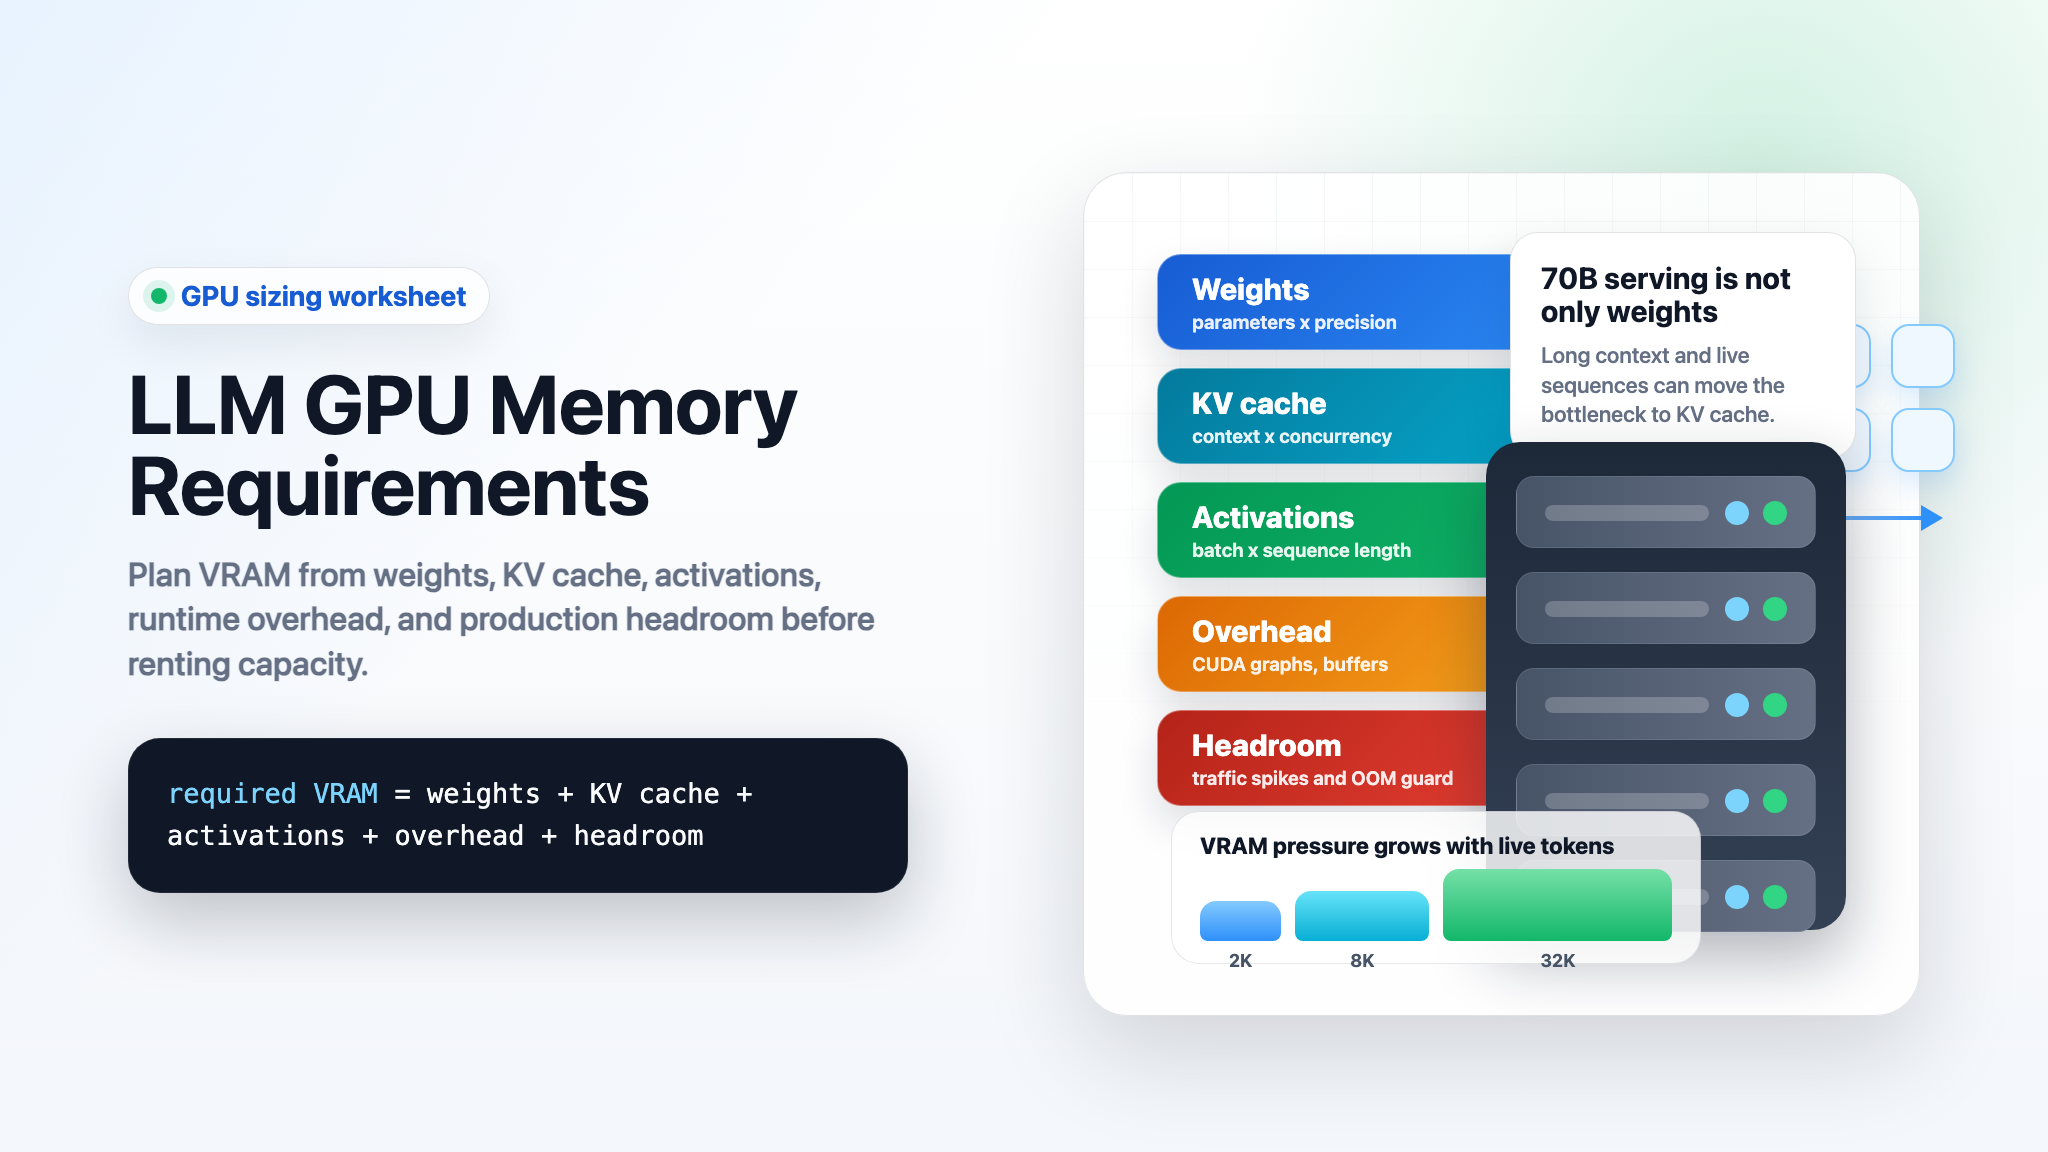
El servicio con contexto largo acaba convirtiendo la memoria de la GPU en un problema de planificación. Una solicitud puede terminar su primer turno, pero dejar tras de sí un estado KV cuya recomputación es costosa y que no se necesita en la GPU en ese momento. La descarga de caché KV es la técnica de mover bloques de caché reutilizables desde el nivel rápido de GPU a un nivel más grande y más lento —normalmente, primero a la RAM del host— y promoverlos de vuelta solo cuando una solicitud posterior pueda reutilizarlos.
El objetivo no es hacer que el almacenamiento lento se comporte como HBM. El objetivo es reservar la costosa capacidad de KV de la GPU para el conjunto de trabajo activo, mientras se mantienen disponibles en otro lugar los prefijos de alto valor. Esto hace que la descarga de caché KV sea más útil cuando el tráfico tiene contextos largos y una reutilización significativa: prompts de sistema recurrentes, estructuras de RAG, sesiones de varios turnos o prefijos de documentos repetidos.
Esta guía muestra cómo decidir si la jerarquización es adecuada, cómo encajan los controles actuales de vLLM, qué expone TensorRT-LLM para la descarga a memoria del host y cómo probar el cambio sin sustituir un fallo de falta de memoria de GPU por un incidente de latencia de cola.
La respuesta rápida
Use la descarga de caché KV como una extensión controlada de la reutilización de prefijos, no como una solución de memoria predeterminada.
| Patrón de tráfico | Empiece con | Por qué |
|---|---|---|
| Prompts de sistema largos repetidos o prefijos RAG | Almacenamiento en caché de prefijos en GPU y, después, un piloto de descarga a CPU | Una solicitud posterior puede reutilizar un prefijo almacenado en caché en lugar de recomputarlo. |
| Sesiones interactivas de larga duración con períodos de inactividad | Nivel cálido de GPU + CPU | El contexto inactivo puede salir de la memoria de la GPU y seguir siendo recuperable. |
| Prompts mayoritariamente únicos y de una sola vez | Primero, capacidad de GPU y control de admisión | Un bloque de caché sin reutilización futura solo añade trabajo de transferencia cuando se descarga. |
| Memoria de GPU limitada, pero RAM del host disponible | Experimento pequeño de descarga a CPU | La descarga puede crear espacio para bloques KV activos, pero el coste de promoción debe mantenerse dentro del SLO. |
| Se necesita un nivel inferior duradero | Nivel primario de CPU más un nivel secundario probado | Un nivel secundario puede ampliar la retención, pero no sustituye a un nivel activo rápido. |
La restricción importante es la localidad. Cuando se reutiliza un bloque descargado, debe volver a la memoria de la GPU antes de que la atención lo utilice. Esa ruta de transferencia forma parte del presupuesto de latencia de la solicitud.
Qué almacena realmente un nivel de caché KV
Durante la generación autorregresiva, las capas de atención producen tensores de claves y valores para los tokens procesados. Conservar esos tensores permite al servidor evitar recomputar el prefijo ya visto en un paso de decodificación posterior o en una reutilización de prefijo compatible. En TensorRT-LLM, la caché KV se representa como grupos de bloques que almacenan estado para un número fijo de tokens; su documentación también describe la reutilización entre solicitudes, la retención priorizada y la descarga a memoria del host. Sistema de caché KV de TensorRT-LLM
Una pila de servicio práctica suele tener tres posibles temperaturas de almacenamiento:
| Nivel | Función típica | Ventaja | Coste |
|---|---|---|---|
| HBM de GPU | Estado activo y caliente de prellenado y decodificación | La menor latencia de acceso | La capacidad más pequeña y más costosa |
| DRAM de CPU | Bloques reutilizables cálidos | Capacidad mucho mayor; puede actuar como el primer destino de descarga | La promoción a la GPU añade tiempo de transferencia |
| Sistema de archivos o nivel de objetos | Bloques retenidos fríos | Capacidad duradera o compartida | El mayor coste de recuperación y más modos de fallo operativo |
La guía de descarga de vLLM es explícita sobre el orden: su diseño multinivel utiliza la CPU como nivel primario, y las transferencias entre la GPU y un nivel secundario se realizan a través de ese nivel de CPU. En otras palabras, un acierto en el nivel frío no es una lectura directa de la GPU. Guía de uso de descarga de KV de vLLM
              promover ante un acierto de caché utilizable
Solicitud ──> HBM de GPU  <──────────────────── DRAM de CPU
              │                                ▲
              │ expulsar elementos reutilizables │ preparar
              │ completados                     │
              ▼                                │
          caché de GPU activa ─────────────> almacenamiento secundario
                 caliente                 cálido / frío
Este diagrama de descarga de caché KV de vllm es deliberadamente simple: solo el nivel de GPU debe estar siempre en la ruta crítica de cómputo. Los niveles de CPU y almacenamiento deben responder a una política de reutilización medible.
La descarga de caché KV no es descarga de pesos del modelo
Esta distinción evita una configuración incorrecta sorprendentemente común:
- La descarga de caché KV mueve el estado de atención creado por las solicitudes. Cambia principalmente la memoria disponible para el contexto activo y la ruta de reutilización.
- La descarga de pesos del modelo mueve los parámetros del modelo. En vLLM, el control
--cpu-offload-gbestá documentado en la sección de descarga de pesos del modelo y puede añadir trabajo de transferencia CPU–GPU a cada paso de propagación hacia delante del modelo. argumentos de vLLM serve
No suponga que una configuración que permite cargar un modelo también crea más capacidad KV utilizable. Primero separe el presupuesto de pesos del modelo, el espacio de trabajo de tiempo de ejecución y el presupuesto de caché KV; después decida si merece la pena retener bloques KV inactivos fuera de la memoria de la GPU.
Descarga de caché KV de vLLM: empiece con la ruta nativa de CPU
Para la CLI actual de vLLM, la marca de descarga de caché KV de vLLM relevante es --kv-offloading-size. La referencia oficial de la CLI indica que es el tamaño del búfer de descarga de KV en GiB; cuando el paralelismo de tensores es mayor que uno, el tamaño es el total entre los rangos paralelos de tensores. La descarga se desactiva cuando no se establece. La opción complementaria --kv-offloading-backend admite el backend nativo de CPU y LMCache. argumentos de vLLM serve
Use un piloto acotado en lugar de dimensionar el nivel de host con toda la RAM disponible:
vllm serve <your-model> \
  --gpu-memory-utilization 0.85 \
  --kv-offloading-size 16 \
  --kv-offloading-backend native
El ejemplo es una configuración experimental, no un ajuste universal. El valor correcto depende de la estructura de caché del modelo, la longitud de contexto, la configuración de paralelismo de tensores, el margen de RAM del host, la mezcla de solicitudes y el objetivo de latencia. Fije la versión de la imagen de vLLM y ejecute vllm serve --help en esa imagen antes de llevar las opciones a producción; la configuración de serving evoluciona rápidamente.
La ruta nativa es adecuada para una primera prueba de descarga de caché KV de vLLM a CPU porque mantiene acotada la cuestión de la jerarquización: ¿puede un nivel cálido de CPU conservar suficientes bloques útiles para mejorar la admisión o evitar la rotación de caché de GPU sin empeorar el comportamiento de p95 y p99?
Elija la admisión en caché antes que la capacidad de caché
Más bloques retenidos no significan necesariamente más bloques útiles. Antes de aumentar el búfer de descarga, responda cuatro preguntas:
- ¿Qué prefijos se comparten entre solicitudes?
- ¿Cuánto tiempo después de su creación se reutilizan esos prefijos?
- ¿Qué tamaño tiene un bloque útil en relación con su presupuesto de transferencia del host?
- ¿Qué bloques deben expulsarse directamente porque su probabilidad de reutilización es demasiado baja?
Si la carga de trabajo no puede responder las dos primeras preguntas a partir de trazas, comience midiendo la reutilización de prefijos en la GPU. Un nivel de CPU puede conservar un estado de caché cálido; no puede crear reutilización para prompts completamente únicos.
Construya una ruta de jerarquización de vLLM solo después del piloto de CPU
OffloadingConnector de vLLM es la ruta hacia un nivel primario de CPU más niveles secundarios opcionales. La guía oficial describe CPUOffloadingSpec para un único nivel de CPU y TieringOffloadingSpec para un nivel primario de CPU con uno o más niveles secundarios. También documenta LRU y ARC como opciones integradas de política de expulsión. Guía de uso de descarga de KV de vLLM
La siguiente es una configuración fiel del ejemplo documentado de varios niveles. Reemplace el modelo, las rutas, el tamaño de bloque, los bytes y los recuentos de hilos solo después de probarlos en su propio host:
vllm serve <your-model> \
  --kv-transfer-config '{
    "kv_connector": "OffloadingConnector",
    "kv_role": "kv_both",
    "kv_connector_extra_config": {
      "spec_name": "TieringOffloadingSpec",
      "cpu_bytes_to_use": 10737418240,
      "block_size": 16,
      "eviction_policy": "lru",
      "secondary_tiers": [
        {
          "type": "fs",
          "root_dir": "/mnt/kv_cache",
          "n_read_threads": 32,
          "n_write_threads": 16
        }
      ]
    }
  }'
Tres detalles operativos importan más que copiar el fragmento:
cpu_bytes_to_usees la reserva total del nivel de CPU entre los workers, no una sugerencia imprecisa para el sistema operativo. Presupueste para el proceso, el SO, la caché de páginas de almacenamiento y cualquier servicio ubicado conjuntamente.- El tamaño de bloque o fragmento configurado establece la unidad de E/S. Los fragmentos muy pequeños pueden aumentar la sobrecarga de metadatos y planificación; los muy grandes pueden promover bytes que una solicitud no necesita. Pruebe ambos con longitudes de prefijo reales.
- Un nivel secundario está aguas abajo de la CPU. Si el nivel de CPU es demasiado pequeño o está saturado, añadir capacidad de sistema de archivos puede retener más datos sin mejorar la latencia de un acierto posterior.
Por lo tanto, el objetivo de la descarga de caché KV de vLLM no es «retenerlo todo». Es «retener los bloques con una vía de reutilización plausible y oportuna».
Descarga de caché KV de TensorRT-LLM a memoria del host
TensorRT-LLM expone la misma idea básica mediante su configuración de caché KV. Su documentación indica que host_cache_size asigna memoria del host para la descarga, tiene un valor predeterminado de cero y permite que un bloque siga siendo reutilizable hasta que posteriormente se expulse de la memoria del host. Al reutilizarse, el bloque se copia de vuelta a la memoria de la GPU. Sistema de caché KV de TensorRT-LLM
Para una implementación de descarga de caché KV de TensorRT-LLM a memoria del host, preste atención a la política de retención además de a la capacidad:
| Control de TensorRT-LLM | Qué verificar |
|---|---|
host_cache_size |
El presupuesto de bytes es intencional y deja margen de memoria en el host. |
| Prioridad de bloque / política de retención | Las regiones de prompt reutilizadas con frecuencia se retienen antes que los datos descartables. |
secondary_offload_min_priority |
Los bloques de baja prioridad pueden omitir la descarga al host y expulsarse directamente, lo que reduce el tráfico evitable hacia el host. |
| Reutilización de bloques entre solicitudes | La reutilización permanece habilitada y es observable por separado de las estimaciones del planificador. |
TensorRT-LLM documenta un valor predeterminado de secondary_offload_min_priority de 35 en el momento de redactar este texto. Trátelo como un valor predeterminado versionado, no como una recomendación de política: un umbral debe reflejar el valor de reutilización observado y el coste de transferencia de su servicio.
Un método de despliegue que protege la latencia
No active un nivel frío durante un incidente de capacidad y declare el éxito cuando se detenga el OOM. En su lugar, ejecute una secuencia controlada:
- Capture una línea base solo con GPU. Registre la distribución de longitud de contexto, la concurrencia, el tiempo hasta el primer token, la latencia entre tokens, p50/p95/p99 de extremo a extremo, la tasa de reutilización de prefijos y el comportamiento de expulsión de KV de la GPU.
- Reserve margen real en el host. Incluya la sobrecarga del tiempo de ejecución y el sistema operativo; no dimensione una caché de CPU basándose únicamente en instantáneas de memoria libre.
- Habilite un nivel pequeño de CPU. Mantenga estables el modelo, la política de lotes, el patrón de tráfico y las alertas de SLO mientras modifica una dimensión de la caché.
- Compare la calidad de los aciertos, no solo su número. Distinga entre aciertos de GPU, promociones desde CPU, promociones desde el nivel frío y fallos que desencadenan una recomputación.
- Examine la latencia de cola bajo contención. Ejecute solicitudes largas y cortas combinadas, así como un aumento gradual de concurrencia. Un resultado basado solo en la media oculta las colas de transferencia.
- Añada un nivel secundario solo si el valor de retención lo justifica. Pruebe la pérdida de caché, la presión de almacenamiento, el comportamiento tras reinicios y las ráfagas de promociones antes de desplegarlo ampliamente.
- Establezca una regla de reversión. Por ejemplo: deshabilite el nivel más reciente cuando el tiempo p99 hasta el primer token o la latencia entre tokens supere el presupuesto acordado durante un intervalo sostenido.
La guía de vLLM documenta la configuración y las métricas de descarga, incluida la información de configuración y las señales de uso de caché de CPU. Úselas junto con las trazas de la aplicación; una métrica de caché sin latencia por solicitud dificulta distinguir una promoción valiosa de la saturación por transferencias. Guía de uso de descarga de KV de vLLM
Modos de fallo que se deben evitar mediante el diseño
| Modo de fallo | Cómo se manifiesta | Mejor respuesta |
|---|---|---|
| Tratar todos los bloques de caché como valiosos | El nivel de CPU se llena, aumentan las promociones y empeora la latencia | Admita y retenga según evidencia de reutilización, no solo según el orden de creación. |
| Confundir la descarga de pesos con la descarga de caché KV | El modelo carga, pero la concurrencia con contexto largo sigue siendo deficiente | Separe los presupuestos de pesos, KV, espacio de trabajo y margen de seguridad. |
| Sobreasignar RAM del host | El host comienza a recuperar memoria o los servicios ubicados conjuntamente se desestabilizan | Reserve un presupuesto fijo y realice pruebas de carga con contención realista. |
| Añadir un nivel secundario demasiado pronto | Más bytes retenidos, sin mejora significativa del SLO | Demuestre primero la reutilización del nivel de CPU; después pruebe el nivel frío de forma independiente. |
| Ignorar la topología de transferencia | Buen resultado en laboratorio, p99 deficiente en un nodo compartido | Evalúe el rendimiento con la topología exacta de GPU, CPU, PCIe/NVLink y ruta de almacenamiento utilizada en producción. |
| Ocultar el comportamiento de la caché a los operadores | Un incidente parece una variación aleatoria de la latencia | Exponga señales específicas por nivel de aciertos, promociones, expulsiones, capacidad y errores. |
Cuándo la descarga de caché KV es la optimización equivocada
Omita por ahora la descarga de caché KV cuando:
- La memoria de GPU no es el factor limitante.
- Los prompts son casi todos únicos, por lo que los prefijos retenidos no vuelven a utilizarse.
- Su SLO principal es una latencia de cola muy baja y no se puede demostrar que la ruta de transferencia se ajuste a ella.
- La DRAM del host o el almacenamiento ya son recursos de producción disputados.
- Aún no se han evaluado el almacenamiento en caché de prefijos, el procesamiento por lotes, los límites de contexto, la selección de modelos o la cuantización de caché.
En esos casos, el primer paso más limpio puede ser una revisión del presupuesto de memoria de GPU, una política de contexto diferente o un cambio en la arquitectura de servicio. Para las opciones de topología y paralelismo, consulte Inferencia multi-GPU de vLLM, vLLM frente a SGLang y TensorRT-LLM frente a vLLM.
Preguntas frecuentes
¿La descarga de caché KV reduce el uso de memoria de GPU?
Puede reducir la presión de los bloques KV inactivos reutilizables al moverlos fuera del nivel de GPU. No elimina la necesidad de caché residente en GPU para el trabajo de atención activo, y un bloque descargado reutilizado debe promocionarse de nuevo antes de utilizarse.
¿Cuál es la opción de descarga de caché KV de vLLM?
En la documentación actual de la CLI de vLLM, --kv-offloading-size habilita un búfer de descarga de KV cuando se establece, mientras que --kv-offloading-backend selecciona el backend. Verifique las opciones exactas en la versión fijada de vLLM. Argumentos de servicio de vLLM
¿Un nivel de sistema de archivos es una caché directa de GPU?
No. vLLM documenta la CPU como el nivel principal de su implementación multinivel; las transferencias entre la GPU y un nivel secundario se realizan por etapas a través de la memoria de CPU. Por eso, las pruebas del nivel secundario deben incluir toda la ruta de promoción.
¿La descarga de caché KV es mejor que comprar una GPU más grande?
Resuelven restricciones diferentes. Una GPU más grande puede aumentar el conjunto de trabajo activo sin sobrecarga de promoción. La descarga puede retener estado cálido o frío útil con la capacidad de GPU existente. Compare ambas opciones con la reutilización medida de la carga de trabajo, el SLO de latencia, la carga operativa y el coste total de servicio.
Conclusión: trate la descarga de caché KV como una política de caché, no como un truco de capacidad
El diseño más sólido de descarga de caché KV mantiene el estado activo en la GPU, reserva memoria de CPU para reutilización en caliente respaldada por evidencia y añade un nivel frío solo cuando la retención sigue siendo valiosa después de medir el costo de transferencia y la gestión de fallos. Comience con una prueba piloto limitada en CPU, instrumente las promociones y la latencia por nivel, y adopte únicamente la política que mejore un SLO de producción, no simplemente la cantidad de caché retenida.
Si el costo operativo de una pila de servicio autohospedada supera el control que necesita su carga de trabajo, compare un despliegue en la nube con GPU con una API de modelo o explore Flatkey Compute antes de comprometerse con una flota más grande.