L’inférence à long contexte finit par transformer la mémoire GPU en problème d’ordonnancement. Une requête peut terminer son premier tour tout en laissant derrière elle un état KV coûteux à recalculer et dont le GPU n’a pas besoin à cet instant. La déportation du cache KV consiste à déplacer des blocs de cache réutilisables du niveau GPU rapide vers un niveau plus grand et plus lent — généralement d’abord la RAM de l’hôte — puis à les remonter uniquement lorsqu’une requête ultérieure peut les réutiliser.
L’objectif n’est pas de faire passer un stockage lent pour de la HBM. Il s’agit de réserver la coûteuse capacité KV du GPU à l’ensemble de travail actif tout en maintenant ailleurs les préfixes à forte valeur. La déportation du cache KV est donc particulièrement utile lorsque votre trafic présente des contextes longs et une réutilisation significative : prompts système récurrents, structures RAG, sessions multi-tours ou préfixes de documents répétés.
Ce guide montre comment déterminer si la hiérarchisation est appropriée, comment s’articulent les contrôles actuels de vLLM, ce que TensorRT-LLM propose pour la déportation vers la mémoire hôte et comment tester ce changement sans remplacer une erreur de mémoire GPU insuffisante par un incident de latence de queue.
La réponse rapide
Utilisez la déportation du cache KV comme une extension contrôlée de la réutilisation des préfixes — et non comme une correction de mémoire par défaut.
| Profil de trafic | Commencez par | Pourquoi |
|---|---|---|
| Prompts système longs ou préfixes RAG répétés | Mise en cache des préfixes sur GPU, puis pilote de déportation vers le CPU | Une requête ultérieure peut réutiliser un préfixe mis en cache au lieu de le recalculer. |
| Sessions interactives longues avec des périodes d’inactivité | Niveau chaud GPU + CPU | Le contexte inactif peut quitter la mémoire GPU tout en restant récupérable. |
| Prompts majoritairement uniques et à usage unique | Capacité GPU et contrôle d’admission d’abord | Un bloc de cache sans réutilisation future ne fait qu’ajouter du travail de transfert lorsqu’il est déporté. |
| Mémoire GPU limitée, mais RAM hôte disponible | Petite expérimentation de déportation vers le CPU | La déportation peut libérer de l’espace pour les blocs KV actifs, mais le coût de remontée doit rester dans le SLO. |
| Besoin d’un niveau inférieur durable | Niveau principal CPU plus un niveau secondaire testé | Un niveau secondaire peut prolonger la rétention, mais ne remplace pas un niveau actif rapide. |
La contrainte importante est la localité. Lorsqu’un bloc déporté est réutilisé, il doit revenir dans la mémoire GPU avant que l’attention ne l’utilise. Ce chemin de transfert fait partie du budget de latence de la requête.
Ce qu’un niveau de cache KV stocke réellement
Lors de la génération autorégressive, les couches d’attention produisent des tenseurs de clés et de valeurs pour les jetons traités. La conservation de ces tenseurs permet au serveur d’éviter de recalculer le préfixe déjà vu lors d’une étape de décodage ultérieure ou d’une réutilisation de préfixe compatible. Dans TensorRT-LLM, le cache KV est représenté sous forme de pools de blocs qui conservent l’état pour un nombre fixe de jetons ; sa documentation décrit également la réutilisation entre requêtes, la rétention priorisée et la déportation vers la mémoire hôte. Système de cache KV TensorRT-LLM
Une pile d’inférence pratique comporte généralement trois températures de stockage possibles :
| Niveau | Rôle typique | Atout | Coût |
|---|---|---|---|
| HBM GPU | État actif et chaud de préremplissage et de décodage | Latence d’accès minimale | Capacité la plus faible et la plus coûteuse |
| DRAM CPU | Blocs réutilisables tièdes | Capacité bien plus importante ; peut servir de première cible de déportation | La remontée vers le GPU ajoute un temps de transfert |
| Système de fichiers ou niveau objet | Blocs froids conservés | Capacité durable ou partagée | Coût de récupération le plus élevé et davantage de modes de défaillance opérationnels |
Le guide de déportation de vLLM est explicite quant à l’ordre : sa conception multi-niveaux utilise le CPU comme niveau principal, et les transferts entre le GPU et un niveau secondaire transitent par ce niveau CPU. En d’autres termes, un accès au niveau froid n’est pas une lecture GPU directe. Guide d’utilisation de la déportation KV de vLLM
              remontée lors d’un accès au cache utilisable
Requête ──> HBM GPU  <──────────────────── DRAM CPU
              │                                ▲
              │ éviction des blocs terminés,   │ transit
              │ réutilisables                  │
              ▼                                │
          cache GPU actif  ─────────────> stockage secondaire
                 chaud                    tiède / froid
Ce diagramme de déportation du cache KV vllm est volontairement simple : seul le niveau GPU doit se trouver en permanence sur le chemin critique de calcul. Les niveaux CPU et stockage doivent répondre à une politique de réutilisation mesurable.
La déportation du cache KV n’est pas la déportation des poids du modèle
Cette distinction évite une erreur de configuration étonnamment fréquente :
- La déportation du cache KV déplace l’état d’attention créé par les requêtes. Elle modifie principalement la mémoire disponible pour le contexte actif et le chemin de réutilisation.
- La déportation des poids du modèle déplace les paramètres du modèle. Dans vLLM, le contrôle
--cpu-offload-gbest documenté sous la déportation des poids du modèle et peut ajouter du travail de transfert CPU–GPU à chaque passe avant du modèle. Arguments de vLLM serve
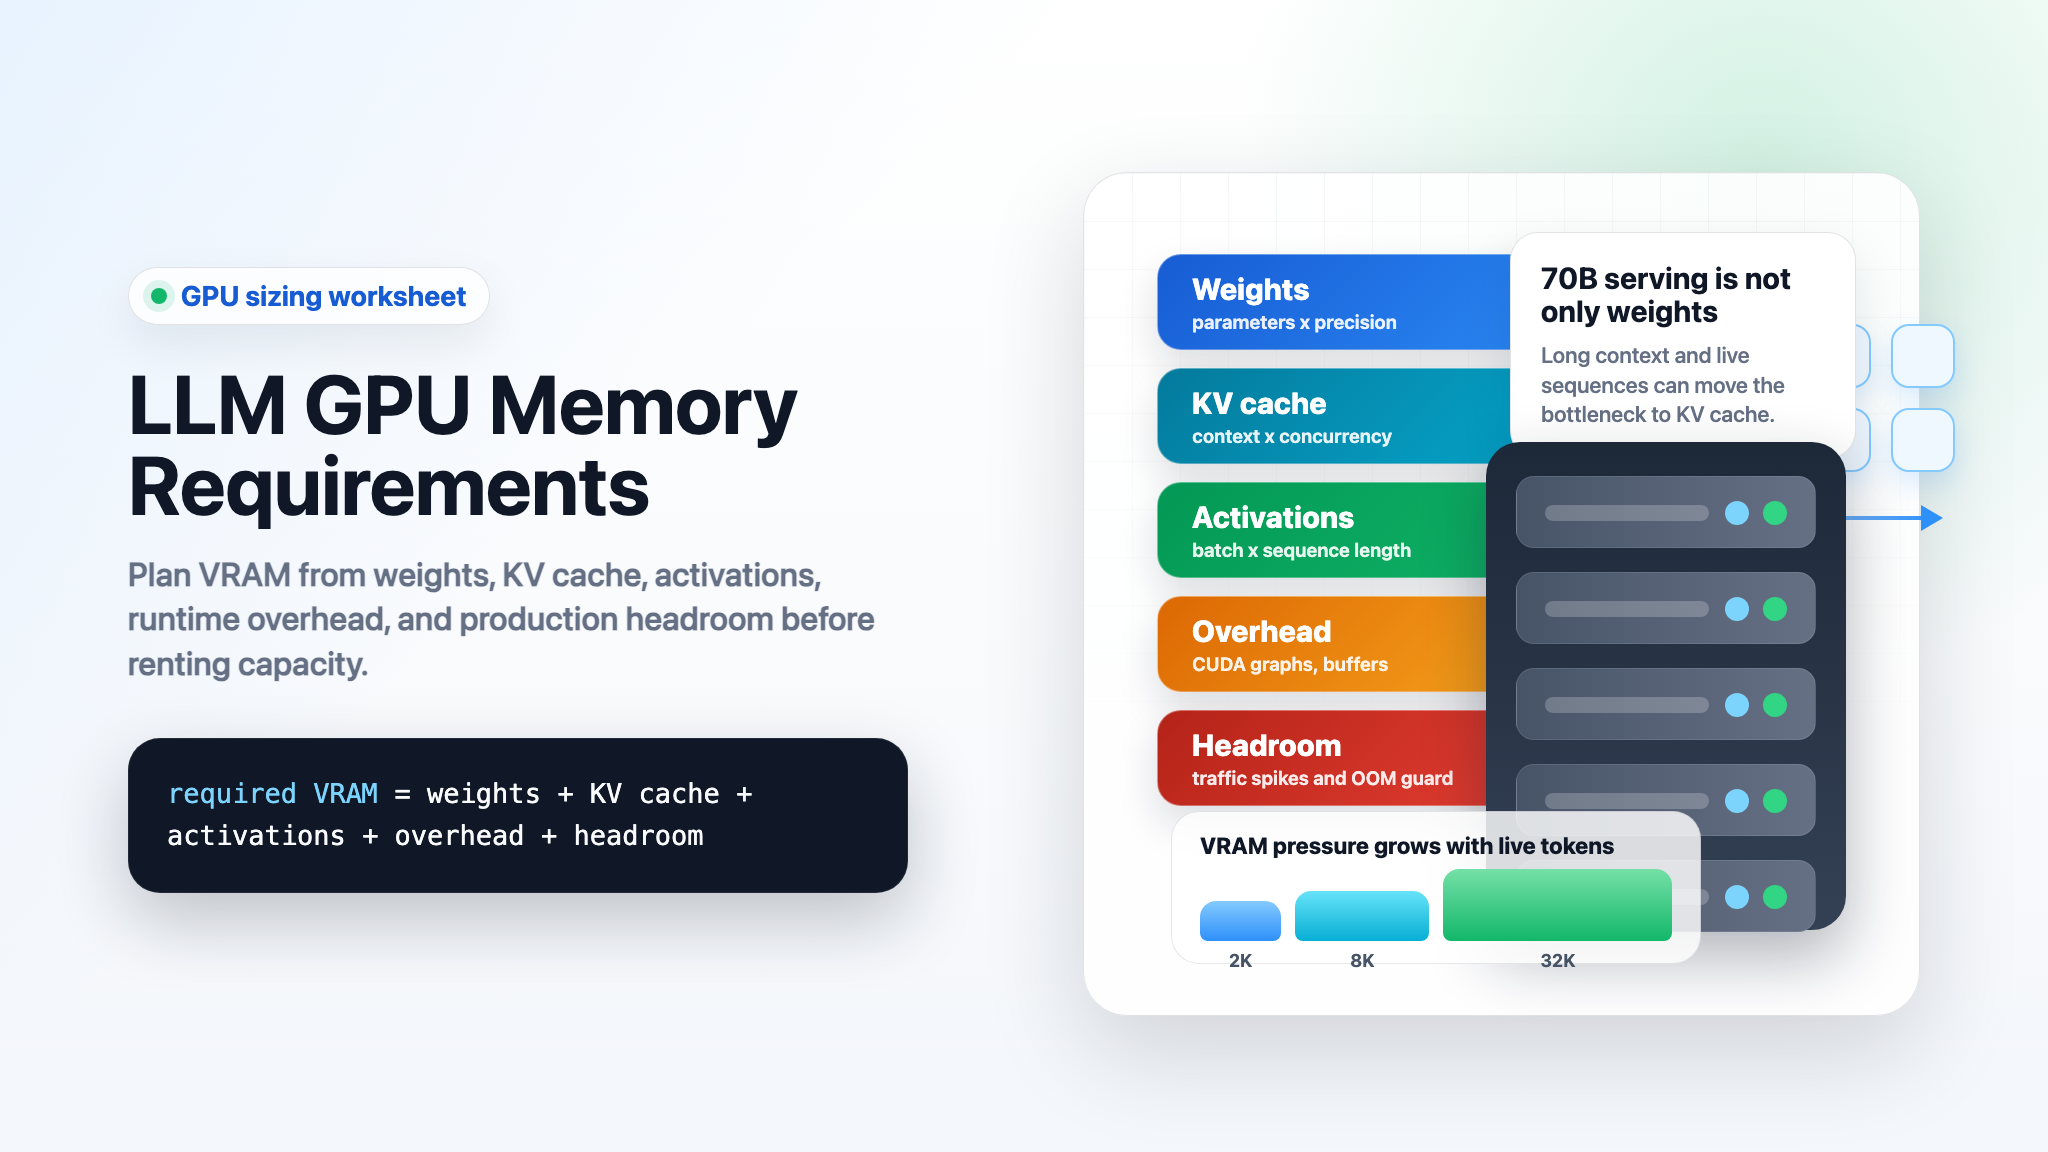
Ne supposez pas qu’un paramètre permettant de charger un modèle crée également davantage de capacité KV utilisable. Séparez d’abord le budget des poids du modèle, l’espace de travail d’exécution et le budget du cache KV ; déterminez ensuite si les blocs KV inactifs valent la peine d’être conservés hors de la mémoire GPU.
Déportation du cache KV vLLM : commencez par le chemin CPU natif
Dans l’interface CLI actuelle de vLLM, le paramètre de déportation du cache KV vllm pertinent est --kv-offloading-size. La référence officielle de la CLI indique qu’il s’agit de la taille du tampon de déportation KV en Gio ; lorsque le parallélisme tensoriel est supérieur à un, la taille correspond au total sur l’ensemble des rangs de parallélisme tensoriel. La déportation est désactivée lorsque ce paramètre n’est pas défini. Le paramètre associé --kv-offloading-backend prend en charge le backend CPU natif et LMCache. Arguments de vLLM serve
Utilisez un pilote limité plutôt que de dimensionner le niveau hôte sur toute la RAM disponible :
vllm serve <your-model> \
  --gpu-memory-utilization 0.85 \
  --kv-offloading-size 16 \
  --kv-offloading-backend native
Cet exemple constitue une forme d’expérimentation, et non un réglage universel. La bonne valeur dépend de l’organisation du cache du modèle, de la longueur du contexte, de la configuration de parallélisme tensoriel, de la marge de RAM hôte, du mix de requêtes et de l’objectif de latence. Figez la version de l’image vLLM et exécutez vllm serve --help dans cette image avant de mettre des paramètres en production ; la configuration d’inférence évolue rapidement.
Le chemin natif convient à un premier essai de déportation CPU du cache KV vllm, car il limite la question de la hiérarchisation : un niveau CPU chaud peut-il conserver suffisamment de blocs utiles pour améliorer l’admission ou éviter le renouvellement du cache GPU sans dégrader le comportement aux p95 et p99 ?
Choisissez l’admission dans le cache avant sa capacité
Conserver davantage de blocs ne signifie pas nécessairement conserver davantage de blocs utiles. Avant d’augmenter le tampon de déportation, répondez à quatre questions :
- Quels préfixes sont partagés entre les requêtes ?
- Combien de temps après leur création ces préfixes sont-ils réutilisés ?
- Quelle est la taille d’un bloc utile par rapport à votre budget de transfert hôte ?
- Quels blocs doivent être évincés immédiatement parce que leur probabilité de réutilisation est trop faible ?
Si la charge de travail ne permet pas de répondre aux deux premières questions à partir des traces, commencez par mesurer la réutilisation des préfixes sur GPU. Un niveau CPU peut préserver un état de cache chaud ; il ne peut pas créer de la réutilisation pour des invites entièrement uniques.
Ne construisez un chemin de hiérarchisation vLLM qu’après le pilote CPU
Le OffloadingConnector de vLLM est le chemin vers un niveau principal CPU et des niveaux secondaires facultatifs. Le guide officiel décrit CPUOffloadingSpec pour un seul niveau CPU et TieringOffloadingSpec pour un niveau principal CPU avec un ou plusieurs niveaux secondaires. Il documente également LRU et ARC comme options intégrées de politique d’éviction. Guide d’utilisation de la déportation KV de vLLM
Ce qui suit est une configuration fidèle à l’exemple documenté à plusieurs niveaux. Ne remplacez le modèle, les chemins, la taille de bloc, les octets et les nombres de threads qu’après les avoir testés sur votre propre hôte :
vllm serve <your-model> \
  --kv-transfer-config '{
    "kv_connector": "OffloadingConnector",
    "kv_role": "kv_both",
    "kv_connector_extra_config": {
      "spec_name": "TieringOffloadingSpec",
      "cpu_bytes_to_use": 10737418240,
      "block_size": 16,
      "eviction_policy": "lru",
      "secondary_tiers": [
        {
          "type": "fs",
          "root_dir": "/mnt/kv_cache",
          "n_read_threads": 32,
          "n_write_threads": 16
        }
      ]
    }
  }'
Trois détails opérationnels comptent davantage que la copie de l’extrait :
cpu_bytes_to_useest la réservation totale du niveau CPU sur l’ensemble des workers, et non une vague suggestion au système d’exploitation. Prévoyez un budget pour le processus, le système d’exploitation, le cache de pages du stockage et les éventuels services colocalisés.- La taille de bloc ou de fragment configurée définit l’unité d’E/S. De très petits fragments peuvent augmenter la surcharge de métadonnées et d’ordonnancement ; de très grands fragments peuvent promouvoir des octets dont une requête n’a pas besoin. Testez les deux avec des longueurs de préfixe réelles.
- Un niveau secondaire se trouve en aval du CPU. Si le niveau CPU est trop petit ou saturé, ajouter de la capacité de système de fichiers peut conserver davantage de données sans améliorer la latence d’un accès ultérieur.
L’objectif de la déportation du cache KV vllm n’est donc pas de « tout conserver ». Il est de « conserver les blocs présentant une voie de réutilisation plausible et suffisamment rapide ».
Déportation du cache KV TensorRT-LLM vers la mémoire hôte
TensorRT-LLM expose la même idée de base via sa configuration de cache KV. Sa documentation indique que host_cache_size alloue de la mémoire hôte pour la déportation, vaut zéro par défaut et permet à un bloc de rester réutilisable jusqu’à son éviction ultérieure de la mémoire hôte. Lors de sa réutilisation, le bloc est recopié dans la mémoire GPU. Système de cache KV TensorRT-LLM
Pour un déploiement de déportation du cache KV tensorrt-llm vers la mémoire hôte, prêtez attention à la politique de rétention autant qu’à la capacité :
| Contrôle TensorRT-LLM | Éléments à vérifier |
|---|---|
host_cache_size |
Le budget en octets est intentionnel et laisse une marge de mémoire hôte. |
| Priorité des blocs / politique de rétention | Les régions d’invite fréquemment réutilisées sont conservées avant les données jetables. |
secondary_offload_min_priority |
Les blocs de faible priorité peuvent contourner la déportation hôte et être évincés directement, ce qui réduit le trafic hôte évitable. |
| Réutilisation de blocs entre requêtes | La réutilisation reste activée et observable séparément des estimations de l’ordonnanceur. |
TensorRT-LLM indique une valeur par défaut de secondary_offload_min_priority de 35 au moment de la rédaction. Considérez-la comme une valeur par défaut versionnée, et non comme une recommandation de politique : un seuil doit refléter la valeur de réutilisation observée et le coût de transfert de votre service.
Une méthode de déploiement qui protège la latence
N’activez pas un niveau froid pendant un incident de capacité pour ensuite déclarer le succès lorsque les erreurs OOM cessent. Exécutez plutôt une séquence contrôlée :
- Établissez une référence GPU uniquement. Enregistrez la distribution des longueurs de contexte, la concurrence, le délai avant le premier jeton, la latence inter-jetons, les p50/p95/p99 de bout en bout, le taux de réutilisation des préfixes et le comportement d’éviction du cache KV sur le GPU.
- Réservez une marge réelle sur l’hôte. Incluez la surcharge du runtime et le système d’exploitation ; ne dimensionnez pas un cache CPU à partir des seuls instantanés de mémoire libre.
- Activez un petit niveau CPU. Maintenez stables le modèle, la politique de lots, la forme du trafic et les alertes de SLO pendant que vous modifiez une seule dimension du cache.
- Comparez la qualité des hits, pas seulement leur nombre. Distinguez les hits GPU, les promotions CPU, les promotions depuis le niveau froid et les échecs qui déclenchent un recalcul.
- Examinez la latence de queue en situation de contention. Exécutez des requêtes longues et courtes mixtes ainsi qu’une montée en concurrence. Un résultat fondé uniquement sur la moyenne masque les files d’attente de transfert.
- Ajoutez un niveau secondaire uniquement si la valeur de rétention le justifie. Testez la perte de cache, la pression sur le stockage, le comportement au redémarrage et les rafales de promotion avant un déploiement généralisé.
- Définissez une règle de retour arrière. Par exemple : désactivez le niveau le plus récent lorsque le délai p99 avant le premier jeton ou la latence inter-jetons dépasse le budget convenu pendant une période prolongée.
Le guide vLLM documente les métriques de configuration et de déportation, y compris les informations de configuration et les signaux d’utilisation du cache CPU. Utilisez-les avec les traces applicatives ; une métrique de cache sans latence au niveau des requêtes rend difficile la distinction entre une promotion utile et une saturation due aux transferts. Guide d’utilisation de la déportation KV de vLLM
Modes de défaillance à éviter dès la conception
| Mode de défaillance | Apparence | Meilleure réponse |
|---|---|---|
| Considérer tous les blocs de cache comme précieux | Le niveau CPU se remplit, les promotions augmentent, la latence se dégrade | Admettez et conservez selon des preuves de réutilisation, et non selon le seul ordre de création. |
| Confondre la déportation des poids avec la déportation du cache KV | Le modèle se charge, mais la concurrence sur des contextes longs reste faible | Séparez les budgets pour les poids, le KV, l’espace de travail et la marge de sécurité. |
| Surengager la RAM de l’hôte | L’hôte commence à récupérer de la mémoire ou les services colocalisés deviennent instables | Réservez un budget fixe et effectuez des tests de charge sous une contention réaliste. |
| Ajouter un niveau secondaire trop tôt | Davantage d’octets conservés, sans amélioration significative du SLO | Démontrez d’abord la réutilisation du niveau CPU ; testez ensuite le niveau froid indépendamment. |
| Ignorer la topologie des transferts | Bon résultat en laboratoire, p99 médiocre sur un nœud partagé | Évaluez les performances sur la topologie exacte de GPU, CPU, PCIe/NVLink et de chemin de stockage utilisée en production. |
| Masquer le comportement du cache aux opérateurs | Un incident ressemble à une variation aléatoire de la latence | Exposez des signaux par niveau pour les hits, promotions, évictions, capacités et erreurs. |
Quand la déportation du cache KV est la mauvaise optimisation
Renoncez pour l’instant à la déportation du cache KV lorsque :
- La mémoire GPU n’est pas le facteur limitant.
- Les prompts sont presque tous uniques, de sorte que les préfixes conservés ne sont pas réutilisés.
- Votre SLO principal exige une très faible latence de queue et il n’est pas possible de démontrer que le chemin de transfert y tient.
- La DRAM de l’hôte ou le stockage est déjà une ressource de production disputée.
- La mise en cache des préfixes, le traitement par lots, les limites de contexte, le choix du modèle ou la quantification du cache n’ont pas encore été évalués.
Dans ces cas, la première étape la plus appropriée peut être une revue du budget de mémoire GPU, une politique de contexte différente ou un changement d’architecture d’inférence. Pour les choix de topologie et de parallélisme, consultez Inférence multi-GPU avec vLLM, vLLM vs SGLang et TensorRT-LLM vs vLLM.
FAQ
La déportation du cache KV réduit-elle l’utilisation de la mémoire GPU ?
Elle peut réduire la pression due aux blocs KV inactifs réutilisables en les déplaçant hors du niveau GPU. Elle ne supprime pas le besoin d’un cache résidant sur le GPU pour le travail d’attention actif, et un bloc déporté réutilisé doit être promu de nouveau avant utilisation.
Quel est le drapeau de déportation du cache KV de vLLM ?
Dans la documentation CLI actuelle de vLLM, --kv-offloading-size active un tampon de déportation KV lorsqu’il est défini, tandis que --kv-offloading-backend sélectionne le backend. Vérifiez les drapeaux exacts dans votre version épinglée de vLLM. Arguments de vLLM serve
Un niveau de système de fichiers est-il un cache GPU direct ?
Non. vLLM documente le CPU comme niveau principal de son implémentation multi-niveaux ; les transferts entre le GPU et un niveau secondaire transitent par la mémoire CPU. C’est pourquoi les tests du niveau secondaire doivent inclure le chemin de promotion complet.
La déportation du cache KV est-elle préférable à l’achat d’un GPU plus grand ?
Elles répondent à des contraintes différentes. Un GPU plus grand peut augmenter l’ensemble de travail actif sans surcharge de promotion. La déportation peut conserver un état utile tiède ou froid avec la capacité GPU existante. Comparez les deux options en fonction de la réutilisation mesurée de la charge de travail, du SLO de latence, de la charge opérationnelle et du coût total d’inférence.
Conclusion : traiter la déportation du cache KV comme une politique de cache, et non comme une astuce de capacité
La conception la plus robuste de la déportation du cache KV conserve l’état actif sur le GPU, réserve la mémoire CPU à la réutilisation à chaud étayée par des preuves et n’ajoute un niveau froid que lorsque la conservation reste utile après mesure du coût de transfert et de la gestion des défaillances. Commencez par un pilote CPU limité, instrumentez les promotions et la latence par niveau, et ne mettez en production que la politique qui améliore un SLO de production — pas seulement la quantité de cache conservée.
Si le coût opérationnel d’une pile d’inférence auto-hébergée l’emporte sur le contrôle dont votre charge de travail a besoin, comparez un déploiement dans le cloud GPU avec une API de modèle ou découvrez Flatkey Compute avant de vous engager dans une flotte plus importante.