LLM Gateway初心者ガイド: 初回リクエストから本番運用まで
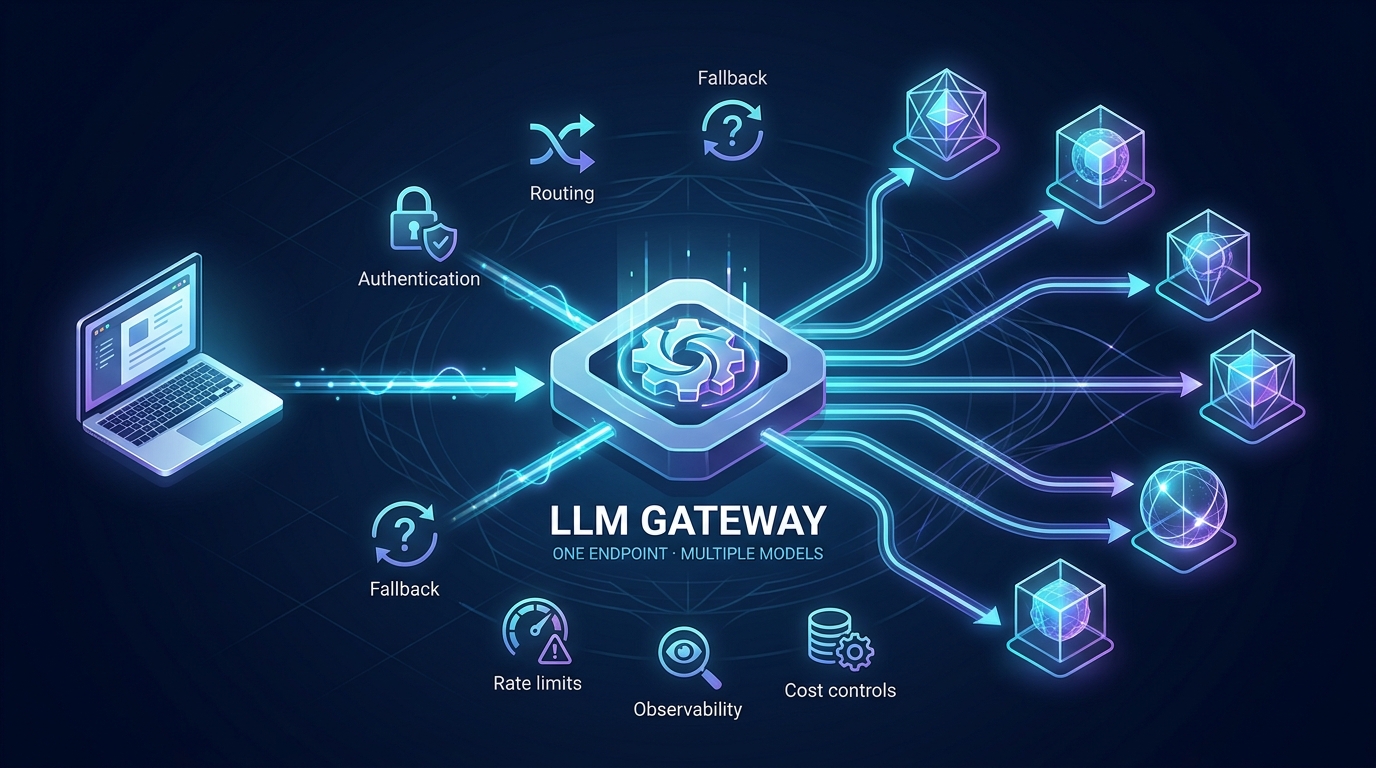
LLMゲートウェイは、アプリケーションと1つ以上のAIモデルプロバイダーの間に位置する制御レイヤーです。アプリは各プロバイダーに個別接続する代わりに、ゲートウェイへリクエストを送信します。ゲートウェイはそのリクエストを認証し、ポリシーを適用し、モデルまたは上流接続を選択し、呼び出しを転送し、結果を記録します。
一見すると普通のAPI接続処理のようですが、実際のAIプロダクトではすぐに問題を解決します。最初のモデル統合は簡単ですが、5つ目はそうではありません。プロバイダーごとに、別のキー、SDK、リクエスト形式、レート制限ポリシー、エラー形式、利用状況ページ、請求書が増えていきます。
このLLMゲートウェイ初心者ガイドでは、このレイヤーが何をするのか、リクエストがどのように流れるのか、周辺ツールとどう違うのか、いつ必要になるのか、そして過剰設計せずに最初のゲートウェイ統合をどう実装するのかを解説します。また、構築と購入を比較するスコアカード、段階的な展開計画、そしてゲートウェイが実際にビジネス価値を生んでいるかを判断するための測定可能な受け入れ基準も紹介します。
2026年8月4日更新: このガイドには、リクエストエンベロープ、3つのテストバッチ、受け入れ台帳、本番移行終了条件を含む最初の100リクエスト用ラボに加え、15分のクイックスタートとロールアウトチェックリストが追加されました。
60秒でできる初心者向け判断
次の条件のうち1つのアプリケーションが1つのプロバイダーを呼び出していて、ワークロードがまだ実験段階で、短時間の障害や手動でのキー更新が顧客に影響しないなら、まだLLMゲートウェイは不要である可能性が高いです。
次の項目のうち2つ以上が当てはまるなら、ゲートウェイの導入を検討すべきです:
- アプリケーションが1つ以上のモデルプロバイダーを使用している、または今後使用する予定がある;
- 複数のサービスがAI認証情報と利用制御を必要としている;
- レート制限やプロバイダー障害が顧客のワークフローを中断しうる;
- 財務部門がモデル費用をチーム、製品、または顧客単位で照合できない;
- モデルの変更にアプリケーションのデプロイが必要;
- 共有の許可リスト、クォータ、監査証跡、またはフォールバックポリシーが必要;
- 開発者が複数のリポジトリで同じプロバイダーアダプターを再実装している。
初心者によくある間違いは、アーキテクチャ図が成熟して見えるという理由だけでゲートウェイを採用してしまうことです。繰り返し発生する運用作業を減らす、または測定可能な制御を生み出せる場合に導入しましょう。
LLMゲートウェイとは何か?
LLMゲートウェイは、LLM APIゲートウェイまたはAIゲートウェイとも呼ばれ、アプリケーションがAIモデルにアクセスするための安定したインターフェースを提供します。最も基本的な形では、以下を提供します:
- モデルリクエスト用の単一エンドポイント;
- 単一の認証境界;
- 一貫したリクエスト/レスポンス契約;
- 一元化された利用記録;
- リクエストの送信先を決めるルーティングルール。
より高機能なゲートウェイでは、予算の強制、許可されたモデルの制限、制約付きリトライの処理、同等ルート間のフェイルオーバー、リクエストIDの付与、エラーの正規化、レイテンシ・トークン・コストのテレメトリ出力も可能です。
このLLMゲートウェイ入門ガイドで重要な考え方は、関心の分離です。プロダクトのコードは、完了させる必要がある作業を記述すべきです。ゲートウェイは、プロバイダーへのアクセス、ルーティングポリシー、運用上の制御を担当すべきです。
Application
    │
    │ one authenticated request
    ▼
LLM gateway
    ├── policy and quota check
    ├── model or route selection
    ├── provider request
    ├── retry or safe fallback
    └── usage and error record
             │
             ├── Provider A / Model 1
             ├── Provider B / Model 2
             └── Provider C / Model 3
すべてのモデルプロバイダーを直接呼び出さない理由は?
直接統合は、多くの場合、適切な出発点です。プロトタイプが1つのモデルを使用し、トラフィックが少なく、共有制御を必要としない場合、ゲートウェイを追加すると価値よりも複雑さのほうが増えることがあります。
ただし、アプリケーションが複数のプロバイダーを必要とする場合や、本番環境で確実に動作させなければならない場合は、このトレードオフが変わります。
| 懸念点 | プロバイダーへの直接統合 | LLMゲートウェイ |
|---|---|---|
| 認証情報 | 各環境ごとに個別のキー | アプリケーション向けの単一キーまたはID |
| クライアントコード | プロバイダー固有のクライアントとアダプター | 対応していれば安定したクライアント契約 |
| モデル切り替え | プロバイダーごとのアプリ変更または設定 | 中央集約されたルートまたはモデルポリシーの変更 |
| レート制限 | 各プロバイダーごとに個別に処理 | 協調的な制限、キュー、リトライポリシー |
| 利用状況の追跡 | プロバイダーダッシュボードに分散 | リクエスト、トークン、レイテンシー、コストの一元記録 |
| フェイルオーバー | 各アプリケーション内のカスタムロジック | 共有された、契約を認識したフォールバックポリシー |
| ガバナンス | すべてのサービスで繰り返し実装 | モデルの中央許可リスト、クォータ、監査フィールド |
ゲートウェイは、プロバイダー間の違いを消し去るものではありません。モデルには依然として、異なる機能、コンテキスト制限、ツールスキーマ、ストリーミング動作、安全性ポリシー、価格設定があります。優れたゲートウェイは、すべてのモデルが交換可能だと装うのではなく、そうした違いを明示し、管理しやすくします。
LLMゲートウェイの仕組み: ステップごとに見る
1. アプリケーションが1つのリクエストを送信する
アプリケーションは安定したベースURLを呼び出し、ゲートウェイの認証情報を渡します。OpenAI互換のゲートウェイでは、既存のOpenAIクライアントは base_url、APIキー、モデル識別子を変更するだけで済む場合があります。
2. ゲートウェイがそれを認証し、認可する
ゲートウェイは、呼び出し元のプロジェクト、環境、ユーザー、またはワークロードを検証します。その後、上流側のコストが発生する前に、許可リスト、クォータ、予算、最大トークンのポリシーを確認できます。
3. ルーティングルールが送信先を選択する
リクエストでは、正確なモデル名を指定することもあります。support-fast のようなチーム管理のエイリアスを使うこともあります。あるいは、機能、稼働状況、リージョン、レイテンシー、コストを考慮するルーティングポリシーに入ることもあります。
最初の実装では、明示的なモデル選択か、シンプルなエイリアスを優先してください。動的ルーティングは有用ですが、評価データと可観測性を得てから導入すべきです。
4. ゲートウェイは、保持できるものだけを変換する
一部のゲートウェイは、複数のプロバイダーにまたがって OpenAI 互換の契約を提供します。ゲートウェイは、選択されたプロバイダーの API にフィールドをマッピングし、可能な範囲でレスポンスを正規化します。
互換性には限界があります。モデルを切り替える前に、構造化出力、ツール呼び出し、画像、ストリーミング、終了理由、トークン計測、エラー挙動をテストしてください。「互換」とは、単にリクエストが HTTP 200 を返したという意味ではなく、必要な契約がテストに合格したことを意味すべきです。
5. ゲートウェイは運用ポリシーを処理する
ゲートウェイは、タイムアウトを適用したり、リトライ予算を尊重したり、正常でないルートを一時停止したり、フォールバックを選択したりできます。リトライには上限が必要です。フォールバックはタスクの契約を維持しなければなりません。ツールの副作用や部分的にストリーミングされた出力を含むリクエストでは、自動再実行ではなく、停止して突き合わせる経路が必要になる場合があります。
より深い本番設計については、model fallback strategy playbook と LLM rate limits guide を参照してください。
6. ゲートウェイは何が起きたかを記録する
有用な記録には、リクエスト ID、アプリケーション、環境、要求されたモデル、解決されたプロバイダーとモデル、レイテンシ、ステータス、リトライ回数、入力および出力トークン、推定コストが含まれます。
生のプロンプトとレスポンスは、デフォルトではログに記録しないでください。運用を支えるメタデータを記録し、コンテンツのログ記録は別のセキュリティおよびプライバシー上の判断として扱ってください。
15分でできる LLM Gateway クイックスタート
ゲートウェイを理解する最短の方法は、重要ではない 1 件のリクエストをそこ経由でルーティングすることです。サーバー側のテストスクリプト、明示的なモデル、そして期待される結果が明白なプロンプトを使ってください。自動ルーティングや本番エージェントから始めないでください。
ステップ 1: 直接プロバイダーのベースラインを記録する
何かを変更する前に、現在の直接呼び出しから次の 5 つの情報を保存してください:
- レスポンスがタスクを満たしているかどうか;
- 総レイテンシと、ストリーミングの場合は最初のトークンまでの時間;
- 入力トークン数と出力トークン数;
- プロバイダーのリクエスト ID とエラーの形状;
- 受け入れた結果の推定コスト。
これにより、比較するための具体的な基準ができます。ゲートウェイ移行は、HTTP 200 を返したというだけでは成功とは言えません。
ステップ 2: ワークロードではなく接続を変更する
OpenAI 互換ゲートウェイの場合、アプリケーション側での変更は通常、ゲートウェイ API キー、ゲートウェイのベース URL、そしてサポートされているモデル識別子です。正確な環境変数名は、クライアントとゲートウェイによって異なります。
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["LLM_GATEWAY_API_KEY"],
    base_url=os.environ["LLM_GATEWAY_BASE_URL"],
)

response = client.chat.completions.create(
    model=os.environ["LLM_GATEWAY_MODEL"],
    messages=[
        {"role": "system", "content": "有効なJSONのみを返してください。"},
        {"role": "user", "content": "このチケットをbilling、bug、featureのいずれかに分類してください: 請求が二重に発生しました。"},
    ],
    temperature=0,
)

print(response.choices[0].message.content)
認証情報はサーバー側に保持してください。ゲートウェイのマスターキーをブラウザJavaScript、モバイルバイナリ、公開リポジトリ、共有スクリーンショットに置かないでください。
ステップ3: レスポンス契約を比較する
確認すべきなのはテキスト品質だけではありません。アプリケーションが実際に利用するフィールドを確認してください:
- レスポンスIDとモデル名;
- 終了理由;
- トークン使用量;
- ストリーミングイベントの順序;
- 構造化出力の挙動;
- ツール呼び出しの識別子と引数;
- HTTPステータスとエラー本文;
- キャンセルとタイムアウトの挙動。
OpenAI互換性は移行作業を減らしますが、すべてのプロバイダ機能が同一に動作することを保証するわけではありません。コードが依存する契約をテストしてください。
ステップ4: 安全な失敗を1つ強制する
テスト環境を使って、無効なモデル名、意図的に極端に短いタイムアウト、または開発用クォータなど、予測可能な失敗を1つ引き起こしてください。ゲートウェイが追跡可能なリクエストIDと、アプリケーションが分類できるエラーを返すことを確認します。
制御されていない本番負荷を作ってプロバイダ障害をテストしないでください。目的は、アプリケーションが認証、レート制限、タイムアウト、上流、検証の失敗を区別できることを証明することです。
ステップ5: 受け入れ表で判断する
| 確認項目 | 初心者向け受け入れ基準 |
|---|---|
| 出力 | 直接呼び出しと同じタスク検証を通過する |
| レイテンシ | ワークロードで定めた予算内に収まる |
| 使用量 | トークン関連のフィールドが存在する、または欠如が文書化されている |
| 追跡性 | 1つのリクエストIDでアプリ、ゲートウェイ、上流の記録を結び付けられる |
| エラー | アプリが再試行可能な失敗と再試行不可の失敗を分類できる |
| コスト | 生のリクエストごとではなく、受け入れられた結果ごとに計測される |
| ロールバック | 直接経路への切り戻しが文書化され、テストされている |
ゲートウェイが必要な行のいずれかに失敗する場合、その差分が修正されるか明示的に स्वीकारされるまで、本番環境ではテストを行わないでください。
最初の100件のゲートウェイリクエスト: 初心者向けラボ
最初のリクエストが成功しただけでは、接続性が証明されるだけです。ゲートウェイが本番運用に安全であることはまだ証明されません。次に目指すべき小さな管理可能なマイルストーンは、互換性、追跡性、障害処理、運用規律をテストする代表的な100件のリクエストです。
このラボは意図的にシンプルです。動的ルーティングや複雑な評価プラットフォーム、大規模な本番移行は必要ありません。初心者が、続行するか、特定のギャップを修正するか、あるいは直接プロバイダー経由に戻るかを判断するための十分な根拠を得られるようにしています。
リクエストエンベロープから始める
トラフィックを送る前に、各リクエストに付随する、または対応するゲートウェイ記録に表示されるメタデータを定義します。最小限のリクエストエンベロープは次のようになります。
{
  "request_id": "gw_test_0001",
  "environment": "staging",
  "workload": "support_ticket_classification",
  "requested_route": "ticket-classifier-v1",
  "customer_tier": "internal-test",
  "contains_sensitive_data": false,
  "timeout_ms": 12000,
  "max_attempts": 2,
  "evaluation_case_id": "ticket_014"
}
ゲートウェイでは、この正確な JSON ではなく、ヘッダー、タグ、メタデータフィールド、またはサーバー側コンテキストを使用する場合があります。重要なのは、アプリケーション、ゲートウェイ、評価レコードが安定したリクエスト ID を共有することです。
ルーティングタグに、生のシークレット、完全なプロンプト、個人データ、または機密性の高い顧客テキストを入れないでください。運用メタデータはコンテンツから分離してください。ワークロードに機密データが含まれる場合は、その内容をオブザーバビリティフィールドにコピーするのではなく、分類を記録し、適切なログポリシーを適用してください。
バッチ 1: 40 件の通常リクエスト
一次ルートで成功するはずの代表的な入力を 40 件使用します。1 つのデモプロンプトを繰り返すのではなく、簡単なケース、典型的なケース、境界ケースを含めてください。
各リクエストについて、次を記録します。
- 出力がタスク固有の検証に合格したかどうか;
- ゲートウェイと上流のリクエスト ID;
- 要求されたエイリアスと解決されたプロバイダー/モデル;
- 総レイテンシーと、該当する場合は最初のトークンまでの時間;
- 利用可能な場合は入力トークン数と出力トークン数;
- リトライまたはフォールバック回数;
- 推定コスト;
- 最終的な判定: accepted、rejected、または manual review。
目的は完璧なスコアではありません。失敗が見える形で説明可能かどうかを見つけることが目的です。完全なトレース付きの rejected 出力は、ルートや使用状況の記録がないそれらしい出力よりも有用です。
バッチ 2: 30 件の契約境界リクエスト
次の 30 件のリクエストで、アプリケーションが依存する正確な機能を検証します。次から選んでください。
- 承認済み入力上限付近の長いコンテキスト;
- 厳密な JSON またはスキーマ制約付き出力;
- ストリーミングの開始、キャンセル、完了;
- 有効および無効な引数を伴うツール呼び出し;
- ワークロードで使用する場合の画像、音声、または文書入力;
- 多言語プロンプト;
- 空、壊れた、またはサイズ超過のリクエスト;
- アプリケーションポリシーによって拒否されるべきコンテンツ。
OpenAI 互換のエンドポイントだからといって、すべての境界動作が同一になるとは思わないでください。ゲートウェイがこのバッチを通過できるのは、アプリケーションがレスポンスを正しく消費し、未対応の動作をワークフローを静かに壊すことなく分類できる場合だけです。
バッチ 3: 30 件の制御された失敗リクエスト
非本番環境を使って、境界的な失敗挙動をテストします。次のような安全なケースを含めてください。
- 無効なモデル名またはルート名;
- 欠落している、または失効した開発用資格情報;
- 意図的に短いタイムアウト;
- 開発用のクォータまたはレート制限条件;
- 1つのシミュレートされた再試行可能な上流エラー;
- タスク契約と意図的に互換性のないフォールバック候補1つ。
最後のケースは重要です。別のモデルが利用可能だからといって、ゲートウェイは単にルーティング先を切り替えるべきではありません。代替ルートが構造化出力、ツールの挙動、データポリシー、または品質要件を維持できない場合、正しい対応は停止して分類済みエラーを返すことです。
より詳しい失敗ポリシーについては、model fallback strategy workflow playbook と LLM rate limits guide を使用してください。
1リクエスト1行の受入れ台帳を維持する
まずはスプレッドシートかデータベースのテーブルから始められます。内容を理解する前に、実際のケースを隠してしまうダッシュボードは避けてください。
| Field | What it tells you |
|---|---|
| Request ID | アプリケーション、ゲートウェイ、上流の証跡を結びつけます |
| Evaluation case | どの入力と期待動作をテストしたかを示します |
| Requested route | アプリケーションが何を要求したかを記録します |
| Resolved route | 実際に処理したプロバイダーとモデルを明らかにします |
| Validation result | 有用な完了結果とHTTPレベルの成功を切り分けます |
| Error class | 停止、再試行、ルーティング変更、突合の各ケースを区別します |
| Attempts | 隠れた再試行の増幅を可視化します |
| Latency | ワークロードがユーザー向けの予算内に収まっていることを確認します |
| Estimated cost | 受理された結果ごとの比較を支援します |
| Rollback needed | 本番展開の拡大を妨げるケースを特定します |
100件のリクエスト後、少なくとも4つの要約指標を計算します。
accepted completion rate = accepted results / total requests

trace coverage = requests with complete route and request IDs / total requests

retry amplification = total upstream attempts / total gateway requests

cost per accepted result = total estimated cost / accepted results
ゲートウェイを生のリクエスト価格だけで比較してはいけません。検証に失敗し、繰り返し試行を引き起こし、または手作業での修復を要する安価なリクエストは、タスクを正しく完了するより高価なリクエストよりも高くつくことがあります。
明示的な本番移行の終了基準を使用する
ラボを始める前に、各基準を必須、任意、または適用外としてマークします。そのうえで、熱意ではなく証拠に基づいて判断してください。
| 終了基準 | 初心者向けルールの例 |
|---|---|
| 契約互換性 | 必須のレスポンスフィールドと機能がすべて通過する |
| 受け入れ可能な完了 | 直接プロバイダのベースラインからの実質的な劣化がない |
| 追跡可能性 | すべてのリクエストにアプリケーションIDとゲートウェイのリクエストIDがある |
| ルートの可視性 | 解決されたプロバイダ/モデルが、完了したすべてのリクエストで利用可能である |
| 失敗の分類 | 想定される失敗が stop、retry、reroute、または reconcile にマッピングされる |
| リトライ予算 | いずれのリクエストも、宣言された試行回数またはレイテンシ予算を超えない |
| 機密情報のログ記録 | 別途承認され、管理されていない限り、Raw content はオフである |
| コストの可視性 | 承認された結果あたりのコストを計算できる |
| ロールバック | コードを書き換えずに direct route を復元できる |
次の3つの結果のいずれかを使用します:
- Go: すべての必須基準を満たしている; 低リスクのワークロード1つを小規模なカナリアに移す。
- Fix: ゲートウェイは実用可能だが、明示された互換性、テレメトリ、セキュリティ、または障害ポリシーのギャップが本番投入を妨げている。
- Stop: このレイヤーは、現在の測定可能な問題を解決せずに、リスクや運用作業を追加する。
ラボが完了するのは、誰かがその निर्णयを所有し、証拠が保存され、ロールバック経路が引き続き利用可能な場合だけです。そうすることで、「LLM gateway に接続した」を再現可能なエンジニアリング成果に変えられます。
LLM Gateway の7つの中核機能
1. プロバイダ抽象化
ゲートウェイは、アプリケーションコードとプロバイダAPIの間に安定した境界を作ります。これにより、繰り返しの統合作業が減り、移行のテストもしやすくなります。
2. 認証とキー管理
アプリケーションはゲートウェイに認証し、プロバイダの認証情報はその背後に残ります。これにより、リポジトリやデプロイ環境全体に分散する上流のシークレット数を減らせる場合があります。ただし、ローテーション、スコープ設定、マスキング、インシデント対応の必要性はなくなりません。専用の安全なAPIキー管理ガイドに従ってください。
3. モデルルーティング
ルーティングは「このエイリアスをこのモデルに送る」程度に単純でも構いません。より高度なポリシーでは、機能、健全性、レイテンシ、リージョン、コストを使用できます。判断は説明可能に保ってください。すべてのリクエストで、なぜそのルートが選ばれたのかを記録する必要があります。
4. 信頼性制御
ゲートウェイは、タイムアウト、リトライ予算、サーキットブレーカー、ヘルスチェック、安全なフォールバックを集約できます。集約することで、各アプリケーションチームがそれぞれ別の障害ポリシーを作るのを防げます。
5. レート制限の調整
プロバイダは通常、時間あたりのリクエスト数やトークン数に制約を設けます。ゲートウェイは、複数のサービスが同じ上流のクォータを無計画に奪い合うのではなく、同時実行数、キュー、バックオフ、ルート容量を調整できます。
6. 可観測性とコスト配賦
ゲートウェイはすべてのリクエストを把握するため、一貫したテレメトリを付与するのに自然な場所です。生のトークンコストだけでなく、それ以上の指標を計測しましょう。受理されたタスク率、レイテンシ、リトライ、そして受理されたタスクあたりのコストを追跡し、安価でも信頼性の低い経路が効率的に見えてしまわないようにします。
AI APIコスト最適化ガイドでは、一覧価格だけでなくワークロードの結果を用いて経路を比較する方法を説明しています。
7. ポリシーとガバナンス
チームはゲートウェイを使ってモデルを制限し、予算を設定し、トークン使用量に上限を設け、開発用キーと本番用キーを分離し、監査対応可能な利用記録を作成できます。これらの制御は、より多くのアプリケーションやエージェントが同じモデルアクセス層を共有するようになるほど、ますます有用になります。
LLM Gatewayと類似ツールの比較
初心者はしばしば、「gateway」「router」「orchestration framework」「reverse proxy」を同じ意味で使います。これらは重なる部分がありますが、同じものではありません。
| ツール | 主な役割 | 通常は担当しないもの |
|---|---|---|
| LLM gateway | モデル呼び出し全体にわたるアクセス、ポリシー、ルーティング、信頼性、テレメトリ | アプリケーション全体のワークフロー |
| Model router | モデルまたは上流経路の選択 | 認証、課金、ガバナンス、または同梱されていない限り完全な可観測性 |
| Orchestration framework | プロンプト、ツール、メモリ、エージェント、複数ステップのワークフローを調整する | デフォルトで中央のプロバイダーアカウントと課金制御 |
| Reverse proxy | ネットワークトラフィックの転送、TLS終端、一般的なHTTP制御の適用 | モデルを意識したトークン上限、フォールバック契約、またはデフォルトでのAI利用会計 |
| Provider SDK | プロバイダー固有の機能を使って1つのプロバイダーのAPIを呼び出す | クロスプロバイダーのルーティングと統合された制御 |
これらの層は組み合わせることができます。エージェントフレームワークがLLM gatewayを呼び出し、gatewayが内部でrouterを使い、reverse proxyがネットワーク制御のためにgatewayの前段に置かれることもあります。
LLM Gatewayはいつ必要か?
このLLM gateway初心者ガイドを意思決定のテストとして使ってください。次のうち2つ以上が当てはまるなら、gatewayを評価する価値があります。
- 2つ以上のモデルプロバイダーをサポートしている。
- 複数のサービスやエージェントがモデルアクセスを必要としている。
- プロバイダーキーが環境ごとに重複している。
- どのアプリケーションが請求を発生させたのか、チームが答えられない。
- レート制限の扱いがコードベースごとに異なる。
- プロバイダー障害や劣化した経路が重要なワークフローを中断する。
- モデルの許可リスト、クォータ、または環境レベルの予算が必要。
- モデルの切り替えに、SDKやデプロイの変更を何度も行う必要がある。
- 運用チームが、アプリケーション層とプロバイダー層をまたぐ1つのリクエストIDを必要としている。
低リスクのプロトタイプが1つ、プロバイダーが1つ、所有者が1人で、本番の信頼性やガバナンス要件がない場合は、まだgatewayは不要かもしれません。まずは直接アクセスから始めつつ、将来の移行を管理しやすくするために、プロバイダー呼び出しは小さなアプリケーションアダプターの背後に置いておきましょう。
LLM Gatewayを自作するか購入するか: 実践的スコアカード
最も重要なビジネス評価の問いは、ゲートウェイが役に立つかどうかではありません。チームがどの部分を自分たちで持つべきかです。ゲートウェイを自前で構築することも、ホスト型サービスを採用することも、オープンソースのプロキシを運用することも、あるいはそれらを組み合わせることもできます。
機能チェックリストから選ぶのではなく、重み付きスコアカードを使いましょう。各 विकल्पを1〜5で採点し、重みを掛け合わせて、合計を比較します。以下の重みは出発点であり、普遍的なルールではありません。
| 基準 | 推奨重み | 確認すべき प्रश्न |
|---|---|---|
| ワークロード互換性 | 25% | ストリーミング、構造化出力、ツール、画像、エラー詳細、トークン集計を保持できますか? |
| 信頼性 | 20% | タイムアウト、リトライ、ヘルスチェック、フォールバックルール、インシデントの可視性は明示されていますか? |
| セキュリティとガバナンス | 15% | テナントを分離し、モデルを制限し、認証情報をローテーションし、コンテンツをマスキングし、アクセスを監査できますか? |
| 可観測性 | 15% | 要求されたルート、解決されたルート、試行、レイテンシー、使用量、検証、コストを追跡できますか? |
| 運用負荷 | 10% | アップグレード、プロバイダー変更、スケーリング、オンコール対応、データ保持は誰が担当しますか? |
| 商業的適合性 | 10% | 課金は分かりやすく、エクスポート可能で、帰属可能で、想定される利用パターンに適合していますか? |
| 移行経路 | 5% | 設定とテレメトリーをエクスポートし、アプリケーションの契約を維持したまま、再実装なしで切り替えできますか? |
制御そのものが製品であるときは構築する
ルーティングの挙動が中核となる競争優位である場合、利用可能なサービスでは満たせないデプロイメントモデルが規制で求められる場合、またはトラフィック規模が専任のプラットフォームチームを正当化する場合、構築は合理的です。ただし、「構築」にはHTTPリクエストの転送以上のものが含まれます。認証、プロバイダーアダプター、スキーマ差分、ストリーミング、エラー正規化、クォータ、可観測性、リリース管理、セキュリティレビュー、インシデント対応を自分たちで担うことを意味します。
アクセスと運用が差別化されないなら購入する
ホスト型ゲートウェイは、複数プロバイダーへより早く到達したい、課金と認証情報を集約したい、複数のアプリケーションに共有コントロールプレーンを提供したい、という目的に通常よく適しています。それでも評価には移行経路を含めるべきです。ゲートウェイをアプリケーションアダプターの背後に置き、モデル機能テストを保持し、製品コード全体にプロバイダー固有の前提を埋め込まないようにしましょう。
運用できるならオープンソースを使う
オープンソースのゲートウェイやプロキシは柔軟性とコードの可視性を提供できますが、自前運用は可用性、スケーリング、アップグレード、テレメトリー保存、セキュリティパッチ適用をチームに移します。ソフトウェアライセンスだけでなく、総運用責任を比較してください。
4段階のLLMゲートウェイ展開
安全な展開は、一度に1層ずつ実証します。すべてのワークロードにわたる動的コストルーティングから始めてはいけません。
ステージ1: 互換性のシャドーテスト
候補のゲートウェイを通して代表的な評価セットを、運用中の挙動を変えずに実行します。リクエストのフィールド、レスポンス、ストリーミング、ツール呼び出し、構造化出力、使用量フィールド、エラーを確認します。不一致はすべて記録してください。アプリケーションの契約が変わるなら、HTTPレスポンスが成功していても十分ではありません。
終了条件: ゲートウェイが、理由の説明できない契約損失なしに、ワークロードに必要な機能と品質チェックを通過すること。
ステージ 2: 1つの低リスクワークロード
可逆で非重要なワークロードを、明示的な1つのモデルルートへ移行します。ロールバック用として、以前のプロバイダー直結パスは利用可能なままにしておきます。リトライやフォールバックを追加する前に、リクエストIDと解決済みルートのテレメトリを追加します。
終了条件: チームが失敗したリクエストをすべて説明でき、使用量を突き合わせ、コードリリースなしでロールバックできること。
ステージ 3: 信頼性ポリシー
実際に観測した障害モードに対して、上限付きタイムアウト、リトライ分類、そして1つの検証済みフォールバックを追加します。両方とも似たJSONを受け入れるという理由だけでモデル間をフォールバックしてはいけません。代替ルートは同じワークロード契約を満たす必要があります。
より深いリカバリ設計については、モデルフォールバック戦略プレイブックとLLMレート制限ガイドを参照してください。
終了条件: 障害訓練により、リトライとフォールバックが重複する副作用、暴走するレイテンシ、または制御不能なコスト増を引き起こすことなく、受理された完了を改善することが示されること。
ステージ 4: 共有本番コントロールプレーン
最初のワークロードで安定した計測が得られてから、拡張します。テナントのクォータ、モデルの許可リスト、環境分離、予算アラート、ルート変更のための文書化された手順を追加します。誰がポリシーを変更できるのか、変更がどのように監査されるのかを確認します。
終了条件: 複数のアプリケーションが、コスト帰属、インシデント追跡性、セキュリティ境界、ロールバック制御を失うことなくゲートウェイを使用できること。
初心者向けエラーマップ: リトライ、再ルート、または停止?
ゲートウェイの信頼性は、フォールバックモデルの数よりも、各障害に対して正しい判断を下すことに左右されます。この簡略化したマップを出発点として使用してください。
| 失敗 | 典型的な意味 | 初心者向けの対応 |
|---|---|---|
| 400 または validation error | リクエスト契約が無効、またはサポートされていない | 停止し、リクエストを修正して、同じ内容を再試行しない |
| 401 または 403 | 認証情報、権限、モデルの allowlist、またはアカウントの問題 | 停止してアラートを上げる。ランダムなキーを順に試してはいけない |
| 404 model or route | 設定された識別子が利用不可、または誤っている | 停止するか、明示的に承認された同等ルートを使用する |
| 408 または client timeout | 呼び出し元のレイテンシ予算が切れた | 可能ならキャンセルし、タスクが冪等な場合にのみ再試行する |
| 429 rate limit | 容量またはクォータを超過した | 再試行の指示に従い、キューに入れるか、検証済みの同等ルートを使う |
| 出力前の 5xx | ゲートウェイまたは上流が、利用可能な応答を返す前に失敗した | 上限付き再試行または検証済みのフェイルオーバーを使う |
| ストリームが出力途中で途切れる | 部分的な内容がすでに存在する可能性がある | 停止して整合性を確認する。副作用を無条件に再実行しない |
| ツール呼び出しが実行された可能性がある | 外部状態が変化しているかもしれない | 再試行前に冪等キーまたはツールの状態を確認する |
上限付き という言葉が重要です。すべてのワークフローには、最大再試行回数、総時間予算、そして終了状態が必要です。そうでないと、ゲートウェイは 1 回のプロバイダ障害を、重複したツール操作、暴走するコスト、より大きな障害へと変えてしまいます。
より深い実装については、model fallback strategy playbook を参照してください。
ゲートウェイが機能しているかを測定する方法
ゲートウェイの成功は、接続されているプロバイダ数ではありません。受け入れられた成果と運用制御の改善です。
| 指標 | 示していること | 初心者向けの計算方法 |
|---|---|---|
| 受け入れられた完了率 | ユーザーが利用可能な結果を受け取れているか | 受け入れられた結果 ÷ ワークフロー開始数 |
| ゲートウェイ起因の失敗率 | 新しいレイヤーが失敗を生み出しているか | ゲートウェイ失敗数 ÷ ゲートウェイリクエスト数 |
| p95 エンドツーエンドレイテンシ | ポリシーとフェイルオーバーがユーザー体験を損ねていないか | アプリケーション開始から受け入れられた結果までの 95 パーセンタイル |
| フォールバック回復率 | フォールバックが実際の失敗を解決しているか | 受け入れられたフォールバック結果 ÷ フォールバック試行数 |
| 受け入れられた結果あたりのコスト | 安い呼び出しが、より安い成果につながっているか | モデルと再試行の合計コスト ÷ 受け入れられた結果 |
| ルートの説明可能性 | 障害と請求を追跡できるか | 要求されたルートと解決済みルートのフィールドがあるリクエスト ÷ 総リクエスト数 |
| ポリシー拒否の精度 | ガバナンスが意図したトラフィックをブロックしているか | 正しく拒否されたリクエスト ÷ レビュー済み拒否数 |
移行前にベースラインを設定してください。そのうえで、同じワークロード、評価セット、トラフィック区分、時間窓で比較します。品質が低下する、レイテンシが増える、またはコストの突合が難しくなるなら、見かけ上のトークン単価が下がっても、それは成功したゲートウェイの結果ではありません。
コスト分析については、AI API cost optimization guideを引き続き参照してください。より包括的なテレメトリ計画については、AI observability implementation checklistを使用してください。
初心者向けの実装: 5つの実践ステップ
ステップ1: タスク契約を書き出す
サポートチケットの要約や請求書からの項目抽出など、実際のワークロードを1つ選びます。以下を定義します。
- 必要な入力と出力;
- 許容されるレイテンシー;
- 検証ルール;
- ストリーミングが必要かどうか;
- ツールが副作用を引き起こしうるかどうか;
- 何を合格結果とみなすか。
この契約によって、フォールバックが安全かどうか、また別のモデルが実際に同等かどうかが決まります。
ステップ2: 安定したクライアントインターフェースを選ぶ
アプリケーションがすでにOpenAI互換のSDKを使用している場合、互換性のあるゲートウェイにより移行作業を減らせます。たとえばFlatkeyでは、https://router.flatkey.ai/v1 にOpenAI互換のベースURLがあることをドキュメントで示しています。
curl -X POST "https://router.flatkey.ai/v1/chat/completions" \
  -H "Authorization: Bearer $FLATKEY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "your-model",
    "messages": [
      {"role": "user", "content": "このエラーを平易な英語で説明してください。"}
    ]
  }'
キーにはシークレットマネージャーまたはサーバー側の環境変数を使用してください。ブラウザやモバイルのクライアントコードに埋め込んではいけません。
ステップ3: 明示的なルーティングから始める
ワークロードを、検証済みの1つのモデルにルーティングします。アプリケーションから独立した構成にしたい場合は、設定で内部エイリアスをそのモデルにマッピングします。再現可能な評価セットができるまでは、不透明な「最安モデル」や「最適モデル」のルーターは避けてください。
ステップ4: 最小限実用のテレメトリを追加する
以下を記録します。
- ゲートウェイのリクエストID;
- ワークロードと環境;
- 要求されたエイリアス;
- 解決されたプロバイダーとモデル;
- ステータスとレイテンシー;
- リトライ回数とフォールバック回数;
- 入力トークンと出力トークン;
- 推定コスト;
- 検証結果。
これだけあれば、最初の本番障害をデバッグし、後で代替案を比較するのに十分です。
ステップ5: 1つの制約付き障害ポリシーを追加する
まずはタイムアウトと、瞬断的な障害に対する小さなリトライ予算から始めます。代替ルートが同じタスク契約を満たすことを確認してから、フォールバックを追加してください。ストリーミングや副作用を伴うツール呼び出しでは、アプリケーションが部分完了をどのように検知し、状態をどう整合させるかを定義します。
LLM Gatewayを使う最初の1週間
すべてのアプリケーションを一度に移行するのではなく、7日間の導入計画を使ってください。
1日目: 1つのワークロードを棚卸しする
現在のプロバイダー、モデル、SDK、認証情報、必要な機能、トラフィック、レイテンシーバジェット、データの機密性、ロールバック担当者を書き出します。
2日目: 互換性テストを実行する
直接ルートとゲートウェイルートの両方を通じて、代表的なプロンプトを送信します。ワークロードで長文入力、構造化出力、ストリーミング、ツール、期待されるエラーケースを使用する場合は、それらも含めます。
3日目: リクエストIDと使用記録を追加する
アプリケーションがゲートウェイのリクエストIDを保存し、機密コンテンツをデフォルトでログに記録することなく、モデル、プロバイダールート、レイテンシ、トークン、再試行回数、検証結果と関連付けられることを確認します。
4日目: 障害ポリシーを定義する
エラーを停止、再試行、同等フェイルオーバー、クロスモデルフォールバック、手動照合に分類します。総再試行回数とレイテンシの予算を設定します。
5日目: 小規模な本番カナリアを送信する
低リスクのワークロード1つと、意図的に小さいトラフィック割合を使用します。直接ルートは利用可能なままにしておきます。受理された完了率、p95レイテンシ、受理された結果あたりのコストを比較します。
6日目: セキュリティと支出制御を見直す
開発用と本番用の資格情報を分離し、許可されたモデルを制限し、クォータを設定し、ルーティングポリシーを誰が閲覧または変更できるかを確認します。より完全な制御チェックリストについては、安全なAPIキー管理ガイドを使用してください。
7日目: Go、Fix、Stopの判断を下す
- Go: 必須の契約チェックに合格し、カナリアが受け入れ基準を満たしている。
- Fix: アーキテクチャは健全だが、1つの測定可能なギャップが拡大を妨げている。
- Stop: ゲートウェイが、現在の制御上の利点がないまま運用リスクまたはコストを追加している。
判断内容と次回レビュー日を文書化します。計測されていない移行よりも、制御された停止のほうが望ましいです。
初心者によくあるミス
すべてのモデルを互換可能だと扱うこと
リクエスト構文が正規化されていても、機能と出力の挙動は異なります。ワークロードで使用する正確な機能をテストしてください。
測定前にルーティングすること
評価データなしの動的ルーティングでは、意思決定ロジックがブラックボックスに入ってしまいます。まずベースラインを確立し、その後で測定可能なポリシーを導入してください。
すべてのエラーを再試行すること
認証エラー、無効なリクエスト、予算超過、未対応機能は一時的なものではありません。後で成功する可能性のあるエラーだけを再試行し、必要に応じてジッター付きの指数バックオフを使用してください。
デフォルトで機密コンテンツをログに記録すること
プロンプトには、顧客情報、ソースコード、またはビジネスデータが含まれる場合があります。メタデータの可観測性とコンテンツ保持は分けて管理してください。
解決されたルートを隠すこと
アプリケーションがエイリアスを要求する場合は、実際に使用されたプロバイダーとモデルを記録してください。そうしないと、障害、品質低下、コスト変動の説明が難しくなります。
成果ではなく価格を測定すること
トークン単価が低いからといって、ワークロード全体のコストが低くなるとは限りません。コスト計算には検証失敗と再試行を含めてください。
Flatkeyがゲートウェイパターンに適合する方法
Flatkeyは、1つのキー、共有利用記録、そしてOpenAI互換のモデルエンドポイントを備えた、統合されたモデルおよびツールアクセス層を提供します。既存の互換クライアントに対する移行パスは、ベースURLを変更し、Flatkeyのキーを使用し、対応モデルを選択し、ワークロード契約をテストすることです。
そのため、集約レイヤーを自分で構築・運用せずにプロバイダーのアカウント乱立を減らしたい場合に、Flatkeyは有用です。設計を評価していて初心者向けの概要を探しているわけではないなら、詳細なAI API gateway architecture guideをお読みください。クライアントの移行準備ができているなら、OpenAI-compatible API gateway checklistを使用してください。
実際のワークロードを試す準備ができたら、Flatkeyモデルを探す、ドキュメントを確認する、またはAPIキーを作成することができます。
LLM Gateway初心者ガイドのチェックリスト
LLMゲートウェイを通して本番トラフィックを送信する前に、以下を確認してください:
- [ ] 1つのワークロード契約に成功基準が定義されている。
- [ ] アプリケーションがサーバー側のゲートウェイ認証情報を使用している。
- [ ] 選択したモデルが代表的なテストに合格した。
- [ ] 構造化出力、ツール、ストリーミングを使用する場合はテスト済みである。
- [ ] タイムアウトと再試行可能なエラーが明示的に定義されている。
- [ ] フォールバックがワークロード契約を維持する。
- [ ] すべてのリクエストに追跡可能なリクエストIDが付与される。
- [ ] 解決されたプロバイダーとモデルが記録される。
- [ ] トークン、レイテンシー、再試行、検証、コストが測定される。
- [ ] 開発用と本番用のクォータが分離されている。
- [ ] 生コンテンツのログ記録が無効化されているか、意図的に管理されている。
- [ ] 直接ロールバックするパスが文書化されている。
- [ ] 許容された完了、レイテンシー、受け入れられた結果1件あたりのコストのベースラインが存在する。
- [ ] ビルド、ホスト型、セルフホスト型のオプションが、運用負荷と退出経路の観点で比較されている。
- [ ] 最初の展開では、動的ルーティングを導入する前に、明示的な1つのルートを使用する。
よくある質問
LLMゲートウェイはAPIゲートウェイと同じですか?
これは、AIモデルのトラフィック向けに特化したAPIゲートウェイです。認証やレート制限などの標準的なAPIゲートウェイ機能に加え、モデル認識ルーティング、トークン使用量、AI固有のエラー正規化、契約を考慮したフォールバックを提供できます。
LLMゲートウェイはモデルをホストしますか?
必ずしもそうではありません。外部プロバイダーにルーティングするゲートウェイもあれば、推論インフラと統合されているものもあり、両方をサポートするものもあります。推論がどこで行われるのか、どのプロバイダーが実際に各モデルを提供しているのか、そのルートが利用記録にどのように表示されるのかを確認してください。
LLMゲートウェイはコストを削減しますか?
利用データを一元化し、クォータを適用し、重複する統合を減らし、測定に基づくルート変更を可能にすることで役立つ場合があります。節約は自動的には起こりません。再試行や品質不良も含め、受け入れられたタスク1件あたりのコストを比較してください。
OpenAI SDKでLLMゲートウェイを使えますか?
はい、ゲートウェイがOpenAI互換エンドポイントを公開し、アプリケーションが使用する機能をサポートしている場合は可能です。ベースURLと認証情報を変更し、完全なワークロード契約を、完全な互換性があると仮定せずにテストしてください。
ゲートウェイは単一障害点ですか?
その可能性はあります。デプロイメントアーキテクチャ、ヘルスチェック、上流のフェイルオーバー、タイムアウト動作、可観測性、サービス約束、ロールバック経路を評価してください。制御を一元化すると運用上のレバレッジは高まるため、ゲートウェイ自体を本番インフラとして扱う必要があります。
スタートアップはLLMゲートウェイを自作すべきですか、それとも購入すべきですか?
ゲートウェイの振る舞いが中核的な差別化要因である場合、特殊なデプロイ制約が必要な場合、または運用するチームがいる場合は、自作が向いています。主な目的が、より速い導入、より少ないプロバイダー統合、統一された利用状況、共有制御であれば、購入が向いています。小規模チームでも、プロバイダー呼び出しがすでにアダプターの背後に分離されていれば、まず直接接続で始めて後から移行できます。
本番トラフィックを移す前に何をテストすべきですか?
正確なワークロード契約をテストしてください。ストリーミング、構造化出力、ツール、メディア入力、コンテキスト制限、エラー動作、タイムアウト処理、使用量フィールド、出力品質です。その後、直接のロールバック経路を持つ低リスクのカナリアを実行し、ゲートウェイ導入前のベースラインと比較して、受理された完了率、p95レイテンシ、受理済み結果あたりのコストを比較してください。
シンプルなメンタルモデル
このLLM gateway初心者ガイドを最短で言うと、次のとおりです。
あなたのアプリケーションはAIの処理を要求します。ゲートウェイは、そのリクエストが許可されるか、どこに送るか、失敗をどう処理するか、何を記録するかを決定します。
1つのワークロード、1つの安定したインターフェース、明示的なルーティング、最小限の実用的なテレメトリ、そして1つの境界が定められた障害ポリシーから始めてください。品質、レイテンシ、信頼性、コストを測定できるようになってから、高度なルーティングを追加してください。