Guia para Iniciantes de LLM Gateway: Da Primeira Requisição à Produção
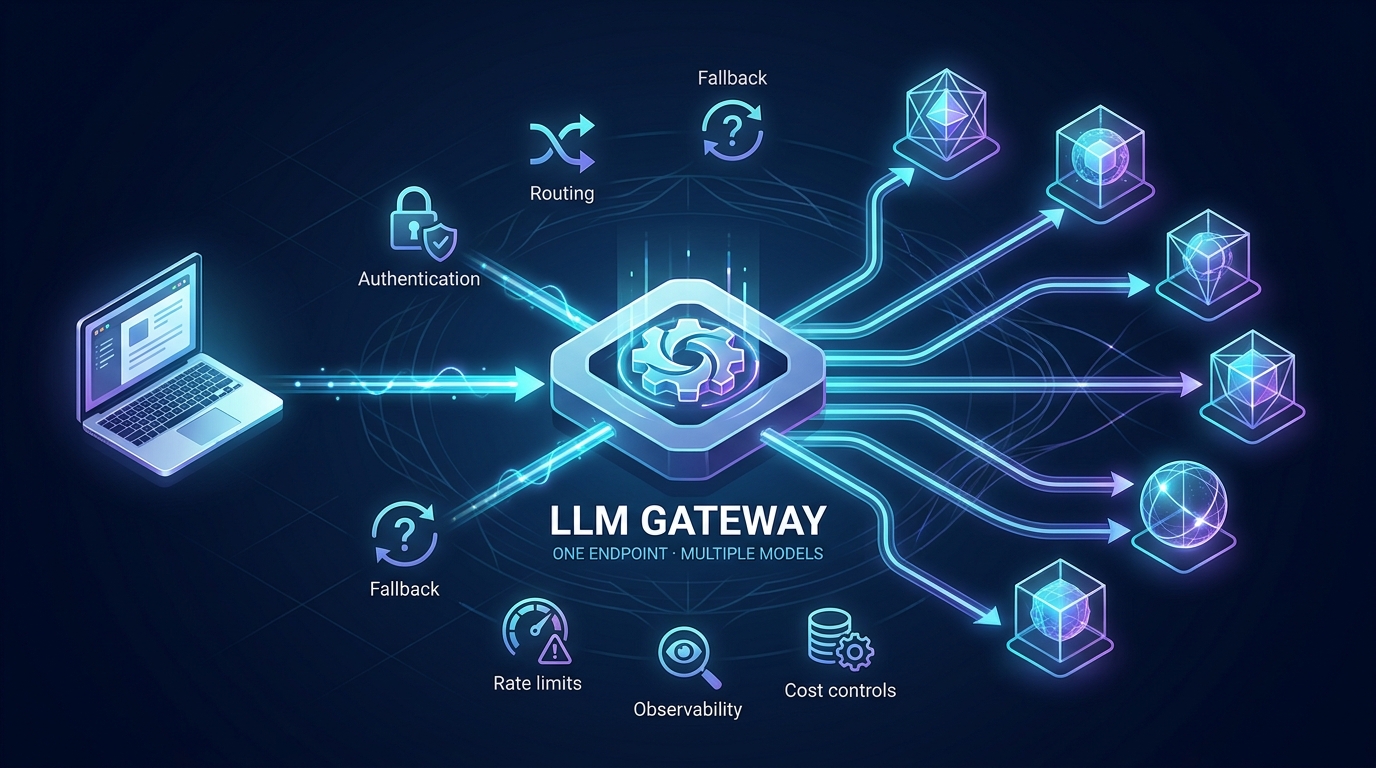
Um LLM gateway é uma camada de controle entre sua aplicação e um ou mais provedores de modelos de IA. Seu app envia requisições ao gateway em vez de se conectar separadamente a cada provedor. O gateway então autentica a requisição, aplica políticas, escolhe um modelo ou conexão upstream, encaminha a chamada e registra o resultado.
Isso parece um plumbing de API comum, mas resolve um problema que surge rapidamente em produtos reais de IA: a primeira integração de modelo é simples; a quinta não é. Cada provedor pode introduzir outra chave, SDK, formato de requisição, política de limite de taxa, formato de erro, página de uso e cobrança.
Este guia para iniciantes de LLM gateway explica o que a camada faz, como uma requisição passa por ela, como ela difere de ferramentas adjacentes, quando você precisa de uma e como implementar uma primeira integração com gateway sem exagerar na engenharia. Ele também fornece uma matriz de decisão entre construir versus comprar, um plano de implantação em etapas e critérios mensuráveis de aceitação para decidir se um gateway está criando valor real para o negócio.
Atualizado em 4 de agosto de 2026: Este guia agora inclui um laboratório dos primeiros 100 pedidos com um envelope de requisição, três lotes de teste, um registro de aceitação e critérios de saída para produção, além do quickstart de 15 minutos e da lista de verificação de implantação.
A Decisão de 60 Segundos para Iniciantes
Você provavelmente ainda não precisa de um LLM gateway se uma aplicação chama um provedor, a carga de trabalho ainda é experimental e uma breve indisponibilidade ou rotação manual de chave não afetaria os clientes.
Você deve avaliar um gateway quando duas ou mais destas afirmações forem verdadeiras:
- sua aplicação usa, ou espera usar, mais de um provedor de modelos;
- vários serviços precisam de credenciais de IA e controles de uso;
- limites de taxa ou incidentes do provedor podem interromper o fluxo de trabalho de um cliente;
- as finanças não conseguem reconciliar os gastos com modelos por equipe, produto ou cliente;
- trocar modelos exige uma implantação da aplicação;
- você precisa de uma allowlist compartilhada, quota, trilha de auditoria ou política de fallback;
- os desenvolvedores estão recriando os mesmos adaptadores de provedor em vários repositórios.
O erro de iniciante é adotar um gateway porque o diagrama de arquitetura parece maduro. Adote-o quando ele eliminar trabalho operacional repetido ou criar um controle que você possa medir.
O que é um LLM Gateway?
Um LLM gateway, também chamado de LLM API gateway ou AI gateway, oferece às aplicações uma interface estável para acessar modelos de IA. Em sua forma mais simples, ele fornece:
- um endpoint para requisições de modelo;
- uma única fronteira de autenticação;
- um contrato consistente de requisição e resposta;
- registros centralizados de uso;
- regras de roteamento que decidem para onde uma requisição vai.
Um gateway mais capaz também pode impor orçamentos, restringir modelos permitidos, tratar retries limitados, fazer failover entre rotas equivalentes, anexar IDs de requisição, normalizar erros e emitir telemetria de latência, tokens e custos.
A ideia importante neste guia para iniciantes de gateway LLM é a separação de responsabilidades. O código do seu produto deve descrever a tarefa que precisa ser concluída. O gateway deve lidar com acesso ao provedor, política de roteamento e controles operacionais.
Application
    │
    │ uma requisição autenticada
    ▼
Gateway LLM
    ├── verificação de política e cota
    ├── seleção de modelo ou rota
    ├── requisição ao provedor
    ├── tentativa novamente ou fallback seguro
    └── registro de uso e erro
             │
             ├── Provedor A / Modelo 1
             ├── Provedor B / Modelo 2
             └── Provedor C / Modelo 3
Por que não chamar diretamente cada provedor de modelo?
A integração direta costuma ser o ponto de partida certo. Se um protótipo usa um modelo, tem baixo tráfego e não precisa de controles compartilhados, adicionar um gateway pode criar mais superfície de complexidade do que valor.
O equilíbrio muda quando a aplicação precisa de vários provedores ou precisa operar de forma confiável em produção.
| Preocupação | Integrações diretas com provedores | Gateway LLM |
|---|---|---|
| Credenciais | Chaves separadas em cada ambiente | Uma chave ou identidade voltada para a aplicação |
| Código do cliente | Clientes e adaptadores específicos do provedor | Contrato de cliente estável onde suportado |
| Troca de modelo | Alteração na aplicação ou configuração por provedor | Alteração central de rota ou política de modelo |
| Limites de taxa | Lidado separadamente para cada provedor | Limites, filas e política de retentativa coordenados |
| Rastreamento de uso | Distribuído entre painéis dos provedores | Registros centralizados de requisições, tokens, latência e custo |
| Failover | Lógica personalizada em cada aplicação | Política de fallback compartilhada e consciente do contrato |
| Governança | Repetida em cada serviço | Listas de अनुमतिção de modelos, cotas e campos de auditoria centralizados |
O gateway não faz desaparecer as diferenças entre provedores. Os modelos ainda podem ter capacidades, limites de contexto, esquemas de ferramentas, comportamento de streaming, políticas de segurança e preços diferentes. Um bom gateway torna essas diferenças explícitas e gerenciáveis, em vez de fingir que todos os modelos são intercambiáveis.
Como um gateway LLM funciona, passo a passo
1. A aplicação envia uma requisição
A aplicação chama uma URL base estável e fornece uma credencial do gateway. Com um gateway compatível com OpenAI, um cliente OpenAI existente pode precisar apenas de um base_url, chave de API e identificador de modelo diferentes.
2. O gateway autentica e autoriza isso
O gateway verifica o projeto, ambiente, usuário ou carga de trabalho que faz a chamada. Em seguida, ele pode verificar uma lista de अनुमतिção, cota, orçamento ou política de limite máximo de tokens antes que qualquer gasto upstream ocorra.
3. Uma regra de roteamento escolhe o destino
A requisição pode nomear um modelo exato. Ela pode usar um alias controlado pela equipe, como support-fast. Ou pode entrar em uma política de roteamento que considera capacidade, integridade, região, latência ou custo.
Para uma primeira implementação, prefira a seleção explícita de modelo ou um alias simples. O roteamento dinâmico é útil, mas deve vir depois de você ter dados de avaliação e observabilidade.
4. O gateway traduz apenas o que consegue preservar
Alguns gateways expõem um contrato compatível com a OpenAI em vários provedores. O gateway mapeia campos para a API do provedor selecionado e normaliza a resposta quando possível.
A compatibilidade tem limites. Antes de trocar de modelo, teste saída estruturada, chamada de ferramentas, imagens, streaming, motivos de término, contabilização de tokens e comportamento de erro. “Compatível” deve significar que o contrato necessário passou nos testes, e não apenas que a requisição retornou HTTP 200.
5. O gateway lida com a política operacional
O gateway pode aplicar um timeout, respeitar um orçamento de tentativas, pausar uma rota insalubre ou escolher um fallback. As tentativas devem ser limitadas. Os fallbacks devem preservar o contrato da tarefa. Requisições com efeitos colaterais de ferramentas ou saída parcialmente transmitida podem exigir um caminho de interromper e reconciliar em vez de uma repetição automática.
Para um design mais profundo de produção, use o playbook de estratégia de fallback de modelos e o guia de limites de taxa de LLM.
6. O gateway registra o que aconteceu
Registros úteis incluem um ID da requisição, aplicação, ambiente, modelo solicitado, provedor e modelo resolvidos, latência, status, contagem de tentativas, tokens de entrada e saída e custo estimado.
Não registre prompts e respostas brutos por padrão. Registre metadados que deem suporte às operações e trate o registro de conteúdo como uma decisão separada de segurança e privacidade.
Um início rápido de 15 minutos com LLM Gateway
A maneira mais rápida de entender um gateway é encaminhar por ele uma requisição não crítica. Use um script de teste do lado do servidor, um modelo explícito e um prompt com um resultado esperado óbvio. Não comece com roteamento automático nem com um agente de produção.
Passo 1: Registre a linha de base do provedor direto
Antes de mudar qualquer coisa, salve cinco fatos da chamada direta atual:
- se a resposta satisfaz a tarefa;
- latência total e tempo até o primeiro token, se houver streaming;
- contagens de tokens de entrada e saída;
- ID da requisição do provedor e formato do erro;
- custo estimado para o resultado aceito.
Isso lhe dá algo concreto para comparar. A migração para um gateway não é bem-sucedida apenas porque retorna HTTP 200.
Passo 2: Mude a conexão, não a carga de trabalho
Para um gateway compatível com a OpenAI, a mudança do lado da aplicação geralmente é uma chave de API do gateway, uma URL base do gateway e um identificador de modelo compatível. Os nomes exatos das variáveis de ambiente dependem do cliente e do gateway.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["LLM_GATEWAY_API_KEY"],
    base_url=os.environ["LLM_GATEWAY_BASE_URL"],
)

response = client.chat.completions.create(
    model=os.environ["LLM_GATEWAY_MODEL"],
    messages=[
        {"role": "system", "content": "Retorne apenas JSON válido."},
        {"role": "user", "content": "Classifique este ticket como cobrança, bug ou recurso: Fui cobrado duas vezes."},
    ],
    temperature=0,
)

print(response.choices[0].message.content)
Mantenha as credenciais no servidor. Nunca coloque uma chave mestra do gateway em JavaScript do navegador, em um binário mobile, em um repositório público ou em uma captura de tela compartilhada.
Etapa 3: Compare o contrato da resposta
Verifique mais do que a qualidade do texto. Confirme os campos que sua aplicação realmente consome:
- ID da resposta e nome do modelo;
- motivo de término;
- uso de tokens;
- ordem dos eventos de streaming;
- comportamento de saída estruturada;
- identificadores e argumentos de chamadas de ferramenta;
- status HTTP e corpo do erro;
- comportamento de cancelamento e timeout.
A compatibilidade com OpenAI reduz o trabalho de migração, mas não garante que cada recurso do provedor se comporte de forma idêntica. Teste o contrato do qual seu código depende.
Etapa 4: Force uma falha segura
Use um ambiente de teste para acionar uma falha previsível, como um nome de modelo inválido, um timeout intencionalmente muito curto ou uma cota de desenvolvimento. Verifique se o gateway retorna um ID de requisição rastreável e um erro que sua aplicação consiga classificar.
Não teste uma indisponibilidade do provedor criando carga descontrolada em produção. O objetivo é provar que sua aplicação consegue distinguir falhas de autenticação, limite de taxa, timeout, upstream e validação.
Etapa 5: Decida com uma tabela de aceitação
| Verificação | Regra de aceitação para iniciantes |
|---|---|
| Saída | Passa na mesma validação de tarefa que a chamada direta |
| Latência | Dentro do orçamento declarado da carga de trabalho |
| Uso | Os campos de token estão presentes ou a ausência está documentada |
| Rastreabilidade | Um ID de requisição conecta o aplicativo, o gateway e o registro upstream |
| Erros | A aplicação consegue classificar falhas retentáveis e não retentáveis |
| Custo | Medido por resultado aceito, não por requisição bruta |
| Rollback | Voltar para a rota direta está documentado e testado |
Se o gateway falhar em qualquer linha obrigatória, mantenha o teste fora da produção até que a lacuna seja corrigida ou explicitamente aceita.
Suas Primeiras 100 Requisições ao Gateway: Um Laboratório para Iniciantes
Uma primeira requisição bem-sucedida prova a conectividade. Ela não prova que o gateway é seguro para produção. O próximo marco útil é um pequeno conjunto controlado de 100 requisições representativas que testa compatibilidade, rastreabilidade, tratamento de falhas e disciplina operacional.
Este laboratório é intencionalmente simples. Ele não exige roteamento dinâmico, uma plataforma de avaliação complexa nem uma grande migração de produção. Ele fornece a um iniciante evidências suficientes para decidir se deve prosseguir, corrigir uma lacuna específica ou retornar ao caminho direto do provedor.
Comece com um envelope de requisição
Antes de enviar tráfego, defina os metadados que acompanham cada requisição ou aparecem no registro correspondente do gateway. Um envelope de requisição mínimo pode ser assim:
{
  "request_id": "gw_test_0001",
  "environment": "staging",
  "workload": "support_ticket_classification",
  "requested_route": "ticket-classifier-v1",
  "customer_tier": "internal-test",
  "contains_sensitive_data": false,
  "timeout_ms": 12000,
  "max_attempts": 2,
  "evaluation_case_id": "ticket_014"
}
Seu gateway pode usar cabeçalhos, tags, campos de metadados ou contexto do lado do servidor em vez deste JSON exato. A parte importante é que a aplicação, o gateway e o registro de avaliação compartilhem uma identidade estável da requisição.
Não coloque segredos brutos, prompts completos, dados pessoais ou texto confidencial de clientes em tags de roteamento. Mantenha os metadados operacionais separados do conteúdo. Se a carga de trabalho contiver dados sensíveis, registre a classificação e aplique a política de logging apropriada em vez de copiar o conteúdo para campos de observabilidade.
Lote 1: 40 requisições normais
Use 40 entradas representativas que devem ter sucesso na rota principal. Inclua casos fáceis, típicos e de fronteira, em vez de repetir um único prompt de demonstração.
Para cada requisição, registre:
- se a saída passou na validação específica da tarefa;
- IDs de requisição do gateway e do upstream;
- alias solicitado e provedor/modelo resolvido;
- latência total e tempo até o primeiro token, se aplicável;
- tokens de entrada e saída, quando disponíveis;
- contagem de tentativas ou fallback;
- custo estimado;
- a decisão final: aceita, rejeitada ou revisão manual.
O objetivo não é uma pontuação perfeita. O objetivo é descobrir se as falhas são visíveis e explicáveis. Uma saída rejeitada com um rastreamento completo é mais útil do que uma saída plausível sem registro de rota ou de uso.
Lote 2: 30 requisições de borda de contrato
Use as próximas 30 requisições para exercitar os recursos exatos dos quais sua aplicação depende. Escolha entre:
- contexto longo próximo ao seu limite aprovado de entrada;
- saída JSON estrita ou limitada por schema;
- início de streaming, cancelamento e conclusão;
- chamadas de ferramenta com argumentos válidos e inválidos;
- entradas de imagem, áudio ou documento, se a carga de trabalho as usar;
- prompts multilíngues;
- requisições vazias, malformadas ou superdimensionadas;
- conteúdo que deve ser rejeitado pela política da aplicação.
Não assuma que um endpoint compatível com OpenAI torna todo comportamento de borda idêntico. O gateway só aprova este lote quando sua aplicação consegue consumir a resposta corretamente e classificar comportamento não suportado sem corromper silenciosamente o fluxo de trabalho.
Lote 3: 30 requisições de falha controlada
Use um ambiente de não produção para testar o comportamento de falha delimitada. Inclua casos seguros, como:
- um nome de modelo ou rota inválido;
- uma credencial de desenvolvimento ausente ou revogada;
- um tempo limite intencionalmente curto;
- uma condição de cota ou limite de taxa de desenvolvimento;
- um erro upstream simuladamente passível de nova tentativa;
- um candidato de fallback que seja deliberadamente incompatível com o contrato da tarefa.
Esse último caso importa. Um gateway não deve redirecionar apenas porque outro modelo está disponível. Se a rota alternativa não puder preservar saída estruturada, comportamento de ferramentas, política de dados ou requisitos de qualidade, a ação correta é interromper e retornar um erro classificado.
Para uma política de falhas mais aprofundada, use o playbook de fluxo de trabalho da estratégia de fallback de modelo e o guia de limites de taxa de LLM.
Mantenha um livro-razão de aceitação com uma linha por requisição
Você pode começar com uma planilha ou uma tabela de banco de dados. Evite um painel que oculte os casos subjacentes antes que você os compreenda.
| Campo | O que ele informa |
|---|---|
| ID da requisição | Conecta evidências da aplicação, do gateway e do upstream |
| Caso de avaliação | Mostra qual entrada e comportamento esperado foram testados |
| Rota solicitada | Registra o que a aplicação pediu |
| Rota resolvida | Revela o provedor e o modelo que de fato atenderam a solicitação |
| Resultado da validação | Separa conclusões úteis de sucesso no nível HTTP |
| Classe de erro | Distingue casos de interrupção, nova tentativa, redirecionamento e reconciliação |
| Tentativas | Expõe a amplificação oculta de novas tentativas |
| Latência | Confirma que a carga de trabalho permanece dentro do orçamento voltado ao usuário |
| Custo estimado | Suporta a comparação por resultado aceito |
| Rollback necessário | Identifica casos que bloqueariam a expansão para produção |
Calcule pelo menos quatro métricas de resumo após as 100 requisições:
taxa de conclusão aceita = resultados aceitos / total de requisições

cobertura de rastreabilidade = requisições com IDs completos de rota e requisição / total de requisições

amplificação de novas tentativas = total de tentativas upstream / total de requisições do gateway

custo por resultado aceito = custo estimado total / resultados aceitos
Não compare gateways apenas pelo preço bruto da requisição. Uma requisição barata que falha na validação, aciona tentativas repetidas ou exige reparo manual pode ser mais cara do que uma requisição com preço mais alto que conclui a tarefa corretamente.
Use critérios explícitos de saída para produção
Antes de o laboratório começar, marque cada critério como obrigatório, opcional ou não aplicável. Em seguida, decida com base em evidências, e não em entusiasmo.
| Critério de saída | Exemplo de regra para iniciantes |
|---|---|
| Compatibilidade contratual | Cada campo de resposta e recurso obrigatórios passa |
| Aceitação da conclusão | Sem regressão material em relação à linha de base do provedor direto |
| Rastreabilidade | Cada requisição tem um ID de requisição da aplicação e do gateway |
| Visibilidade da rota | O provedor/modelo resolvido está disponível para cada requisição concluída |
| Classificação de falhas | Falhas esperadas se mapeiam para parar, tentar novamente, redirecionar ou reconciliar |
| Orçamento de retry | Nenhuma requisição excede o orçamento declarado de tentativas ou de latência |
| Registro de dados sensíveis | Conteúdo bruto fica desativado, a menos que seja aprovado e governado separadamente |
| Visibilidade de custos | O custo por resultado aceito pode ser calculado |
| Rollback | A rota direta pode ser restaurada sem reescrita de código |
Use um de três resultados:
- Avançar: todos os critérios obrigatórios passam; mova uma carga de trabalho de baixo risco para um pequeno canário.
- Corrigir: o gateway é viável, mas uma lacuna nomeada de compatibilidade, telemetria, segurança ou política de falha bloqueia a produção.
- Parar: a camada adiciona risco ou trabalho operacional sem resolver um problema atual e mensurável.
O laboratório só está concluído quando alguém assume a decisão, as evidências são salvas e o caminho de rollback permanece disponível. Isso transforma “nos conectamos a um gateway de LLM” em um resultado de engenharia repetível.
As Sete Funções Principais de um LLM Gateway
1. Abstração de provedor
O gateway cria uma fronteira estável entre o código da aplicação e as APIs do provedor. Isso reduz integrações repetidas e facilita testar migrações.
2. Autenticação e gerenciamento de chaves
As aplicações se autenticam no gateway, enquanto as credenciais do provedor permanecem atrás dele. Isso pode reduzir o número de segredos upstream distribuídos entre repositórios e ambientes de implantação. Isso não remove a necessidade de rotação, escopo, mascaramento e resposta a incidentes. Siga um guia dedicado de gerenciamento seguro de chaves de API.
3. Roteamento de modelo
O roteamento pode ser tão simples quanto “enviar este alias para este modelo”. Políticas mais avançadas podem usar capacidade, saúde, latência, região ou custo. Mantenha a decisão explicável: cada requisição deve registrar por que uma rota foi escolhida.
4. Controles de confiabilidade
O gateway pode centralizar timeouts, orçamentos de retry, circuit breakers, verificações de saúde e alternativas seguras. A centralização evita que cada equipe de aplicação invente uma política de falha diferente.
5. Coordenação de rate limit
Os provedores comumente restringem requisições e tokens ao longo do tempo. Um gateway pode coordenar concorrência, filas, backoff e capacidade de rota em vez de permitir que vários serviços compitam às cegas pelo mesmo quota upstream.
6. Observabilidade e alocação de custos
O gateway vê cada requisição, então é um lugar natural para anexar telemetria consistente. Meça mais do que o custo bruto por token. Acompanhe a taxa de tarefas aceitas, a latência, as tentativas de nova execução e o custo por tarefa aceita, para que uma rota barata, mas pouco confiável, não pareça eficiente.
O guia de otimização de custos de API de IA explica como comparar rotas usando os resultados da carga de trabalho, e não apenas o preço de tabela.
7. Política e governança
As equipes podem usar um gateway para restringir modelos, definir orçamentos, limitar o uso de tokens, separar chaves de desenvolvimento e produção e criar registros de uso prontos para auditoria. Esses controles tornam-se cada vez mais úteis à medida que mais aplicativos e agentes compartilham a mesma camada de acesso ao modelo.
LLM Gateway vs. Ferramentas Semelhantes
Iniciantes frequentemente usam “gateway”, “roteador”, “framework de orquestração” e “proxy reverso” como se fossem intercambiáveis. Eles se sobrepõem, mas não são a mesma coisa.
| Ferramenta | Função principal | O que ela normalmente não cobre |
|---|---|---|
| LLM gateway | Acesso, política, roteamento, confiabilidade e telemetria em chamadas de modelo | Todo o fluxo de trabalho do aplicativo |
| Roteador de modelo | Selecionar um modelo ou rota upstream | Autenticação, cobrança, governança ou observabilidade completa, a menos que estejam incluídas no pacote |
| Framework de orquestração | Coordenar prompts, ferramentas, memória, agentes e fluxos de trabalho em várias etapas | Controle de conta do provedor central e de cobrança por padrão |
| Proxy reverso | Encaminhar tráfego de rede, encerrar TLS e aplicar controles HTTP genéricos | Limites de tokens cientes do modelo, contratos de fallback ou contabilização de uso de IA por padrão |
| SDK do provedor | Chamar a API de um provedor com recursos nativos do provedor | Roteamento entre provedores e controles unificados |
Você pode combinar essas camadas. Um framework de agente pode chamar um LLM gateway. O gateway pode usar um roteador internamente. Um proxy reverso pode ficar na frente do gateway para controles de rede.
Quando Você Precisa de um LLM Gateway?
Use este guia para iniciantes de LLM Gateway como um teste de decisão. Um gateway vale a pena avaliar quando duas ou mais destas afirmações forem verdadeiras:
- Você dá suporte a mais de um provedor de modelo.
- Vários serviços ou agentes precisam de acesso ao modelo.
- As chaves do provedor são duplicadas entre ambientes.
- As equipes não conseguem responder qual aplicativo gerou uma cobrança.
- O tratamento de limite de taxa difere entre codebases.
- Uma indisponibilidade do provedor ou uma rota degradada interrompe um fluxo de trabalho crítico.
- Você precisa de allowlists de modelos, cotas ou orçamentos no nível do ambiente.
- Trocar modelos exige mudanças repetidas no SDK ou no deploy.
- A operação precisa de um único ID de requisição em toda a camada do aplicativo e do provedor.
Você talvez ainda não precise de um gateway quando tiver um único protótipo de baixo risco, um único provedor, um único responsável e nenhuma exigência de confiabilidade ou governança em produção. Comece com acesso direto, mas mantenha as chamadas ao provedor atrás de um pequeno adaptador de aplicativo para que uma futura migração seja controlada.
Construir vs. Comprar um LLM Gateway: Um Scorecard Prático
A pergunta mais importante para a avaliação de negócios não é se um gateway é útil. É quais partes a sua equipe deve assumir. Você pode construir um gateway, adotar um serviço hospedado, executar um proxy de código aberto ou combinar essas abordagens.
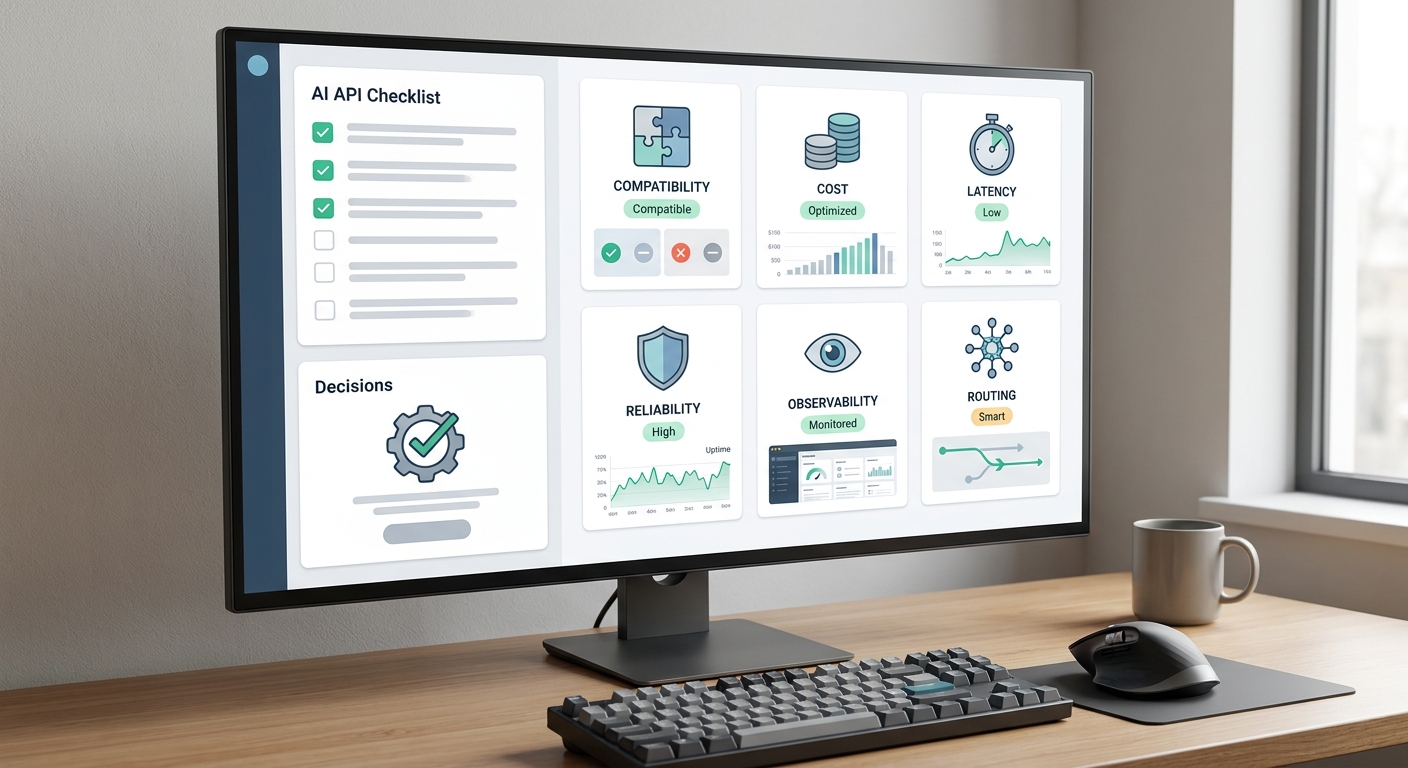
Use um scorecard ponderado em vez de escolher a partir de uma lista de funcionalidades. Dê uma nota de 1 a 5 para cada opção, multiplique pelo peso e compare os totais. Os pesos abaixo são pontos de partida, não regras universais.
| Critério | Peso sugerido | Perguntas a fazer |
|---|---|---|
| Compatibilidade com a carga de trabalho | 25% | Ele preserva streaming, saída estruturada, ferramentas, imagens, detalhes de erro e contabilização de tokens? |
| Confiabilidade | 20% | Timeouts, tentativas, verificações de integridade, regras de fallback e visibilidade de incidentes estão explícitos? |
| Segurança e governança | 15% | Você pode isolar tenants, restringir modelos, rotacionar credenciais, redigir conteúdo e auditar acessos? |
| Observabilidade | 15% | Você consegue rastrear a rota solicitada, a rota resolvida, as tentativas, a latência, o uso, a validação e o custo? |
| Esforço operacional | 10% | Quem lida com upgrades, mudanças de provedor, escalabilidade, resposta de plantão e retenção de dados? |
| Adequação comercial | 10% | A cobrança é compreensível, exportável, atribuível e compatível com o padrão de uso esperado? |
| Caminho de saída | 5% | Você pode exportar configuração e telemetria, preservar contratos da aplicação e trocar sem reescrever? |
Construa quando o controle for o produto
Construir pode ser racional quando o comportamento de roteamento é uma vantagem competitiva central, as regulamentações exigem um modelo de implantação que os serviços disponíveis não conseguem atender, ou a escala do seu tráfego justifica uma equipe dedicada de plataforma. Mas “construir” inclui mais do que encaminhar requisições HTTP. Significa assumir autenticação, adaptadores de provedor, diferenças de esquema, streaming, normalização de erros, cotas, observabilidade, gestão de releases, revisões de segurança e resposta a incidentes.
Compre quando acesso e operações não forem diferenciados
Um gateway hospedado geralmente é uma opção melhor quando o objetivo é acessar vários provedores mais rapidamente, consolidar faturamento e credenciais ou oferecer a várias aplicações um plano de controle compartilhado. A avaliação ainda deve incluir um caminho de saída. Mantenha o gateway atrás de um adaptador de aplicação, preserve testes de capacidade do modelo e evite incorporar suposições específicas de provedor em todo o código do produto.
Use código aberto quando você puder operá-lo
Um gateway ou proxy de código aberto pode oferecer flexibilidade e visibilidade do código, mas a auto-hospedagem transfere disponibilidade, escalabilidade, upgrades, armazenamento de telemetria e correção de segurança para a sua equipe. Compare a obrigação operacional total, não apenas a licença do software.
A Implantação do LLM Gateway em Quatro Etapas
Uma implantação segura comprova uma camada por vez. Não comece com roteamento dinâmico de custos em todas as cargas de trabalho.
Etapa 1: teste sombra de compatibilidade
Envie um conjunto de avaliação representativo pelo gateway candidato sem alterar o comportamento de produção. Verifique campos da requisição, respostas, streaming, chamadas de ferramentas, saídas estruturadas, campos de uso e erros. Registre cada incompatibilidade. Uma resposta HTTP bem-sucedida não é suficiente se o contrato da aplicação mudar.
Critério de saída: o gateway atende aos recursos exigidos e às verificações de qualidade da carga de trabalho, sem perda de contrato sem explicação.
Stage 2: Uma carga de trabalho de baixo risco
Migre uma carga de trabalho reversível e não crítica para uma rota explícita de modelo. Mantenha o caminho anterior direto ao provedor disponível como reversão. Adicione IDs de requisição e telemetria de rota resolvida antes de adicionar retries ou fallback.
Critério de saída: a equipe consegue explicar cada requisição com falha, reconciliar o uso e reverter sem uma liberação de código.
Stage 3: Política de confiabilidade
Adicione um timeout limitado, classificação de retries e um fallback testado para um modo de falha que você realmente tenha observado. Não faça fallback entre modelos apenas porque ambos aceitam JSON semelhante. A rota alternativa deve satisfazer o mesmo contrato da carga de trabalho.
Para um design de recuperação mais profundo, use o playbook de estratégia de fallback de modelo e o guia de limites de taxa de LLM.
Critério de saída: exercícios de falha mostram que retries e fallback melhoram a conclusão aceita sem causar efeitos colaterais duplicados, latência descontrolada ou gasto não controlado.
Stage 4: Plano de controle de produção compartilhado
Expanda somente depois que a primeira carga de trabalho tiver medições estáveis. Adicione quotas de tenant, allowlists de modelos, separação de ambientes, alertas de orçamento e um processo documentado para alterar rotas. Revise quem pode modificar a política e como as alterações são auditadas.
Critério de saída: vários aplicativos podem usar o gateway sem perder a atribuição de custos, a rastreabilidade de incidentes, as fronteiras de segurança ou o controle de reversão.
Mapa de Erros para Iniciantes: Retry, Reencaminhar ou Parar?
A confiabilidade do gateway depende menos do número de modelos de fallback do que de tomar a decisão correta para cada falha. Use este mapa simplificado como ponto de partida.
| Falha | Significado típico | Ação para iniciantes |
|---|---|---|
| 400 ou erro de validação | O contrato da requisição é inválido ou não compatível | Pare, corrija a requisição e não tente novamente sem alterações |
| 401 ou 403 | Problema de credencial, permissão, allowlist do modelo ou conta | Pare e alerte; nunca faça rodízio entre chaves aleatórias |
| 404 model ou route | O identificador configurado está indisponível ou incorreto | Pare ou use uma rota equivalente explicitamente aprovada |
| 408 ou timeout do cliente | O orçamento de latência do chamador expirou | Cancele se possível; tente novamente apenas quando a tarefa for idempotente |
| 429 limite de taxa | A capacidade ou a cota foi excedida | Respeite a orientação de retry, enfileire ou use uma rota equivalente testada |
| 5xx antes da saída | O gateway ou o upstream falhou antes de uma resposta utilizável | Use retry limitado ou failover testado |
| Stream quebra no meio da saída | Conteúdo parcial pode já existir | Pare e faça a reconciliação; não repita cegamente efeitos colaterais |
| A chamada de ferramenta pode ter sido executada | O estado externo pode ter mudado | Verifique a chave de idempotência ou o estado da ferramenta antes de tentar novamente |
A palavra limitado importa. Cada fluxo de trabalho precisa de um número máximo de tentativas, um orçamento total de tempo e um estado terminal. Caso contrário, um gateway pode transformar um único incidente do provedor em ações duplicadas de ferramentas, custo descontrolado e uma indisponibilidade maior.
Para uma implementação mais profunda, use o playbook de estratégia de fallback de modelo.
Como Medir se o Gateway Está Funcionando
O sucesso do gateway não é o número de provedores conectados. É a melhora nos resultados aceitos e no controle operacional.
| Métrica | O que ela revela | Cálculo amigável para iniciantes |
|---|---|---|
| Taxa de conclusão aceita | Se os usuários recebem resultados utilizáveis | resultados aceitos ÷ inícios do fluxo de trabalho |
| Taxa de falha atribuível ao gateway | Se a nova camada cria falhas | falhas do gateway ÷ requisições ao gateway |
| Latência p95 de ponta a ponta | Se a política e o failover prejudicam a experiência do usuário | 95º percentil do início do aplicativo até o resultado aceito |
| Taxa de recuperação por fallback | Se o fallback resolve falhas reais | resultados aceitos via fallback ÷ tentativas de fallback |
| Custo por resultado aceito | Se chamadas mais baratas produzem resultados mais baratos | custo total de modelo e retry ÷ resultados aceitos |
| Explicabilidade da rota | Se incidentes e faturas podem ser rastreados | requisições com campos de rota solicitada e resolvida ÷ total de requisições |
| Precisão da rejeição de políticas | Se a governança bloqueia o tráfego pretendido | requisições rejeitadas corretamente ÷ rejeições revisadas |
Defina uma linha de base antes da migração. Depois compare a mesma carga de trabalho, conjunto de avaliação, segmento de tráfego e janela de tempo. Se a qualidade cair, a latência aumentar ou os custos ficarem mais difíceis de reconciliar, um preço nominal de token mais baixo não é um resultado bem-sucedido do gateway.
Para análise de custos, continue com o guia de otimização de custos de API de IA. Para um plano de telemetria mais completo, use a lista de verificação de implementação de observabilidade de IA.
Uma implementação para iniciantes: cinco passos práticos
Passo 1: Escreva o contrato da tarefa
Escolha uma carga de trabalho real, como resumir tickets de suporte ou extrair campos de faturas. Defina:
- entradas e saídas necessárias;
- latência aceitável;
- regras de validação;
- se streaming é necessário;
- se as ferramentas podem criar efeitos colaterais;
- o que conta como um resultado aceito.
Esse contrato determina se um fallback é seguro e se outro modelo é realmente equivalente.
Passo 2: Escolha uma interface de cliente estável
Se sua aplicação já usa um SDK compatível com OpenAI, um gateway compatível pode reduzir o trabalho de migração. A Flatkey, por exemplo, documenta uma URL base compatível com OpenAI em https://router.flatkey.ai/v1.
curl -X POST "https://router.flatkey.ai/v1/chat/completions" \
  -H "Authorization: Bearer $FLATKEY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "your-model",
    "messages": [
      {"role": "user", "content": "Explain this error in plain English."}
    ]
  }'
Use um gerenciador de segredos ou uma variável de ambiente no lado do servidor para a chave. Nunca a inclua no código do navegador ou do cliente mobile.
Passo 3: Comece com roteamento explícito
Roteie a carga de trabalho para um modelo testado. Se você quiser independência da aplicação, mapeie um alias interno para esse modelo na configuração. Evite um roteador opaco de “modelo mais barato” ou “melhor modelo” até ter um conjunto de avaliação repetível.
Passo 4: Adicione a telemetria mínima viável
Registre:
- ID da requisição do gateway;
- carga de trabalho e ambiente;
- alias solicitado;
- provedor e modelo resolvidos;
- status e latência;
- contagem de tentativas e fallbacks;
- tokens de entrada e saída;
- custo estimado;
- resultado da validação.
Isso é suficiente para depurar os primeiros problemas em produção e comparar alternativas depois.
Passo 5: Adicione uma política de falha limitada
Comece com um timeout e um pequeno orçamento de retries para falhas transitórias. Adicione fallback somente depois de verificar se a rota alternativa passa pelo mesmo contrato da tarefa. Para streaming ou chamadas de ferramentas com efeitos colaterais, defina como a aplicação detecta a conclusão parcial e reconcilia o estado.
Sua primeira semana com um LLM Gateway
Use um plano de adoção de sete dias em vez de migrar todas as aplicações de uma vez.
Dia 1: Faça o inventário de uma carga de trabalho
Anote o provedor atual, modelo, SDK, credenciais, recursos necessários, tráfego, orçamento de latência, sensibilidade dos dados e responsável pelo rollback.
Dia 2: Execute o teste de compatibilidade
Envie prompts representativos pelo caminho direto e pelo caminho do gateway. Inclua entradas longas, saída estruturada, streaming, ferramentas e casos de erro esperados, se a carga de trabalho os usar.
Dia 3: Adicione identidade da requisição e registros de uso
Confirme que a aplicação armazena um ID de requisição do gateway e consegue associá-lo ao modelo, à rota do provedor, à latência, aos tokens, à contagem de tentativas e ao resultado da validação, sem registrar conteúdo sensível por padrão.
Dia 4: Defina a política de falhas
Classifique os erros em parada, nova tentativa, failover equivalente, fallback entre modelos e reconciliação manual. Defina um orçamento total de tentativas e de latência.
Dia 5: Envie um pequeno canário em produção
Use uma carga de trabalho de baixo risco e uma fatia de tráfego deliberadamente pequena. Mantenha o caminho direto disponível. Compare a taxa de conclusão aceita, a latência p95 e o custo por resultado aceito.
Dia 6: Revise os controles de segurança e de gastos
Separe as credenciais de desenvolvimento e produção, restrinja os modelos permitidos, defina cotas e verifique quem pode visualizar ou alterar a política de roteamento. Use o guia de gerenciamento seguro de chaves de API para uma lista de controle mais completa.
Dia 7: Tome uma decisão de avançar, corrigir ou parar
- Avançar: as verificações obrigatórias do contrato passam e o canário atende aos limites de aceitação.
- Corrigir: a arquitetura é sólida, mas uma lacuna mensurável bloqueia a expansão.
- Parar: o gateway adiciona risco operacional ou custo sem um benefício de controle atual.
Documente a decisão e a próxima data de revisão. Uma parada controlada é melhor do que uma migração não medida.
Erros Comuns de Iniciantes
Tratar todos os modelos como intercambiáveis
Mesmo quando a sintaxe da requisição é padronizada, as capacidades e o comportamento de saída diferem. Teste os recursos exatos que sua carga de trabalho usa.
Roteamento antes de medir
Roteamento dinâmico sem dados de avaliação transfere a lógica de decisão para uma caixa-preta. Estabeleça primeiro uma linha de base e depois introduza uma política mensurável.
Tentar novamente cada erro
Erros de autenticação, requisições inválidas, orçamentos esgotados e recursos não suportados não são transitórios. Refaça a tentativa apenas para erros que possam ter sucesso mais tarde e use backoff exponencial com jitter quando apropriado.
Registrar conteúdo sensível por padrão
Prompts podem conter dados de clientes, código-fonte ou dados de negócios. Mantenha a observabilidade de metadados separada da retenção de conteúdo.
Ocultar a rota resolvida
Se a aplicação solicitar um alias, registre o provedor e o modelo reais usados. Caso contrário, incidentes, regressões de qualidade e mudanças de custo ficam difíceis de explicar.
Medir preço em vez de resultados
Preços menores por token não garantem menor custo da carga de trabalho. Inclua falhas de validação e novas tentativas no seu cálculo de custo.
Como a Flatkey se Encaixa no Padrão de Gateway
A Flatkey fornece uma camada unificada de acesso a modelos e ferramentas com uma única chave, registros de uso compartilhados e um endpoint de modelo compatível com OpenAI. Para um cliente compatível existente, o caminho de migração é alterar a URL base, usar uma chave Flatkey, escolher um modelo suportado e testar o contrato da carga de trabalho.
Isso torna a Flatkey relevante quando você quer reduzir a proliferação de contas de provedores sem construir e operar você mesmo a camada de agregação. Se você está avaliando o design em vez de procurar uma visão geral para iniciantes, leia o guia detalhado de arquitetura de gateway de API de IA. Se você está pronto para migrar um cliente, use o checklist de gateway de API compatível com OpenAI.
Explore os modelos da Flatkey, consulte a documentação ou crie uma chave de API quando estiver pronto para testar uma carga de trabalho real.
Checklist do Guia para Iniciantes de LLM Gateway
Antes de enviar tráfego de produção por meio de um gateway de LLM, confirme:
- [ ] Um contrato de carga de trabalho definiu critérios de sucesso.
- [ ] A aplicação usa uma credencial de gateway no lado do servidor.
- [ ] O modelo selecionado passou em testes representativos.
- [ ] Saída estruturada, ferramentas e streaming foram testados, se usados.
- [ ] Timeouts e erros passíveis de repetição foram definidos explicitamente.
- [ ] O fallback preserva o contrato da carga de trabalho.
- [ ] Cada requisição recebe um ID de requisição rastreável.
- [ ] O provedor e o modelo resolvidos são registrados.
- [ ] Tokens, latência, tentativas, validação e custo são medidos.
- [ ] As cotas de desenvolvimento e produção são separadas.
- [ ] O registro de conteúdo bruto está desativado ou deliberadamente governado.
- [ ] Um caminho direto de rollback está documentado.
- [ ] Existe uma linha de base para conclusão aceita, latência e custo por resultado aceito.
- [ ] As opções build, hospedada e self-hosted foram comparadas quanto à carga operacional e ao caminho de saída.
- [ ] O primeiro rollout usa uma rota explícita antes que o roteamento dinâmico seja introduzido.
Perguntas Frequentes
Um gateway de LLM é o mesmo que um gateway de API?
É um gateway de API especializado para tráfego de modelos de IA. Ele pode fornecer funções padrão de gateway de API, como autenticação e limitação de taxa, além de roteamento com consciência do modelo, uso de tokens, normalização de erros específica de IA e fallback consciente do contrato.
Um gateway de LLM hospeda os modelos?
Não necessariamente. Alguns gateways roteiam para provedores externos, outros são integrados à infraestrutura de inferência e alguns suportam ambos. Pergunte onde a inferência ocorre, qual provedor realmente atende cada modelo e como esse caminho aparece nos registros de uso.
Um gateway de LLM reduz custos?
Ele pode ajudar centralizando dados de uso, aplicando cotas, reduzindo integrações duplicadas e permitindo mudanças de rota medidas. A economia não é automática. Compare o custo por tarefa aceita, incluindo tentativas e falhas de गुणवत्ता.
Posso usar um gateway de LLM com o SDK da OpenAI?
Sim, se o gateway expõe um endpoint compatível com a OpenAI e oferece suporte aos recursos usados pela sua aplicação. Altere a URL base e a credencial e, em seguida, teste o contrato completo da carga de trabalho em vez de presumir compatibilidade perfeita.
Um gateway é um único ponto de falha?
Pode ser. Avalie sua arquitetura de implantação, verificações de integridade, failover upstream, comportamento de timeout, observabilidade, compromissos de serviço e caminho de rollback. Centralizar o controle aumenta a alavancagem operacional, então o próprio gateway deve ser tratado como infraestrutura de produção.
Uma startup deve construir ou comprar um gateway de LLM?
Construa quando o comportamento do gateway for um diferencial central, você precisar de restrições de implantação incomuns ou tiver uma equipe para operá-lo. Compre quando o objetivo principal for acesso mais rápido, menos integrações com provedores, uso unificado e controles compartilhados. Uma equipe pequena também pode começar diretamente e migrar depois, se as chamadas aos provedores já estiverem isoladas atrás de um adaptador.
O que devo testar antes de mover o tráfego de produção?
Teste o contrato exato da carga de trabalho: streaming, saída estruturada, ferramentas, entradas de mídia, limites de contexto, comportamento de erro, tratamento de timeout, campos de uso e qualidade da saída. Depois, execute um canário de baixo risco com um caminho direto de rollback e compare a conclusão aceita, a latência p95 e o custo por resultado aceito com a linha de base pré-gateway.
O Modelo Mental Simples
A versão mais curta deste guia para iniciantes de LLM Gateway é:
Sua aplicação solicita trabalho de IA. O gateway decide se a solicitação é permitida, para onde ela deve ir, como a falha deve ser tratada e o que deve ser registrado.
Comece com uma carga de trabalho, uma interface estável, roteamento explícito, telemetria mínima viável e uma política de falha bem delimitada. Adicione roteamento sofisticado somente depois de conseguir medir qualidade, latência, confiabilidade e custo.