Guide débutant de LLM Gateway : de la première requête à la production
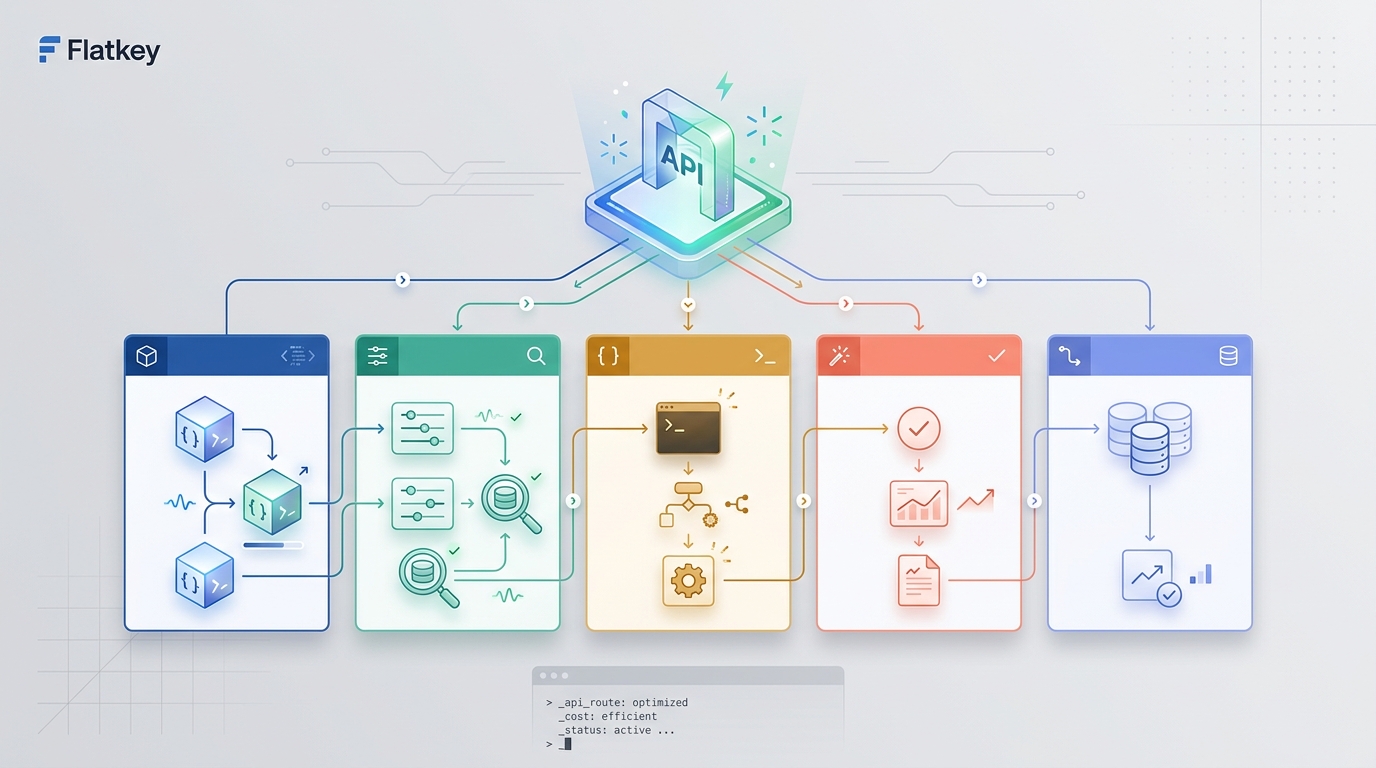
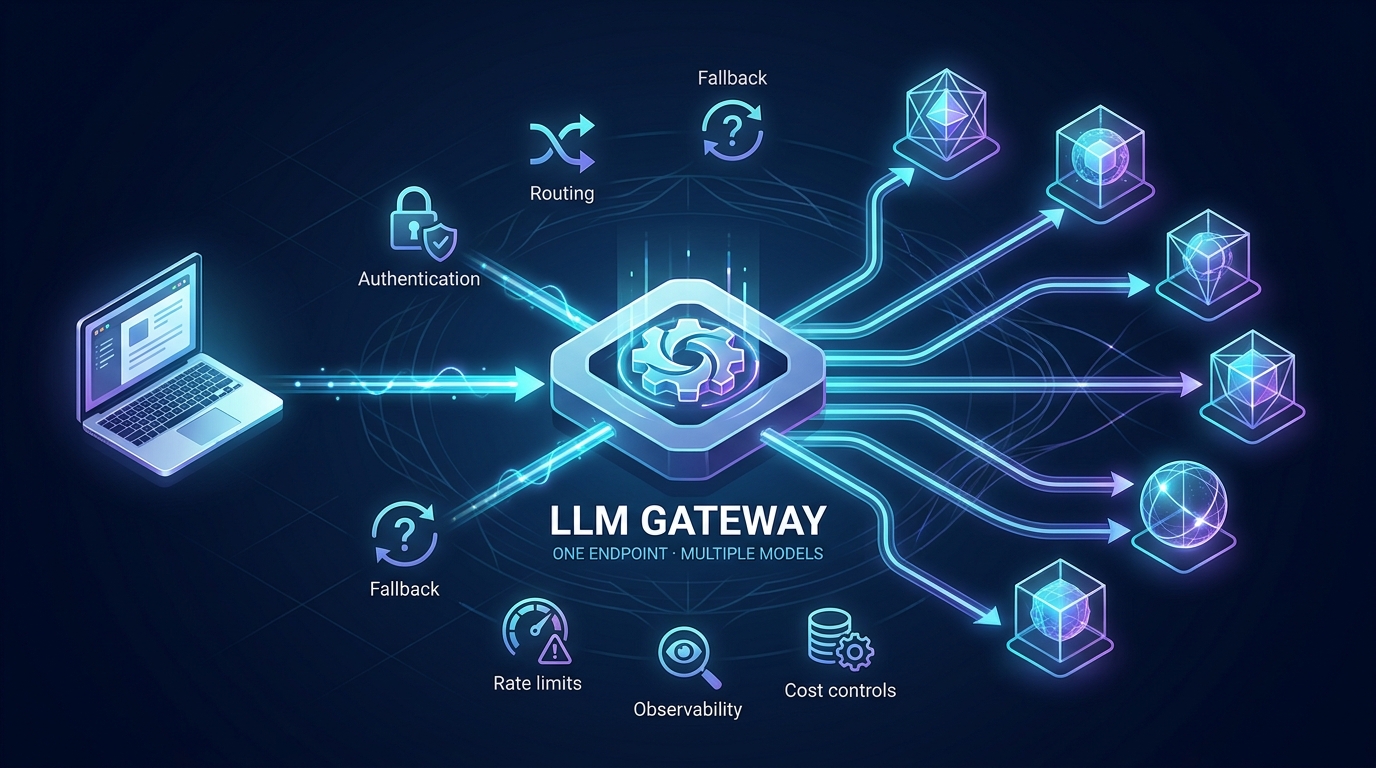
Une passerelle LLM est une couche de contrôle entre votre application et un ou plusieurs fournisseurs de modèles d’IA. Votre application envoie ses requêtes à la passerelle au lieu de se connecter séparément à chaque fournisseur. La passerelle authentifie ensuite la requête, applique la politique, choisit un modèle ou une connexion en amont, transfère l’appel et enregistre le résultat.
Cela ressemble à de la plomberie API ordinaire, mais cela résout un problème qui apparaît rapidement dans les produits d’IA réels : la première intégration de modèle est simple ; la cinquième ne l’est pas. Chaque fournisseur peut introduire une nouvelle clé, un SDK, un format de requête, une politique de limitation de débit, une forme d’erreur, une page d’utilisation et une facture.
Ce guide débutant de LLM Gateway explique ce que fait cette couche, comment une requête y transite, en quoi elle diffère des outils adjacents, quand vous en avez besoin et comment mettre en œuvre une première intégration de passerelle sans la surconcevoir. Il vous donne aussi une grille de décision construire vs acheter, un plan de déploiement progressif et des critères d’acceptation mesurables pour déterminer si une passerelle crée une vraie valeur métier.
Mise à jour du 4 août 2026 : Ce guide inclut désormais un laboratoire des 100 premières requêtes avec une enveloppe de requête, trois lots de test, un registre d’acceptation et des critères de sortie vers la production, en plus du démarrage rapide en 15 minutes et de la checklist de déploiement.
La décision du débutant en 60 secondes
Vous n’avez probablement pas encore besoin d’une passerelle LLM si une seule application appelle un seul fournisseur, si la charge de travail est encore expérimentale et si une courte interruption ou une rotation manuelle des clés n’aurait pas d’impact sur les clients.
Vous devriez évaluer une passerelle lorsque deux ou plusieurs de ces affirmations sont vraies :
- votre application utilise, ou prévoit d’utiliser, plus d’un fournisseur de modèles ;
- plusieurs services ont besoin d’identifiants IA et de contrôles d’utilisation ;
- les limites de débit ou les incidents chez le fournisseur peuvent interrompre le parcours d’un client ;
- la finance ne peut pas rapprocher les dépenses de modèles d’une équipe, d’un produit ou d’un client ;
- changer de modèles nécessite un déploiement de l’application ;
- vous avez besoin d’une liste d’autorisation partagée, d’un quota, d’une piste d’audit ou d’une politique de secours ;
- les développeurs recréent les mêmes adaptateurs de fournisseur dans plusieurs dépôts.
L’erreur du débutant consiste à adopter une passerelle parce que le diagramme d’architecture a l’air mature. Adoptez-la lorsqu’elle supprime des tâches opérationnelles répétées ou crée un contrôle que vous pouvez mesurer.
Qu’est-ce qu’une passerelle LLM ?
Une passerelle LLM, aussi appelée passerelle API LLM ou passerelle IA, offre aux applications une interface stable pour accéder aux modèles d’IA. Dans sa forme la plus simple, elle fournit :
- un point de terminaison pour les requêtes de modèle ;
- une frontière d’authentification unique ;
- un contrat de requête et de réponse cohérent ;
- des journaux d’utilisation centralisés ;
- des règles de routage qui décident où va une requête.
Une passerelle plus avancée peut également appliquer des budgets, restreindre les modèles autorisés, gérer des nouvelles tentatives limitées, assurer un basculement entre des routes équivalentes, associer des identifiants de requête, normaliser les erreurs et émettre des télémétries de latence, de jetons et de coût.
L’idée importante dans ce guide débutant de LLM gateway est la séparation des responsabilités. Le code de votre produit doit décrire la tâche qu’il doit accomplir. La gateway doit gérer l’accès au fournisseur, la politique de routage et les contrôles opérationnels.
Application
    │
    │ une requête authentifiée
    ▼
LLM gateway
    ├── vérification de la politique et du quota
    ├── sélection du modèle ou de la route
    ├── requête au fournisseur
    ├── nouvelle tentative ou repli sécurisé
    └── enregistrement de l’utilisation et des erreurs
             │
             ├── Fournisseur A / Modèle 1
             ├── Fournisseur B / Modèle 2
             └── Fournisseur C / Modèle 3
Pourquoi ne pas appeler directement chaque fournisseur de modèle ?
L’intégration directe est souvent le bon point de départ. Si un prototype utilise un seul modèle, a un faible trafic et n’a pas besoin de contrôles partagés, l’ajout d’une gateway peut créer plus de complexité que de valeur.
Le compromis change lorsque l’application a besoin de plusieurs fournisseurs ou doit fonctionner de manière fiable en production.
| Préoccupation | Intégrations directes aux fournisseurs | LLM gateway |
|---|---|---|
| Identifiants | Clés séparées dans chaque environnement | Une seule clé ou identité côté application |
| Code client | Clients et adaptateurs spécifiques au fournisseur | Contrat client stable lorsque pris en charge |
| Changement de modèle | Modification de l’application ou configuration par fournisseur | Changement central de route ou de politique de modèle |
| Limites de débit | Gérées séparément pour chaque fournisseur | Limites, files d’attente et politique de nouvelle tentative coordonnés |
| Suivi de l’utilisation | Réparti entre les tableaux de bord des fournisseurs | Enregistrements centralisés des requêtes, des jetons, de la latence et des coûts |
| Basculement | Logique personnalisée dans chaque application | Politique de repli partagée et consciente du contrat |
| Gouvernance | Répétée dans chaque service | Listes d’autorisation de modèles, quotas et champs d’audit centralisés |
La gateway n’efface pas les différences entre fournisseurs. Les modèles peuvent toujours avoir des capacités, des limites de contexte, des schémas d’outils, des comportements de streaming, des politiques de sécurité et des tarifs différents. Une bonne gateway rend ces différences explicites et gérables au lieu de prétendre que chaque modèle est interchangeable.
Comment fonctionne une LLM gateway, étape par étape
1. L’application envoie une requête
L’application appelle une URL de base stable et fournit un identifiant d’accès de gateway. Avec une gateway compatible OpenAI, un client OpenAI existant peut n’avoir besoin que d’un base_url, d’une clé API et d’un identifiant de modèle différents.
2. La gateway l’authentifie et l’autorise
La gateway vérifie le projet, l’environnement, l’utilisateur ou la charge de travail appelants. Elle peut ensuite contrôler une liste d’autorisation, un quota, un budget ou une politique de jetons maximum avant toute dépense en amont.
3. Une règle de routage choisit la destination
La requête peut désigner un modèle précis. Elle peut utiliser un alias contrôlé par l’équipe, comme support-fast. Ou elle peut entrer dans une politique de routage qui prend en compte la capacité, l’état, la région, la latence ou le coût.
Pour une première implémentation, privilégiez une sélection explicite du modèle ou un alias simple. Le routage dynamique est utile, mais il doit venir après l’obtention de données d’évaluation et d’une observabilité suffisante.
4. La passerelle ne traduit que ce qu’elle peut préserver
Certaines passerelles exposent un contrat compatible avec OpenAI sur plusieurs fournisseurs. La passerelle mappe les champs vers l’API du fournisseur sélectionné et normalise la réponse lorsque c’est possible.
La compatibilité a ses limites. Avant de changer de modèle, testez la sortie structurée, l’appel d’outils, les images, le streaming, les raisons de fin, la comptabilisation des tokens et le comportement en cas d’erreur. « Compatible » doit signifier que votre contrat requis a passé les tests, et pas seulement que la requête a renvoyé HTTP 200.
5. La passerelle gère la politique opérationnelle
La passerelle peut appliquer un délai d’attente, respecter un budget de tentatives, mettre en pause une route défaillante ou choisir une solution de repli. Les nouvelles tentatives doivent être limitées. Les solutions de repli doivent préserver le contrat de la tâche. Les requêtes avec des effets de bord d’outils ou une sortie partiellement diffusée peuvent nécessiter un chemin d’arrêt et de réconciliation plutôt qu’une relecture automatique.
Pour une conception de production plus approfondie, utilisez le playbook de stratégie de repli de modèle et le guide des limites de débit LLM.
6. La passerelle enregistre ce qui s’est passé
Les enregistrements utiles comprennent un identifiant de requête, l’application, l’environnement, le modèle demandé, le fournisseur et le modèle résolus, la latence, le statut, le nombre de tentatives, les tokens d’entrée et de sortie, ainsi que le coût estimé.
Ne consignez pas par défaut les prompts et les réponses bruts. Journalisez les métadonnées qui soutiennent les opérations, et traitez la journalisation du contenu comme une décision distincte de sécurité et de confidentialité.
Un démarrage rapide LLM Gateway en 15 minutes
Le moyen le plus rapide de comprendre une passerelle consiste à faire passer une requête non critique par elle. Utilisez un script de test côté serveur, un modèle explicite et un prompt avec un résultat attendu évident. Ne commencez pas par un routage automatique ni par un agent de production.
Étape 1 : Enregistrer la référence du fournisseur direct
Avant de modifier quoi que ce soit, enregistrez cinq éléments issus de l’appel direct actuel :
- si la réponse satisfait la tâche ;
- la latence totale et le temps jusqu’au premier token en cas de streaming ;
- les comptes de tokens d’entrée et de sortie ;
- l’identifiant de requête du fournisseur et la forme de l’erreur ;
- le coût estimé pour le résultat accepté.
Cela vous donne quelque chose de concret à comparer. Une migration vers une passerelle ne réussit pas simplement parce qu’elle renvoie HTTP 200.
Étape 2 : Modifier la connexion, pas la charge de travail
Pour une passerelle compatible OpenAI, le changement côté application consiste généralement en une clé API de la passerelle, une URL de base de la passerelle et un identifiant de modèle pris en charge. Les noms exacts des variables d’environnement dépendent du client et de la passerelle.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["LLM_GATEWAY_API_KEY"],
    base_url=os.environ["LLM_GATEWAY_BASE_URL"],
)

response = client.chat.completions.create(
    model=os.environ["LLM_GATEWAY_MODEL"],
    messages=[
        {"role": "system", "content": "Return valid JSON only."},
        {"role": "user", "content": "Classify this ticket as billing, bug, or feature: I was charged twice."},
    ],
    temperature=0,
)

print(response.choices[0].message.content)
Conservez les identifiants de connexion côté serveur. Ne placez jamais une clé maître de gateway dans du JavaScript côté navigateur, un binaire mobile, un dépôt public ou une capture d’écran partagée.
Étape 3 : Comparez le contrat de réponse
Vérifiez plus que la qualité du texte. Confirmez les champs que votre application consomme réellement :
- ID de réponse et nom du modèle ;
- raison de fin ;
- utilisation des tokens ;
- ordre des événements de streaming ;
- comportement de la sortie structurée ;
- identifiants et arguments des appels d’outils ;
- statut HTTP et corps de l’erreur ;
- comportement d’annulation et de délai d’attente.
La compatibilité OpenAI réduit le travail de migration, mais elle ne garantit pas que chaque fonctionnalité du fournisseur se comporte de manière identique. Testez le contrat dont dépend votre code.
Étape 4 : Forcez un échec sécurisé
Utilisez un environnement de test pour déclencher un échec prévisible, comme un nom de modèle invalide, un délai d’attente volontairement minuscule ou un quota de développement. Vérifiez que la gateway renvoie un ID de requête traçable et une erreur que votre application peut classer.
Ne testez pas une panne de fournisseur en créant une charge de production incontrôlée. L’objectif est de prouver que votre application peut distinguer les échecs d’authentification, de limitation de débit, de délai d’attente, en amont et de validation.
Étape 5 : Décidez avec un tableau d’acceptation
| Vérification | Règle d’acceptation pour débutant |
|---|---|
| Résultat | Passe la même validation de tâche que l’appel direct |
| Latence | Dans le budget annoncé pour la charge de travail |
| Utilisation | Les champs de tokens sont présents ou leur absence est documentée |
| Traçabilité | Un seul ID de requête relie l’application, la gateway et l’enregistrement en amont |
| Erreurs | L’application peut classer les échecs récupérables et non récupérables |
| Coût | Mesuré par résultat accepté, et non par requête brute |
| Retour arrière | Le retour au chemin direct est documenté et testé |
Si la gateway échoue sur une ligne requise, laissez le test hors production jusqu’à ce que l’écart soit corrigé ou explicitement accepté.
Vos 100 premières requêtes Gateway : un laboratoire pour débutant
Une première requête réussie prouve la connectivité. Elle ne prouve pas que la gateway est sûre pour la production. L’étape utile suivante est un petit ensemble contrôlé de 100 requêtes représentatives qui teste la compatibilité, la traçabilité, la gestion des échecs et la discipline opérationnelle.
Ce laboratoire est volontairement simple. Il ne nécessite pas de routage dynamique, de plateforme d’évaluation complexe ni de migration massive en production. Il fournit à un débutant suffisamment d’éléments pour décider s’il faut continuer, corriger une lacune précise ou revenir à une connexion directe au fournisseur.
Commencez par une enveloppe de requête
Avant d’envoyer du trafic, définissez les métadonnées qui accompagnent chaque requête ou apparaissent dans l’enregistrement correspondant du gateway. Une enveloppe de requête minimale peut ressembler à ceci :
{
  "request_id": "gw_test_0001",
  "environment": "staging",
  "workload": "support_ticket_classification",
  "requested_route": "ticket-classifier-v1",
  "customer_tier": "internal-test",
  "contains_sensitive_data": false,
  "timeout_ms": 12000,
  "max_attempts": 2,
  "evaluation_case_id": "ticket_014"
}
Votre gateway peut utiliser des en-têtes, des balises, des champs de métadonnées ou un contexte côté serveur à la place de ce JSON exact. L’important est que l’application, le gateway et l’enregistrement d’évaluation partagent une identité de requête stable.
Ne placez pas de secrets bruts, de prompts complets, de données personnelles ou de texte client confidentiel dans les balises de routage. Séparez les métadonnées opérationnelles du contenu. Si la charge de travail contient des données sensibles, consignez la classification et appliquez la politique de journalisation appropriée au lieu de copier le contenu dans les champs d’observabilité.
Lot 1 : 40 requêtes normales
Utilisez 40 entrées représentatives qui devraient réussir sur la route principale. Incluez des cas faciles, typiques et limites plutôt que de répéter un seul prompt de démonstration.
Pour chaque requête, enregistrez :
- si la sortie a passé la validation spécifique à la tâche ;
- les identifiants de requête du gateway et de l’upstream ;
- l’alias demandé et le fournisseur/modèle résolu ;
- la latence totale et le temps jusqu’au premier token, le cas échéant ;
- les tokens d’entrée et de sortie lorsqu’ils sont disponibles ;
- le nombre de tentatives ou de bascules ;
- le coût estimé ;
- la décision finale : acceptée, rejetée ou en revue manuelle.
L’objectif n’est pas d’obtenir un score parfait. L’objectif est de découvrir si les échecs sont visibles et explicables. Une sortie rejetée avec une trace complète est plus utile qu’une sortie plausible sans aucun enregistrement de route ou d’utilisation.
Lot 2 : 30 requêtes de cas limites contractuels
Utilisez les 30 requêtes suivantes pour tester les fonctionnalités exactes dont votre application dépend. Choisissez parmi :
- un contexte long proche de votre limite d’entrée approuvée ;
- une sortie JSON stricte ou contrainte par schéma ;
- le démarrage du streaming, l’annulation et la complétion ;
- des appels d’outils avec des arguments valides et invalides ;
- des entrées image, audio ou document si la charge de travail les utilise ;
- des prompts multilingues ;
- des requêtes vides, malformées ou surdimensionnées ;
- du contenu qui devrait être rejeté par la politique de l’application.
Ne présumez pas qu’un endpoint compatible OpenAI rende chaque comportement de cas limite identique. Le gateway ne valide ce lot que lorsque votre application peut consommer correctement la réponse et classer le comportement non pris en charge sans corrompre silencieusement le flux de travail.
Lot 3 : 30 requêtes d’échec contrôlé
Utilisez un environnement hors production pour tester un comportement d’échec borné. Incluez des cas sûrs tels que :
- un nom de modèle ou de route invalide ;
- un identifiant d’accès de développement manquant ou révoqué ;
- un délai d’expiration intentionnellement court ;
- une condition de quota ou de limitation de débit en développement ;
- une erreur amont réessayable simulée ;
- un candidat de repli délibérément incompatible avec le contrat de la tâche.
Ce dernier cas est important. Une passerelle ne doit pas réacheminer simplement parce qu’un autre modèle est disponible. Si la route alternative ne peut pas préserver la sortie structurée, le comportement des outils, la politique de données ou les exigences de qualité, l’action correcte consiste à s’arrêter et à renvoyer une erreur classifiée.
Pour une politique d’échec plus approfondie, utilisez le guide de workflow de la stratégie de repli des modèles et le guide des limites de débit des LLM.
Tenez un registre d’acceptation avec une ligne par requête
Vous pouvez commencer avec un tableur ou une table de base de données. Évitez un tableau de bord qui masque les cas sous-jacents avant que vous ne les compreniez.
| Champ | Ce qu’il vous indique |
|---|---|
| ID de requête | Relie les preuves de l’application, de la passerelle et de l’amont |
| Cas d’évaluation | Montre quelle entrée et quel comportement attendu ont été testés |
| Route demandée | Capture ce que l’application a demandé |
| Route résolue | Révèle le fournisseur et le modèle qui l’ont effectivement servie |
| Résultat de validation | Sépare les complétions utiles du simple succès au niveau HTTP |
| Classe d’erreur | Distingue les cas d’arrêt, de réessai, de réacheminement et de réconciliation |
| Essais | Met en évidence l’amplification cachée des réessais |
| Latence | Confirme que la charge de travail reste dans son budget côté utilisateur |
| Coût estimé | Permet la comparaison par résultat accepté |
| Rétrogradation nécessaire | Identifie les cas qui bloqueraient l’extension en production |
Calculez au moins quatre métriques récapitulatives après les 100 requêtes :
taux de complétion acceptée = résultats acceptés / total des requêtes

couverture de trace = requêtes avec des ID complets de route et de requête / total des requêtes

amplification des réessais = total des tentatives amont / total des requêtes passerelle

coût par résultat accepté = coût estimé total / résultats acceptés
Ne comparez pas les passerelles uniquement sur le prix brut par requête. Une requête bon marché qui échoue à la validation, déclenche des tentatives répétées ou nécessite une réparation manuelle peut être plus coûteuse qu’une requête plus chère qui accomplit correctement la tâche.
Utilisez des critères explicites de sortie vers la production
Avant le début du laboratoire, marquez chaque critère comme requis, facultatif ou non applicable. Puis décidez sur la base de preuves plutôt que de l’enthousiasme.
| Critère de sortie | Exemple de règle pour débutant |
|---|---|
| Compatibilité du contrat | Tous les champs de réponse et fonctionnalités requis passent |
| Complétion acceptée | Aucune régression matérielle par rapport à la base de référence du fournisseur direct |
| Traçabilité | Chaque requête dispose d’un identifiant d’application et d’un identifiant de requête du gateway |
| Visibilité du routage | Le fournisseur/modèle résolu est disponible pour chaque requête terminée |
| Classification des échecs | Les échecs attendus se mappent à arrêter, réessayer, rerouter ou réconcilier |
| Budget de réessai | Aucune requête ne dépasse le nombre d’essais déclaré ou le budget de latence |
| Journalisation sensible | Le contenu brut est désactivé sauf approbation et gouvernance distinctes |
| Visibilité des coûts | Le coût par résultat accepté peut être calculé |
| Retour arrière | Le chemin direct peut être rétabli sans réécriture du code |
Utilisez l’un des trois résultats :
- Go : tous les critères requis sont satisfaits ; déplacez une charge de travail à faible risque vers un petit canary.
- Fix : le gateway est viable, mais une lacune nommée en compatibilité, télémétrie, sécurité ou politique d’échec bloque la production.
- Stop : la couche ajoute du risque ou du travail d’exploitation sans résoudre un problème actuel et mesurable.
Le laboratoire n’est terminé que lorsque quelqu’un est responsable de la décision, que les preuves sont enregistrées et que le chemin de retour arrière reste disponible. Cela transforme « nous avons connecté un gateway LLM » en un résultat d’ingénierie reproductible.
Les sept fonctions principales d’un gateway LLM
1. Abstraction du fournisseur
Le gateway crée une frontière stable entre le code applicatif et les API des fournisseurs. Cela réduit les intégrations répétées et facilite les tests de migration.
2. Authentification et gestion des clés
Les applications s’authentifient auprès du gateway, tandis que les identifiants du fournisseur restent derrière lui. Cela peut réduire le nombre de secrets en amont distribués entre les dépôts et les environnements de déploiement. Cela n’élimine pas le besoin de rotation, de restriction de portée, de masquage et de réponse aux incidents. Suivez un guide dédié à la gestion sécurisée des clés API.
3. Routage des modèles
Le routage peut être aussi simple que « envoyer cet alias vers ce modèle ». Des politiques plus avancées peuvent utiliser la capacité, l’état de santé, la latence, la région ou le coût. Gardez la décision explicable : chaque requête doit enregistrer pourquoi un routage a été choisi.
4. Contrôles de fiabilité
Le gateway peut centraliser les délais d’attente, les budgets de réessai, les coupe-circuits, les vérifications de santé et les solutions de repli sûres. La centralisation empêche chaque équipe applicative d’inventer une politique d’échec différente.
5. Coordination des limites de débit
Les fournisseurs limitent souvent les requêtes et les tokens dans le temps. Un gateway peut coordonner la concurrence, les files d’attente, l’exponential backoff et la capacité de routage au lieu de laisser plusieurs services se disputer aveuglément le même quota en amont.
6. Observabilité et répartition des coûts
La passerelle voit chaque requête, c’est donc un emplacement naturel pour attacher une télémétrie cohérente. Mesurez plus que le simple coût des jetons bruts. Suivez le taux de tâches acceptées, la latence, les tentatives et le coût par tâche acceptée afin qu’un itinéraire bon marché mais peu fiable ne paraisse pas efficace.
Le guide d’optimisation des coûts des API d’IA explique comment comparer les itinéraires en utilisant les résultats de charge de travail plutôt que le seul prix affiché.
7. Politique et gouvernance
Les équipes peuvent utiliser une passerelle pour restreindre les modèles, définir des budgets, plafonner l’utilisation des jetons, séparer les clés de développement et de production, et créer des enregistrements d’utilisation prêts pour l’audit. Ces contrôles deviennent de plus en plus utiles à mesure que davantage d’applications et d’agents partagent la même couche d’accès aux modèles.
LLM Gateway vs. outils similaires
Les débutants utilisent souvent « gateway », « router », « orchestration framework » et « reverse proxy » de manière interchangeable. Ils se recoupent, mais ne sont pas identiques.
| Outil | Rôle principal | Ce qu’il ne prend généralement pas en charge |
|---|---|---|
| LLM gateway | Accès, politique, routage, fiabilité et télémétrie pour les appels aux modèles | L’intégralité du flux de travail de l’application |
| Model router | Sélectionner un modèle ou une route amont | L’authentification, la facturation, la gouvernance ou l’observabilité complète, sauf si elles sont incluses |
| Orchestration framework | Coordonner les prompts, les outils, la mémoire, les agents et les flux de travail en plusieurs étapes | Le compte fournisseur central et le contrôle de la facturation par défaut |
| Reverse proxy | Transmettre le trafic réseau, terminer TLS et appliquer des contrôles HTTP génériques | Des limites de jetons tenant compte du modèle, des contrats de repli ou la comptabilisation de l’utilisation de l’IA par défaut |
| Provider SDK | Appeler l’API d’un fournisseur avec des fonctionnalités natives du fournisseur | Le routage multi-fournisseurs et des contrôles unifiés |
Vous pouvez combiner ces couches. Un framework d’agent peut appeler une LLM gateway. La passerelle peut utiliser un routeur en interne. Un reverse proxy peut se placer devant la passerelle pour les contrôles réseau.
Quand avez-vous besoin d’une LLM Gateway ?
Utilisez ce guide débutant de LLM Gateway comme test de décision. Une passerelle mérite d’être évaluée lorsque deux ou plusieurs de ces affirmations sont vraies :
- Vous prenez en charge plus d’un fournisseur de modèles.
- Plusieurs services ou agents ont besoin d’un accès aux modèles.
- Les clés fournisseur sont dupliquées entre les environnements.
- Les équipes ne peuvent pas dire quelle application a généré une charge.
- La gestion des limites de débit diffère selon les bases de code.
- Une panne fournisseur ou une route dégradée interrompt un flux de travail critique.
- Vous avez besoin de listes d’autorisation de modèles, de quotas ou de budgets au niveau de l’environnement.
- Changer de modèles nécessite des modifications répétées du SDK ou du déploiement.
- L’exploitation a besoin d’un seul identifiant de requête à travers les couches application et fournisseur.
Vous n’avez peut-être pas encore besoin d’une passerelle si vous avez un seul prototype à faible risque, un seul fournisseur, un seul propriétaire et aucune exigence de fiabilité ou de gouvernance en production. Commencez par un accès direct, mais gardez les appels fournisseur derrière un petit adaptateur applicatif afin qu’une migration future soit maîtrisée.
Construire vs acheter une LLM Gateway : une grille d’évaluation pratique
La question d’évaluation commerciale la plus importante n’est pas de savoir si une passerelle est utile. C’est quelles parties votre équipe doit prendre en charge. Vous pouvez créer une passerelle, adopter un service hébergé, exécuter un proxy open source ou les combiner.
Utilisez un tableau de bord pondéré plutôt que de choisir à partir d’une liste de fonctionnalités. Attribuez à chaque option une note de 1 à 5, multipliez-la par le poids, puis comparez les totaux. Les poids ci-dessous sont des points de départ, pas des règles universelles.
| Critère | Poids suggéré | Questions à poser |
|---|---|---|
| Compatibilité de la charge de travail | 25% | Préserve-t-il le streaming, la sortie structurée, les outils, les images, les détails d’erreur et la comptabilisation des jetons ? |
| Fiabilité | 20% | Les délais d’attente, les tentatives, les vérifications de santé, les règles de repli et la visibilité des incidents sont-ils explicites ? |
| Sécurité et gouvernance | 15% | Pouvez-vous isoler les locataires, restreindre les modèles, faire tourner les identifiants, masquer le contenu et auditer l’accès ? |
| Observabilité | 15% | Pouvez-vous tracer la route demandée, la route résolue, les tentatives, la latence, l’utilisation, la validation et le coût ? |
| Charge opérationnelle | 10% | Qui gère les mises à niveau, les changements de fournisseur, la mise à l’échelle, la réponse d’astreinte et la rétention des données ? |
| Adéquation commerciale | 10% | La facturation est-elle compréhensible, exportable, attribuable et compatible avec votre schéma d’utilisation attendu ? |
| Voie de sortie | 5% | Pouvez-vous exporter la configuration et la télémétrie, préserver les contrats d’application et changer sans réécriture ? |
Construire lorsque le contrôle est le produit
Construire peut être rationnel lorsque le comportement de routage constitue un avantage concurrentiel essentiel, que des réglementations exigent un modèle de déploiement que les services disponibles ne peuvent pas satisfaire, ou que l’échelle de votre trafic justifie une équipe plateforme dédiée. Mais « construire » implique bien plus que relayer des requêtes HTTP. Cela signifie prendre en charge l’authentification, les adaptateurs de fournisseurs, les différences de schéma, le streaming, la normalisation des erreurs, les quotas, l’observabilité, la gestion des versions, les revues de sécurité et la réponse aux incidents.
Acheter lorsque l’accès et les opérations ne sont pas différenciants
Une passerelle hébergée est généralement mieux adaptée lorsque l’objectif est d’accéder plus rapidement à plusieurs fournisseurs, de centraliser la facturation et les identifiants, ou de donner à plusieurs applications un plan de contrôle partagé. L’évaluation doit néanmoins inclure une voie de sortie. Gardez la passerelle derrière un adaptateur d’application, préservez les tests de capacités des modèles et évitez d’intégrer des hypothèses propres à un fournisseur dans tout le code produit.
Utiliser l’open source lorsque vous pouvez l’exploiter
Une passerelle ou un proxy open source peut offrir de la flexibilité et de la visibilité sur le code, mais l’hébergement interne transfère à votre équipe la disponibilité, la mise à l’échelle, les mises à niveau, le stockage de télémétrie et l’application des correctifs de sécurité. Comparez l’obligation opérationnelle totale, pas seulement la licence logicielle.
Le déploiement de la passerelle LLM en quatre étapes
Un déploiement sûr valide une couche à la fois. Ne commencez pas par un routage dynamique des coûts sur l’ensemble des charges de travail.
Étape 1 : test fantôme de compatibilité
Envoyez un ensemble d’évaluation représentatif via la passerelle candidate sans modifier le comportement de production. Vérifiez les champs de requête, les réponses, le streaming, les appels d’outils, les sorties structurées, les champs d’utilisation et les erreurs. Enregistrez chaque divergence. Une réponse HTTP réussie n’est pas suffisante si le contrat de l’application change.
Condition de sortie : la passerelle prend en charge les fonctionnalités et les contrôles qualité requis par la charge de travail, sans perte de contrat inexpliquée.
Étape 2 : une charge de travail à faible risque
Basculez une charge de travail réversible et non critique vers un seul itinéraire de modèle explicite. Conservez l’ancien chemin direct vers le fournisseur comme solution de retour arrière. Ajoutez des identifiants de requête et une télémétrie de route résolue avant d’ajouter des nouvelles tentatives ou un fallback.
Condition de sortie : l’équipe peut expliquer chaque requête échouée, rapprocher l’utilisation et revenir en arrière sans nouvelle version de code.
Étape 3 : politique de fiabilité
Ajoutez un délai d’attente borné, une classification des nouvelles tentatives et un fallback testé pour un mode de défaillance que vous avez réellement observé. N’effectuez pas de fallback entre modèles simplement parce qu’ils acceptent tous deux un JSON similaire. L’itinéraire alternatif doit satisfaire le même contrat de charge de travail.
Pour une conception de reprise plus approfondie, utilisez le guide de stratégie de fallback de modèle et le guide des limites de débit LLM.
Condition de sortie : les exercices de panne montrent que les nouvelles tentatives et le fallback améliorent le nombre de complétions acceptées sans provoquer d’effets de bord en double, de latence galopante ou de dépenses incontrôlées.
Étape 4 : plan de contrôle de production partagé
Étendez le dispositif uniquement après que la première charge de travail dispose de mesures stables. Ajoutez des quotas de locataire, des listes d’autorisation de modèles, une séparation des environnements, des alertes budgétaires et un processus documenté pour modifier les routes. Examinez qui peut modifier la politique et comment les changements sont audités.
Condition de sortie : plusieurs applications peuvent utiliser la passerelle sans perdre l’attribution des coûts, la traçabilité des incidents, les frontières de sécurité ni le contrôle du retour arrière.
Carte des erreurs pour débutants : réessayer, rerouter ou arrêter ?
La fiabilité de la passerelle dépend moins du nombre de modèles de fallback que de la capacité à prendre la bonne décision pour chaque échec. Utilisez cette carte simplifiée comme point de départ.
| Échec | Signification typique | Action pour débutant |
|---|---|---|
| 400 ou erreur de validation | Le contrat de la requête est invalide ou non pris en charge | Arrêtez, corrigez la requête et ne recommencez pas sans modification |
| 401 ou 403 | Problème d’identifiants, d’autorisation, de liste d’autorisation du modèle ou de compte | Arrêtez et déclenchez une alerte ; ne faites jamais défiler des clés aléatoires |
| 404 modèle ou route | L’identifiant configuré est indisponible ou incorrect | Arrêtez ou utilisez une route équivalente explicitement approuvée |
| 408 ou délai d’attente du client | Le budget de latence de l’appelant a expiré | Annulez si possible ; réessayez uniquement lorsque la tâche est idempotente |
| 429 limite de débit | La capacité ou le quota a été dépassé | Respectez les consignes de réessai, mettez en file d’attente ou utilisez une route équivalente testée |
| 5xx avant la sortie | La passerelle ou l’amont a échoué avant une réponse exploitable | Utilisez un réessai borné ou un basculement testé |
| Le flux se rompt en cours de sortie | Un contenu partiel peut déjà exister | Arrêtez et mettez en cohérence ; ne rejouez pas aveuglément les effets de bord |
| L’appel d’outil a peut-être été exécuté | L’état externe a pu changer | Vérifiez la clé d’idempotence ou l’état de l’outil avant de réessayer |
Le mot borné est important. Chaque workflow a besoin d’un nombre maximal de tentatives, d’un budget de temps total et d’un état terminal. Sinon, une passerelle peut transformer un incident chez un fournisseur en actions d’outil en double, en coûts incontrôlés et en une panne plus grave.
Pour une implémentation plus approfondie, utilisez le playbook de stratégie de repli de modèle.
Comment mesurer si la passerelle fonctionne
Le succès d’une passerelle ne se mesure pas au nombre de fournisseurs connectés. Il se mesure à l’amélioration des résultats acceptés et du contrôle opérationnel.
| Métrique | Ce qu’elle révèle | Calcul adapté aux débutants |
|---|---|---|
| Taux d’achèvement accepté | Si les utilisateurs reçoivent des résultats exploitables | résultats acceptés ÷ démarrages de workflow |
| Taux d’échec attribuable à la passerelle | Si la nouvelle couche crée des échecs | échecs de la passerelle ÷ requêtes de la passerelle |
| Latence de bout en bout au p95 | Si la politique et le basculement nuisent à l’expérience utilisateur | 95e percentile entre le démarrage de l’application et le résultat accepté |
| Taux de récupération par repli | Si le repli résout les échecs réels | résultats acceptés en repli ÷ tentatives de repli |
| Coût par résultat accepté | Si des appels moins chers produisent des արդյունats moins coûteux | coût total du modèle et des réessais ÷ résultats acceptés |
| Explicabilité des routes | Si les incidents et les factures peuvent être retracés | requêtes avec champs de route demandée et résolue ÷ total des requêtes |
| Précision des refus de politique | Si la gouvernance bloque le trafic prévu | requêtes correctement refusées ÷ refus examinés |
Établissez une référence avant la migration. Comparez ensuite la même charge de travail, le même ensemble d’évaluation, le même segment de trafic et la même fenêtre temporelle. Si la qualité baisse, si la latence augmente ou si les coûts deviennent plus difficiles à rapprocher, un prix facial par jeton plus bas n’est pas un résultat de passerelle réussi.
Pour l'analyse des coûts, poursuivez avec le guide d’optimisation des coûts des API d’IA. Pour un plan de télémétrie plus complet, utilisez la liste de contrôle de mise en œuvre de l’observabilité de l’IA.
Une implémentation pour débutant : cinq étapes pratiques
Étape 1 : rédigez le contrat de la tâche
Choisissez une charge de travail réelle, comme le résumé de tickets de support ou l’extraction de champs à partir de factures. Définissez :
- les entrées et sorties requises ;
- la latence acceptable ;
- les règles de validation ;
- si le streaming est requis ;
- si des outils peuvent créer des effets de bord ;
- ce qui compte comme un résultat accepté.
Ce contrat détermine si un fallback est sûr et si un autre modèle est réellement équivalent.
Étape 2 : choisissez une interface client stable
Si votre application utilise déjà un SDK compatible OpenAI, une passerelle compatible peut réduire le travail de migration. Flatkey, par exemple, documente une URL de base compatible OpenAI à https://router.flatkey.ai/v1.
curl -X POST "https://router.flatkey.ai/v1/chat/completions" \
  -H "Authorization: Bearer $FLATKEY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "your-model",
    "messages": [
      {"role": "user", "content": "Explain this error in plain English."}
    ]
  }'
Utilisez un gestionnaire de secrets ou une variable d’environnement côté serveur pour la clé. Ne l’intégrez jamais dans le code d’un client web ou mobile.
Étape 3 : commencez par un routage explicite
Acheminiez la charge de travail vers un modèle testé. Si vous voulez une indépendance applicative, mappez un alias interne à ce modèle dans la configuration. Évitez un routeur opaque du type « modèle le moins cher » ou « meilleur modèle » tant que vous n’avez pas un jeu d’évaluation reproductible.
Étape 4 : ajoutez la télémétrie minimale viable
Enregistrez :
- l’ID de requête de la passerelle ;
- la charge de travail et l’environnement ;
- l’alias demandé ;
- le fournisseur et le modèle résolus ;
- le statut et la latence ;
- le nombre de tentatives et de basculements ;
- les jetons d’entrée et de sortie ;
- le coût estimé ;
- le résultat de la validation.
Cela suffit pour dépanner les premiers problèmes de production et comparer des alternatives plus tard.
Étape 5 : ajoutez une politique de défaillance bornée
Commencez par un délai d’attente et un petit budget de nouvelles tentatives pour les échecs transitoires. N’ajoutez un fallback qu’après avoir vérifié que la route alternative respecte le même contrat de tâche. Pour le streaming ou les appels d’outils avec effets de bord, définissez comment l’application détecte une exécution partielle et réconcilie l’état.
Votre première semaine avec un LLM Gateway
Utilisez un plan d’adoption sur sept jours plutôt que de migrer toutes les applications d’un coup.
Jour 1 : recensez une charge de travail
Notez le fournisseur actuel, le modèle, le SDK, les identifiants, les fonctionnalités requises, le trafic, le budget de latence, la sensibilité des données et le responsable du rollback.
Jour 2 : exécutez le test de compatibilité
Envoyez des prompts représentatifs via le chemin direct et le chemin de la passerelle. Incluez les entrées longues, la sortie structurée, le streaming, les outils et les cas d’erreur attendus si la charge de travail les utilise.
Jour 3 : ajouter l’identité de la requête et les enregistrements d’utilisation
Confirmez que l’application stocke un identifiant de requête de passerelle et peut le relier au modèle, à l’itinéraire du fournisseur, à la latence, aux jetons, au nombre de tentatives et au résultat de validation, sans consigner par défaut de contenu sensible.
Jour 4 : définir la politique d’échec
Classez les erreurs en arrêt, nouvelle tentative, basculement équivalent, solution de repli multi-modèles et réconciliation manuelle. Définissez un budget total de tentatives et de latence.
Jour 5 : envoyer un petit canari de production
Utilisez une charge de travail à faible risque et une part de trafic volontairement faible. Gardez le chemin direct disponible. Comparez le taux de complétion acceptée, la latence p95 et le coût par résultat accepté.
Jour 6 : examiner la sécurité et les contrôles de dépenses
Séparez les identifiants de développement et de production, restreignez les modèles autorisés, définissez des quotas et vérifiez qui peut consulter ou modifier la politique de routage. Utilisez le guide de gestion sécurisée des clés API pour une liste de contrôle plus complète des mesures de contrôle.
Jour 7 : prendre une décision go, fix ou stop
- Go : les vérifications de contrat requises passent et le canari atteint ses seuils d’acceptation.
- Fix : l’architecture est saine, mais un écart mesurable bloque l’expansion.
- Stop : la passerelle ajoute un risque opérationnel ou un coût sans bénéfice de contrôle actuel.
Documentez la décision et la prochaine date de revue. Un arrêt contrôlé est préférable à une migration non mesurée.
Erreurs courantes des débutants
Traiter tous les modèles comme interchangeables
Même lorsque la syntaxe des requêtes est normalisée, les capacités et le comportement de sortie diffèrent. Testez les fonctionnalités exactes que votre charge de travail utilise.
Acheminer avant de mesurer
Le routage dynamique sans données d’évaluation déplace la logique de décision dans une boîte noire. Établissez d’abord une référence, puis introduisez une politique mesurable.
Réessayer chaque erreur
Les erreurs d’authentification, les requêtes invalides, les budgets épuisés et les fonctionnalités non prises en charge ne sont pas transitoires. Réessayez uniquement les erreurs qui peuvent réussir plus tard, et utilisez un backoff exponentiel avec jitter lorsque cela est approprié.
Journaliser le contenu sensible par défaut
Les prompts peuvent contenir des données clients, du code source ou des données métier. Gardez l’observabilité des métadonnées séparée de la conservation du contenu.
Masquer l’itinéraire résolu
Si l’application demande un alias, enregistrez le fournisseur et le modèle réellement utilisés. Sinon, les incidents, les régressions de qualité et les changements de coût deviennent difficiles à expliquer.
Mesurer le prix au lieu des résultats
Des prix de jetons plus bas ne garantissent pas un coût de charge de travail plus faible. Incluez les échecs de validation et les nouvelles tentatives dans votre calcul de coût.
Comment Flatkey s’intègre au modèle de passerelle
Flatkey fournit une couche unifiée d’accès aux modèles et aux outils avec une seule clé, des journaux d’utilisation partagés et un point de terminaison de modèle compatible OpenAI. Pour un client compatible existant, le chemin de migration consiste à changer l’URL de base, utiliser une clé Flatkey, choisir un modèle pris en charge et tester le contrat de charge de travail.
Flatkey devient donc pertinent lorsque vous تريد réduire la multiplication des comptes fournisseurs sans construire et exploiter vous-même la couche d’agrégation. Si vous évaluez l’architecture plutôt que de chercher un aperçu pour débutant, lisez le guide détaillé sur l’architecture d’une passerelle d’API IA. Si vous êtes prêt à migrer un client, utilisez la checklist de passerelle d’API compatible OpenAI.
Explorez les modèles Flatkey, consultez la documentation, ou créez une clé API lorsque vous serez prêt à tester une charge de travail réelle.
Checklist du guide débutant de LLM Gateway
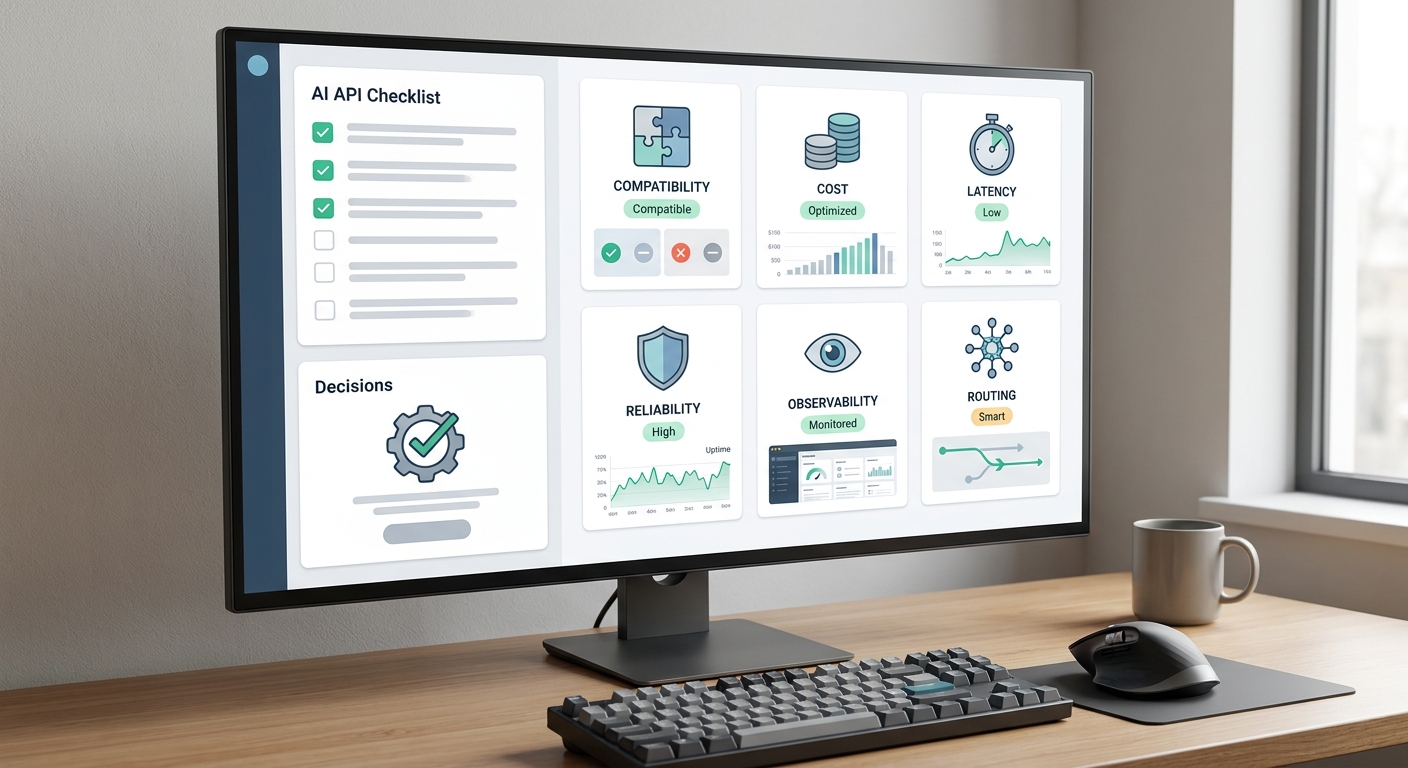
Avant d’envoyer du trafic de production via une passerelle LLM, vérifiez :
- [ ] Un contrat de charge de travail a défini des critères de réussite.
- [ ] L’application utilise un identifiant d’accès de passerelle côté serveur.
- [ ] Le modèle sélectionné a passé des tests représentatifs.
- [ ] La sortie structurée, les outils et le streaming ont été testés s’ils sont utilisés.
- [ ] Les délais d’expiration et les erreurs réessayables sont définis explicitement.
- [ ] Le mécanisme de repli préserve le contrat de charge de travail.
- [ ] Chaque requête reçoit un identifiant de requête traçable.
- [ ] Le fournisseur et le modèle résolus sont enregistrés.
- [ ] Les jetons, la latence, les nouvelles tentatives, la validation et le coût sont mesurés.
- [ ] Les quotas de développement et de production sont séparés.
- [ ] La journalisation du contenu brut est désactivée ou encadrée de manière explicite.
- [ ] Un chemin de retour arrière direct est documenté.
- [ ] Une référence existe pour le taux d’achèvement accepté, la latence et le coût par résultat accepté.
- [ ] Les options build, hébergée et auto-hébergée ont été comparées en termes de charge opérationnelle et de voie de sortie.
- [ ] Le premier déploiement utilise une route explicite avant l’introduction du routage dynamique.
Questions fréquemment posées
Une passerelle LLM est-elle la même chose qu’une passerelle API ?
C’est une passerelle API spécialisée pour le trafic des modèles d’IA. Elle peut fournir des fonctions standard de passerelle API telles que l’authentification et la limitation du débit, ainsi que le routage conscient des modèles, l’utilisation des jetons, la normalisation des erreurs spécifiques à l’IA et un mécanisme de repli tenant compte du contrat.
Une passerelle LLM héberge-t-elle les modèles ?
Pas nécessairement. Certaines passerelles routent vers des fournisseurs externes, d’autres sont intégrées à une infrastructure d’inférence, et certaines prennent en charge les deux. Demandez où l’inférence a lieu, quel fournisseur sert réellement chaque modèle, et comment cette route apparaît dans les journaux d’utilisation.
Une passerelle LLM réduit-elle les coûts ?
Elle peut aider en centralisant les données d’utilisation, en appliquant des quotas, en réduisant les intégrations dupliquées et en permettant des changements de route mesurés. Les économies ne sont pas automatiques. Comparez le coût par tâche acceptée, y compris les nouvelles tentatives et les échecs de qualité.
Puis-je utiliser une passerelle LLM avec le SDK OpenAI ?
Oui, si la passerelle expose un point de terminaison compatible avec OpenAI et prend en charge les fonctionnalités utilisées par votre application. Modifiez l’URL de base et l’identifiant de connexion, puis testez l’intégralité du contrat de charge de travail plutôt que de supposer une compatibilité parfaite.
Une passerelle est-elle un point unique de défaillance ?
Elle peut l’être. Évaluez son architecture de déploiement, ses vérifications d’état, le basculement en amont, le comportement des délais d’attente, l’observabilité, les engagements de service et le chemin de retour en arrière. La centralisation du contrôle augmente l’effet de levier opérationnel, donc la passerelle elle-même doit être considérée comme une infrastructure de production.
Une startup devrait-elle construire ou acheter une passerelle LLM ?
Construisez lorsque le comportement de la passerelle est un différenciateur clé, que vous avez des contraintes de déploiement inhabituelles, ou que vous avez l’équipe pour l’exploiter. Achetez lorsque l’objectif principal est un accès plus rapide, moins d’intégrations de fournisseurs, une utilisation unifiée et des contrôles partagés. Une petite équipe peut aussi commencer en direct et migrer plus tard si les appels aux fournisseurs sont déjà isolés derrière un adaptateur.
Que dois-je tester avant de déplacer le trafic de production ?
Testez exactement le contrat de charge de travail : flux continu, sortie structurée, outils, entrées multimédias, limites de contexte, comportement des erreurs, gestion des délais d’attente, champs d’utilisation et qualité de sortie. Ensuite, exécutez un canari à faible risque avec un chemin de retour en arrière direct et comparez le taux d’achèvement accepté, la latence p95 et le coût par résultat accepté au référentiel d’avant la passerelle.
Le modèle mental simple
La version la plus courte de ce guide débutant de LLM Gateway est :
Votre application demande un travail d’IA. La passerelle décide si la requête est autorisée, où elle doit être acheminée, comment l’échec doit être géré et ce qui doit être enregistré.
Commencez avec une seule charge de travail, une interface stable, un routage explicite, une télémétrie minimale viable et une politique de défaillance unique et bornée. N’ajoutez un routage sophistiqué qu’une fois que vous pouvez mesurer la qualité, la latence, la fiabilité et le coût.