Руководство для начинающих по LLM Gateway: от первого запроса до продакшена
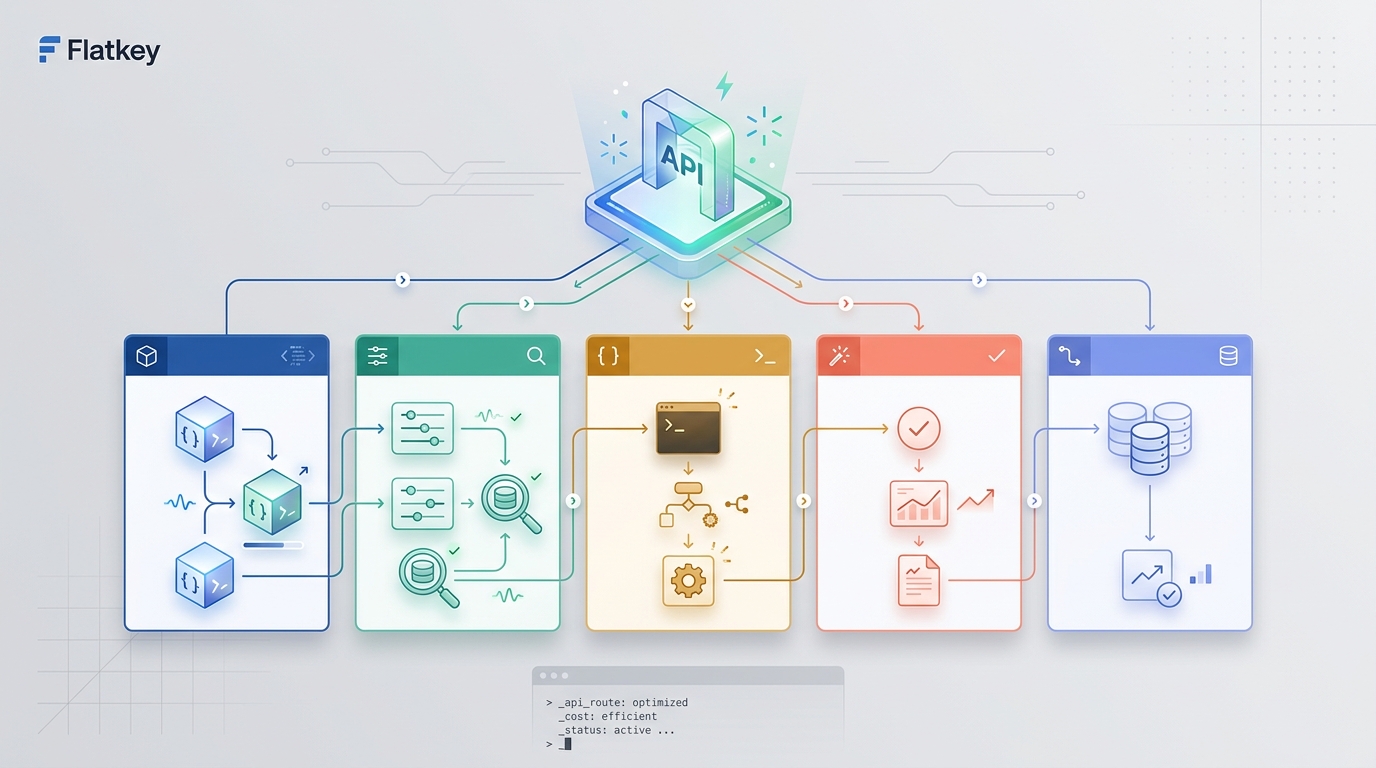
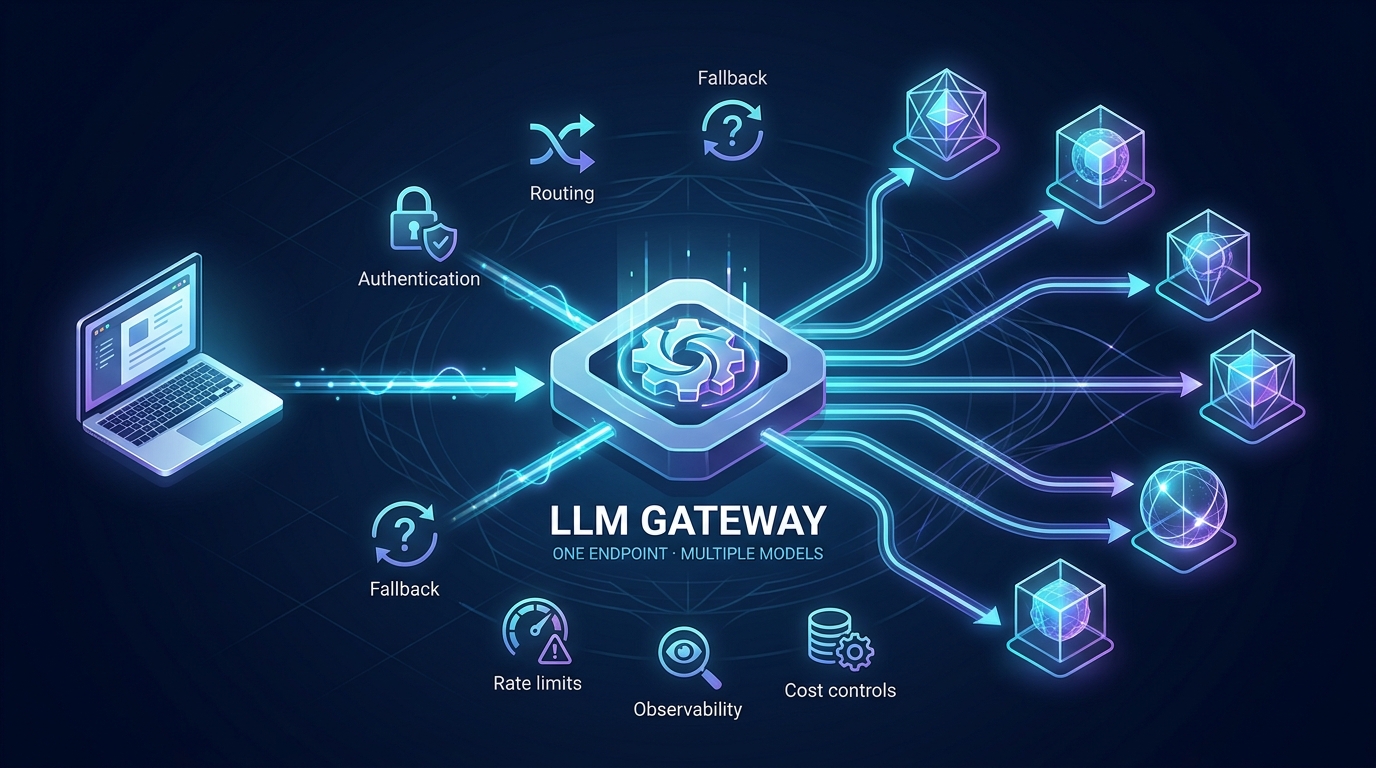
LLM gateway — это уровень управления между вашим приложением и одним или несколькими поставщиками AI-моделей. Ваше приложение отправляет запросы в gateway вместо того, чтобы подключаться отдельно к каждому поставщику. Затем gateway выполняет аутентификацию запроса, применяет политики, выбирает модель или upstream-соединение, перенаправляет вызов и записывает результат.
Это звучит как обычная API-инфраструктура, но она решает проблему, которая быстро возникает в реальных AI-продуктах: первую интеграцию с моделью сделать просто; пятую — уже нет. Каждый поставщик может добавить еще один ключ, SDK, формат запроса, политику rate limit, форму ошибки, страницу использования и счет.
Это руководство для начинающих по LLM gateway объясняет, что делает этот уровень, как через него проходит запрос, чем он отличается от смежных инструментов, когда он нужен и как реализовать первую интеграцию с gateway без излишнего усложнения. Оно также дает таблицу для сравнения build vs buy, поэтапный план внедрения и измеримые критерии приемки, чтобы решить, создает ли gateway реальную бизнес-ценность.
Обновлено 4 августа 2026 года: В это руководство теперь включена лабораторная работа по первым 100 запросам с envelope запроса, тремя тестовыми партиями, журналом приемки и критериями выхода в продакшен, а также 15-минутный quickstart и чеклист внедрения.
60-секундное решение для начинающих
Вам, вероятно, пока не нужен LLM gateway, если одно приложение вызывает одного поставщика, нагрузка все еще экспериментальная, а короткий простой или ручная ротация ключа не повлияют на клиентов.
Стоит оценивать gateway, когда верны два или более из следующих утверждений:
- ваше приложение использует или планирует использовать более одного поставщика моделей;
- нескольким сервисам нужны AI-учетные данные и контроль использования;
- rate limits или инциденты у поставщика могут прервать клиентский процесс;
- финансы не могут сопоставить расходы на модели с командой, продуктом или клиентом;
- смена модели требует развертывания приложения;
- вам нужен общий allowlist, квота, audit trail или политика fallback;
- разработчики заново реализуют одни и те же адаптеры поставщиков в нескольких репозиториях.
Ошибка новичков — внедрять gateway потому, что архитектурная схема выглядит зрелой. Внедряйте его тогда, когда он убирает повторяющуюся операционную работу или создает контроль, который можно измерить.
Что такое LLM Gateway?
LLM gateway, также называемый LLM API gateway или AI gateway, предоставляет приложениям стабильный интерфейс для доступа к AI-моделям. В своей простейшей форме он обеспечивает:
- одну точку входа для запросов к моделям;
- один контур аутентификации;
- единый контракт запроса и ответа;
- централизованные записи об использовании;
- правила маршрутизации, которые определяют, куда отправляется запрос.
Более функциональный gateway также может обеспечивать соблюдение бюджетов, ограничивать разрешенные модели, выполнять ограниченные retries, переключаться между эквивалентными маршрутами при отказе, добавлять request ID, нормализовать ошибки и передавать телеметрию по задержке, токенам и стоимости.
Важная идея в этом руководстве для начинающих по LLM gateway — это разделение ответственности. Код вашего продукта должен описывать задачу, которую нужно выполнить. Gateway должен обрабатывать доступ к провайдерам, политику маршрутизации и операционные контроли.
Application
    │
    │ one authenticated request
    ▼
LLM gateway
    ├── policy and quota check
    ├── model or route selection
    ├── provider request
    ├── retry or safe fallback
    └── usage and error record
             │
             ├── Provider A / Model 1
             ├── Provider B / Model 2
             └── Provider C / Model 3
Почему бы не обращаться к каждому провайдеру моделей напрямую?
Прямая интеграция часто является правильной отправной точкой. Если прототип использует одну модель, имеет низкий трафик и не нуждается в общих средствах управления, добавление gateway может создать больше лишней сложности, чем пользы.
Компромисс меняется, когда приложению нужны несколько провайдеров или оно должно надежно работать в продакшене.
| Проблема | Прямые интеграции с провайдерами | LLM gateway |
|---|---|---|
| Учетные данные | Отдельные ключи в каждой среде | Один ключ или идентификатор, обращенный к приложению |
| Код клиента | Клиенты и адаптеры, специфичные для провайдера | Стабильный контракт клиента, где это поддерживается |
| Переключение моделей | Изменение приложения или конфигурация для каждого провайдера | Централизованное изменение маршрута или политики модели |
| Ограничения по частоте | Обрабатываются отдельно для каждого провайдера | Скоординированные лимиты, очереди и политика повторных попыток |
| Отслеживание использования | Разбросано по панелям провайдеров | Централизованные записи запросов, токенов, задержек и затрат |
| Отказоустойчивость | Специальная логика в каждом приложении | Общая fallback-политика с учетом контракта |
| Управление | Повторяется в каждом сервисе | Централизованные allowlist моделей, квоты и поля аудита |
Gateway не устраняет различия между провайдерами. У моделей по-прежнему могут быть разные возможности, ограничения контекста, схемы инструментов, поведение потоковой передачи, политики безопасности и цены. Хороший gateway делает эти различия явными и управляемыми, а не делает вид, что каждая модель взаимозаменяема.
Как работает LLM Gateway, шаг за шагом
1. Приложение отправляет один запрос
Приложение вызывает стабильный базовый URL и передает учетные данные gateway. В случае gateway, совместимого с OpenAI, существующему клиенту OpenAI может понадобиться только другой base_url, API-ключ и идентификатор модели.
2. Gateway аутентифицирует и авторизует его
Gateway проверяет вызывающий проект, среду, пользователя или рабочую нагрузку. Затем он может проверить allowlist, квоту, бюджет или политику максимального числа токенов до того, как будут понесены какие-либо затраты у вышестоящего провайдера.
3. Правило маршрутизации выбирает назначение
Запрос может указывать точную модель. Он может использовать псевдоним, управляемый командой, например support-fast. Или он может попадать под политику маршрутизации, которая учитывает возможности, состояние, регион, задержку или стоимость.
Для первой реализации лучше выбрать явный выбор модели или простой алиас. Динамическая маршрутизация полезна, но к ней стоит переходить только после того, как у вас появятся данные оценки и наблюдаемость.
4. Шлюз переводит только то, что может сохранить
Некоторые шлюзы предоставляют контракт, совместимый с OpenAI, поверх нескольких провайдеров. Шлюз сопоставляет поля с API выбранного провайдера и, где это возможно, нормализует ответ.
Совместимость имеет пределы. Перед переключением моделей протестируйте структурированный вывод, вызов инструментов, изображения, потоковую передачу, причины завершения, учет токенов и поведение при ошибках. «Совместимый» должен означать, что ваш требуемый контракт прошел тесты, а не просто то, что запрос вернул HTTP 200.
5. Шлюз обрабатывает операционную политику
Шлюз может применять тайм-аут, учитывать бюджет на повторы, приостанавливать неработоспособный маршрут или выбирать резервный вариант. Повторы должны быть ограничены. Резервные варианты должны сохранять контракт задачи. Запросы с побочными эффектами инструментов или частично потоковым выводом могут требовать сценария остановки и согласования вместо автоматического повторного запуска.
Для более глубокой производственной архитектуры используйте плейбук стратегии резервирования моделей и руководство по лимитам LLM rate limits.
6. Шлюз записывает, что произошло
Полезные записи включают идентификатор запроса, приложение, среду, запрошенную модель, определенного провайдера и модель, задержку, статус, число повторов, входные и выходные токены, а также оценочную стоимость.
Не логируйте сырые промпты и ответы по умолчанию. Логируйте метаданные, которые поддерживают эксплуатацию, а ведение журнала содержимого рассматривайте как отдельное решение в области безопасности и конфиденциальности.
15-минутный быстрый старт LLM Gateway
Самый быстрый способ понять шлюз — пропустить через него один некритичный запрос. Используйте серверный тестовый скрипт, явную модель и промпт с очевидным ожидаемым результатом. Не начинайте с автоматической маршрутизации или производственного агента.
Шаг 1: Зафиксируйте базовую линию прямого провайдера
Перед тем как что-либо менять, сохраните пять фактов из текущего прямого вызова:
- удовлетворяет ли ответ задаче;
- общую задержку и время до первого токена, если используется потоковая передача;
- количество входных и выходных токенов;
- идентификатор запроса провайдера и форму ошибки;
- оценочную стоимость принятого результата.
Это дает вам конкретную точку для сравнения. Миграция на шлюз не считается успешной только потому, что она возвращает HTTP 200.
Шаг 2: Измените подключение, а не рабочую нагрузку
Для шлюза, совместимого с OpenAI, изменение на стороне приложения обычно сводится к API-ключу шлюза, базовому URL шлюза и поддерживаемому идентификатору модели. Точные имена переменных окружения зависят от клиента и шлюза.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["LLM_GATEWAY_API_KEY"],
    base_url=os.environ["LLM_GATEWAY_BASE_URL"],
)

response = client.chat.completions.create(
    model=os.environ["LLM_GATEWAY_MODEL"],
    messages=[
        {"role": "system", "content": "Возвращайте только валидный JSON."},
        {"role": "user", "content": "Классифицируйте этот тикет как billing, bug или feature: с меня списали деньги дважды."},
    ],
    temperature=0,
)

print(response.choices[0].message.content)
Храните учетные данные на сервере. Никогда не размещайте master key шлюза в браузерном JavaScript, мобильном бинарном файле, публичном репозитории или на общем скриншоте.
Шаг 3: Сравните контракт ответа
Проверяйте не только качество текста. Подтвердите поля, которые действительно использует ваше приложение:
- ID ответа и имя модели;
- причину завершения;
- использование токенов;
- порядок streaming-событий;
- поведение структурированного вывода;
- идентификаторы и аргументы tool-call;
- HTTP-статус и тело ошибки;
- поведение отмены и тайм-аута.
Совместимость с OpenAI уменьшает объем работ по миграции, но не гарантирует, что все возможности провайдера будут вести себя одинаково. Тестируйте тот контракт, на который опирается ваш код.
Шаг 4: Принудительно вызовите один безопасный сбой
Используйте тестовую среду, чтобы вызвать один предсказуемый сбой, например неверное имя модели, намеренно слишком маленький тайм-аут или лимит для dev-среды. Проверьте, что шлюз возвращает отслеживаемый ID запроса и ошибку, которую ваше приложение может классифицировать.
Не тестируйте отказ провайдера, создавая неконтролируемую нагрузку в продакшене. Цель — доказать, что ваше приложение умеет различать ошибки аутентификации, ограничения по rate limit, тайм-ауты, upstream-сбои и ошибки валидации.
Шаг 5: Примите решение с помощью таблицы приемки
| Проверка | Правило приемки для начинающих |
|---|---|
| Вывод | Проходит ту же проверку задачи, что и прямой вызов |
| Задержка | В пределах заявленного бюджета для нагрузки |
| Использование | Поля токенов присутствуют, либо отсутствие задокументировано |
| Отслеживаемость | Один ID запроса связывает приложение, шлюз и upstream-запись |
| Ошибки | Приложение может классифицировать повторяемые и неповторяемые сбои |
| Стоимость | Измеряется на принятый результат, а не на сырой запрос |
| Откат | Возврат к прямому маршруту задокументирован и протестирован |
Если шлюз не проходит любой обязательный пункт, не переводите тест в продакшен, пока несоответствие не будет исправлено или явно принято.
Ваши первые 100 запросов к шлюзу: лаборатория для начинающих
Успешный первый запрос подтверждает подключение. Он не доказывает, что шлюз безопасен для продакшена. Следующая полезная веха — небольшой контролируемый набор из 100 репрезентативных запросов, который проверяет совместимость, отслеживаемость, обработку сбоев и дисциплину эксплуатации.
Этот лабораторный сценарий намеренно прост. Он не требует динамической маршрутизации, сложной платформы оценки или крупной миграции в продакшен. Он дает новичку достаточно доказательств, чтобы решить, стоит ли двигаться дальше, исправить конкретный пробел или вернуться к прямому маршруту к провайдеру.
Начните с конверта запроса
Перед отправкой трафика определите метаданные, которые сопровождают каждый запрос или появляются в соответствующей записи gateway. Минимальный конверт запроса может выглядеть так:
{
  "request_id": "gw_test_0001",
  "environment": "staging",
  "workload": "support_ticket_classification",
  "requested_route": "ticket-classifier-v1",
  "customer_tier": "internal-test",
  "contains_sensitive_data": false,
  "timeout_ms": 12000,
  "max_attempts": 2,
  "evaluation_case_id": "ticket_014"
}
Ваш gateway может использовать заголовки, теги, поля метаданных или серверный контекст вместо именно этого JSON. Важная часть заключается в том, чтобы приложение, gateway и запись оценки использовали стабильную идентичность запроса.
Не помещайте в теги маршрутизации необработанные секреты, полные промпты, персональные данные или конфиденциальный текст клиента. Отделяйте операционные метаданные от содержимого. Если в нагрузке есть чувствительные данные, зафиксируйте классификацию и применяйте соответствующую политику логирования, а не копируйте содержимое в поля наблюдаемости.
Пакет 1: 40 обычных запросов
Используйте 40 репрезентативных входных данных, которые должны успешно пройти по основному маршруту. Включите простые, типовые и граничные случаи, а не повторяйте один демонстрационный промпт.
Для каждого запроса фиксируйте:
- прошел ли результат проверку, специфичную для задачи;
- gateway и upstream идентификаторы запросов;
- запрошенный alias и разрешенный provider/model;
- общую задержку и время до первого токена, если применимо;
- входные и выходные токены, если доступны;
- количество повторных попыток или fallback;
- оценочную стоимость;
- итоговое решение: принято, отклонено или на ручную проверку.
Цель не в идеальном результате. Цель в том, чтобы выяснить, являются ли сбои видимыми и объяснимыми. Отклоненный результат с полным трассированием полезнее, чем правдоподобный результат без записи о маршруте или использовании.
Пакет 2: 30 запросов на границах контракта
Используйте следующие 30 запросов, чтобы проверить именно те функции, от которых зависит ваше приложение. Выберите из:
- длинный контекст вблизи вашего утвержденного лимита входа;
- строгий JSON или вывод, ограниченный схемой;
- начало стриминга, отмена и завершение;
- вызовы инструментов с корректными и некорректными аргументами;
- входные данные в виде изображения, аудио или документа, если рабочая нагрузка их использует;
- многоязычные промпты;
- пустые, некорректно сформированные или слишком большие запросы;
- контент, который должен быть отклонен политикой приложения.
Не предполагайте, что OpenAI-совместимый endpoint делает все граничные сценарии идентичными. Gateway пропускает этот пакет только тогда, когда ваше приложение может корректно потребить ответ и классифицировать неподдерживаемое поведение, не повреждая рабочий процесс незаметно.
Пакет 3: 30 контролируемых запросов с отказом
Используйте непродакшен-среду, чтобы протестировать поведение при ограниченных сбоях. Включите безопасные случаи, такие как:
- некорректное имя модели или маршрута;
- отсутствующий или отозванный учетный данные для разработки;
- умышленно маленький тайм-аут;
- условие квоты или ограничения частоты запросов для разработки;
- одну имитированную повторно обрабатываемую ошибку upstream;
- один кандидат для fallback, который намеренно несовместим с контрактом задачи.
Последний случай важен. Gateway не должен перенаправлять запрос только потому, что доступна другая модель. Если альтернативный маршрут не может сохранить структурированный вывод, поведение инструментов, политику данных или требования к качеству, правильное действие — остановиться и вернуть классифицированную ошибку.
Для более глубокой политики обработки сбоев используйте рабочую инструкцию по стратегии fallback для model fallback strategy workflow playbook и руководство по rate limits LLM.
Ведите журнал приемки: одна строка на один запрос
Можно начать с таблицы или базы данных. Избегайте дашборда, который скрывает базовые случаи, пока вы их не поймете.
| Поле | Что оно вам сообщает |
|---|---|
| Request ID | Связывает доказательства приложения, gateway и upstream |
| Evaluation case | Показывает, какие входные данные и ожидаемое поведение были протестированы |
| Requested route | Фиксирует, что запросило приложение |
| Resolved route | Показывает поставщика и модель, которые фактически обслужили запрос |
| Validation result | Отделяет полезные завершения от успешного ответа на уровне HTTP |
| Error class | Различает случаи stop, retry, reroute и reconciliation |
| Attempts | Показывает скрытое усиление повторных попыток |
| Latency | Подтверждает, что нагрузка укладывается в пользовательский бюджет |
| Estimated cost | Поддерживает сравнение по принятому результату |
| Rollback needed | Выявляет случаи, которые заблокировали бы расширение в продакшен |
Рассчитайте как минимум четыре сводные метрики после 100 запросов:
accepted completion rate = accepted results / total requests

trace coverage = requests with complete route and request IDs / total requests

retry amplification = total upstream attempts / total gateway requests

cost per accepted result = total estimated cost / accepted results
Не сравнивайте gateway только по цене одного запроса. Дешевый запрос, который не проходит валидацию, запускает повторные попытки или требует ручного исправления, может оказаться дороже, чем более дорогой запрос, который корректно завершает задачу.
Используйте явные критерии выхода в продакшен
Перед началом лабораторных испытаний отметьте каждый критерий как обязательный, необязательный или неприменимый. Затем принимайте решение на основе доказательств, а не энтузиазма.
| Критерий выхода | Пример базового правила для новичков |
|---|---|
| Совместимость контракта | Каждое обязательное поле ответа и функция проходят проверку |
| Принятое завершение | Нет существенной регрессии по сравнению с базовой интеграцией с прямым провайдером |
| Трассируемость | Каждый запрос имеет идентификатор приложения и идентификатор запроса шлюза |
| Видимость маршрута | Определённый провайдер/модель доступны для каждого завершённого запроса |
| Классификация сбоев | Ожидаемые сбои сопоставляются с действиями stop, retry, reroute или reconcile |
| Бюджет повторных попыток | Ни один запрос не превышает заявленный бюджет попыток или задержки |
| Логирование чувствительных данных | Сырой контент отключён, если только он не утверждён и не управляется отдельно |
| Видимость затрат | Можно рассчитать стоимость за принятый результат |
| Откат | Прямой маршрут можно восстановить без переписывания кода |
Используйте один из трёх результатов:
- Go: все обязательные критерии пройдены; перенесите одну низкорисковую нагрузку на небольшой canary.
- Fix: шлюз жизнеспособен, но выявленный разрыв в совместимости, телеметрии, безопасности или политике обработки сбоев блокирует продакшен.
- Stop: слой добавляет риск или операционную нагрузку, не решая текущую измеримую проблему.
Лабораторная работа считается завершённой только тогда, когда кто-то владеет решением, доказательства сохранены, а путь отката остаётся доступным. Так фраза «мы подключились к LLM gateway» превращается в воспроизводимый инженерный результат.
Семь основных задач LLM gateway
1. Абстракция провайдера
Шлюз создаёт стабильную границу между кодом приложения и API провайдера. Это уменьшает число повторяющихся интеграций и упрощает тестирование миграций.
2. Аутентификация и управление ключами
Приложения проходят аутентификацию через шлюз, а учётные данные провайдера остаются за ним. Это может уменьшить количество upstream-секретов, распространяемых по репозиториям и средам развёртывания. Это не отменяет необходимость ротации, ограничения областей доступа, редактирования и реагирования на инциденты. Следуйте отдельному руководству по безопасному управлению API-ключами.
3. Маршрутизация моделей
Маршрутизация может быть такой простой, как «отправить этот alias в эту модель». Более продвинутые политики могут использовать возможности, состояние, задержку, регион или стоимость. Делайте решение объяснимым: каждый запрос должен фиксировать, почему был выбран тот или иной маршрут.
4. Управление надёжностью
Шлюз может централизовать таймауты, бюджеты повторных попыток, circuit breaker'ы, проверки здоровья и безопасные fallback'и. Централизация предотвращает ситуацию, когда каждая команда приложения придумывает свою собственную политику обработки сбоев.
5. Координация ограничений скорости
Провайдеры обычно ограничивают запросы и токены во времени. Шлюз может координировать параллелизм, очереди, backoff и пропускную способность маршрута вместо того, чтобы позволять нескольким сервисам вслепую конкурировать за одну и ту же upstream-квоту.
6. Наблюдаемость и распределение затрат
Шлюз видит каждый запрос, поэтому это естественное место для добавления согласованной телеметрии. Измеряйте не только сырой расход токенов. Отслеживайте долю принятых задач, задержку, повторы и стоимость на одну принятую задачу, чтобы дешевый, но ненадежный маршрут не выглядел эффективным.
Руководство по оптимизации затрат на AI API объясняет, как сравнивать маршруты, опираясь на результаты рабочей нагрузки, а не только на прайс-лист.
7. Политика и управление
Команды могут использовать шлюз, чтобы ограничивать модели, устанавливать бюджеты, задавать верхний предел использования токенов, разделять ключи для разработки и продакшена, а также создавать готовые к аудиту записи об использовании. Эти механизмы становятся все полезнее по мере того, как все больше приложений и агентов используют один и тот же слой доступа к моделям.
LLM Gateway vs. Similar Tools
Новички часто используют «gateway», «router», «orchestration framework» и «reverse proxy» как взаимозаменяемые термины. Они пересекаются, но это не одно и то же.
| Tool | Primary job | What it usually does not own |
|---|---|---|
| LLM gateway | Доступ, политика, маршрутизация, надежность и телеметрия для вызовов моделей | Полный рабочий процесс приложения |
| Model router | Выбор модели или upstream-маршрута | Аутентификацию, биллинг, управление или полную наблюдаемость, если это не входит в комплект |
| Orchestration framework | Координация промптов, инструментов, памяти, агентов и многошаговых рабочих процессов | Учетную запись центрального провайдера и контроль биллинга по умолчанию |
| Reverse proxy | Передача сетевого трафика, завершение TLS и применение общих HTTP-ограничений | Ограничения токенов с учетом модели, контракты fallback или учет использования AI по умолчанию |
| Provider SDK | Вызов API одного провайдера с нативными для провайдера возможностями | Кросс-провайдерную маршрутизацию и унифицированные механизмы контроля |
Вы можете сочетать эти уровни. Фреймворк агентов может вызывать LLM-шлюз. Шлюз может использовать роутер внутри. Перед шлюзом может находиться reverse proxy для сетевого контроля.
Когда вам нужен LLM Gateway?
Используйте это руководство для начинающих по LLM gateway как тест принятия решения. Шлюз стоит рассмотреть, когда верны два или более из этих утверждений:
- Вы поддерживаете более одного провайдера моделей.
- Несколько сервисов или агентов нуждаются в доступе к моделям.
- Ключи провайдеров дублируются между окружениями.
- Команды не могут ответить, какое приложение сформировало списание.
- Обработка rate-limit отличается между кодовыми базами.
- Сбой провайдера или деградировавший маршрут прерывает критический рабочий процесс.
- Вам нужны allowlist моделей, квоты или бюджеты на уровне окружения.
- Для переключения моделей требуются повторные изменения SDK или деплоя.
- Операциям нужен один request ID на уровнях приложения и провайдера.
Возможно, вам пока не нужен шлюз, если у вас есть один низкорисковый прототип, один провайдер, один владелец и нет требований к надежности или управлению в продакшене. Начните с прямого доступа, но держите вызовы провайдера за небольшим адаптером приложения, чтобы будущая миграция была контролируемой.
Сделать или купить LLM Gateway: практическая таблица оценки
Самый важный вопрос для бизнес-оценки — не в том, полезен ли шлюз. Вопрос в том, какие части ваша команда должна владеть. Вы можете построить шлюз, использовать hosted-сервис, запустить open-source proxy или комбинировать эти варианты.
Используйте взвешенную таблицу оценки вместо выбора по списку функций. Оценивайте каждый вариант от 1 до 5, умножайте на вес и сравнивайте итоговые суммы. Приведённые ниже веса — это отправные точки, а не универсальные правила.
| Критерий | Рекомендуемый вес | Вопросы для оценки |
|---|---|---|
| Совместимость с рабочими нагрузками | 25% | Сохраняет ли он streaming, структурированный вывод, tools, изображения, детали ошибок и учёт токенов? |
| Надёжность | 20% | Явно ли заданы таймауты, retries, проверки состояния, правила fallback и видимость инцидентов? |
| Безопасность и governance | 15% | Можно ли изолировать tenants, ограничивать модели, ротировать credentials, редактировать содержимое и аудитировать доступ? |
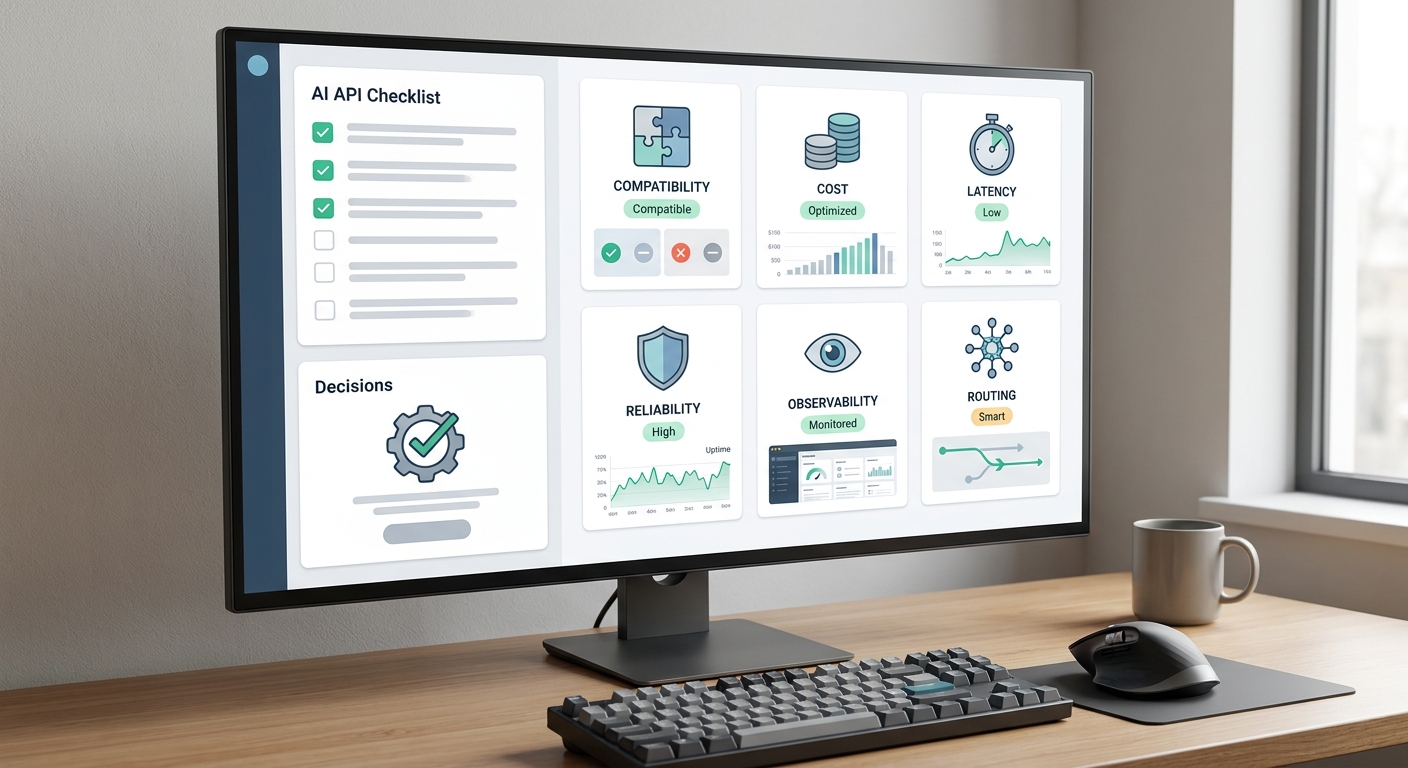
| Наблюдаемость | 15% | Можно ли отследить запрошенный маршрут, определённый маршрут, попытки, задержку, usage, валидацию и cost? |
| Операционная нагрузка | 10% | Кто занимается обновлениями, изменениями provider, масштабированием, on-call реагированием и хранением данных? |
| Коммерческое соответствие | 10% | Понятен ли billing, можно ли его экспортировать, атрибутировать и совместим ли он с вашим ожидаемым профилем использования? |
| Путь выхода | 5% | Можно ли экспортировать конфигурацию и telemetry, сохранить контракты приложения и переключиться без переписывания? |
Стройте, когда контроль — это продукт
Разработка может быть рациональной, когда поведение маршрутизации является ключевым конкурентным преимуществом, когда regulations требуют модели развертывания, которую доступные сервисы не могут обеспечить, или когда масштаб вашего трафика оправдывает выделенную platform team. Но «build» включает больше, чем простую пересылку HTTP-запросов. Это означает владение аутентификацией, адаптерами provider, различиями схем, streaming, нормализацией ошибок, quotas, observability, управлением релизами, проверками безопасности и реагированием на инциденты.
Покупайте, когда доступ и операции не являются дифференцирующими
Hosted gateway обычно лучше подходит, когда цель — быстрее подключиться к нескольким provider, консолидировать billing и credentials или дать нескольким приложениям общий control plane. Оценка по-прежнему должна включать путь выхода. Держите gateway за application adapter, сохраняйте тесты возможностей моделей и не встраивайте специфичные для provider предположения во весь product code.
Используйте open source, когда вы можете это обслуживать
Open-source gateway или proxy могут дать гибкость и прозрачность кода, но self-hosting перекладывает на вашу команду ответственность за availability, scaling, обновления, хранение telemetry и установку security patching. Сравнивайте общую операционную нагрузку, а не только лицензию на software.
Четырёхэтапное внедрение LLM Gateway
Безопасное внедрение доказывает по одному слою за раз. Не начинайте с dynamic cost routing для всех рабочих нагрузок.
Этап 1: Shadow-тест совместимости
Отправьте репрезентативный набор для оценки через кандидатный шлюз, не изменяя поведение продакшена. Проверьте поля запроса, ответы, потоковую передачу, вызовы инструментов, структурированные выходные данные, поля использования и ошибки. Зафиксируйте каждое несоответствие. Успешного HTTP-ответа недостаточно, если меняется контракт приложения.
Условие выхода: шлюз проходит обязательные для рабочей нагрузки функции и проверки качества без необъяснимой потери контракта.
Этап 2: Одна низкорисковая рабочая нагрузка
Перенесите обратимую, некритичную рабочую нагрузку на один явно заданный маршрут модели. Сохраните прежний прямой путь к провайдеру доступным как вариант отката. Добавьте идентификаторы запросов и телеметрию разрешённого маршрута до добавления повторных попыток или fallback.
Условие выхода: команда может объяснить каждый неудачный запрос, сопоставить использование и выполнить откат без релиза кода.
Этап 3: Политика надёжности
Добавьте ограниченный таймаут, классификацию повторных попыток и один протестированный fallback для режима отказа, который вы действительно наблюдали. Не выполняйте fallback между моделями только потому, что обе принимают похожий JSON. Альтернативный маршрут должен соответствовать тому же контракту рабочей нагрузки.
Для более глубокого проектирования восстановления используйте playbook стратегии model fallback и руководство по лимитам скорости LLM.
Условие выхода: учения по отказам показывают, что повторные попытки и fallback улучшают долю принятых завершений, не вызывая дублирующихся побочных эффектов, неконтролируемого роста задержки или неконтролируемых расходов.
Этап 4: Общая производственная control plane
Расширяйте только после того, как у первой рабочей нагрузки появятся стабильные измерения. Добавьте квоты арендаторов, allowlist моделей, разделение окружений, предупреждения по бюджету и документированный процесс изменения маршрутов. Проверьте, кто может изменять политику и как аудируются изменения.
Условие выхода: несколько приложений могут использовать шлюз без потери атрибуции затрат, прослеживаемости инцидентов, границ безопасности или контроля отката.
Карта ошибок для начинающих: повторить, перенаправить или остановиться?
Надёжность шлюза зависит не столько от числа резервных моделей, сколько от правильного решения для каждого сбоя. Используйте эту упрощённую карту как отправную точку.
| Сбой | Типичное значение | Действие для начинающего |
|---|---|---|
| 400 или ошибка валидации | Контракт запроса недействителен или не поддерживается | Остановитесь, исправьте запрос и не повторяйте его без изменений |
| 401 или 403 | Проблема с учетными данными, разрешениями, allowlist моделей или аккаунтом | Остановитесь и сообщите об этом; никогда не переключайтесь случайным образом между ключами |
| 404 модель или маршрут | Настроенный идентификатор недоступен или указан неверно | Остановитесь или используйте явно одобренный эквивалентный маршрут |
| 408 или тайм-аут клиента | Истек допустимый бюджет задержки вызывающей стороны | Отмените, если возможно; повторяйте только когда задача идемпотентна |
| 429 ограничение по rate limit | Превышена пропускная способность или квота | Соблюдайте рекомендации по повтору, поставьте в очередь или используйте протестированный эквивалентный маршрут |
| 5xx до вывода | Gateway или upstream отказал до получения пригодного ответа | Используйте ограниченные повторы или протестированный failover |
| Поток прерывается в середине вывода | Частичный контент уже может существовать | Остановитесь и выполните сверку; не воспроизводите побочные эффекты вслепую |
| Вызов инструмента мог выполниться | Внешнее состояние могло измениться | Перед повторной попыткой проверьте idempotency key или состояние инструмента |
Слово bounded имеет значение. Каждый рабочий процесс нуждается в максимальном числе повторов, общем бюджете времени и конечном состоянии. Иначе gateway может превратить один инцидент у провайдера в дублирующиеся действия инструмента, неконтролируемый рост затрат и более серьезный сбой.
Для более глубокой реализации используйте playbook по стратегии fallback для моделей.
Как измерить, работает ли gateway
Успех gateway — это не количество подключенных провайдеров. Это улучшение доли принятых результатов и операционного контроля.
| Метрика | Что она показывает | Расчет, подходящий для начинающих |
|---|---|---|
| Доля завершений с принятым результатом | Получают ли пользователи пригодные результаты | принятые результаты ÷ запуски workflow |
| Доля сбоев, связанных с gateway | Создает ли новый слой сбои | сбои gateway ÷ запросы к gateway |
| p95 сквозной задержки | Ухудшают ли политика и failover пользовательский опыт | 95-й процентиль от старта приложения до принятого результата |
| Доля восстановления через fallback | Решает ли fallback реальные сбои | принятые результаты fallback ÷ попытки fallback |
| Стоимость за принятый результат | Приводят ли более дешевые вызовы к более дешевым результатам | общая стоимость модели и повторов ÷ принятые результаты |
| Объяснимость маршрута | Можно ли отследить инциденты и счета | запросы с полями requested и resolved route ÷ все запросы |
| Точность отклонения по политике | Блокирует ли governance нужный трафик | корректно отклоненные запросы ÷ проверенные отклонения |
Установите базовую линию до миграции. Затем сравните одну и ту же нагрузку, набор для оценки, сегмент трафика и временное окно. Если качество падает, задержка растет или затраты становится сложнее сверять, более низкая заявленная цена за токен не является успешным результатом gateway.
Для анализа затрат продолжайте с руководством по оптимизации затрат на AI API. Для более полного плана телеметрии используйте чек-лист внедрения AI observability.
Реализация для начинающих: пять практических шагов
Шаг 1: Составьте контракт задачи
Выберите одну реальную нагрузку, например суммирование обращений в поддержку или извлечение полей из счетов. Определите:
- обязательные входные и выходные данные;
- допустимую задержку;
- правила валидации;
- требуется ли потоковая передача;
- могут ли инструменты создавать побочные эффекты;
- что считается принятым результатом.
Этот контракт определяет, безопасен ли fallback и действительно ли другой моделью можно заменить текущую.
Шаг 2: Выберите стабильный клиентский интерфейс
Если ваше приложение уже использует SDK, совместимый с OpenAI, совместимый gateway может сократить объем работ по миграции. Flatkey, например, документирует базовый URL, совместимый с OpenAI, по адресу https://router.flatkey.ai/v1.
curl -X POST "https://router.flatkey.ai/v1/chat/completions" \
  -H "Authorization: Bearer $FLATKEY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "your-model",
    "messages": [
      {"role": "user", "content": "Объясни эту ошибку простыми словами."}
    ]
  }'
Используйте менеджер секретов или серверную переменную окружения для ключа. Никогда не встраивайте его в код браузера или мобильного клиента.
Шаг 3: Начните с явной маршрутизации
Направьте нагрузку на одну протестированную модель. Если вам нужна независимость приложения, сопоставьте внутренний alias с этой моделью в конфигурации. Избегайте непрозрачного маршрутизатора «самая дешевая модель» или «лучшая модель», пока у вас не появится воспроизводимый набор оценок.
Шаг 4: Добавьте минимально необходимую телеметрию
Записывайте:
- request ID gateway;
- нагрузку и окружение;
- запрошенный alias;
- определенного провайдера и модель;
- статус и задержку;
- количество повторных попыток и fallback;
- токены входа и выхода;
- оценочную стоимость;
- результат валидации.
Этого достаточно, чтобы отладить первые проблемы в продакшене и позже сравнить альтернативы.
Шаг 5: Добавьте одну ограниченную политику отказов
Начните с таймаута и небольшого бюджета на повторные попытки для временных сбоев. Добавляйте fallback только после проверки, что альтернативный маршрут проходит тот же контракт задачи. Для потоковой передачи или вызовов инструментов с побочными эффектами определите, как приложение обнаруживает частичное выполнение и согласует состояние.
Первая неделя с LLM Gateway
Используйте семидневный план внедрения вместо того, чтобы сразу переводить все приложения.
День 1: Инвентаризируйте одну нагрузку
Запишите текущего провайдера, модель, SDK, учетные данные, требуемые функции, трафик, бюджет задержки, чувствительность данных и ответственного за rollback.
День 2: Запустите тест совместимости
Отправляйте репрезентативные промпты через прямой маршрут и маршрут через gateway. Включите длинные входные данные, структурированный вывод, стриминг, инструменты и ожидаемые случаи ошибок, если ваша рабочая нагрузка их использует.
День 3: Добавьте идентификатор запроса и записи об использовании
Убедитесь, что приложение сохраняет ID запроса gateway и может связывать его с моделью, маршрутом провайдера, задержкой, токенами, числом повторов и результатом валидации, не логируя по умолчанию чувствительный контент.
День 4: Определите политику отказов
Классифицируйте ошибки как stop, retry, equivalent failover, cross-model fallback и manual reconciliation. Задайте общий бюджет на повторы и задержку.
День 5: Отправьте небольшой production-canary
Используйте одну низкорисковую рабочую нагрузку и намеренно маленькую долю трафика. Оставьте прямой маршрут доступным. Сравните долю принятых completion, p95 latency и стоимость на один принятый результат.
День 6: Проверьте контроль безопасности и расходов
Разделите учетные данные для разработки и production, ограничьте разрешенные модели, задайте квоты и проверьте, кто может просматривать или изменять политику маршрутизации. Используйте руководство по безопасному управлению API-ключами для более полного контрольного списка.
День 7: Примите решение go, fix или stop
- Go: необходимые проверки контрактов пройдены, а canary достигает порогов приемки.
- Fix: архитектура корректна, но один измеримый пробел блокирует расширение.
- Stop: gateway добавляет операционный риск или стоимость без текущей пользы с точки зрения контроля.
Документируйте решение и дату следующего пересмотра. Контролируемый stop лучше, чем миграция без измерений.
Распространенные ошибки новичков
Считать все модели взаимозаменяемыми
Даже когда синтаксис запросов унифицирован, возможности и поведение вывода различаются. Тестируйте именно те функции, которые использует ваша рабочая нагрузка.
Маршрутизация до измерения
Динамическая маршрутизация без данных оценки переносит логику принятия решений в черный ящик. Сначала установите базовый уровень, затем внедрите измеримую политику.
Повторять каждую ошибку
Ошибки аутентификации, неверные запросы, исчерпанные бюджеты и неподдерживаемые функции не являются временными. Повторяйте только те ошибки, которые могут быть успешными позже, и при необходимости используйте экспоненциальный backoff с jitter.
Логировать чувствительный контент по умолчанию
Промпты могут содержать данные клиентов, исходный код или бизнес-данные. Разделяйте наблюдаемость метаданных и хранение контента.
Скрывать фактически выбранный маршрут
Если приложение запрашивает псевдоним, фиксируйте фактического провайдера и используемую модель. Иначе инциденты, регрессии качества и изменения стоимости будет трудно объяснить.
Измерять цену вместо результатов
Более низкая цена за токен не гарантирует более низкую стоимость рабочей нагрузки. Включайте ошибки валидации и повторы в расчет стоимости.
Как Flatkey вписывается в паттерн gateway
Flatkey предоставляет унифицированный уровень доступа к моделям и инструментам с одним ключом, общими журналами использования и endpoint для моделей, совместимый с OpenAI. Для уже существующего совместимого клиента путь миграции заключается в том, чтобы изменить базовый URL, использовать ключ Flatkey, выбрать поддерживаемую модель и протестировать контракт рабочей нагрузки.
Это делает Flatkey актуальным, когда вы хотите сократить расползание аккаунтов у провайдеров, не строя и не эксплуатируя слой агрегации самостоятельно. Если вы оцениваете дизайн, а не ищете обзор для начинающих, прочитайте подробное руководство по архитектуре AI API gateway. Если вы готовы мигрировать клиент, используйте чек-лист OpenAI-compatible API gateway.
Изучите модели Flatkey, ознакомьтесь с документацией или создайте API-ключ, когда будете готовы протестировать реальную рабочую нагрузку.
Контрольный список руководства для начинающих по LLM Gateway
Перед отправкой production-трафика через LLM gateway убедитесь в следующем:
- [ ] У одного контракта рабочей нагрузки определены критерии успеха.
- [ ] В приложении используется серверный учетный credential для gateway.
- [ ] Выбранная модель прошла тесты на репрезентативных данных.
- [ ] Структурированный вывод, инструменты и потоковая передача были протестированы, если используются.
- [ ] Тайм-ауты и ошибки, подлежащие повторной попытке, явно определены.
- [ ] Резервный вариант сохраняет контракт рабочей нагрузки.
- [ ] Каждый запрос получает отслеживаемый ID запроса.
- [ ] Зафиксированы разрешенный провайдер и модель.
- [ ] Измеряются токены, задержка, повторы, валидация и стоимость.
- [ ] Разделены квоты для разработки и production.
- [ ] Логирование необработанного контента отключено или намеренно регулируется.
- [ ] Документирован прямой путь отката.
- [ ] Существует базовый ориентир для принятого завершения, задержки и стоимости на одно принятое результат.
- [ ] Build, hosted и self-hosted варианты сравнивались по операционной нагрузке и пути выхода.
- [ ] Первый rollout использует один явный маршрут до внедрения динамической маршрутизации.
Часто задаваемые вопросы
LLM gateway — это то же самое, что и API gateway?
Это специализированный API gateway для трафика AI-моделей. Он может предоставлять стандартные функции API gateway, такие как аутентификация и rate limiting, а также маршрутизацию с учетом модели, использование токенов, нормализацию ошибок, специфичных для AI, и fallback с учетом контракта.
LLM gateway размещает модели?
Не обязательно. Некоторые gateway маршрутизируют запросы к внешним провайдерам, некоторые интегрированы с инфраструктурой inference, а некоторые поддерживают оба варианта. Уточните, где выполняется inference, какой провайдер фактически обслуживает каждую модель и как этот маршрут отображается в журналах использования.
LLM gateway снижает затраты?
Он может помочь за счет централизации данных об использовании, применения квот, сокращения дублирующихся интеграций и возможности измеряемых изменений маршрутизации. Экономия не возникает автоматически. Сравнивайте стоимость на одну принятую задачу, включая повторы и сбои качества.
Могу ли я использовать LLM gateway с OpenAI SDK?
Да, если шлюз предоставляет endpoint, совместимый с OpenAI, и поддерживает функции, которые использует ваше приложение. Измените base URL и учетные данные, затем протестируйте полный контракт рабочей нагрузки, а не предполагаемую идеальную совместимость.
Является ли шлюз единой точкой отказа?
Может быть. Оцените его архитектуру развертывания, проверки состояния, отказоустойчивое переключение на upstream, поведение таймаутов, наблюдаемость, обязательства по уровню сервиса и путь отката. Централизация управления повышает операционную эффективность, поэтому сам шлюз следует рассматривать как production-инфраструктуру.
Должен ли стартап создавать LLM gateway самостоятельно или покупать его?
Создавайте, когда поведение gateway является ключевым отличием, вам нужны необычные ограничения развертывания или у вас есть команда для его эксплуатации. Покупайте, когда главная цель — более быстрый доступ, меньше интеграций с провайдерами, единообразное использование и общие механизмы контроля. Небольшая команда также может начать напрямую и мигрировать позже, если вызовы к провайдерам уже изолированы за adapter.
Что следует протестировать перед переводом production-трафика?
Проверьте точный контракт рабочей нагрузки: streaming, структурированный вывод, tools, входные медиа, ограничения контекста, поведение при ошибках, обработку таймаутов, поля использования и качество вывода. Затем запустите малорисковый canary с прямым путем отката и сравните принятый completion, p95 latency и стоимость за принятый результат с базовым уровнем до внедрения gateway.
Простая ментальная модель
Самая короткая версия этого руководства для начинающих по LLM gateway такова:
Ваше приложение запрашивает выполнение задач с помощью ИИ. Gateway решает, разрешен ли запрос, куда его следует направить, как обрабатывать сбой и что нужно зафиксировать.
Начните с одной рабочей нагрузки, одного стабильного интерфейса, явной маршрутизации, минимально необходимой телеметрии и одной ограниченной политики отказов. Добавляйте сложную маршрутизацию только после того, как сможете измерять качество, latency, надежность и стоимость.