Guía para principiantes de LLM Gateway: de la primera solicitud a producción
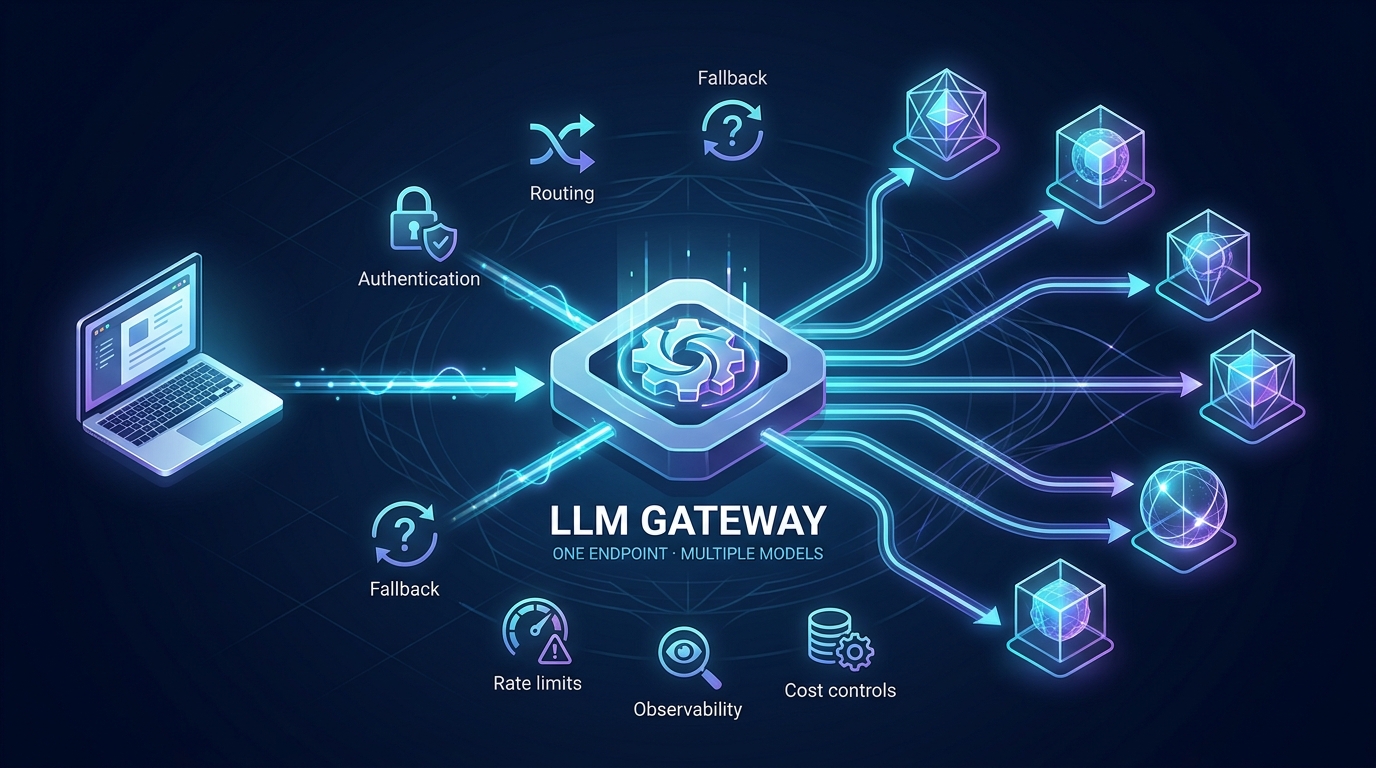
Un LLM gateway es una capa de control entre tu aplicación y uno o más proveedores de modelos de IA. Tu app envía solicitudes al gateway en lugar de conectarse por separado a cada proveedor. Luego, el gateway autentica la solicitud, aplica políticas, elige un modelo o una conexión upstream, reenvía la llamada y registra el resultado.
Eso suena como una infraestructura de API ordinaria, pero resuelve un problema que aparece rápidamente en productos de IA reales: la primera integración con un modelo es simple; la quinta, no. Cada proveedor puede introducir otra clave, SDK, formato de solicitud, política de límite de tasa, formato de error, página de uso y factura.
Esta guía para principiantes de LLM gateway explica qué hace esta capa, cómo se mueve una solicitud a través de ella, en qué se diferencia de herramientas cercanas, cuándo la necesitas y cómo implementar una primera integración con un gateway sin sobrediseñarla. También te ofrece una matriz de decisión entre construir o comprar, un plan de despliegue por etapas y criterios de aceptación medibles para decidir si un gateway está creando valor empresarial real.
Actualizado el 4 de agosto de 2026: Esta guía ahora incluye un laboratorio de las primeras 100 solicitudes con un sobre de solicitud, tres lotes de prueba, un registro de aceptación y criterios de salida a producción, junto con la guía rápida de 15 minutos y la lista de verificación de despliegue.
La decisión para principiantes en 60 segundos
Probablemente aún no necesitas un LLM gateway si una aplicación llama a un proveedor, la carga de trabajo sigue siendo experimental y una breve caída o la rotación manual de claves no afectarían a los clientes.
Deberías evaluar un gateway cuando dos o más de estas afirmaciones sean verdaderas:
- tu aplicación usa, o espera usar, más de un proveedor de modelos;
- varios servicios necesitan credenciales de IA y controles de uso;
- los límites de tasa o incidentes del proveedor pueden interrumpir el flujo de trabajo de un cliente;
- finanzas no puede conciliar el gasto en modelos con un equipo, producto o cliente;
- cambiar de modelo requiere un despliegue de la aplicación;
- necesitas una allowlist compartida, cuotas, una auditoría o una política de fallback;
- los desarrolladores están reconstruyendo los mismos adaptadores de proveedor en varios repositorios.
El error de principiante es adoptar un gateway porque el diagrama de arquitectura parece maduro. Adóptalo cuando elimine trabajo operativo repetido o cree un control que puedas medir.
¿Qué es un LLM gateway?
Un LLM gateway, también llamado LLM API gateway o AI gateway, ofrece a las aplicaciones una interfaz estable para acceder a modelos de IA. En su forma más simple, proporciona:
- un único endpoint para solicitudes de modelos;
- un único perímetro de autenticación;
- un contrato coherente de solicitud y respuesta;
- registros centralizados de uso;
- reglas de enrutamiento que deciden a dónde va una solicitud.
Un gateway más capaz también puede aplicar presupuestos, restringir los modelos permitidos, gestionar reintentos limitados, hacer failover entre rutas equivalentes, adjuntar identificadores de solicitud, normalizar errores y emitir telemetría de latencia, tokens y coste.
La idea importante en esta guía para principiantes de LLM gateway es la separación de responsabilidades. El código de tu producto debe describir el trabajo que necesita realizar. El gateway debe encargarse del acceso al proveedor, la política de enrutamiento y los controles operativos.
Application
    │
    │ one authenticated request
    ▼
LLM gateway
    ├── policy and quota check
    ├── model or route selection
    ├── provider request
    ├── retry or safe fallback
    └── usage and error record
             │
             ├── Provider A / Model 1
             ├── Provider B / Model 2
             └── Provider C / Model 3
¿Por qué no llamar directamente a cada proveedor de modelos?
La integración directa suele ser el punto de partida correcto. Si un prototipo usa un solo modelo, tiene poco tráfico y no necesita controles compartidos, añadir un gateway puede crear más superficie que valor.
La compensación cambia cuando la aplicación necesita varios proveedores o debe operar de forma fiable en producción.
| Concern | Direct provider integrations | LLM gateway |
|---|---|---|
| Credentials | Separate keys in each environment | One application-facing key or identity |
| Client code | Provider-specific clients and adapters | Stable client contract where supported |
| Model switching | Application change or configuration per provider | Central route or model policy change |
| Rate limits | Handled separately for each provider | Coordinated limits, queues, and retry policy |
| Usage tracking | Split across provider dashboards | Central request, token, latency, and cost records |
| Failover | Custom logic in each application | Shared, contract-aware fallback policy |
| Governance | Repeated in every service | Central model allowlists, quotas, and audit fields |
El gateway no hace desaparecer las diferencias entre proveedores. Los modelos aún pueden tener diferentes capacidades, límites de contexto, esquemas de herramientas, comportamiento de streaming, políticas de seguridad y precios. Un buen gateway hace que esas diferencias sean explícitas y manejables en lugar de fingir que todos los modelos son intercambiables.
Cómo funciona un gateway de LLM, paso a paso
1. La aplicación envía una solicitud
La aplicación llama a una URL base estable y proporciona una credencial del gateway. Con un gateway compatible con OpenAI, un cliente OpenAI existente puede necesitar solo un base_url, una clave de API y un identificador de modelo diferentes.
2. El gateway la autentica y autoriza
El gateway verifica el proyecto, entorno, usuario o carga de trabajo que realiza la llamada. Luego puede comprobar una lista permitida, cuota, presupuesto o política de tokens máximos antes de que ocurra cualquier gasto upstream.
3. Una regla de enrutamiento elige el destino
La solicitud puede nombrar un modelo exacto. Puede usar un alias controlado por el equipo, como support-fast. O puede entrar en una política de enrutamiento que considere capacidad, estado, región, latencia o coste.
Para una primera implementación, prefiera una selección explícita del modelo o un alias sencillo. El enrutamiento dinámico es útil, pero debería venir después de contar con datos de evaluación y observabilidad.
4. El gateway solo traduce lo que puede preservar
Algunos gateways exponen un contrato compatible con OpenAI a través de múltiples proveedores. El gateway asigna campos a la API del proveedor seleccionado y normaliza la respuesta cuando es posible.
La compatibilidad tiene límites. Antes de cambiar de modelo, pruebe la salida estructurada, la llamada a herramientas, las imágenes, el streaming, los motivos de finalización, la contabilización de tokens y el comportamiento ante errores. “Compatible” debería significar que el contrato que necesita superó las pruebas, no simplemente que la solicitud devolvió HTTP 200.
5. El gateway gestiona la política operativa
El gateway puede aplicar un tiempo de espera, respetar un presupuesto de reintentos, pausar una ruta no saludable o elegir un fallback. Los reintentos deben estar acotados. Los fallbacks deben preservar el contrato de la tarea. Las solicitudes con efectos secundarios de herramientas o salida transmitida parcialmente pueden requerir una ruta de detener y reconciliar en lugar de una repetición automática.
Para un diseño de producción más profundo, use el playbook de estrategia de fallback de modelo y la guía de límites de tasa de LLM.
6. El gateway registra lo que sucedió
Los registros útiles incluyen un ID de solicitud, la aplicación, el entorno, el modelo solicitado, el proveedor y modelo resueltos, la latencia, el estado, el número de reintentos, los tokens de entrada y salida, y el costo estimado.
No registre prompts y respuestas sin procesar por defecto. Registre metadatos que respalden las operaciones, y trate el registro de contenido como una decisión aparte de seguridad y privacidad.
Inicio rápido de 15 minutos de LLM Gateway
La forma más rápida de entender un gateway es enrutar a través de él una solicitud no crítica. Use un script de prueba del lado del servidor, un modelo explícito y un prompt con un resultado esperado obvio. No empiece con enrutamiento automático ni con un agente de producción.
Paso 1: Registre la línea base del proveedor directo
Antes de cambiar nada, guarde cinco datos de la llamada directa actual:
- si la respuesta satisface la tarea;
- la latencia total y el tiempo hasta el primer token si hay streaming;
- los recuentos de tokens de entrada y salida;
- el ID de solicitud del proveedor y la forma del error;
- el costo estimado del resultado aceptado.
Esto le da algo concreto con lo que comparar. Una migración al gateway no es exitosa simplemente porque devuelve HTTP 200.
Paso 2: Cambie la conexión, no la carga de trabajo
Para un gateway compatible con OpenAI, el cambio visible para la aplicación suele ser una clave API del gateway, una URL base del gateway y un identificador de modelo compatible. Los nombres exactos de las variables de entorno dependen del cliente y del gateway.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["LLM_GATEWAY_API_KEY"],
    base_url=os.environ["LLM_GATEWAY_BASE_URL"],
)

response = client.chat.completions.create(
    model=os.environ["LLM_GATEWAY_MODEL"],
    messages=[
        {"role": "system", "content": "Return valid JSON only."},
        {"role": "user", "content": "Clasifica este ticket como facturación, error o función: Me cobraron dos veces."},
    ],
    temperature=0,
)

print(response.choices[0].message.content)
Mantén las credenciales en el servidor. Nunca coloques una clave maestra de gateway en JavaScript del navegador, un binario móvil, un repositorio público o una captura de pantalla compartida.
Paso 3: Compara el contrato de respuesta
Verifica más que la calidad del texto. Confirma los campos que tu aplicación realmente consume:
- el ID de respuesta y el nombre del modelo;
- el motivo de finalización;
- el uso de tokens;
- el orden de los eventos de streaming;
- el comportamiento de la salida estructurada;
- los identificadores y argumentos de las llamadas a herramientas;
- el estado HTTP y el cuerpo del error;
- el comportamiento de cancelación y tiempo de espera.
La compatibilidad con OpenAI reduce el trabajo de migración, pero no garantiza que todas las funciones del proveedor se comporten de forma idéntica. Prueba el contrato del que depende tu código.
Paso 4: Fuerza un fallo seguro
Usa un entorno de prueba para provocar un fallo predecible, como un nombre de modelo inválido, un tiempo de espera intencionadamente muy corto o una cuota de desarrollo. Verifica que el gateway devuelva un ID de solicitud rastreable y un error que tu aplicación pueda clasificar.
No pruebes una caída del proveedor creando una carga incontrolada en producción. El objetivo es demostrar que tu aplicación puede distinguir entre fallos de autenticación, límite de tasa, tiempo de espera, upstream y validación.
Paso 5: Decide con una tabla de aceptación
| Check | Beginner acceptance rule |
|---|---|
| Output | Pasa la misma validación de la tarea que la llamada directa |
| Latency | Dentro del presupuesto declarado de la carga de trabajo |
| Usage | Los campos de tokens están presentes o la ausencia está documentada |
| Traceability | Un ID de solicitud conecta la app, el gateway y el registro upstream |
| Errors | La app puede clasificar fallos reintentables y no reintentables |
| Cost | Medido por resultado aceptado, no por solicitud bruta |
| Rollback | Volver a la ruta directa está documentado y probado |
Si el gateway falla cualquier fila requerida, mantén la prueba fuera de producción hasta que la brecha se corrija o se acepte explícitamente.
Tus primeras 100 solicitudes al gateway: un laboratorio para principiantes
Una primera solicitud exitosa demuestra conectividad. No demuestra que el gateway sea seguro para producción. El siguiente hito útil es un conjunto pequeño y controlado de 100 solicitudes representativas que pruebe la compatibilidad, la trazabilidad, el manejo de fallos y la disciplina operativa.
Este laboratorio es intencionalmente simple. No requiere enrutamiento dinámico, una plataforma de evaluación compleja ni una gran migración de producción. Le proporciona a un principiante suficiente evidencia para decidir si continuar, corregir una brecha específica o volver a la ruta directa del proveedor.
Comience con un sobre de solicitud
Antes de enviar tráfico, defina los metadatos que viajan con cada solicitud o aparecen en el registro correspondiente del gateway. Un sobre de solicitud mínimo puede verse así:
{
  "request_id": "gw_test_0001",
  "environment": "staging",
  "workload": "support_ticket_classification",
  "requested_route": "ticket-classifier-v1",
  "customer_tier": "internal-test",
  "contains_sensitive_data": false,
  "timeout_ms": 12000,
  "max_attempts": 2,
  "evaluation_case_id": "ticket_014"
}
Su gateway puede usar encabezados, etiquetas, campos de metadatos o contexto del lado del servidor en lugar de este JSON exacto. Lo importante es que la aplicación, el gateway y el registro de evaluación compartan una identidad de solicitud estable.
No coloque secretos sin procesar, prompts completos, datos personales o texto confidencial de clientes en las etiquetas de enrutamiento. Mantenga los metadatos operativos separados del contenido. Si la carga de trabajo contiene datos sensibles, registre la clasificación y aplique la política de registro adecuada en lugar de copiar el contenido en los campos de observabilidad.
Lote 1: 40 solicitudes normales
Utilice 40 entradas representativas que deberían tener éxito en la ruta principal. Incluya casos fáciles, típicos y de borde en lugar de repetir un solo prompt de demostración.
Para cada solicitud, registre:
- si la salida pasó la validación específica de la tarea;
- los IDs de solicitud del gateway y del upstream;
- el alias solicitado y el proveedor/modelo resuelto;
- la latencia total y el tiempo hasta el primer token, si corresponde;
- los tokens de entrada y salida cuando estén disponibles;
- el recuento de reintentos o fallback;
- el costo estimado;
- la resolución final: aceptada, rechazada o revisión manual.
El objetivo no es una puntuación perfecta. El objetivo es descubrir si los fallos son visibles y explicables. Una salida rechazada con un seguimiento completo es más útil que una salida plausible sin ruta ni registro de uso.
Lote 2: 30 solicitudes de borde de contrato
Use las siguientes 30 solicitudes para ejercitar las funciones exactas de las que depende su aplicación. Elija entre:
- contexto largo cerca de su límite de entrada aprobado;
- salida JSON estricta o restringida por esquema;
- inicio de streaming, cancelación y finalización;
- llamadas a herramientas con argumentos válidos e inválidos;
- entradas de imagen, audio o documento si la carga de trabajo las usa;
- prompts multilingües;
- solicitudes vacías, malformadas o demasiado grandes;
- contenido que debería ser rechazado por la política de la aplicación.
No asuma que un endpoint compatible con OpenAI hace que todos los comportamientos de borde sean idénticos. El gateway solo aprueba este lote cuando su aplicación puede consumir la respuesta correctamente y clasificar el comportamiento no compatible sin corromper silenciosamente el flujo de trabajo.
Lote 3: 30 solicitudes de fallo controlado
Use un entorno de no producción para probar el comportamiento de fallo acotado. Incluya casos seguros como:
- un nombre de modelo o ruta no válido;
- una credencial de desarrollo ausente o revocada;
- un tiempo de espera intencionadamente corto;
- una condición de cuota o límite de tasa de desarrollo;
- un error upstream simulable y recuperable;
- un candidato de fallback que sea deliberadamente incompatible con el contrato de la tarea.
Ese último caso importa. Un gateway no debe reencaminar simplemente porque haya otro modelo disponible. Si la ruta alternativa no puede preservar la salida estructurada, el comportamiento de herramientas, la política de datos o los requisitos de calidad, la acción correcta es detenerse y devolver un error clasificado.
Para una política de fallo más profunda, use el playbook del flujo de trabajo de la estrategia de fallback de modelos y la guía de límites de tasa de LLM.
Mantenga un registro de aceptación de una fila por solicitud
Puede empezar con una hoja de cálculo o una tabla de base de datos. Evite un panel que oculte los casos subyacentes antes de que los entienda.
| Field | What it tells you |
|---|---|
| Request ID | Conecta la aplicación, el gateway y la evidencia upstream |
| Evaluation case | Muestra qué entrada y comportamiento esperado se probaron |
| Requested route | Registra lo que la aplicación solicitó |
| Resolved route | Revela el proveedor y el modelo que realmente lo atendieron |
| Validation result | Separa las completaciones útiles del éxito a nivel HTTP |
| Error class | Distingue los casos de parada, reintento, reruteo y reconciliación |
| Attempts | Expone la amplificación oculta de reintentos |
| Latency | Confirma que la carga de trabajo se mantiene dentro de su presupuesto orientado al usuario |
| Estimated cost | Permite la comparación por resultado aceptado |
| Rollback needed | Identifica los casos que bloquearían la expansión a producción |
Calcule al menos cuatro métricas resumidas después de las 100 solicitudes:
accepted completion rate = accepted results / total requests

trace coverage = requests with complete route and request IDs / total requests

retry amplification = total upstream attempts / total gateway requests

cost per accepted result = total estimated cost / accepted results
No compare gateways solo por el precio bruto de la solicitud. Una solicitud barata que falla la validación, desencadena intentos repetidos o requiere reparación manual puede ser más cara que una solicitud con un precio más alto que completa la tarea correctamente.
Use criterios explícitos de salida a producción
Antes de que comience el laboratorio, marque cada criterio como obligatorio, opcional o no aplicable. Luego decida con evidencia en lugar de entusiasmo.
| Criterio de salida | Ejemplo de regla para principiantes |
|---|---|
| Compatibilidad de contrato | Cada campo de respuesta y característica requeridos pasa |
| Aceptación de la finalización | No hay una regresión material frente a la línea base del proveedor directo |
| Trazabilidad | Cada solicitud tiene un ID de aplicación y un ID de solicitud del gateway |
| Visibilidad de la ruta | El proveedor/modelo resuelto está disponible para cada solicitud completada |
| Clasificación de fallos | Los fallos esperados se asignan a detener, reintentar, redirigir o reconciliar |
| Presupuesto de reintentos | Ninguna solicitud supera el número declarado de intentos o el presupuesto de latencia |
| Registro sensible | El contenido sin procesar está desactivado salvo que se apruebe y gobierne por separado |
| Visibilidad de costos | Se puede calcular el costo por resultado aceptado |
| Reversión | La ruta directa se puede restaurar sin reescribir el código |
Usa uno de tres resultados:
- Seguir: todos los criterios requeridos pasan; mueve una carga de trabajo de bajo riesgo a un pequeño canario.
- Corregir: el gateway es viable, pero una brecha nombrada de compatibilidad, telemetría, seguridad o política de fallos bloquea producción.
- Detener: la capa añade riesgo o trabajo operativo sin resolver un problema actual y medible.
El laboratorio solo está completo cuando alguien asume la decisión, la evidencia se guarda y la ruta de reversión permanece disponible. Eso convierte “nos conectamos a un gateway de LLM” en un resultado de ingeniería repetible.
Las siete tareas principales de un gateway de LLM
1. Abstracción de proveedor
El gateway crea un límite estable entre el código de la aplicación y las API del proveedor. Esto reduce las integraciones repetidas y facilita probar las migraciones.
2. Autenticación y gestión de claves
Las aplicaciones se autentican en el gateway, mientras que las credenciales del proveedor permanecen detrás de él. Esto puede reducir el número de secretos de upstream distribuidos entre repositorios y entornos de despliegue. No elimina la necesidad de rotación, alcance, redacción y respuesta a incidentes. Sigue una guía dedicada de gestión segura de claves API.
3. Enrutamiento de modelos
El enrutamiento puede ser tan simple como “envía este alias a este modelo”. Las políticas más avanzadas pueden usar capacidad, estado, latencia, región o costo. Mantén la decisión explicable: cada solicitud debe registrar por qué se eligió una ruta.
4. Controles de fiabilidad
El gateway puede centralizar tiempos de espera, presupuestos de reintentos, circuit breakers, comprobaciones de estado y fallbacks seguros. La centralización evita que cada equipo de aplicación invente una política de fallos distinta.
5. Coordinación de límites de tasa
Los proveedores suelen limitar solicitudes y tokens a lo largo del tiempo. Un gateway puede coordinar la concurrencia, las colas, el backoff y la capacidad de enrutamiento en lugar de permitir que varios servicios compitan ciegamente por la misma cuota upstream.
6. Observabilidad y asignación de costos
La gateway ve todas las solicitudes, así que es un lugar natural para adjuntar telemetría coherente. Mide más que el costo bruto de tokens. Haz seguimiento de la tasa de tareas aceptadas, la latencia, los reintentos y el costo por tarea aceptada para que una ruta barata pero poco fiable no parezca eficiente.
La guía de optimización de costos de API de IA explica cómo comparar rutas usando resultados de la carga de trabajo en lugar de fijarse solo en el precio de lista.
7. Política y gobernanza
Los equipos pueden usar una gateway para restringir modelos, establecer presupuestos, limitar el uso de tokens, separar las claves de desarrollo y producción, y crear registros de uso listos para auditoría. Estos controles se vuelven cada vez más útiles a medida que más aplicaciones y agentes comparten la misma capa de acceso a modelos.
LLM Gateway vs. herramientas similares
Los principiantes suelen usar “gateway”, “router”, “framework de orquestación” y “reverse proxy” indistintamente. Se superponen, pero no son lo mismo.
| Herramienta | Tarea principal | Lo que normalmente no controla |
|---|---|---|
| LLM gateway | Acceso, política, enrutamiento, fiabilidad y telemetría en las llamadas al modelo | Todo el flujo de trabajo de la aplicación |
| Model router | Seleccionar un modelo o una ruta upstream | Autenticación, facturación, gobernanza o observabilidad completa, salvo que venga incluido |
| Framework de orquestación | Coordinar prompts, herramientas, memoria, agentes y flujos de trabajo de varios pasos | Control central de cuenta del proveedor y de la facturación de forma predeterminada |
| Reverse proxy | Reenviar tráfico de red, terminar TLS y aplicar controles HTTP genéricos | Límites de tokens conscientes del modelo, contratos de respaldo o contabilidad del uso de IA de forma predeterminada |
| SDK del proveedor | Llamar a la API de un proveedor con funciones nativas del proveedor | Enrutamiento entre proveedores y controles unificados |
Puedes combinar estas capas. Un framework de agentes puede llamar a una LLM gateway. La gateway puede usar un router internamente. Un reverse proxy puede situarse delante de la gateway para controles de red.
¿Cuándo necesitas una LLM gateway?
Usa esta guía para principiantes de LLM Gateway como una prueba de decisión. Una gateway merece la pena evaluarse cuando dos o más de estas afirmaciones son verdaderas:
- Soportas más de un proveedor de modelos.
- Varios servicios o agentes necesitan acceso a modelos.
- Las claves de proveedor se duplican entre entornos.
- Los equipos no pueden responder qué aplicación generó un cargo.
- El manejo de límites de velocidad difiere entre bases de código.
- Una caída del proveedor o una ruta degradada interrumpe un flujo de trabajo crítico.
- Necesitas listas de अनुमति de modelos, cuotas o presupuestos a nivel de entorno.
- Cambiar de modelo requiere cambios repetidos en el SDK o en el despliegue.
- Operaciones necesita un único ID de solicitud en las capas de aplicación y proveedor.
Puede que todavía no necesites una gateway cuando tienes un prototipo de bajo riesgo, un proveedor, un responsable y ningún requisito de fiabilidad o gobernanza en producción. Empieza con acceso directo, pero mantén las llamadas al proveedor detrás de un pequeño adaptador de aplicación para que una futura migración esté controlada.
Construir vs. comprar una LLM gateway: una tarjeta de evaluación práctica
La pregunta de evaluación empresarial más importante no es si una gateway es útil. Es qué partes debería asumir su equipo. Puede crear una gateway, adoptar un servicio alojado, ejecutar un proxy de código abierto o combinarlos.
Utilice una tabla de puntuación ponderada en lugar de elegir a partir de una lista de funciones. Califique cada opción del 1 al 5, multiplíquela por el peso y compare los totales. Los pesos siguientes son puntos de partida, no reglas universales.
| Criterion | Suggested weight | Questions to ask |
|---|---|---|
| Compatibilidad de la carga de trabajo | 25% | ¿Preserva el streaming, la salida estructurada, las herramientas, las imágenes, los detalles de errores y la contabilización de tokens? |
| Fiabilidad | 20% | ¿Los tiempos de espera, los reintentos, las comprobaciones de estado, las reglas de respaldo y la visibilidad de incidentes son explícitos? |
| Seguridad y gobernanza | 15% | ¿Puede aislar tenants, restringir modelos, rotar credenciales, redactar contenido y auditar el acceso? |
| Observabilidad | 15% | ¿Puede rastrear la ruta solicitada, la ruta resuelta, los intentos, la latencia, el uso, la validación y el costo? |
| Carga operativa | 10% | ¿Quién gestiona las actualizaciones, los cambios de proveedor, la escalabilidad, la respuesta de guardia y la retención de datos? |
| Ajuste comercial | 10% | ¿La facturación es comprensible, exportable, atribuible y compatible con su patrón de uso esperado? |
| Ruta de salida | 5% | ¿Puede exportar la configuración y la telemetría, preservar los contratos de la aplicación y cambiar sin reescribir? |
Cree cuando el control sea el producto
Crear puede ser racional cuando el comportamiento de enrutamiento es una ventaja competitiva central, las regulaciones requieren un modelo de despliegue que los servicios disponibles no pueden cumplir, o la escala de su tráfico justifica un equipo de plataforma dedicado. Pero “crear” incluye más que reenviar solicitudes HTTP. Significa asumir la autenticación, los adaptadores de proveedor, las diferencias de esquema, el streaming, la normalización de errores, las cuotas, la observabilidad, la gestión de lanzamientos, las revisiones de seguridad y la respuesta a incidentes.
Compre cuando el acceso y las operaciones no estén diferenciados
Una gateway alojada suele ser una mejor opción cuando el objetivo es acceder más rápido a varios proveedores, consolidar la facturación y las credenciales, o dar a varias aplicaciones un plano de control compartido. La evaluación todavía debe incluir una ruta de salida. Mantenga la gateway detrás de un adaptador de aplicación, conserve las pruebas de capacidades del modelo y evite incrustar suposiciones específicas de cada proveedor en todo el código del producto.
Use código abierto cuando pueda operarlo
Una gateway o proxy de código abierto puede ofrecer flexibilidad y visibilidad del código, pero alojarlo usted mismo traslada la disponibilidad, la escalabilidad, las actualizaciones, el almacenamiento de telemetría y la aplicación de parches de seguridad a su equipo. Compare la obligación operativa total, no solo la licencia del software.
El despliegue de gateway LLM en cuatro etapas
Un despliegue seguro demuestra una capa a la vez. No empiece con enrutamiento dinámico de costos en todas las cargas de trabajo.
Etapa 1: Prueba sombra de compatibilidad
Envía un conjunto de evaluación representativo a través del gateway candidato sin cambiar el comportamiento de producción. Verifica los campos de la solicitud, las respuestas, el streaming, las llamadas a herramientas, las salidas estructuradas, los campos de uso y los errores. Registra cada discrepancia. Una respuesta HTTP correcta no es suficiente si cambia el contrato de la aplicación.
Criterio de salida: el gateway supera las funciones y comprobaciones de calidad requeridas por la carga de trabajo sin ninguna pérdida de contrato sin explicación.
Etapa 2: una carga de trabajo de bajo riesgo
Mueve una carga de trabajo reversible y no crítica a una ruta de modelo explícita. Mantén disponible la ruta directa anterior del proveedor como reversión. Añade IDs de solicitud y telemetría de ruta resuelta antes de agregar reintentos o fallback.
Criterio de salida: el equipo puede explicar cada solicitud fallida, conciliar el uso y revertir sin un lanzamiento de código.
Etapa 3: política de confiabilidad
Añade un tiempo de espera acotado, clasificación de reintentos y un fallback probado para un modo de fallo que realmente hayas observado. No hagas fallback entre modelos solo porque ambos aceptan un JSON similar. La ruta alternativa debe cumplir el mismo contrato de la carga de trabajo.
Para un diseño de recuperación más profundo, usa el manual de estrategia de fallback de modelos y la guía de límites de tasa de LLM.
Criterio de salida: los simulacros de fallo muestran que los reintentos y el fallback mejoran la finalización aceptada sin causar efectos secundarios duplicados, latencia descontrolada ni gasto descontrolado.
Etapa 4: plano de control compartido para producción
Amplía solo después de que la primera carga de trabajo tenga mediciones estables. Añade cuotas de inquilino, listas de अनुमति de modelos, separación de entornos, alertas de presupuesto y un proceso documentado para cambiar rutas. Revisa quién puede modificar la política y cómo se auditan los cambios.
Criterio de salida: varias aplicaciones pueden usar el gateway sin perder la atribución de costos, la trazabilidad de incidentes, los límites de seguridad ni el control de reversión.
Mapa de errores para principiantes: ¿reintentar, redirigir o detenerse?
La confiabilidad del gateway depende menos del número de modelos de fallback que de tomar la decisión correcta para cada fallo. Usa este mapa simplificado como punto de partida.
| Fallo | Significado típico | Acción para principiantes |
|---|---|---|
| 400 o error de validación | El contrato de la solicitud no es válido o no es compatible | Detente, corrige la solicitud y no reintentes sin cambios |
| 401 o 403 | Problema de credenciales, permisos, lista de अनुमति de modelos o cuenta | Detente y alerta; nunca vayas rotando claves aleatorias |
| 404 modelo o ruta | El identificador configurado no está disponible o es incorrecto | Detente o usa una ruta equivalente aprobada explícitamente |
| 408 o tiempo de espera del cliente | Expiró el presupuesto de latencia del solicitante | Cancelalo si es posible; reintenta solo cuando la tarea sea idempotente |
| 429 límite de tasa | Se superó la capacidad o la cuota | Respeta la guía de reintento, encola o usa una ruta equivalente probada |
| 5xx antes de la salida | La gateway o el upstream falló antes de una respuesta utilizable | Usa reintento acotado o failover probado |
| La transmisión se interrumpe a mitad de la salida | Es posible que ya exista contenido parcial | Detente y concilia; no repitas a ciegas efectos secundarios |
| Es posible que se haya ejecutado una llamada a una herramienta | El estado externo podría haber cambiado | Comprueba la clave de idempotencia o el estado de la herramienta antes de reintentar |
La palabra acotado importa. Cada flujo de trabajo necesita un número máximo de reintentos, un presupuesto total de tiempo y un estado terminal. De lo contrario, una gateway puede convertir un incidente de un proveedor en acciones de herramientas duplicadas, costos descontrolados y una interrupción mayor.
Para una implementación más profunda, usa el playbook de estrategia de fallback de modelos.
Cómo medir si la gateway está funcionando
El éxito de la gateway no es la cantidad de proveedores conectados. Es la mejora en los resultados aceptados y en el control operativo.
| Métrica | Qué revela | Cálculo apto para principiantes |
|---|---|---|
| Tasa de finalización aceptada | Si los usuarios reciben resultados utilizables | resultados aceptados ÷ inicios del flujo de trabajo |
| Tasa de fallos atribuibles a la gateway | Si la nueva capa crea fallos | fallos de la gateway ÷ solicitudes a la gateway |
| latencia p95 de extremo a extremo | Si la política y el failover perjudican la experiencia del usuario | percentil 95 desde el inicio de la aplicación hasta el resultado aceptado |
| Tasa de recuperación por fallback | Si el fallback resuelve fallos reales | resultados aceptados por fallback ÷ intentos de fallback |
| Costo por resultado aceptado | Si las llamadas más baratas producen resultados más baratos | costo total de modelo y reintentos ÷ resultados aceptados |
| Explicabilidad de rutas | Si los incidentes y las facturas se pueden rastrear | solicitudes con campos de ruta solicitada y resuelta ÷ solicitudes totales |
| Precisión de rechazo de políticas | Si la gobernanza bloquea el tráfico previsto | solicitudes correctamente rechazadas ÷ rechazos revisados |
Establece una línea base antes de la migración. Luego compara la misma carga de trabajo, conjunto de evaluación, segmento de tráfico y ventana de tiempo. Si la calidad cae, la latencia aumenta o los costos se vuelven más difíciles de conciliar, un precio nominal más bajo por token no es un resultado exitoso de la gateway.
Para el análisis de costos, continúa con la guía de optimización de costos de API de IA. Para un plan de telemetría más completo, usa la lista de verificación de implementación de observabilidad de IA.
Una implementación para principiantes: cinco pasos prácticos
Paso 1: Escribe el contrato de la tarea
Elige una carga de trabajo real, como resumir tickets de soporte o extraer campos de facturas. Define:
- entradas y salidas requeridas;
- latencia aceptable;
- reglas de validación;
- si se requiere streaming;
- si las herramientas pueden crear efectos secundarios;
- qué cuenta como un resultado aceptado.
Este contrato determina si un fallback es seguro y si otro modelo es realmente equivalente.
Paso 2: Elige una interfaz de cliente estable
Si tu aplicación ya usa un SDK compatible con OpenAI, un gateway compatible puede reducir el trabajo de migración. Flatkey, por ejemplo, documenta una URL base compatible con OpenAI en https://router.flatkey.ai/v1.
curl -X POST "https://router.flatkey.ai/v1/chat/completions" \
  -H "Authorization: Bearer $FLATKEY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "your-model",
    "messages": [
      {"role": "user", "content": "Explain this error in plain English."}
    ]
  }'
Usa un gestor de secretos o una variable de entorno del lado del servidor para la clave. Nunca la incluyas en el código del navegador o del cliente móvil.
Paso 3: Comienza con enrutamiento explícito
Dirige la carga de trabajo a un único modelo probado. Si quieres independencia de la aplicación, asigna un alias interno a ese modelo en la configuración. Evita un enrutador opaco de “modelo más barato” o “mejor modelo” hasta que tengas un conjunto de evaluación repetible.
Paso 4: Añade la telemetría mínima viable
Registra:
- ID de solicitud del gateway;
- carga de trabajo y entorno;
- alias solicitado;
- proveedor y modelo resueltos;
- estado y latencia;
- conteo de reintentos y fallbacks;
- tokens de entrada y salida;
- costo estimado;
- resultado de la validación.
Esto es suficiente para depurar los primeros problemas de producción y comparar alternativas más adelante.
Paso 5: Añade una política de fallo limitada
Comienza con un tiempo de espera y un pequeño presupuesto de reintentos para fallos transitorios. Añade fallback solo después de verificar que la ruta alternativa supera el mismo contrato de la tarea. Para streaming o llamadas a herramientas con efectos secundarios, define cómo la aplicación detecta la finalización parcial y reconcilia el estado.
Tu primera semana con un LLM Gateway
Usa un plan de adopción de siete días en lugar de mover todas las aplicaciones a la vez.
Día 1: inventaria una carga de trabajo
Anota el proveedor actual, el modelo, el SDK, las credenciales, las funciones requeridas, el tráfico, el presupuesto de latencia, la sensibilidad de los datos y el responsable del rollback.
Día 2: ejecuta la prueba de compatibilidad
Envía prompts representativos a través de la ruta directa y la ruta del gateway. Incluye entradas largas, salida estructurada, streaming, herramientas y casos de error esperados si la carga de trabajo los utiliza.
Día 3: Añade identidad de la solicitud y registros de uso
Confirma que la aplicación almacena un ID de solicitud del gateway y puede vincularlo con el modelo, la ruta del proveedor, la latencia, los tokens, el recuento de reintentos y el resultado de validación sin registrar contenido sensible de forma predeterminada.
Día 4: Define la política de fallos
Clasifica los errores en detener, reintentar, failover equivalente, fallback entre modelos y conciliación manual. Establece un presupuesto total de reintentos y latencia.
Día 5: Envía un pequeño canario en producción
Usa una carga de trabajo de bajo riesgo y una proporción de tráfico deliberadamente pequeña. Mantén disponible la ruta directa. Compara la tasa de finalización aceptada, la latencia p95 y el costo por resultado aceptado.
Día 6: Revisa los controles de seguridad y gasto
Separa las credenciales de desarrollo y producción, restringe los modelos permitidos, establece cuotas y verifica quién puede ver o cambiar la política de enrutamiento. Usa la guía de gestión segura de claves API para una lista de control más completa.
Día 7: Toma una decisión de seguir, corregir o detener
- Seguir: las comprobaciones de contrato requeridas pasan y el canario cumple sus umbrales de aceptación.
- Corregir: la arquitectura es sólida, pero una brecha medible bloquea la expansión.
- Detener: el gateway añade riesgo operativo o costo sin un beneficio de control actual.
Documenta la decisión y la próxima fecha de revisión. Una detención controlada es mejor que una migración no medida.
Errores comunes de principiante
Tratar cada modelo como intercambiable
Aunque la sintaxis de las solicitudes esté normalizada, las capacidades y el comportamiento de salida difieren. Prueba las funciones exactas que usa tu carga de trabajo.
Enrutar antes de medir
El enrutamiento dinámico sin datos de evaluación traslada la lógica de decisión a una caja negra. Establece primero una línea base y luego introduce una política medible.
Reintentar cada error
Los errores de autenticación, las solicitudes no válidas, los presupuestos agotados y las funciones no compatibles no son transitorios. Reintenta solo los errores que puedan tener éxito más adelante, y usa retroceso exponencial con jitter cuando corresponda.
Registrar contenido sensible de forma predeterminada
Los prompts pueden contener datos de clientes, código fuente o datos de negocio. Mantén separada la observabilidad de metadatos de la retención de contenido.
Ocultar la ruta resuelta
Si la aplicación solicita un alias, registra el proveedor y el modelo reales utilizados. De lo contrario, los incidentes, las regresiones de calidad y los cambios de costo se vuelven difíciles de explicar.
Medir el precio en lugar de los resultados
Los precios más bajos por token no garantizan un menor costo de la carga de trabajo. Incluye los fallos de validación y los reintentos en tu cálculo de costos.
Cómo encaja Flatkey en el patrón de gateway
Flatkey proporciona una capa unificada de acceso a modelos y herramientas con una sola clave, registros de uso compartidos y un endpoint de modelo compatible con OpenAI. Para un cliente compatible existente, la ruta de migración consiste en cambiar la URL base, usar una clave de Flatkey, elegir un modelo compatible y probar el contrato de la carga de trabajo.
Eso hace que Flatkey sea relevante cuando quieres reducir la proliferación de cuentas de proveedores sin construir y operar tú mismo la capa de agregación. Si estás evaluando el diseño en lugar de buscar una introducción para principiantes, lee la guía detallada de arquitectura de gateway de API para IA. Si estás listo para migrar un cliente, usa la lista de verificación del gateway de API compatible con OpenAI.
Explora los modelos de Flatkey, revisa la documentación o crea una clave de API cuando estés listo para probar una carga de trabajo real.
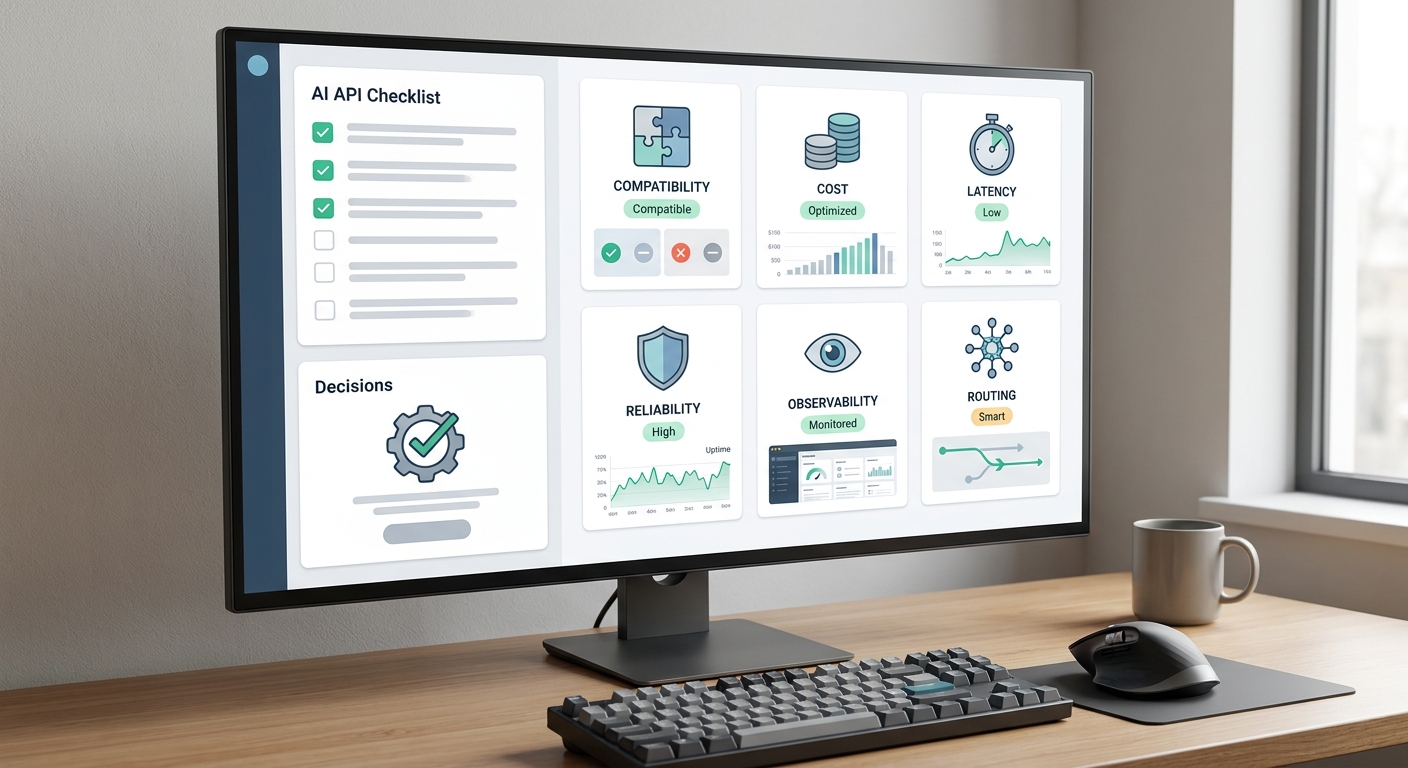
Lista de verificación de la guía para principiantes de LLM Gateway
Antes de enviar tráfico de producción a través de un gateway de LLM, confirma:
- [ ] Un contrato de carga de trabajo tiene criterios de éxito definidos.
- [ ] La aplicación usa una credencial de gateway del lado del servidor.
- [ ] El modelo seleccionado superó pruebas representativas.
- [ ] La salida estructurada, las herramientas y el streaming se probaron si se usaron.
- [ ] Los timeouts y los errores recuperables están definidos explícitamente.
- [ ] El fallback preserva el contrato de la carga de trabajo.
- [ ] Cada solicitud recibe un ID de solicitud rastreable.
- [ ] El proveedor y el modelo resueltos se registran.
- [ ] Se miden tokens, latencia, reintentos, validación y coste.
- [ ] Las cuotas de desarrollo y producción están separadas.
- [ ] El registro de contenido sin procesar está deshabilitado o gobernado deliberadamente.
- [ ] Se documenta una ruta de reversión directa.
- [ ] Existe una línea base para la finalización aceptada, la latencia y el coste por resultado aceptado.
- [ ] Las opciones de compilación, alojada y autohospedada se compararon en carga operativa y ruta de salida.
- [ ] El primer despliegue usa una ruta explícita antes de introducir el enrutamiento dinámico.
Preguntas frecuentes
¿Un gateway de LLM es lo mismo que un API gateway?
Es un API gateway especializado para el tráfico de modelos de IA. Puede proporcionar funciones estándar de un API gateway, como autenticación y limitación de tasa, además de enrutamiento consciente del modelo, uso de tokens, normalización de errores específicos de IA y fallback consciente del contrato.
¿Un gateway de LLM aloja los modelos?
No necesariamente. Algunos gateways enrutan a proveedores externos, algunos están integrados con la infraestructura de inferencia y algunos admiten ambos. Pregunta dónde ocurre la inferencia, qué proveedor sirve realmente cada modelo y cómo aparece esa ruta en los registros de uso.
¿Un gateway de LLM reduce los costes?
Puede ayudar centralizando los datos de uso, aplicando cuotas, reduciendo integraciones duplicadas y permitiendo cambios de ruta medidos. El ahorro no es automático. Compara el coste por tarea aceptada, incluidos los reintentos y los fallos de calidad.
¿Puedo usar un gateway de LLM con el SDK de OpenAI?
Sí, si la puerta de enlace expone un endpoint compatible con OpenAI y admite las funciones que usa su aplicación. Cambie la URL base y la credencial, y luego pruebe el contrato completo de la carga de trabajo en lugar de asumir una compatibilidad perfecta.
¿Una puerta de enlace es un único punto de fallo?
Puede serlo. Evalúe su arquitectura de implementación, las comprobaciones de estado, el failover upstream, el comportamiento de los timeouts, la observabilidad, los compromisos de servicio y la ruta de reversión. Centralizar el control aumenta el apalancamiento operativo, por lo que la propia puerta de enlace debe tratarse como infraestructura de producción.
¿Debería una startup construir o comprar una puerta de enlace de LLM?
Construya cuando el comportamiento de la puerta de enlace sea un diferenciador clave, necesite restricciones de implementación poco comunes o tenga el equipo para operarla. Compre cuando el objetivo principal sea acceder más rápido, tener menos integraciones con proveedores, unificar el uso y compartir controles. Un equipo pequeño también puede empezar con acceso directo y migrar más tarde si las llamadas al proveedor ya están aisladas detrás de un adaptador.
¿Qué debo probar antes de mover tráfico de producción?
Pruebe el contrato exacto de la carga de trabajo: streaming, salida estructurada, herramientas, entradas multimedia, límites de contexto, comportamiento de errores, manejo de timeouts, campos de uso y calidad de salida. Luego ejecute un canario de bajo riesgo con una ruta de reversión directa y compare la finalización aceptada, la latencia p95 y el coste por resultado aceptado frente a la línea base previa a la puerta de enlace.
El modelo mental simple
La versión más corta de esta guía para principiantes de LLM gateway es:
Su aplicación solicita trabajo de IA. La puerta de enlace decide si la solicitud está permitida, adónde debe ir, cómo debe manejarse el fallo y qué debe registrarse.
Empiece con una carga de trabajo, una interfaz estable, enrutamiento explícito, telemetría mínima viable y una política de fallo limitada. Añada enrutamiento sofisticado solo después de poder medir la calidad, la latencia, la fiabilidad y el coste.