¿Qué es el enrutamiento de LLM? Reglas, ponderaciones y políticas basadas en costes
El enrutamiento de LLM es el proceso de elegir el modelo, la ruta del proveedor o la ruta de respaldo que debe gestionar una solicitud de IA concreta. La decisión puede estar fijada en el código de la aplicación, tomarse mediante reglas explícitas, calcularse a partir de criterios ponderados o delegarse en un clasificador entrenado. El objetivo no es que cada solicitud siga una ruta diferente. Es hacer que cada ruta sea intencional, comprobable y segura.
Si se pregunta qué es el enrutamiento de LLM, la respuesta práctica es: es la capa de políticas entre una solicitud de aplicación y una llamada a un modelo. Un enrutador primero descarta las opciones que no pueden satisfacer la solicitud y, después, selecciona una ruta apta según las prioridades que haya establecido su equipo, como capacidad, calidad, latencia, coste, disponibilidad y política de datos.
Esta distinción es importante. Un modelo económico no es automáticamente una opción predeterminada segura para un flujo de trabajo orientado al cliente. Un modelo muy capaz no es automáticamente la elección adecuada para una tarea simple de clasificación. Y una alternativa de respaldo solo es útil cuando conserva los contratos de salida, herramientas y datos que espera su aplicación.
Versión corta: un buen enrutamiento de LLM comienza con restricciones estrictas, clasifica solo los candidatos compatibles, registra el motivo de la elección y recurre a un respaldo únicamente cuando este es seguro según el contrato.
Ese es el estándar que debería cumplir una respuesta lista para producción a qué es el enrutamiento de LLM: una decisión que un ingeniero pueda inspeccionar, probar y modificar sin tener que adivinar qué regla oculta movió el tráfico.
¿Qué es exactamente el enrutamiento de LLM?
¿Qué es el enrutamiento de LLM? Es un proceso de decisión que asigna una solicitud entrante a la mejor ruta de ejecución aprobada para esa solicitud. La ruta puede identificar un modelo específico, un proveedor, una región, un grupo de modelos o un respaldo probado.
El enrutador puede residir en su aplicación, una puerta de enlace de API o un servicio gestionado de enrutamiento de modelos. Por ejemplo, Amazon Bedrock intelligent prompt routing selecciona entre modelos aptos de una familia según la calidad de respuesta y el coste previstos. El enrutador de modelos de Microsoft Foundry ofrece modos de enrutamiento equilibrados, orientados a la calidad y orientados al coste. Son implementaciones de la misma idea subyacente: seleccionar de forma deliberada en lugar de tratar cada prompt como si fuera idéntico.
El enrutamiento de LLM no es lo mismo que:
- Un equilibrador de carga. Un equilibrador de carga distribuye las solicitudes entre servidores similares. Un enrutador de LLM también considera las capacidades del modelo y los resultados de la tarea.
- Un bucle de reintentos. Reintentar la misma ruta puede resolver un error transitorio; no decide si otro modelo es válido para la tarea.
- Un cambio de modelo sin revisar. Mover una solicitud a un respaldo que cambia la estructura JSON, el comportamiento de las herramientas, los límites de privacidad o la calidad de la respuesta puede generar un fallo más grave que un error explícito.
- El entrenamiento de modelos. El enrutamiento selecciona una ruta de servicio en el momento de la solicitud. No modifica los pesos del modelo.
Para una visión más amplia del límite que alberga estas decisiones, consulte nuestra guía sobre qué es una puerta de enlace de LLM y cuándo resulta útil.
Cómo toma una decisión un enrutador de LLM
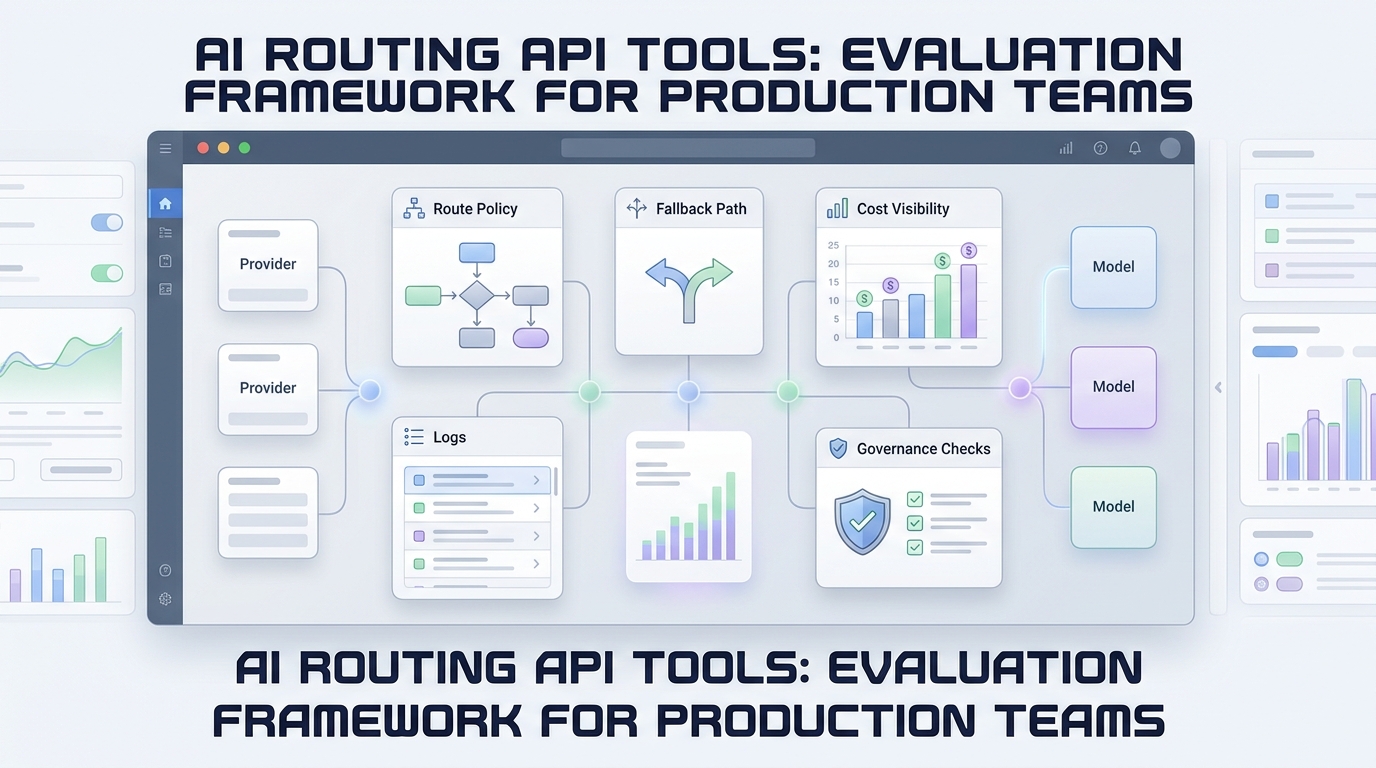
El diseño más fiable separa la elegibilidad de la preferencia. Primero, excluya las opciones que no pueden satisfacer la solicitud. Después, puntúe las rutas restantes según la clase de tráfico actual.
1. Aplique restricciones estrictas antes de cualquier puntuación
Las restricciones estrictas no son negociables. Un modelo que no cumpla una no debe permanecer en el conjunto de candidatos solo porque sea económico o rápido.
Los filtros habituales incluyen:
| Restricción | Pregunta de ejemplo | Por qué es lo primero |
|---|---|---|
| Modalidad | ¿La ruta acepta entrada de texto, imagen, audio o vídeo? | Un endpoint solo de texto no puede procesar una solicitud multimodal. |
| Contrato | ¿Admite las llamadas a herramientas, el formato de streaming o la salida estructurada requeridos? | Una respuesta sintácticamente válida aún puede romper la aplicación. |
| Política de datos | ¿El proveedor, la región o la configuración de retención están aprobados para esta solicitud? | La política no se puede intercambiar por un precio de token más bajo. |
| Capacidad | ¿La ruta tiene suficiente contexto, cuota o capacidad disponible? | Un candidato que rechazará inmediatamente la solicitud no es apto. |
| Política de producto | ¿Este modelo está permitido para este inquilino, entorno o experimento? | Hace que la gobernanza sea auditable en lugar de implícita. |
Este orden evita un error habitual de enrutamiento: tratar todos los modelos como si fueran intercambiables. No lo son. La compatibilidad debe demostrarse para el endpoint exacto y la clase de tráfico que pretende enrutar.
2. Puntúe los candidatos aptos
Después del filtrado, una ruta puede utilizar una puntuación ponderada transparente. Un patrón sencillo es:
puntuación de ruta =
  ponderación_calidad × calidad_esperada
  + ponderación_latencia × (1 - latencia_normalizada)
  + ponderación_coste × (1 - coste_normalizado)
  + ponderación_fiabilidad × estado_reciente_de_la_ruta
Esta fórmula es un marco de decisión, no una referencia universal. Lo importante es que los términos se normalicen de forma coherente, las ponderaciones correspondan a una clase de tráfico y la política pueda explicarse después de un incidente.
Por ejemplo, un trabajo de etiquetado en segundo plano puede dar más peso al coste y al rendimiento. Un agente de soporte orientado al cliente puede dar más peso a la calidad, la compatibilidad con herramientas y la latencia de cola. Un flujo de trabajo regulado puede tratar la residencia de los datos como un filtro absoluto en lugar de como una puntuación.
3. Ejecutar, observar y usar una alternativa limitada
El router debe registrar la ruta seleccionada, las entradas de puntuación, la versión de la política, el ID de la solicitud, la latencia, la estimación de coste o el registro de uso y el estado del resultado. Si falla la ruta principal, la decisión de alternativa necesita sus propias reglas:
- ¿El error es lo bastante transitorio como para reintentar en la misma ruta?
- ¿La solicitud es idempotente o un reintento podría duplicar una acción externa?
- ¿La alternativa conserva el contrato de salida y herramientas?
- ¿La alternativa tiene permitido superar el presupuesto o el límite de datos de la solicitud?
- De no ser así, ¿debería el sistema poner en cola, degradar elegantemente o devolver un error controlado?
Por eso la alternativa es una técnica de enrutamiento, no un sinónimo de enrutamiento. Nuestra guía de estrategia de alternativa de modelos aborda las decisiones de recuperación con más detalle.
Seis técnicas de enrutamiento de LLM para usar deliberadamente
No existe un único router óptimo. Empiece con la técnica más sencilla que pueda satisfacer la carga de trabajo y añada complejidad cuando sus mediciones lo justifiquen.
1. Enrutamiento estático
Todas las solicitudes de una carga de trabajo se envían a un modelo o endpoint específico.
Úselo cuando: esté estableciendo una referencia, necesite un objetivo de evaluación estable o tenga una carga de trabajo limitada con un modelo aprobado.
Atención a: una ruta estática puede ocultar el coste de usar un modelo de alta capacidad para tareas triviales o el riesgo de fiabilidad de depender de una única ruta ascendente.
2. Enrutamiento basado en reglas
Las condiciones explícitas eligen una ruta: envíe las solicitudes con imágenes a una ruta compatible con visión; envíe las solicitudes con llamadas a herramientas solo a modelos que admitan el contrato de herramientas aprobado; envíe los resúmenes internos por lotes a una ruta económica.
Úselo cuando: la decisión sea explicable a partir de los metadatos de la solicitud y las reglas sean lo bastante pocas como para revisarlas.
Atención a: la proliferación de reglas. Coloque las reglas en un archivo o servicio de políticas versionado, en lugar de dispersar comprobaciones de proveedores por el código de la aplicación.
3. Enrutamiento basado en capacidades
El router parte de un registro de capacidades de modelos en lugar de basarse únicamente en el texto del prompt. Filtra según la familia de endpoints, el contexto, las modalidades compatibles, el comportamiento de las herramientas, la compatibilidad con salidas estructuradas, la región y la asignación de la cuenta.
Úselo cuando: una aplicación tenga varios tipos de endpoints o modelos con contratos sustancialmente diferentes.
Atención a: datos de catálogo obsoletos. Trate los ID de modelos, las capacidades y las descontinuaciones como datos operativos que requieren verificación periódica.
4. Enrutamiento ponderado por coste, calidad, latencia y fiabilidad
Las rutas elegibles reciben una puntuación basada en el objetivo actual. Esta es la respuesta habitual a qué es el enrutamiento de LLM cuando un equipo quiere más matices que una regla fija, pero sigue necesitando una política explicable.
Úselo cuando: pueda definir una señal de aceptación medible y disponga de suficiente telemetría de rutas para comparar candidatos.
Atención a: la falsa precisión. Una puntuación solo es tan útil como los datos de calidad, los supuestos de coste, las señales de estado y las ponderaciones que la sustentan. No dé a entender que una puntuación decimal demuestra que un modelo es universalmente mejor.
5. Enrutamiento basado en clasificadores
Un clasificador pequeño o basado en LLM etiqueta la solicitud —por ejemplo, como extracción simple, generación de código, razonamiento complejo o contenido sensible para la seguridad— y luego la entrega a una política predefinida para esa clase.
Úselo cuando: la intención del prompt prediga claramente el nivel de modelo adecuado y pueda evaluar los errores del clasificador por separado de los errores del modelo.
Atención a: añadir una decisión opaca antes de la llamada al modelo. Mantenga una ruta para baja confianza, registre la clasificación y evalúe el clasificador con solicitudes representativas.
6. Enrutamiento de alternativa basado en el estado
La ruta principal se selecciona normalmente, pero el router reacciona a tiempos de espera agotados, sobrecarga, límites de tasa o estado degradado con un reintento limitado, una alternativa equivalente, una cola o un fallo controlado.
Úselo cuando: la disponibilidad importe y haya identificado qué alternativas son compatibles con el contrato.
Atención a: cruzar silenciosamente un límite semántico. Una alternativa puede ser apropiada para una finalización de texto reintentable, pero no para un agente que usa herramientas, un flujo de trabajo que cambia el estado o una salida que debe ajustarse a un esquema estricto. Consulte nuestra guía sobre enrutamiento de agentes multimodales para ver ejemplos en los que los cambios de modalidad hacen que las reglas de alternativa sean más estrictas.
Cree una política basada en costes sin perder de vista la calidad
Basarse en costes no significa «seleccionar siempre el modelo más barato». Significa otorgar al coste una función definida después de que se hayan superado las comprobaciones de capacidad, política y contrato requeridas.
Un patrón útil consiste en crear clases de tráfico antes de establecer las ponderaciones:
| Clase de tráfico | Primera prioridad | Enfoque de enrutamiento habitual | Postura de respaldo segura |
|---|---|---|---|
| Asistente de cara al cliente | Calidad y contrato predecible | Filtro de capacidades + ponderaciones de calidad/latencia | Solo ruta equivalente aprobada |
| Extracción en segundo plano | Rendimiento y coste unitario | Reglas + ponderaciones de coste/latencia | Reintentar, poner en cola o usar una ruta aprobada de menor coste |
| Conjunto de evaluación | Reproducibilidad | Fijar la versión del modelo y de la política | Normalmente sin respaldo oculto |
| Agente que usa herramientas | Compatibilidad de herramientas e idempotencia | Filtro de capacidades + reglas de riesgo | Detener y conciliar ante efectos secundarios inciertos |
| Generación de medios | Requisitos de endpoint y salida | Filtros de modalidad/endpoint + reglas de presupuesto | Fallar de forma cerrada, salvo que se haya probado el respaldo |
A continuación, compare la cifra que importa: el coste por resultado aceptado, no solo el coste por solicitud. Una ruta de menor precio que provoca reintentos adicionales, revisión humana, reparaciones de esquemas o llamadas a herramientas fallidas puede costar más por tarea completada.
La documentación de enrutamiento de Amazon plantea la misma salvedad práctica en un contexto diferente: el enrutamiento automatizado tiene límites, incluidos los datos de entrenamiento específicos de cada ruta y los límites de soporte. Recomienda revisar continuamente el rendimiento y el coste en lugar de asumir que una decisión de enrutamiento seguirá siendo óptima para siempre. Su propia política debe evaluarse frente a su propia combinación de solicitudes.
Una política de enrutamiento segura, en pseudocódigo
Este ejemplo simplificado mantiene la decisión auditable. No presupone que todas las rutas puedan gestionar todas las solicitudes.
const candidates = catalog
  .filter(route => route.isHealthy)
  .filter(route => route.supports(request.modality))
  .filter(route => route.supportsTools(request.requiredTools))
  .filter(route => route.allows(request.dataClass))
  .filter(route => route.withinBudget(request.budget));

if (candidates.length === 0) {
  return failClosed("No approved route for this request");
}

const primary = candidates
  .map(route => ({
    route,
    score: score(route, request.trafficClass),
  }))
  .sort((a, b) => b.score - a.score)[0];

const result = await call(primary.route, request);

if (isTransient(result.error) && request.isIdempotent) {
  return retryWithinBudget(primary.route, request);
}

if (canUseEquivalentFallback(result.error, request, primary.route)) {
  return call(selectApprovedFallback(candidates, primary.route), request);
}

return returnControlledError(result.error);
La política debe emitir un motivo de ruta como tool_contract_required, budget_preferred, primary_unhealthy o no_contract_safe_fallback. Ese pequeño detalle hace que el sistema sea mucho más fácil de depurar que un mensaje genérico de «modelo fallido».
Cómo medir si el enrutamiento de LLM está ayudando
El enrutamiento no tiene éxito porque haya producido un nombre de modelo. Tiene éxito cuando mejora el resultado de una carga de trabajo definida sin crear un riesgo inaceptable.
Realice el seguimiento de los resultados por clase de tráfico, versión de la política y ruta seleccionada:
- Tasa de resultados aceptados: la proporción de respuestas que superan la prueba de aceptación empresarial, de esquema o de revisión humana.
- Coste por resultado aceptado: coste total de modelo, reintentos y remediación dividido entre las tareas aceptadas.
- Latencia P50, P95 y P99: segmentada por tamaño de solicitud y ruta; un promedio puede ocultar una latencia de cola problemática.
- Tasa de recuperación mediante respaldo: con qué frecuencia un respaldo produce un resultado aceptable, no simplemente un HTTP 200.
- Tasa de fallos de contrato: salida estructurada no válida, herramientas no compatibles, incompatibilidad de streaming o campos obligatorios ausentes.
- Distribución de rutas: si una nueva política está enviando inesperadamente la mayor parte del tráfico a una ruta costosa o degradada.
- Tasa de rechazo de la política: con qué frecuencia no existe un candidato seguro; a menudo es una señal para ampliar las capacidades aprobadas en lugar de relajar una barrera de protección.
Para consultar un cuadro de mando práctico, vea métricas de API de enrutamiento de IA que realmente importan. Las métricas son especialmente útiles cuando un cambio de enrutamiento parece reducir el coste de tokens, pero disminuye los resultados aceptados.
¿Cuándo necesita enrutamiento de LLM?
Puede que no necesite un enrutador cuando un proveedor, un endpoint y una carga de trabajo estable cumplen sus requisitos. Fije el modelo, establezca tiempos de espera y reintentos claros, y mida primero la referencia.
El enrutamiento de LLM se vuelve valioso cuando se cumple al menos una de estas condiciones:
- Los distintos tipos de solicitudes necesitan diferentes capacidades, límites de coste u objetivos de latencia.
- Necesita mantener las elecciones de proveedor, modelo y región detrás de un límite de política.
- Una interrupción, un problema de cuota o una retirada requiere una ruta de respuesta segura.
- Quiere comparar candidatos sin reescribir cada llamador.
- Necesita un registro de qué ruta gestionó una solicitud y por qué.
Si eso se parece a su stack, una puerta de enlace puede facilitar la gestión del límite operativo. La documentación de Flatkey describe una URL base compatible con OpenAI y una única clave de API para los modelos compatibles; quienes realizan las llamadas eligen un ID de modelo por solicitud, mientras que la plataforma documenta la conmutación automática por error aguas arriba. Empiece fijando un modelo y registrando los resultados; después, introduzca una política de enrutamiento explícita para las clases de tráfico que realmente la necesiten. Para el siguiente paso arquitectónico, lea nuestra lista de requisitos para una puerta de enlace de API de IA.
Para conocer estrategias de enrutamiento, una plantilla de políticas y código de producción, lea nuestra guía de enrutamiento de modelos.
Preguntas frecuentes
¿Qué es el enrutamiento de LLM frente a la alternativa de modelo?
El enrutamiento de LLM es el proceso más amplio de decisión para seleccionar una ruta de ejecución. Una alternativa de modelo es una acción de recuperación dentro de ese proceso, utilizada solo cuando falla la ruta principal y se aprueba una ruta alternativa para el mismo contrato de solicitud.
¿Qué es el enrutamiento de LLM en una API con múltiples proveedores?
En una API con múltiples proveedores, el enrutamiento de LLM puede seleccionar una ruta de proveedor además de un modelo. La política debe verificar la compatibilidad de los endpoints, la política de datos, la capacidad del modelo, las unidades de precios, el estado y el comportamiento de alternativa antes de considerar equivalentes a dos proveedores.
¿Con qué técnica de enrutamiento de LLM debería empezar un equipo nuevo?
Empiece con enrutamiento estático, además de comprobaciones explícitas de capacidades y observabilidad. Añada reglas para clases de tráfico claramente diferenciadas. Pase al enrutamiento basado en ponderaciones o clasificadores solo después de contar con pruebas representativas y una forma de medir los resultados aceptados.
¿Puede un enrutador de LLM elegir automáticamente el modelo más barato?
Puede hacerlo, pero el coste nunca debe eludir las restricciones estrictas. Primero filtre por la capacidad aprobada y la compatibilidad del contrato; después, optimice el precio entre las rutas elegibles. Valide el resultado con el coste por resultado aceptado, no solo con el precio por token.
La respuesta práctica a «¿qué es el enrutamiento de LLM?»
La respuesta práctica a qué es el enrutamiento de LLM no es «elegir un modelo ingenioso». Es «codificar las decisiones que su equipo puede defender». Empiece con capacidades aprobadas y restricciones estrictas; use ponderaciones solo para compromisos reales; mantenga las alternativas acotadas y seguras para el contrato; y registre cada decisión con suficiente detalle para mejorarla después.
Si está centralizando el acceso a modelos, use ese límite para realizar experimentos de enrutamiento controlados en lugar de dispersar la lógica de proveedores por cada servicio. Obtenga más información en la documentación de la API de Flatkey.