O que é roteamento de LLM? Regras, pesos e políticas sensíveis a custos explicados
O roteamento de LLM é o processo de escolher o modelo, o caminho do provedor ou o caminho de fallback que deve processar uma solicitação específica de IA. A decisão pode ser fixa no código da aplicação, tomada por regras explícitas, calculada com base em critérios ponderados ou delegada a um classificador treinado. O objetivo não é fazer com que cada solicitação siga um caminho diferente. É tornar cada caminho intencional, testável e seguro.
Se você está perguntando o que é roteamento de LLM, a resposta prática é: trata-se da camada de política entre uma solicitação da aplicação e uma chamada de modelo. Um roteador primeiro elimina as opções que não podem atender à solicitação e, em seguida, seleciona uma rota elegível usando as prioridades definidas pela sua equipe, como capacidade, qualidade, latência, custo, disponibilidade e política de dados.
Essa distinção é importante. Um modelo barato não é automaticamente um padrão seguro para um fluxo de trabalho voltado ao cliente. Um modelo altamente capaz não é automaticamente a escolha certa para uma tarefa simples de classificação. E um fallback só é útil quando preserva os contratos de saída, ferramentas e dados esperados pela sua aplicação.
Versão curta: um bom roteamento de LLM começa com restrições rígidas, classifica apenas candidatos compatíveis, registra o motivo da escolha e usa fallback somente quando o backup é seguro em relação ao contrato.
Esse é o padrão que uma resposta pronta para produção à pergunta o que é roteamento de LLM deve atender: uma decisão que um engenheiro possa inspecionar, testar e alterar sem adivinhar qual regra oculta redirecionou o tráfego.
O que é roteamento de LLM, exatamente?
O que é roteamento de LLM? É um processo de decisão que mapeia uma solicitação recebida para o melhor caminho de execução aprovado para essa solicitação. O caminho pode identificar um modelo específico, um provedor, uma região, um grupo de modelos ou um fallback testado.
O roteador pode estar na sua aplicação, em um gateway de API ou em um serviço gerenciado de roteamento de modelos. Por exemplo, o roteamento inteligente de prompts do Amazon Bedrock seleciona entre modelos elegíveis de uma família com base na qualidade prevista da resposta e no custo. O roteador de modelos do Microsoft Foundry oferece modos de roteamento equilibrados, orientados à qualidade e orientados ao custo. Essas são implementações da mesma ideia subjacente: selecionar deliberadamente, em vez de tratar todos os prompts como idênticos.
O roteamento de LLM não é a mesma coisa que:
- Um balanceador de carga. Um balanceador de carga distribui solicitações entre servidores semelhantes. Um roteador de LLM também considera as capacidades do modelo e os resultados das tarefas.
- Um loop de repetição. Repetir a mesma rota pode resolver um erro transitório; isso não decide se outro modelo é válido para a tarefa.
- Uma troca de modelo não revisada. Mover uma solicitação para um backup que altera a estrutura do JSON, o comportamento das ferramentas, os limites de privacidade ou a qualidade da resposta pode gerar uma falha mais grave do que um erro explícito.
- Treinamento de modelos. O roteamento seleciona um caminho de atendimento no momento da solicitação. Ele não altera os pesos do modelo.
Para uma visão mais ampla da camada que hospeda essas decisões, consulte nosso guia sobre o que é um gateway de LLM e quando ele se torna útil.
Como um roteador de LLM toma uma decisão
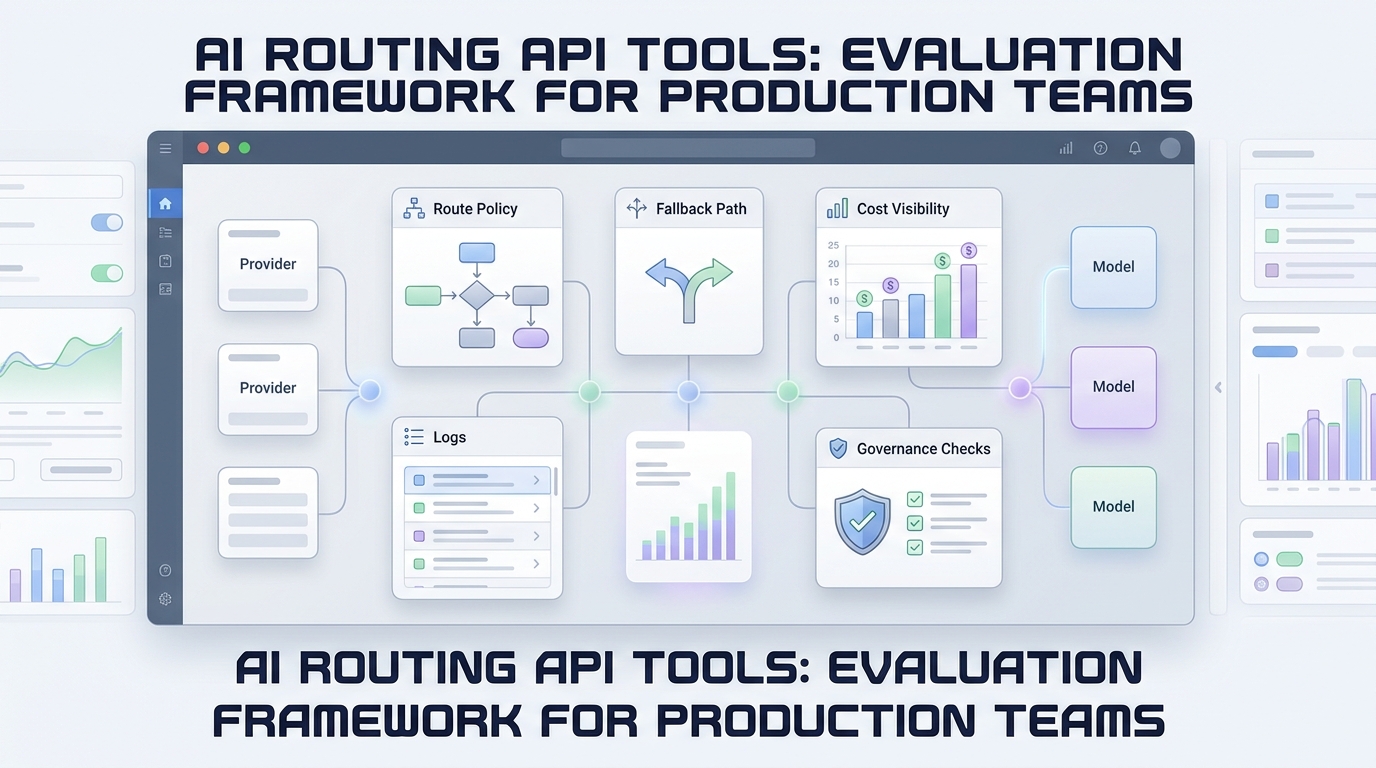
O design mais confiável separa a elegibilidade da preferência. Primeiro, exclua as opções que não podem atender à solicitação. Depois, avalie as rotas restantes em relação à classe de tráfego atual.
1. Aplique restrições rígidas antes de qualquer pontuação
Restrições rígidas não são negociáveis. Um modelo que falha em uma delas não deve permanecer no conjunto de candidatos apenas porque é barato ou rápido.
Filtros típicos incluem:
| Restrição | Pergunta de exemplo | Por que vem primeiro |
|---|---|---|
| Modalidade | A rota aceita entrada de texto, imagem, áudio ou vídeo? | Um endpoint somente de texto não consegue processar uma solicitação multimodal. |
| Contrato | Ela oferece suporte às chamadas de ferramentas, ao formato de streaming ou à saída estruturada exigidos? | Uma resposta sintaticamente válida ainda pode quebrar a aplicação. |
| Política de dados | O provedor, a região ou a configuração de retenção são aprovados para esta solicitação? | Não se pode trocar política por um preço menor por token. |
| Capacidade | A rota tem contexto, cota ou capacidade saudável suficientes? | Um candidato que rejeitará imediatamente a solicitação não é elegível. |
| Política de produto | Este modelo é permitido para este locatário, ambiente ou experimento? | Torna a governança auditável, em vez de implícita. |
Essa ordem evita um erro comum de roteamento: tratar todos os modelos como intercambiáveis. Eles não são. A compatibilidade precisa ser comprovada para o endpoint exato e a classe de tráfego que você pretende rotear.
2. Pontue os candidatos elegíveis
Após a filtragem, uma rota pode usar uma pontuação ponderada transparente. Um padrão simples é:
route score =
  quality_weight × expected_quality
  + latency_weight × (1 - normalized_latency)
  + cost_weight × (1 - normalized_cost)
  + reliability_weight × recent_route_health
Essa fórmula é uma estrutura de decisão, não um benchmark universal. O importante é que os termos sejam normalizados de forma consistente, os pesos pertençam a uma classe de tráfego e a política possa ser explicada após um incidente.
Por exemplo, um trabalho de etiquetagem em segundo plano pode atribuir mais peso ao custo e à capacidade de processamento. Um agente de suporte voltado ao cliente pode atribuir mais peso à qualidade, à compatibilidade com ferramentas e à latência de cauda. Um fluxo de trabalho regulamentado pode tratar a residência de dados como um filtro absoluto, e não como uma pontuação.
3. Execute, observe e use um fallback limitado
O roteador deve registrar a rota selecionada, as entradas de pontuação, a versão da política, o ID da solicitação, a latência, a estimativa de custo ou o registro de uso e o status do resultado. Se a rota primária falhar, a decisão de fallback precisará de suas próprias regras:
- O erro é suficientemente transitório para uma nova tentativa na mesma rota?
- A solicitação é idempotente ou uma nova tentativa poderia duplicar uma ação externa?
- O fallback preserva o contrato de saída e de ferramentas?
- O fallback tem permissão para exceder o orçamento ou o limite de dados da solicitação?
- Se não, o sistema deve enfileirar, degradar graciosamente ou retornar um erro controlado?
É por isso que o fallback é uma técnica de roteamento, e não um sinônimo de roteamento. Nosso guia de estratégia de fallback de modelos aborda as decisões de recuperação com mais detalhes.
Seis técnicas de roteamento de LLM para usar deliberadamente
Não existe um único melhor roteador. Comece pela técnica mais simples capaz de atender à carga de trabalho e adicione complexidade quando suas medições a justificarem.
1. Roteamento estático
Todas as solicitações de uma carga de trabalho são enviadas para um único modelo ou endpoint nomeado.
Use quando: você estiver estabelecendo uma linha de base, precisar de um alvo de avaliação estável ou tiver uma carga de trabalho restrita com um único modelo aprovado.
Fique atento a: uma rota estática pode ocultar o custo de usar um modelo de alta capacidade para tarefas triviais ou o risco de confiabilidade de depender de um único caminho upstream.
2. Roteamento baseado em regras
Condições explícitas escolhem uma rota: envie solicitações com imagens para um caminho com capacidade de visão; envie solicitações com chamadas de ferramentas apenas para modelos compatíveis com o contrato de ferramentas aprovado; envie resumos de lotes internos para uma rota econômica.
Use quando: a decisão for explicável a partir dos metadados da solicitação e houver poucas regras o bastante para serem revisadas.
Fique atento a: proliferação de regras. Coloque as regras em um arquivo ou serviço de política versionado, em vez de dispersar verificações de provedores pelo código da aplicação.
3. Roteamento baseado em capacidades
O roteador parte de um registro de capacidades dos modelos, em vez de apenas do texto do prompt. Ele filtra por família de endpoint, contexto, modalidades compatíveis, comportamento de ferramentas, suporte a saída estruturada, região e permissão da conta.
Use quando: uma aplicação tiver vários tipos de endpoint ou modelos com contratos materialmente diferentes.
Fique atento a: dados de catálogo desatualizados. Trate IDs de modelos, capacidades e descontinuações como dados operacionais que precisam de verificação regular.
4. Roteamento ponderado por custo, qualidade, latência e confiabilidade
Rotas elegíveis recebem uma pontuação com base no objetivo atual. Esta é a resposta comum para o que é roteamento de LLM quando uma equipe quer mais nuance do que uma regra fixa, mas ainda precisa de uma política explicável.
Use quando: você puder definir um sinal de aceitação mensurável e tiver telemetria de rota suficiente para comparar candidatos.
Fique atento a: falsa precisão. Uma pontuação é tão útil quanto os dados de qualidade, as premissas de custo, os sinais de integridade e os pesos por trás dela. Não dê a entender que uma pontuação decimal prova que um modelo é universalmente melhor.
5. Roteamento baseado em classificadores
Um classificador pequeno ou baseado em LLM rotula a solicitação — como extração simples, geração de código, raciocínio complexo ou conteúdo sensível à segurança — e então a encaminha para uma política predefinida para essa classe.
Use quando: a intenção do prompt prever fortemente o nível de modelo apropriado e você puder avaliar os erros do classificador separadamente dos erros do modelo.
Fique atento a: adicionar uma decisão opaca antes da chamada ao modelo. Mantenha um caminho para baixa confiança, registre a classificação e avalie o classificador em relação a solicitações representativas.
6. Roteamento de fallback sensível à integridade
O caminho primário é selecionado normalmente, mas o roteador reage a tempos limite, sobrecarga, limites de taxa ou integridade degradada com uma nova tentativa limitada, um backup equivalente, uma fila ou uma falha controlada.
Use quando: a disponibilidade for importante e você tiver identificado quais backups são compatíveis com o contrato.
Fique atento a: cruzar silenciosamente um limite semântico. Um fallback pode ser apropriado para uma conclusão de texto que pode ser repetida, mas não para um agente que usa ferramentas, um fluxo de trabalho que altera estado ou uma saída que deve corresponder a um esquema rigoroso. Consulte nosso guia sobre roteamento de agentes multimodais para ver exemplos em que mudanças de modalidade tornam as regras de fallback mais rigorosas.
Crie uma política sensível a custos sem perder de vista a qualidade
Sensível a custos não significa “sempre selecionar o modelo mais barato”. Significa atribuir ao custo um papel definido depois que as verificações de capacidade, política e contrato exigidas forem aprovadas.
Um padrão útil é criar classes de tráfego antes de definir os pesos:
| Classe de tráfego | Primeira prioridade | Abordagem de roteamento comum | Postura de fallback segura |
|---|---|---|---|
| Assistente voltado ao cliente | Qualidade e contrato previsível | Filtro de capacidades + pesos de qualidade/latência | Apenas rota aprovada equivalente |
| Extração em segundo plano | Throughput e custo unitário | Regras + pesos de custo/latência | Tentar novamente, enfileirar ou usar rota aprovada de menor custo |
| Conjunto de avaliação | Reprodutibilidade | Fixar a versão do modelo e da política | Geralmente sem fallback oculto |
| Agente que usa ferramentas | Compatibilidade com ferramentas e idempotência | Filtro de capacidades + regras de risco | Interromper e reconciliar diante de efeitos colaterais incertos |
| Geração de mídia | Requisitos de endpoint e saída | Filtros de modalidade/endpoint + regras de orçamento | Falhar de forma fechada, a menos que o backup tenha sido testado |
Em seguida, compare o número que importa: custo por resultado aceito, e não apenas o custo por solicitação. Uma rota de menor preço que causa novas tentativas extras, revisão humana, correções de esquema ou chamadas de ferramentas com falha pode custar mais por tarefa concluída.
A documentação de roteamento da Amazon faz a mesma ressalva prática em um contexto diferente: o roteamento automatizado tem limitações, incluindo dados de treinamento específicos da rota e limites de suporte. Ela recomenda a revisão contínua do desempenho e do custo, em vez de presumir que uma decisão de roteamento permanecerá ideal para sempre. Sua própria política deve ser avaliada em relação à sua própria combinação de solicitações.
Uma política de roteamento segura, em pseudocódigo
Este exemplo simplificado mantém a decisão auditável. Ele não pressupõe que todas as rotas possam lidar com todas as solicitações.
const candidates = catalog
  .filter(route => route.isHealthy)
  .filter(route => route.supports(request.modality))
  .filter(route => route.supportsTools(request.requiredTools))
  .filter(route => route.allows(request.dataClass))
  .filter(route => route.withinBudget(request.budget));

if (candidates.length === 0) {
  return failClosed("No approved route for this request");
}

const primary = candidates
  .map(route => ({
    route,
    score: score(route, request.trafficClass),
  }))
  .sort((a, b) => b.score - a.score)[0];

const result = await call(primary.route, request);

if (isTransient(result.error) && request.isIdempotent) {
  return retryWithinBudget(primary.route, request);
}

if (canUseEquivalentFallback(result.error, request, primary.route)) {
  return call(selectApprovedFallback(candidates, primary.route), request);
}

return returnControlledError(result.error);
A política deve emitir um motivo de rota, como tool_contract_required, budget_preferred, primary_unhealthy ou no_contract_safe_fallback. Esse pequeno detalhe torna o sistema muito mais fácil de depurar do que uma mensagem genérica de “falha do modelo”.
Como medir se o roteamento de LLM está ajudando
O roteamento não é bem-sucedido porque produziu um nome de modelo. Ele é bem-sucedido quando melhora um resultado definido da carga de trabalho sem criar riscos inaceitáveis.
Acompanhe os resultados por classe de tráfego, versão da política e rota selecionada:
- Taxa de resultados aceitos: a proporção de respostas que passam no teste de aceitação de negócio, esquema ou revisão humana.
- Custo por resultado aceito: custo total de modelo, novas tentativas e remediação dividido pelas tarefas aceitas.
- Latência P50, P95 e P99: segmentada por tamanho de solicitação e rota; uma média pode ocultar uma latência de cauda problemática.
- Taxa de recuperação por fallback: com que frequência um fallback produz um resultado aceitável, e não apenas um HTTP 200.
- Taxa de falha de contrato: saída estruturada inválida, ferramentas não compatíveis, incompatibilidade de streaming ou campos obrigatórios ausentes.
- Distribuição de rotas: se uma nova política está enviando inesperadamente a maior parte do tráfego para um caminho caro ou degradado.
- Taxa de rejeição da política: com que frequência não existe um candidato seguro — muitas vezes, um sinal para expandir as capacidades aprovadas em vez de flexibilizar uma proteção.
Para um painel prático, consulte Métricas de API de roteamento de IA que realmente importam. As métricas são especialmente úteis quando uma mudança de roteamento parece reduzir o custo de tokens, mas diminui os resultados aceitos.
Quando você precisa de roteamento de LLM?
Talvez você não precise de um roteador quando um provedor, um endpoint e uma carga de trabalho estável atendem aos seus requisitos. Fixe o modelo, defina timeouts e novas tentativas claros e meça primeiro a linha de base.
O roteamento de LLM se torna valioso quando pelo menos uma destas condições é verdadeira:
- Diferentes tipos de solicitação precisam de diferentes capacidades, faixas de custo ou objetivos de latência.
- Você precisa manter as escolhas de provedor, modelo e região por trás de um limite de política.
- Uma indisponibilidade, problema de cota ou descontinuação exige um caminho de resposta seguro.
- Você quer comparar candidatos sem reescrever cada chamador.
- Você precisa de um registro de qual rota processou uma solicitação e por quê.
Se isso se parece com a sua stack, um gateway pode tornar o limite operacional mais fácil de gerenciar. A documentação da Flatkey descreve uma URL base compatível com OpenAI e uma única chave de API para modelos compatíveis; os chamadores escolhem um ID de modelo por solicitação, enquanto a plataforma documenta o failover automático upstream. Comece fixando um modelo e registrando os resultados; em seguida, introduza uma política de roteamento explícita para as classes de tráfego que realmente precisam dela. Para a próxima etapa arquitetural, leia nossa checklist de requisitos para gateway de API de IA.
Para estratégias de roteamento, um modelo de política e código de produção, leia nosso guia de roteamento de modelos.
Perguntas frequentes
O que é roteamento de LLM em comparação com fallback de modelo?
O roteamento de LLM é o processo mais amplo de decisão para selecionar um caminho de execução. Um fallback de modelo é uma ação de recuperação dentro desse processo, usada apenas quando a rota primária falha e uma rota alternativa é aprovada para o mesmo contrato de solicitação.
O que é roteamento de LLM em uma API com vários provedores?
Em uma API com vários provedores, o roteamento de LLM pode selecionar tanto um caminho de provedor quanto um modelo. A política deve verificar a compatibilidade do endpoint, a política de dados, a capacidade do modelo, as unidades de precificação, a integridade e o comportamento de fallback antes de tratar dois provedores como equivalentes.
Com qual técnica de roteamento de LLM uma nova equipe deve começar?
Comece com roteamento estático, além de verificações explícitas de capacidade e observabilidade. Adicione regras para classes de tráfego claramente distintas. Passe para o roteamento baseado em pesos ou classificadores somente depois de ter testes representativos e uma forma de medir resultados aceitos.
Um roteador de LLM pode escolher automaticamente o modelo mais barato?
Pode, mas o custo nunca deve contornar restrições rígidas. Primeiro, filtre por capacidade aprovada e compatibilidade de contrato; depois, otimize o preço entre as rotas elegíveis. Valide o resultado com o custo por resultado aceito, e não apenas com o preço por token.
A resposta prática para “o que é roteamento de LLM?”
A resposta prática para o que é roteamento de LLM não é “escolha um modelo inteligente”. É “codifique as escolhas que sua equipe consegue defender”. Comece com capacidades aprovadas e restrições rígidas; use pesos apenas para trade-offs reais; mantenha os fallbacks limitados e seguros em relação ao contrato; e registre cada decisão de forma suficiente para melhorá-la depois.
Se você está centralizando o acesso a modelos, use esse limite para executar experimentos de roteamento controlados, em vez de dispersar a lógica de provedores por todos os serviços. Saiba mais na documentação da API Flatkey.