Qu’est-ce que le routage LLM ? Règles, pondérations et politiques tenant compte des coûts
Le routage LLM est le processus qui consiste à choisir le modèle, le chemin du fournisseur ou le chemin de repli qui doit traiter une requête d’IA donnée. La décision peut être fixée dans le code de l’application, prise à l’aide de règles explicites, calculée à partir de critères pondérés ou déléguée à un classifieur entraîné. L’objectif n’est pas de faire emprunter un chemin différent à chaque requête. Il est de rendre chaque chemin intentionnel, testable et sûr.
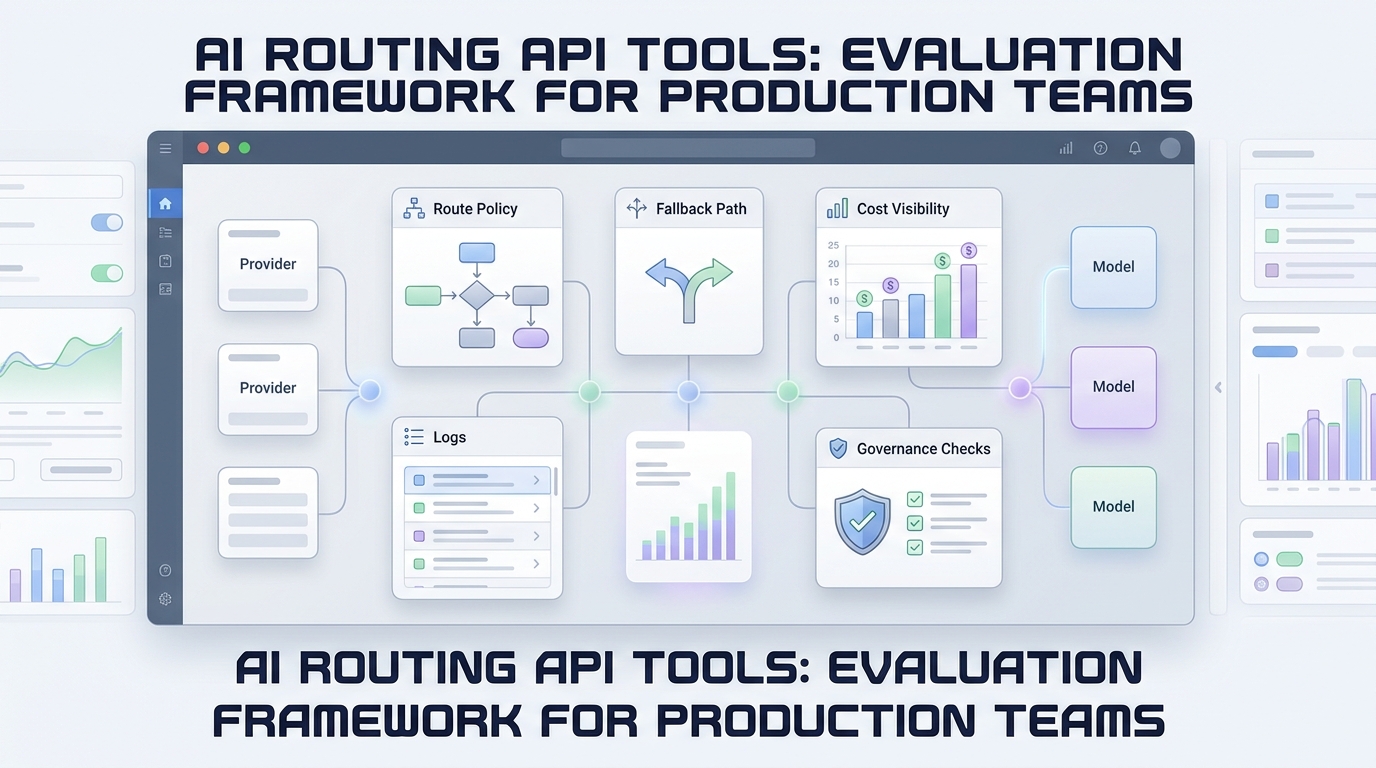
Si vous vous demandez ce qu’est le routage LLM, la réponse pratique est la suivante : c’est la couche de politique entre une requête d’application et un appel de modèle. Un routeur écarte d’abord les options qui ne peuvent pas satisfaire la requête, puis sélectionne un itinéraire éligible en fonction des priorités définies par votre équipe — telles que la capacité, la qualité, la latence, le coût, la disponibilité et la politique de données.
Cette distinction est importante. Un modèle bon marché n’est pas automatiquement un choix sûr par défaut pour un workflow destiné aux clients. Un modèle très performant n’est pas automatiquement le bon choix pour une simple tâche de classification. Et un repli n’est utile que s’il préserve les contrats de sortie, d’outils et de données attendus par votre application.
Version courte : un bon routage LLM commence par des contraintes strictes, ne classe que les candidats compatibles, enregistre la raison du choix et n’utilise un repli que lorsque la solution de secours est sûre au regard du contrat.
C’est le niveau qu’une réponse prête pour la production à la question « qu’est-ce que le routage LLM ? » doit atteindre : une décision qu’un ingénieur peut inspecter, tester et modifier sans deviner quelle règle cachée a redirigé le trafic.
Qu’est-ce que le routage LLM, exactement ?
Qu’est-ce que le routage LLM ? C’est un processus de décision qui associe une requête entrante au meilleur chemin d’exécution approuvé pour cette requête. Le chemin peut identifier un modèle spécifique, un fournisseur, une région, un groupe de modèles ou un repli testé.
Le routeur peut se trouver dans votre application, une passerelle API ou un service géré de routage de modèles. Par exemple, le routage intelligent des prompts d’Amazon Bedrock sélectionne parmi les modèles éligibles d’une même famille en fonction de la qualité de réponse prédite et du coût. Le routeur de modèles de Microsoft Foundry propose des modes de routage équilibré, orienté qualité et orienté coût. Ce sont des implémentations de la même idée sous-jacente : sélectionner délibérément plutôt que de traiter chaque prompt comme s’il était identique.
Le routage LLM n’est pas la même chose que :
- Un équilibreur de charge. Un équilibreur de charge répartit les requêtes entre des serveurs similaires. Un routeur LLM prend également en compte les capacités des modèles et les résultats des tâches.
- Une boucle de nouvelle tentative. Réessayer le même itinéraire peut résoudre une erreur transitoire ; cela ne détermine pas si un autre modèle est valide pour la tâche.
- Un changement de modèle non examiné. Déplacer une requête vers une solution de secours qui modifie la structure JSON, le comportement des outils, les limites de confidentialité ou la qualité des réponses peut créer une défaillance plus grave qu’une erreur explicite.
- L’entraînement de modèle. Le routage sélectionne un chemin de service au moment de la requête. Il ne modifie pas les pondérations du modèle.
Pour une analyse plus large de la couche qui héberge ces décisions, consultez notre guide sur ce qu’est une passerelle LLM et sur les cas où elle devient utile.
Comment un routeur LLM prend une décision
La conception la plus fiable sépare l’éligibilité de la préférence. Excluez d’abord les options qui ne peuvent pas satisfaire la requête. Évaluez ensuite les itinéraires restants en fonction de la classe de trafic actuelle.
1. Appliquer des contraintes strictes avant toute évaluation
Les contraintes strictes ne sont pas négociables. Un modèle qui ne respecte pas l’une d’entre elles ne doit pas rester dans l’ensemble des candidats simplement parce qu’il est peu coûteux ou rapide.
Les filtres courants incluent :
| Contrainte | Exemple de question | Pourquoi elle passe en premier |
|---|---|---|
| Modalité | L’itinéraire accepte-t-il une entrée texte, image, audio ou vidéo ? | Un point de terminaison uniquement textuel ne peut pas traiter une requête multimodale. |
| Contrat | Prend-il en charge les appels d’outils requis, le format du streaming ou la sortie structurée ? | Une réponse syntaxiquement valide peut tout de même casser l’application. |
| Politique de données | Le fournisseur, la région ou le paramètre de conservation est-il approuvé pour cette requête ? | La politique ne peut pas être échangée contre un prix de jeton inférieur. |
| Capacité | L’itinéraire dispose-t-il de suffisamment de contexte, de quota ou de capacité saine ? | Un candidat qui rejettera immédiatement la requête n’est pas éligible. |
| Politique produit | Ce modèle est-il autorisé pour ce locataire, cet environnement ou cette expérience ? | Rend la gouvernance auditable plutôt qu’implicite. |
Cet ordre évite une erreur fréquente de routage : considérer tous les modèles comme interchangeables. Ils ne le sont pas. La compatibilité doit être démontrée pour le point de terminaison exact et la classe de trafic que vous prévoyez de router.
2. Évaluer les candidats éligibles
Après le filtrage, un itinéraire peut utiliser un score pondéré transparent. Voici un modèle simple :
route score =
  quality_weight × expected_quality
  + latency_weight × (1 - normalized_latency)
  + cost_weight × (1 - normalized_cost)
  + reliability_weight × recent_route_health
Cette formule est un cadre de décision, et non une référence universelle. L’important est que les termes soient normalisés de manière cohérente, que les pondérations appartiennent à une classe de trafic et que la politique puisse être expliquée après un incident.
Par exemple, une tâche de marquage en arrière-plan peut accorder davantage de poids au coût et au débit. Un agent d’assistance orienté client peut accorder davantage de poids à la qualité, à la compatibilité des outils et à la latence en queue de distribution. Un workflow réglementé peut traiter la résidence des données comme un filtre absolu plutôt que comme un score.
3. Exécuter, observer et utiliser un repli limité
Le routeur doit consigner la route sélectionnée, les entrées de score, la version de la politique, l’ID de requête, la latence, l’estimation de coût ou l’enregistrement d’utilisation, ainsi que l’état du résultat. Si la route principale échoue, la décision de repli doit suivre ses propres règles :
- L’erreur est-elle suffisamment transitoire pour justifier une nouvelle tentative sur la même route ?
- La requête est-elle idempotente, ou une nouvelle tentative pourrait-elle dupliquer une action externe ?
- Le repli préserve-t-il le contrat de sortie et d’outils ?
- Le repli est-il autorisé à dépasser le budget ou la limite de données de la requête ?
- Sinon, le système doit-il mettre en file d’attente, se dégrader gracieusement ou renvoyer une erreur contrôlée ?
C’est pourquoi le repli est une technique de routage, et non un synonyme de routage. Notre guide pratique de stratégie de repli de modèle couvre plus en détail les décisions de récupération.
Six techniques de routage LLM à utiliser délibérément
Il n’existe pas de routeur unique qui soit le meilleur. Commencez par la technique la plus simple capable de satisfaire la charge de travail, puis ajoutez de la complexité lorsque vos mesures le justifient.
1. Routage statique
Chaque requête d’une charge de travail est envoyée vers un modèle ou un endpoint nommé.
À utiliser lorsque : vous établissez une référence, avez besoin d’une cible d’évaluation stable ou disposez d’une charge de travail restreinte avec un seul modèle approuvé.
À surveiller : une route statique peut masquer le coût de l’utilisation d’un modèle à haute capacité pour des tâches triviales, ou le risque de fiabilité lié à la dépendance à un seul chemin en amont.
2. Routage basé sur des règles
Des conditions explicites choisissent une route : envoyez les requêtes contenant des images vers un chemin prenant en charge la vision ; envoyez les requêtes avec appels d’outils uniquement vers des modèles qui prennent en charge le contrat d’outils approuvé ; envoyez les résumés internes par lots vers une route économique.
À utiliser lorsque : la décision est explicable à partir des métadonnées de la requête et que les règles sont suffisamment peu nombreuses pour être révisées.
À surveiller : la prolifération des règles. Placez les règles dans un fichier ou service de politique versionné, plutôt que de disperser les vérifications de fournisseurs dans le code de l’application.
3. Routage basé sur les capacités
Le routeur part d’un registre des capacités des modèles plutôt que du seul texte du prompt. Il filtre selon la famille d’endpoints, le contexte, les modalités prises en charge, le comportement des outils, la prise en charge des sorties structurées, la région et les autorisations du compte.
À utiliser lorsque : une application comporte plusieurs types d’endpoints ou des modèles aux contrats sensiblement différents.
À surveiller : les données de catalogue obsolètes. Traitez les ID de modèles, les capacités et les dépréciations comme des données opérationnelles nécessitant une vérification régulière.
4. Routage pondéré selon le coût, la qualité, la latence et la fiabilité
Les routes éligibles reçoivent un score selon l’objectif actuel. C’est la réponse courante à qu’est-ce que le routage LLM lorsqu’une équipe souhaite plus de nuance qu’une règle fixe, tout en ayant besoin d’une politique explicable.
À utiliser lorsque : vous pouvez définir un signal d’acceptation mesurable et disposez de suffisamment de télémétrie de routage pour comparer les candidats.
À surveiller : la fausse précision. Un score n’est utile qu’à la hauteur des données de qualité, des hypothèses de coût, des signaux d’état de santé et des pondérations qui le sous-tendent. Ne laissez pas entendre qu’un score décimal prouve qu’un modèle est universellement meilleur.
5. Routage basé sur un classifieur
Un petit classifieur ou un classifieur basé sur un LLM étiquette la requête — par exemple, extraction simple, génération de code, raisonnement complexe ou contenu sensible sur le plan de la sécurité — puis la transmet à une politique prédéfinie pour cette classe.
À utiliser lorsque : l’intention du prompt prédit fortement le niveau de modèle approprié et que vous pouvez évaluer les erreurs du classifieur séparément des erreurs du modèle.
À surveiller : l’ajout d’une décision opaque avant l’appel au modèle. Conservez un chemin pour les faibles niveaux de confiance, consignez la classification et évaluez le classifieur sur des requêtes représentatives.
6. Routage de repli tenant compte de l’état de santé
Le chemin principal est sélectionné normalement, mais le routeur réagit aux délais d’expiration, aux surcharges, aux limites de débit ou à une dégradation de l’état de santé par une nouvelle tentative limitée, une sauvegarde équivalente, une file d’attente ou un échec contrôlé.
À utiliser lorsque : la disponibilité est importante et que vous avez identifié les sauvegardes compatibles avec le contrat.
À surveiller : le franchissement silencieux d’une limite sémantique. Un repli peut être approprié pour une complétion de texte réessayable, mais pas pour un agent utilisant des outils, un workflow modifiant l’état ou une sortie qui doit respecter un schéma strict. Consultez notre guide sur le routage d’agents multimodaux pour des exemples où les changements de modalité rendent les règles de repli plus strictes.
Élaborer une politique tenant compte des coûts sans perdre de vue la qualité
Tenir compte des coûts ne signifie pas « toujours sélectionner le modèle le moins cher ». Cela signifie attribuer au coût un rôle défini une fois que les vérifications requises de capacité, de politique et de contrat ont été effectuées.
Un modèle utile consiste à créer des classes de trafic avant de définir les pondérations :
| Classe de trafic | Priorité principale | Approche de routage courante | Stratégie de repli sûre |
|---|---|---|---|
| Assistant destiné aux clients | Qualité et contrat prévisible | Filtre de capacités + pondérations qualité/latence | Itinéraire équivalent approuvé uniquement |
| Extraction en arrière-plan | Débit et coût unitaire | Règles + pondérations coût/latence | Nouvelle tentative, mise en file d’attente ou itinéraire approuvé moins coûteux |
| Suite d’évaluation | Reproductibilité | Épingler le modèle et la version de la politique | Généralement aucun repli caché |
| Agent utilisant des outils | Compatibilité des outils et idempotence | Filtre de capacités + règles de risque | Arrêter et réconcilier en cas d’effets secondaires incertains |
| Génération de médias | Exigences relatives au point de terminaison et à la sortie | Filtres de modalité/point de terminaison + règles de budget | Échouer par défaut, sauf si la solution de secours a été testée |
Comparez ensuite le chiffre qui compte : le coût par résultat accepté, et pas seulement le coût par requête. Un itinéraire moins cher qui entraîne des tentatives supplémentaires, une revue humaine, des corrections de schéma ou des appels d’outils échoués peut coûter davantage par tâche terminée.
La documentation d’Amazon sur le routage émet la même réserve pratique dans un contexte différent : le routage automatisé a des limites, notamment des données d’entraînement propres à chaque itinéraire et des limites de prise en charge. Elle recommande de revoir régulièrement les performances et les coûts plutôt que de supposer qu’une décision de routage reste optimale indéfiniment. Votre propre politique doit être évaluée par rapport à votre propre mix de requêtes.
Une politique de routage sûre, en pseudocode
Cet exemple simplifié permet d’auditer la décision. Il ne suppose pas que chaque itinéraire peut traiter chaque requête.
const candidates = catalog
  .filter(route => route.isHealthy)
  .filter(route => route.supports(request.modality))
  .filter(route => route.supportsTools(request.requiredTools))
  .filter(route => route.allows(request.dataClass))
  .filter(route => route.withinBudget(request.budget));

if (candidates.length === 0) {
  return failClosed("No approved route for this request");
}

const primary = candidates
  .map(route => ({
    route,
    score: score(route, request.trafficClass),
  }))
  .sort((a, b) => b.score - a.score)[0];

const result = await call(primary.route, request);

if (isTransient(result.error) && request.isIdempotent) {
  return retryWithinBudget(primary.route, request);
}

if (canUseEquivalentFallback(result.error, request, primary.route)) {
  return call(selectApprovedFallback(candidates, primary.route), request);
}

return returnControlledError(result.error);
La politique doit émettre une raison d’itinéraire telle que tool_contract_required, budget_preferred, primary_unhealthy ou no_contract_safe_fallback. Ce petit détail rend le système beaucoup plus facile à déboguer qu’un message générique du type « le modèle a échoué ».
Comment mesurer si le routage LLM est utile
Le routage n’est pas une réussite parce qu’il a produit un nom de modèle. Il est réussi lorsqu’il améliore le résultat d’une charge de travail définie sans créer de risque inacceptable.
Suivez les résultats par classe de trafic, version de politique et itinéraire sélectionné :
- Taux de résultats acceptés : la part des réponses qui réussissent le test d’acceptation métier, de schéma ou de revue humaine.
- Coût par résultat accepté : coût total des modèles, des nouvelles tentatives et de la remédiation divisé par les tâches acceptées.
- Latence P50, P95 et P99 : segmentée par taille de requête et par itinéraire ; une moyenne peut masquer une latence de fin de distribution pénible.
- Taux de récupération par repli : fréquence à laquelle un repli produit un résultat acceptable, et pas simplement un HTTP 200.
- Taux d’échec de contrat : sortie structurée non valide, outils non pris en charge, incompatibilité de streaming ou champs requis manquants.
- Répartition des itinéraires : détermine si une nouvelle politique envoie de façon inattendue la majeure partie du trafic vers un chemin coûteux ou dégradé.
- Taux de rejet par la politique : fréquence à laquelle aucun candidat sûr n’existe — souvent un signal qu’il faut étendre les capacités approuvées plutôt qu’assouplir une barrière de protection.
Pour un tableau de bord pratique, consultez les métriques d’API de routage IA qui comptent vraiment. Ces métriques sont particulièrement utiles lorsqu’une modification du routage semble réduire le coût des tokens, mais diminue les résultats acceptés.
Quand avez-vous besoin du routage LLM ?
Vous n’avez peut-être pas besoin d’un routeur lorsqu’un seul fournisseur, un seul point de terminaison et une seule charge de travail stable répondent à vos exigences. Épinglez le modèle, définissez des délais d’expiration et des nouvelles tentatives clairs, puis mesurez d’abord la référence.
Le routage LLM devient utile lorsqu’au moins l’une de ces conditions est vraie :
- Différents types de requêtes nécessitent différentes capacités, enveloppes de coûts ou objectifs de latence.
- Vous devez conserver les choix de fournisseur, de modèle et de région derrière une limite de politique.
- Une panne, un problème de quota ou une dépréciation nécessite un chemin de réponse sûr.
- Vous souhaitez comparer des candidats sans réécrire chaque appelant.
- Vous avez besoin d’un enregistrement de l’itinéraire qui a traité une requête et de la raison.
Si cela ressemble à votre stack, une passerelle peut faciliter la gestion de la frontière opérationnelle. La documentation de Flatkey décrit une URL de base compatible avec OpenAI et une clé API unique pour les modèles pris en charge ; les appelants choisissent un identifiant de modèle par requête, tandis que la plateforme documente le basculement automatique en amont. Commencez par fixer un modèle et journaliser les résultats, puis introduisez une politique de routage explicite pour les classes de trafic qui en ont réellement besoin. Pour la prochaine étape architecturale, consultez notre checklist des exigences d’une passerelle API d’IA.
Pour des stratégies de routage, un modèle de politique et du code de production, consultez notre guide de routage des modèles.
Questions fréquentes
Qu’est-ce que le routage LLM par rapport au repli de modèle ?
Le routage LLM est le processus décisionnel plus large permettant de sélectionner un chemin d’exécution. Un repli de modèle est une action de récupération au sein de ce processus, utilisée uniquement lorsque l’itinéraire principal échoue et qu’un itinéraire alternatif est approuvé pour le même contrat de requête.
Qu’est-ce que le routage LLM dans une API multi-fournisseurs ?
Dans une API multi-fournisseurs, le routage LLM peut sélectionner un chemin de fournisseur ainsi qu’un modèle. La politique doit vérifier la compatibilité des points de terminaison, la politique relative aux données, les capacités du modèle, les unités tarifaires, l’état de santé et le comportement de repli avant de considérer deux fournisseurs comme équivalents.
Par quelle technique de routage LLM une nouvelle équipe devrait-elle commencer ?
Commencez par un routage statique complété par des vérifications explicites des capacités et de l’observabilité. Ajoutez des règles pour des classes de trafic clairement différentes. Passez au routage pondéré ou fondé sur un classifieur uniquement après avoir obtenu des tests représentatifs et un moyen de mesurer les résultats acceptés.
Un routeur LLM peut-il choisir automatiquement le modèle le moins cher ?
Il le peut, mais le coût ne doit jamais contourner les contraintes strictes. Filtrez d’abord selon les capacités approuvées et la compatibilité contractuelle, puis optimisez le prix parmi les itinéraires éligibles. Validez le résultat à l’aide du coût par résultat accepté, et non du seul prix par token.
La réponse pratique à « qu’est-ce que le routage LLM ? »
La réponse pratique à la question qu’est-ce que le routage LLM n’est pas « choisissez un modèle astucieux ». C’est « encodez les choix que votre équipe peut défendre ». Commencez par les capacités approuvées et les contraintes strictes ; utilisez des pondérations uniquement pour de véritables arbitrages ; limitez les replis et assurez leur compatibilité contractuelle ; et enregistrez chaque décision avec suffisamment de précision pour pouvoir l’améliorer ultérieurement.
Si vous centralisez l’accès aux modèles, utilisez cette frontière pour mener des expérimentations de routage contrôlées plutôt que de disperser la logique des fournisseurs dans chaque service. Pour en savoir plus, consultez la documentation de l’API Flatkey.