LLMルーティングとは?ルール、重み付け、コスト考慮ポリシーを解説
LLMルーティングとは、特定のAIリクエストを処理すべきモデル、プロバイダー経路、またはフォールバック経路を選択するプロセスです。決定はアプリケーションコードに固定することも、明示的なルールで行うことも、重み付けされた基準から算出することも、学習済み分類器に委任することもできます。目的は、すべてのリクエストを別々の経路に通すことではありません。各経路を意図的で、テスト可能かつ安全なものにすることです。
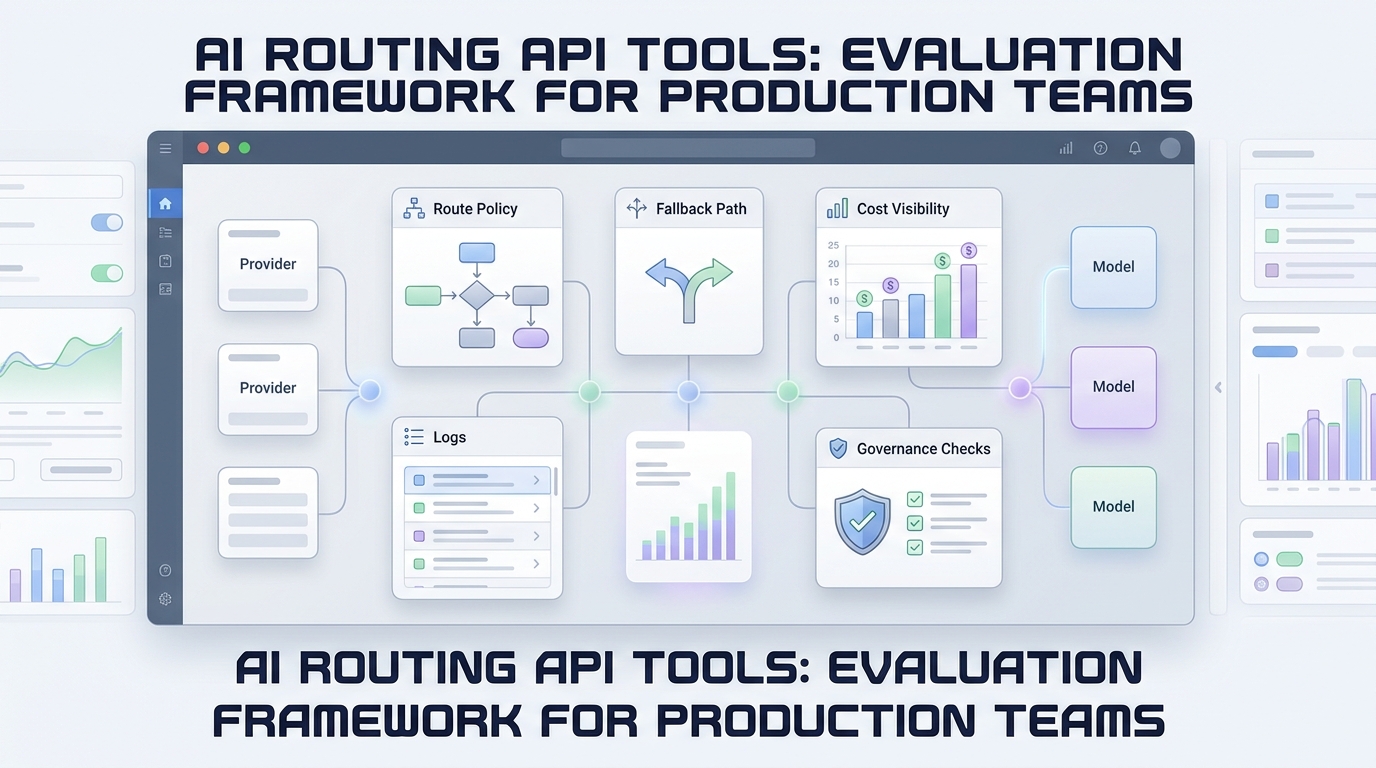
LLMルーティングとは何かと問われた場合、実務的な答えは次のとおりです。これは、アプリケーションリクエストとモデル呼び出しの間にあるポリシーレイヤーです。ルーターはまず、リクエストを満たせない選択肢を除外し、次に、能力、品質、レイテンシ、コスト、可用性、データポリシーなど、チームが設定した優先順位に基づいて、適格な経路を選択します。
この違いは重要です。低コストなモデルが、顧客向けワークフローにとって自動的に安全なデフォルトになるわけではありません。高性能なモデルが、単純な分類ジョブに自動的に適した選択となるわけでもありません。また、フォールバックが有用なのは、アプリケーションが期待する出力、ツール、データの契約を維持できる場合に限られます。
要約:優れたLLMルーティングは、ハード制約から始め、互換性のある候補のみをランク付けし、選択理由を記録し、バックアップが契約上安全な場合にのみフォールバックします。
これが、LLMルーティングとは何かに対する本番環境向けの回答が満たすべき基準です。つまり、エンジニアが、どの隠れたルールがトラフィックを動かしたのか推測することなく、確認、テスト、変更できる意思決定です。
LLMルーティングとは、正確には何か?
LLMルーティングとは何でしょうか?これは、受信したリクエストを、そのリクエストに対して承認された最適な実行経路にマッピングする意思決定プロセスです。経路は、特定のモデル、プロバイダー、リージョン、モデルグループ、またはテスト済みのフォールバックを指定する場合があります。
ルーターは、アプリケーション内、APIゲートウェイ、またはマネージドのモデルルーティングサービスに配置できます。たとえば、Amazon Bedrock intelligent prompt routingは、予測される応答品質とコストに基づき、モデルファミリー内の適格なモデルから選択します。Microsoft Foundry’s model routerは、バランス、品質、コスト重視のルーティングモードを提供します。これらは同じ基礎的な考え方の実装です。つまり、すべてのプロンプトを同一と見なすのではなく、意図的に選択するという考え方です。
LLMルーティングは、次のものとは異なります。
- ロードバランサー。ロードバランサーは、類似したサーバー間にリクエストを分散します。LLMルーターは、モデルの能力やタスクの結果も考慮します。
- リトライループ。同じ経路を再試行すれば一時的なエラーを解決できることがありますが、別のモデルがそのタスクに有効かどうかは判断しません。
- レビューされていないモデルの切り替え。JSONの形式、ツールの動作、プライバシー境界、または回答品質を変えてしまうバックアップへリクエストを移すと、明示的なエラーより深刻な障害を引き起こす可能性があります。
- モデルのトレーニング。ルーティングは、リクエスト時に提供経路を選択します。モデルの重みを変更するものではありません。
これらの意思決定をホストする境界について詳しくは、LLMゲートウェイとは何か、およびそれが有用になるタイミングに関するガイドをご覧ください。
LLMルーターが意思決定を行う仕組み
最も信頼性の高い設計では、適格性と優先度を分離します。まず、リクエストを満たせない選択肢を除外します。次に、現在のトラフィッククラスに対して残った経路をスコアリングします。
1. スコアリングの前にハード制約を適用する
ハード制約は交渉の余地がありません。安価または高速であっても、1つでも満たせないモデルは候補セットに残すべきではありません。
一般的なフィルターには次のものがあります。
| 制約 | 質問例 | 最初に考慮する理由 |
|---|---|---|
| モダリティ | この経路は、テキスト、画像、音声、または動画の入力を受け付けるか? | テキスト専用エンドポイントでは、マルチモーダルなリクエストを処理できません。 |
| 契約 | 必要なツール呼び出し、ストリーミング形式、または構造化出力をサポートしているか? | 構文的に有効な応答であっても、アプリケーションを壊す可能性があります。 |
| データポリシー | このプロバイダー、リージョン、または保持設定は、このリクエストに対して承認されているか? | ポリシーをトークン単価の低さと引き換えにすることはできません。 |
| 容量 | この経路には、十分なコンテキスト、クォータ、または健全な容量があるか? | すぐにリクエストを拒否する候補は適格ではありません。 |
| プロダクトポリシー | このモデルは、このテナント、環境、または実験で許可されているか? | ガバナンスを暗黙的なものではなく監査可能なものにします。 |
この順序により、すべてのモデルを交換可能なものとして扱う、よくあるルーティングの誤りを防げます。モデルは交換可能ではありません。ルーティングしようとする正確なエンドポイントとトラフィッククラスに対して、互換性を証明する必要があります。
2. 適格な候補をスコアリングする
フィルタリング後、経路は透明性のある重み付きスコアを使用できます。単純なパターンの1つは次のとおりです。
route score =
  quality_weight × expected_quality
  + latency_weight × (1 - normalized_latency)
  + cost_weight × (1 - normalized_cost)
  + reliability_weight × recent_route_health
この式は、意思決定のフレームワークであり、普遍的なベンチマークではありません。重要なのは、項が一貫して正規化され、重みがトラフィッククラスに属し、インシデント後にポリシーを説明できることです。
たとえば、バックグラウンドのタグ付けジョブでは、コストとスループットをより重視する場合があります。顧客対応のサポートエージェントでは、品質、ツール互換性、テールレイテンシをより重視する場合があります。規制対象のワークフローでは、データ所在地をスコアではなく絶対的なフィルターとして扱う場合があります。
3. 実行、監視、限定的なフォールバックの使用
ルーターは、選択したルート、スコア入力、ポリシーバージョン、リクエストID、レイテンシ、コスト見積もりまたは使用記録、結果ステータスをログに記録する必要があります。プライマリルートが失敗した場合、フォールバックの判断には独自のルールが必要です。
- エラーは、同じルートで再試行できるほど一時的なものか?
- リクエストは冪等か、それとも再試行によって外部アクションが重複する可能性があるか?
- フォールバックは出力とツールの契約を維持するか?
- フォールバックは、リクエストの予算またはデータ境界を超えることが許可されているか?
- 許可されていない場合、システムはキューに入れるべきか、段階的に機能を低下させるべきか、それとも制御されたエラーを返すべきか?
このため、フォールバックはルーティングの同義語ではなく、ルーティングの手法です。リカバリーの判断については、モデルフォールバック戦略のプレイブックで詳しく解説しています。
意図的に活用する6つのLLMルーティング手法
唯一最適なルーターはありません。まずはワークロードを満たせる最もシンプルな手法から始め、測定結果によって正当化される場合に複雑さを追加します。
1. 静的ルーティング
ワークロード内のすべてのリクエストを、1つの指定されたモデルまたはエンドポイントに送ります。
適している場合:ベースラインを確立する場合、安定した評価対象が必要な場合、または承認済みモデルが1つだけの限定的なワークロードの場合です。
注意点:静的ルートでは、単純な作業に高性能モデルを使用するコストや、1つのアップストリーム経路に依存する信頼性リスクが見えにくくなることがあります。
2. ルールベースのルーティング
明示的な条件でルートを選択します。画像を含むリクエストは視覚機能を備えた経路に送る、ツール呼び出しを含むリクエストは承認済みのツール契約をサポートするモデルにのみ送る、内部バッチ要約は経済的なルートに送る、といった方法です。
適している場合:リクエストメタデータから判断を説明でき、レビュー可能な程度にルール数が少ない場合です。
注意点:ルールの肥大化です。プロバイダーのチェックをアプリケーションコード全体に分散させるのではなく、バージョン管理されたポリシーファイルまたはサービスにルールを置きます。
3. 能力ベースのルーティング
ルーターはプロンプトテキストだけでなく、モデル能力レジストリから開始します。エンドポイントファミリー、コンテキスト、サポートされるモダリティ、ツールの動作、構造化出力のサポート、リージョン、アカウントの利用枠に基づいてフィルタリングします。
適している場合:アプリケーションに複数のエンドポイントタイプがある場合、または契約内容が大きく異なるモデルが複数ある場合です。
注意点:古いカタログデータです。モデルID、能力、非推奨化は、定期的な検証が必要な運用データとして扱います。
4. コスト、品質、レイテンシ、信頼性に重み付けしたルーティング
適格なルートには、現在の目的に基づくスコアが付与されます。固定ルール以上のきめ細かさを求めつつ、説明可能なポリシーも必要とするチームにとって、これがLLMルーティングとは何かという問いへの一般的な答えです。
適している場合:測定可能な受け入れシグナルを定義でき、候補を比較するための十分なルートテレメトリがある場合です。
注意点:見せかけの精度です。スコアが有用かどうかは、その背後にある品質データ、コストの前提、健全性シグナル、重みに左右されます。小数点付きのスコアが、あるモデルが普遍的に優れていることを証明するかのように示してはいけません。
5. 分類器ベースのルーティング
小規模な分類器またはLLMベースの分類器が、単純な抽出、コード生成、複雑な推論、安全性に配慮が必要なコンテンツなどのようにリクエストを分類し、そのクラス用に定義されたポリシーへ渡します。
適している場合:プロンプトの意図が適切なモデル階層を強く予測し、分類器のエラーをモデルのエラーとは別に評価できる場合です。
注意点:モデル呼び出しの前に不透明な判断を追加することです。低信頼度の経路を維持し、分類結果をログに記録し、代表的なリクエストに対して分類器を評価してください。
6. ヘルス認識フォールバックルーティング
プライマリ経路は通常どおり選択されますが、ルーターはタイムアウト、過負荷、レート制限、または健全性の低下に対して、限定的な再試行、同等のバックアップ、キューイング、または制御された失敗で対応します。
適している場合:可用性が重要であり、どのバックアップが契約互換であるかを特定している場合です。
注意点:意味的な境界を知らないうちに越えてしまうことです。再試行可能なテキスト補完にはフォールバックが適切でも、ツールを使用するエージェント、状態を変更するワークフロー、または厳格なスキーマに一致しなければならない出力には適さない場合があります。モダリティの変更によってフォールバックルールがより厳しくなる例については、マルチモーダルエージェントルーティングのガイドを参照してください。
品質を見失わずにコスト考慮ポリシーを構築する
コスト考慮とは、「常に最も安価なモデルを選ぶ」という意味ではありません。必要な能力、ポリシー、契約のチェックに合格した後で、コストに明確な役割を与えることを意味します。
有用なパターンは、重みを設定する前にトラフィッククラスを作成することです。
| トラフィッククラス | 最優先事項 | 一般的なルーティングアプローチ | 安全なフォールバック方針 |
|---|---|---|---|
| 顧客向けアシスタント | 品質と予測可能な契約 | 機能フィルター + 品質/レイテンシの重み付け | 同等の承認済みルートのみ |
| バックグラウンド抽出 | スループットと単位コスト | ルール + コスト/レイテンシの重み付け | 再試行、キューイング、または低コストの承認済みルート |
| 評価スイート | 再現性 | モデルとポリシーのバージョンを固定 | 通常、隠れたフォールバックは使用しない |
| ツール使用エージェント | ツール互換性と冪等性 | 機能フィルター + リスクルール | 副作用が不確かな場合は停止して整合性を確認 |
| メディア生成 | エンドポイントおよび出力要件 | モダリティ/エンドポイントのフィルター + 予算ルール | バックアップがテスト済みでない限りフェイルクローズ |
次に重要な数値、つまりリクエストあたりのコストだけではなく、受け入れられた成果あたりのコストを比較します。再試行の増加、人手レビュー、スキーマ修正、ツール呼び出しの失敗を招く低価格のルートは、完了タスクあたりではより高コストになる可能性があります。
Amazonのルーティングに関するドキュメントでも、別の文脈で同じ実務上の注意点が示されています。自動ルーティングには、ルート固有のトレーニングデータやサポート範囲などの制限があります。ルーティング判断が永久に最適であると想定するのではなく、パフォーマンスとコストを継続的にレビューすることが推奨されています。自社のポリシーは、自社のリクエスト構成に対して評価する必要があります。
安全なルーティングポリシーの疑似コード
この簡略化した例では、意思決定を監査可能な状態に保ちます。すべてのルートがすべてのリクエストを処理できるとは仮定していません。
const candidates = catalog
  .filter(route => route.isHealthy)
  .filter(route => route.supports(request.modality))
  .filter(route => route.supportsTools(request.requiredTools))
  .filter(route => route.allows(request.dataClass))
  .filter(route => route.withinBudget(request.budget));

if (candidates.length === 0) {
  return failClosed("No approved route for this request");
}

const primary = candidates
  .map(route => ({
    route,
    score: score(route, request.trafficClass),
  }))
  .sort((a, b) => b.score - a.score)[0];

const result = await call(primary.route, request);

if (isTransient(result.error) && request.isIdempotent) {
  return retryWithinBudget(primary.route, request);
}

if (canUseEquivalentFallback(result.error, request, primary.route)) {
  return call(selectApprovedFallback(candidates, primary.route), request);
}

return returnControlledError(result.error);
ポリシーでは、tool_contract_required、budget_preferred、primary_unhealthy、no_contract_safe_fallbackなどのルート理由を出力する必要があります。この小さな詳細により、一般的な「モデルが失敗しました」というメッセージよりも、システムのデバッグがはるかに容易になります。
LLMルーティングが役立っているかを測定する方法
ルーティングは、モデル名を出力したからといって成功ではありません。許容できないリスクを生じさせずに、定義されたワークロードの成果を改善したときに成功といえます。
トラフィッククラス、ポリシーバージョン、選択されたルートごとに結果を追跡します。
- 受け入れ済み成果率: ビジネス、スキーマ、または人手レビューによる受け入れテストに合格した応答の割合。
- 受け入れられた成果あたりのコスト: モデル、再試行、修正対応の総コストを、受け入れられたタスク数で割ったもの。
- P50、P95、P99レイテンシ: リクエストサイズとルート別に分類します。平均値では、深刻なテールレイテンシが隠れることがあります。
- フォールバック復旧率: フォールバックが単にHTTP 200を返した頻度ではなく、許容可能な結果を生成した頻度。
- 契約違反率: 無効な構造化出力、サポートされていないツール、ストリーミングの非互換性、または必須フィールドの欠落。
- ルート分布: 新しいポリシーが、予期せずトラフィックの大半を高コストまたは劣化したパスに送っていないか。
- ポリシー拒否率: 安全な候補が存在しない頻度。多くの場合、ガードレールを緩和するのではなく、承認済みの機能を拡充すべきシグナルです。
実用的なスコアカードについては、実際に重要なAIルーティングAPIメトリクスを参照してください。ルーティングの変更によってトークンコストは下がったように見えても、受け入れられる成果が減少する場合に、これらのメトリクスは特に役立ちます。
LLMルーティングが必要になるのはいつですか?
1つのプロバイダー、1つのエンドポイント、1つの安定したワークロードで要件を満たせる場合は、ルーターは不要かもしれません。モデルを固定し、明確なタイムアウトと再試行を設定して、まずベースラインを測定してください。
次のいずれかに該当する場合、LLMルーティングの価値が高まります。
- リクエストの種類ごとに、異なる機能、コスト上限、またはレイテンシ目標が必要である。
- プロバイダー、モデル、リージョンの選択をポリシー境界の背後に置く必要がある。
- 障害、クォータの問題、または廃止に対して安全な対応パスが必要である。
- すべての呼び出し元を書き換えずに候補を比較したい。
- どのルートがなぜリクエストを処理したのかを記録する必要がある。
これが貴社のスタックに当てはまる場合、ゲートウェイを使用すると運用上の境界を管理しやすくなります。Flatkeyのドキュメントでは、サポート対象モデル向けのOpenAI互換ベースURLと単一のAPIキーについて説明しています。呼び出し元はリクエストごとにモデルIDを選択し、プラットフォームは自動アップストリームフェイルオーバーを文書化しています。まずモデルを固定して結果をログに記録し、その後、本当に必要なトラフィッククラスに対して明示的なルーティングポリシーを導入してください。次のアーキテクチャ上のステップについては、AI APIゲートウェイ要件チェックリストをお読みください。
ルーティング戦略、ポリシーテンプレート、プロダクションコードについては、モデルルーティングガイドをお読みください。
よくある質問
LLMルーティングとモデルフォールバックの違いは何ですか?
LLMルーティングは、実行パスを選択するためのより広範な意思決定プロセスです。モデルフォールバックはそのプロセス内の復旧アクションの1つであり、プライマリルートが失敗し、同じリクエスト契約に対して代替ルートが承認されている場合にのみ使用されます。
マルチプロバイダーAPIにおけるLLMルーティングとは何ですか?
マルチプロバイダーAPIでは、LLMルーティングはモデルだけでなくプロバイダーパスも選択できます。2つのプロバイダーを同等とみなす前に、ポリシーでエンドポイント互換性、データポリシー、モデル能力、価格単位、健全性、フォールバック動作を検証する必要があります。
新しいチームはどのLLMルーティング手法から始めるべきですか?
静的ルーティングに、明示的な能力チェックとオブザーバビリティを組み合わせて始めてください。明確に異なるトラフィッククラスに対してルールを追加します。代表的なテストと、受け入れられた結果を測定する方法を用意してから、重み付けまたは分類器ベースのルーティングへ移行してください。
LLMルーターは最も安価なモデルを自動的に選択できますか?
可能ですが、コストによってハード制約を回避してはいけません。まず承認済みの能力と契約互換性でフィルタリングし、その後、適格なルートの中で価格を最適化してください。トークン単価だけでなく、受け入れられた結果あたりのコストで結果を検証します。
「LLMルーティングとは何か?」への実践的な答え
LLMルーティングとは何かに対する実践的な答えは、「賢いモデルを選ぶ」ことではありません。「チームが正当化できる選択をエンコードする」ことです。承認済みの能力とハード制約から始め、実際のトレードオフに対してのみ重みを使用し、フォールバックを限定的かつ契約上安全なものに保ち、後で改善できるようにすべての決定を十分に記録してください。
モデルアクセスを一元化している場合は、その境界を利用して、プロバイダーロジックをすべてのサービスに分散させるのではなく、制御されたルーティング実験を実行してください。詳細はFlatkey APIドキュメントをご覧ください。