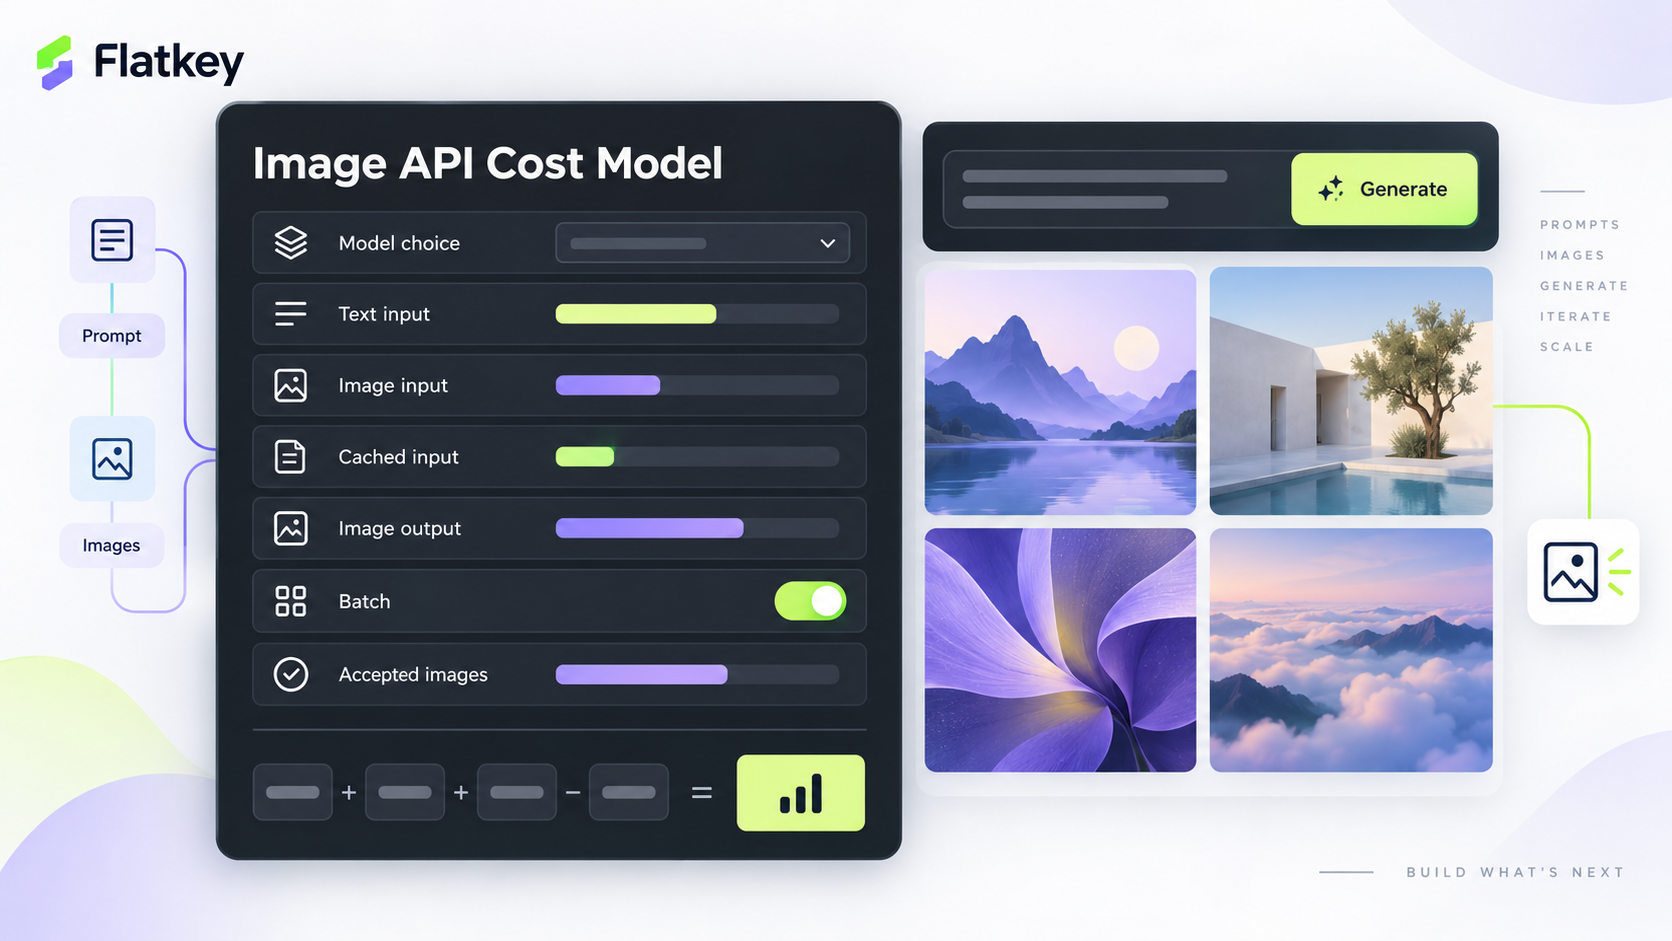
El precio de la API de imágenes de OpenAI no es un precio único por imagen. En la documentación actual de la API de OpenAI, el coste de generación de imágenes se compone de tokens de entrada de texto, tokens de entrada de imagen, entrada en caché cuando aplica, tokens de salida de imagen y, en ocasiones, de los tokens del modelo principal utilizados por la API de Responses.
Para los equipos que integran la generación de imágenes en un producto, la pregunta práctica no es "¿cuánto cuesta una imagen?" Es: ¿cuánto cuesta una imagen aceptada después de incluir prompts, imágenes de referencia, reintentos, vistas previas en streaming, ajustes de calidad y generaciones rechazadas?
Esta guía explica el modelo actual de precios de la API de generación de imágenes de OpenAI, qué cambió con GPT Image 2.5, cómo construir una fórmula de coste fiable y cómo controlar el gasto antes de que un flujo creativo sea difícil de auditar.
Respuesta rápida: qué incluye el precio de la API de imágenes de OpenAI
A 13 de octubre de 2026, la página oficial de precios de OpenAI muestra filas de GPT Image por modalidad y cobra por 1M tokens. La guía de generación de imágenes indica que las nuevas integraciones deben usar uno de los modelos GPT Image 2.5, gpt-image-2.5-sunburst o gpt-image-2.5-flare.
La fórmula de presupuesto es:
estimated request cost =
  text input tokens x text input rate
+ image input tokens x image input rate
+ cached input tokens x cached input rate, when eligible
+ image output tokens x image output rate
+ mainline model tokens, when using the Responses API image tool
+ streamed partial image tokens, when partial_images > 0
Por eso el precio de la API de imágenes de OpenAI cambia entre tres solicitudes que todas devuelven "una imagen". Un prompt corto de texto a imagen, una edición con dos imágenes de referencia y una llamada interactiva a una herramienta que transmite vistas previas parciales pueden tener perfiles de coste muy distintos.
Filas actuales de precios de la API GPT Image
OpenAI muestra actualmente estas filas estándar de generación de imágenes. Trate la tabla como una referencia del día de publicación y vuelva a comprobar la página oficial de precios antes de comprometer cifras de adquisición.
| Modelo | Modalidad | Entrada | Entrada en caché | Salida | Nota de presupuesto |
|---|---|---|---|---|---|
gpt-image-2.5-sunburst |
Imagen | $8.00 / 1M tokens | $2.00 / 1M tokens | $30.00 / 1M tokens | Úselo cuando la precisión de edición sea lo más importante. |
gpt-image-2.5-sunburst |
Texto | $5.00 / 1M tokens | $1.25 / 1M tokens | No aparece | Coste de prompt e instrucciones. |
gpt-image-2.5-flare |
Imagen | $8.00 / 1M tokens | $2.00 / 1M tokens | $30.00 / 1M tokens | Úselo para una generación diaria rápida y de alta calidad. |
gpt-image-2.5-flare |
Texto | $5.00 / 1M tokens | $1.25 / 1M tokens | No aparece | Coste de prompt e instrucciones. |
gpt-image-2 |
Imagen | $8.00 / 1M tokens | $2.00 / 1M tokens | $30.00 / 1M tokens | Fila actual anterior; no asuma que sea el nuevo valor predeterminado óptimo. |
gpt-image-2 |
Texto | $5.00 / 1M tokens | $1.25 / 1M tokens | No aparece | Misma tarifa de texto que las filas de GPT Image 2.5. |
gpt-image-1.5 |
Imagen | $8.00 / 1M tokens | $2.00 / 1M tokens | $32.00 / 1M tokens | Incluye una fila de salida de texto listada. |
gpt-image-1.5 |
Texto | $5.00 / 1M tokens | $1.25 / 1M tokens | $10.00 / 1M tokens | Solo relevante si su ruta aún usa este modelo. |
gpt-image-1-mini |
Imagen | $2.50 / 1M tokens | $0.25 / 1M tokens | $8.00 / 1M tokens | Candidato para borradores de menor coste o experimentos de alto volumen. |
gpt-image-1-mini |
Texto | $2.00 / 1M tokens | $0.20 / 1M tokens | No aparece | Fila de prompt más barata que los modelos principales GPT Image. |
La página de precios de OpenAI también enumera precios Batch para estos modelos de imagen a tarifas de tokens más bajas. Batch puede importar cuando el trabajo es asíncrono: cargas masivas de catálogo, variantes creativas nocturnas, generación de conjuntos de prueba, ejecuciones de regresión de prompts y lotes internos de QA.
GPT Image 2.5: Sunburst frente a Flare
La guía de generación de imágenes describe dos modelos GPT Image 2.5:
| Modelo | Cuándo usarlo | Diferencia de precio |
|---|---|---|
gpt-image-2.5-sunburst |
La precisión de edición es lo más importante. | Mismas tarifas de tokens listadas que Flare. |
gpt-image-2.5-flare |
Necesita generación de imágenes diaria rápida y de alta calidad. | Mismas tarifas de tokens listadas que Sunburst. |
La matización importante: tarifas de tokens iguales no significan el mismo coste por solicitud. La guía de OpenAI indica que el consumo de tokens puede variar según el modelo y el ajuste de calidad. Si dos modelos usan la misma tarifa de salida de imagen de $30 / 1M tokens, pero uno consume más tokens de salida para un tamaño y una calidad elegidos, la imagen generada cuesta más.
Para adquisiciones, compare el usage real de prompts representativos en lugar de asumir que el modelo con la misma fila de precio tiene el mismo coste por imagen.
API Responses frente a API Images
OpenAI expone la generación de imágenes a través de dos vías:
| Ruta de API | Mejor caso de uso | Implicación en el coste |
|---|---|---|
| Images API | Generación directa de imágenes o ediciones de imágenes donde el trabajo con la imagen es la solicitud. | Establece directamente el modelo de imagen y luego presupuestar la entrada de texto, la entrada de imagen y la salida de imagen. |
| Herramienta de imagen de Responses API | Experiencias de imagen conversacionales, de varios pasos o editables. | Añade el uso de tokens del modelo principal al coste de generación de imágenes. |
Esto importa para los precios de la API de imágenes de OpenAI porque un flujo de trabajo de Responses API puede incluir tanto un modelo principal como la herramienta de generación de imágenes. Si tu aplicación pide a un modelo principal que razone sobre el contexto del usuario, decida cuándo generar, revise un prompt y luego invoque GPT Image, la factura final no es solo la fila de salida de imagen.
Usa Images API cuando el flujo de trabajo sea una generación o edición directa. Usa Responses API cuando el flujo de trabajo necesite estado conversacional, orquestación de herramientas o un modelo que decida si generar o editar.
El precio de entrada en caché es más limitado de lo que parece
La documentación de OpenAI señala una restricción específica: el precio de entrada en caché para GPT Image 2 y GPT Image 2.5 solo se aplica a la herramienta de generación de imágenes en Responses API. No se aplica a solicitudes directas de Images API, incluyendo /v1/images/edits.
Ese es un error habitual de presupuestación. Si una hoja de cálculo aplica tarifas en caché a cada prompt repetido o edición de imagen, infraestimará el gasto. Crea líneas de presupuesto separadas:
| Flujo de trabajo | ¿Puede usar precios de entrada de generación de imágenes en caché? | Qué hacer |
|---|---|---|
| Herramienta de generación de imágenes de Responses API | Sí, cuando sea elegible. | Haz un seguimiento externo de la facturación en caché porque los recuentos de tokens en caché pueden no aparecer en usage. |
| Generación directa de Images API | No, según la guía de OpenAI. | Usa las filas estándar de entrada y salida. |
| Ediciones directas de Images API | No, según la guía de OpenAI. | Presupuesta los tokens de entrada de imagen a tarifas estándar. |
La regla segura es simple: trata la entrada en caché como un descuento que verificas en la facturación, no como una suposición por defecto en las estimaciones del producto.
Calidad, tamaño e imágenes parciales
GPT Image 2.5 añade los ajustes de calidad xhigh y max. La misma guía dice que gpt-image-2.5-sunburst y gpt-image-2.5-flare admiten low, medium, high, xhigh y max, mientras que GPT Image 2 anterior admite hasta high.
Los tamaños recomendados incluyen 1024x1024, 1536x1024 y 1024x1536. La guía también indica que GPT Image 2.5 admite dimensiones personalizadas como cadenas WIDTHxHEIGHT con restricciones: el ancho y el alto deben ser múltiplos de 16, la proporción debe estar entre 1:3 y 3:1, ningún borde puede superar los 3840 píxeles y el total de píxeles debe ajustarse al rango documentado.
De esto se derivan tres controles de presupuesto:
- No dejes la calidad en
autodurante las pruebas de coste. Usa valores explícitos para que los resultados sean comparables. - Prueba tus tamaños reales, no solo ejemplos cuadrados.
- Si transmites imágenes parciales, añade el coste de la vista previa. OpenAI dice que cada imagen parcial solicitada con
partial_imagesincurre en 100 tokens adicionales de salida de imagen.
Para interfaces creativas interactivas, las vistas previas parciales pueden mejorar la latencia percibida. También añaden un coste medible en tokens de salida. Hazles seguimiento como una decisión de producto, no como un detalle de implementación oculto dentro de la llamada del SDK.
Una hoja de cálculo práctica de costes
Usa esta hoja antes del lanzamiento.
| Entrada | Valor de ejemplo | De dónde procede | Por qué importa |
|---|---|---|---|
| Solicitudes por mes | 50,000 | Previsión del producto | Volumen total. |
| Imágenes generadas por solicitud | 1.4 | Diseño del producto | Las variantes multiplican el coste de salida. |
| Tasa de imágenes aceptadas | 42% | QA o telemetría de producción | Revela desperdicio por salida creativa rechazada. |
| Promedio de tokens de entrada de texto | Medir desde usage |
Respuesta de la API | Los prompts y las plantillas ocultas añaden coste. |
| Promedio de tokens de entrada de imagen | Medir desde usage cuando se expone |
Respuesta de la API | Las imágenes de referencia y las ediciones pueden dominar el coste de entrada. |
| Promedio de tokens de salida de imagen | Medir por modelo, tamaño y calidad | Respuesta de la API o calculadora | Principal impulsor del coste de generación. |
| Imágenes parciales por solicitud | 0-3 | Ajuste de streaming de la interfaz | Añade 100 tokens de salida por imagen parcial. |
| Tasa de reintentos | Registros de producción | Registros de gateway, app o proveedor | Los reintentos pueden duplicar las rutas fallidas. |
| Proporción de Batch | 0-100% | Diseño del trabajo | El trabajo asíncrono puede optar a tarifas Batch más bajas. |
Luego calcula:
coste por imagen generada =
  gasto total del flujo de trabajo de imágenes / imágenes generadas

coste por imagen aceptada =
  gasto total del flujo de trabajo de imágenes / imágenes aceptadas
El segundo número es el que debe usar compras. Un modelo que parece más barato por imagen generada puede ser más caro por imagen aceptada si crea más variantes rechazadas.
Errores comunes de presupuesto
El primer error es tratar GPT Image como un "precio fijo por imagen." Los precios actuales de la API de imágenes de OpenAI se basan en tokens, y OpenAI indica explícitamente a los equipos que usen usage para medir el consumo de tokens de sus prompts, tamaños y ajustes de calidad.
El segundo error es ignorar el modelo principal en los flujos de la Responses API. Si un modelo como GPT-5.5 decide cuándo y cómo llamar a la herramienta de imágenes, el uso de tokens del modelo principal forma parte del coste de la solicitud.
El tercer error es aplicar tarifas de entrada en caché a ediciones directas de la Images API. La guía de OpenAI dice que los precios de entrada en caché para GPT Image 2 y GPT Image 2.5 no se aplican a las solicitudes directas de la Images API.
El cuarto error es medir llamadas HTTP correctas en lugar de imágenes aceptadas. Los equipos de producto suelen rechazar algunas imágenes generadas por calidad, ajuste de marca, política o preferencia del usuario. La verdadera unidad es la salida creativa aceptada.
El quinto error es olvidarse de las imágenes parciales. Si la interfaz transmite en streaming dos imágenes de vista previa y una imagen final, la experiencia de vista previa tiene un coste en tokens que debe incluirse en el presupuesto.
Cuando Flatkey ayuda
Flatkey es útil cuando tu equipo quiere un único lugar para enrutar y revisar el uso de la API de modelos en lugar de conciliar consolas separadas de proveedores. Para los flujos de trabajo de imágenes, eso significa usar la página actual de precios del proveedor para entender los mecanismos de coste directo y, después, consultar el directorio de modelos de Flatkey, la página de precios y los registros de uso para la ruta exacta del modelo que usa tu aplicación.
En la práctica, Flatkey ayuda a los equipos a formular mejores preguntas:
- ¿Qué modelo usó realmente esta solicitud?
- ¿Qué clave, entorno o cliente generó el gasto?
- ¿La solicitud se completó, falló, se reintentó o fue rechazada aguas abajo?
- ¿Cuál fue el coste por imagen aceptada, no solo por llamada a la API?
- ¿Esta carga de trabajo debería ejecutarse directamente, a través de un gateway o en una ruta de lote asíncrona?
Si ya estás usando un cliente compatible con OpenAI, empieza con la guía rápida de la API de Flatkey, y luego compara los costes del flujo de trabajo de imágenes con la comparación de precios de APIs de generación de imágenes con IA, la gestión de cuotas de la API de IA y la comparación de precios de modelos de IA.
Lista de verificación de precios de la API de imágenes de OpenAI
Antes de publicar un flujo de trabajo de imágenes en producción, confirma:
- Que el modelo seleccionado es el actual:
gpt-image-2.5-sunburst,gpt-image-2.5-flareo una ruta anterior elegida deliberadamente. - Que la ruta de la API es explícita: Images API o la herramienta de imágenes de Responses API.
- Que la calidad y el tamaño están fijados para las pruebas de coste en lugar de dejarse en
auto. - Que los flujos de trabajo con imagen de referencia y edición se miden por separado de los flujos de trabajo de texto a imagen.
- Que las suposiciones de entrada en caché coinciden con la ruta de la API.
- Que la transmisión de imágenes parciales se contabiliza.
- Que los reintentos y las llamadas fallidas son visibles en los registros.
- Que la tasa de imágenes aceptadas se mide por producto o por QA.
- Que los candidatos por lotes se separan de las solicitudes de usuario en tiempo real.
- Que finanzas puede revisar el coste por modelo, entorno, cliente y flujo de trabajo.
Preguntas frecuentes
¿Cuánto cuesta la API de generación de imágenes de OpenAI?
Los precios de la API de generación de imágenes de OpenAI se basan en tokens. A fecha de 13 de octubre de 2026, OpenAI indica que la entrada de imagen de GPT Image 2.5 cuesta $8.00 / 1M tokens, la entrada de imagen en caché $2.00 / 1M tokens y la salida de imagen $30.00 / 1M tokens, con entrada de texto a $5.00 / 1M tokens y entrada de texto en caché a $1.25 / 1M tokens. Tu coste por imagen depende del modelo, la ruta de la API, el prompt, las imágenes de referencia, el tamaño, la calidad, las vistas previas en streaming y los reintentos.
¿GPT Image 2.5 tiene un precio diferente de GPT Image 2?
La página de precios estándar actualmente muestra las mismas tarifas de tokens de texto e imagen para gpt-image-2.5-sunburst, gpt-image-2.5-flare y gpt-image-2. Eso no garantiza el mismo coste por imagen porque el consumo real de tokens puede diferir según el modelo y el ajuste de calidad.
¿Se aplica el precio de entrada en caché a todas las solicitudes de imágenes de OpenAI?
No. La guía de generación de imágenes de OpenAI dice que el precio de entrada en caché para GPT Image 2 y GPT Image 2.5 se aplica solo a la herramienta de generación de imágenes en la Responses API. No se aplica a solicitudes directas de la Images API ni a ediciones directas de imágenes.
¿Las imágenes parciales transmitidas en streaming cuestan más?
Sí. La guía de OpenAI dice que cada imagen parcial solicitada con el parámetro partial_images incurre en 100 tokens adicionales de salida de imagen.
¿Cuál es la mejor manera de prever los precios de la API de imágenes de OpenAI para un producto?
Ejecuta prompts representativos con el modelo exacto, la ruta de la API, la calidad y el tamaño que planeas lanzar. Registra usage, la tasa de reintentos, el número de imágenes generadas, el número de imágenes aceptadas y si la solicitud usó imágenes parciales o Batch. Prevé el coste por imagen aceptada, no solo el coste por imagen generada.
Conclusión
La forma correcta de interpretar los precios de la API de imágenes de OpenAI es como una fórmula de coste, no como un precio estático por imagen. Empieza con las filas de precios actuales de GPT Image 2.5 y, después, mide el uso real de tokens para tus prompts, imágenes de referencia, ajustes de calidad y ruta de la API.
Si tu equipo enruta la generación de imágenes a través de Flatkey, mantén la misma disciplina: verifica la ruta del modelo, inspecciona el uso, separa los experimentos de la producción e informa del coste por imagen aceptada. Ese es el número que producto, ingeniería y compras pueden usar de verdad.
Fuentes consultadas
- OpenAI Developers, guía de generación de imágenes, consultado el 13 de octubre de 2026:
https://developers.openai.com/api/docs/guides/image-generation - OpenAI Developers, página de precios, consultado el 13 de octubre de 2026:
https://developers.openai.com/api/docs/pricing#image-generation - Mapa temático de Flatkey y cobertura previa de precios de la API de imágenes de OpenAI, consultado el 13 de octubre de 2026.