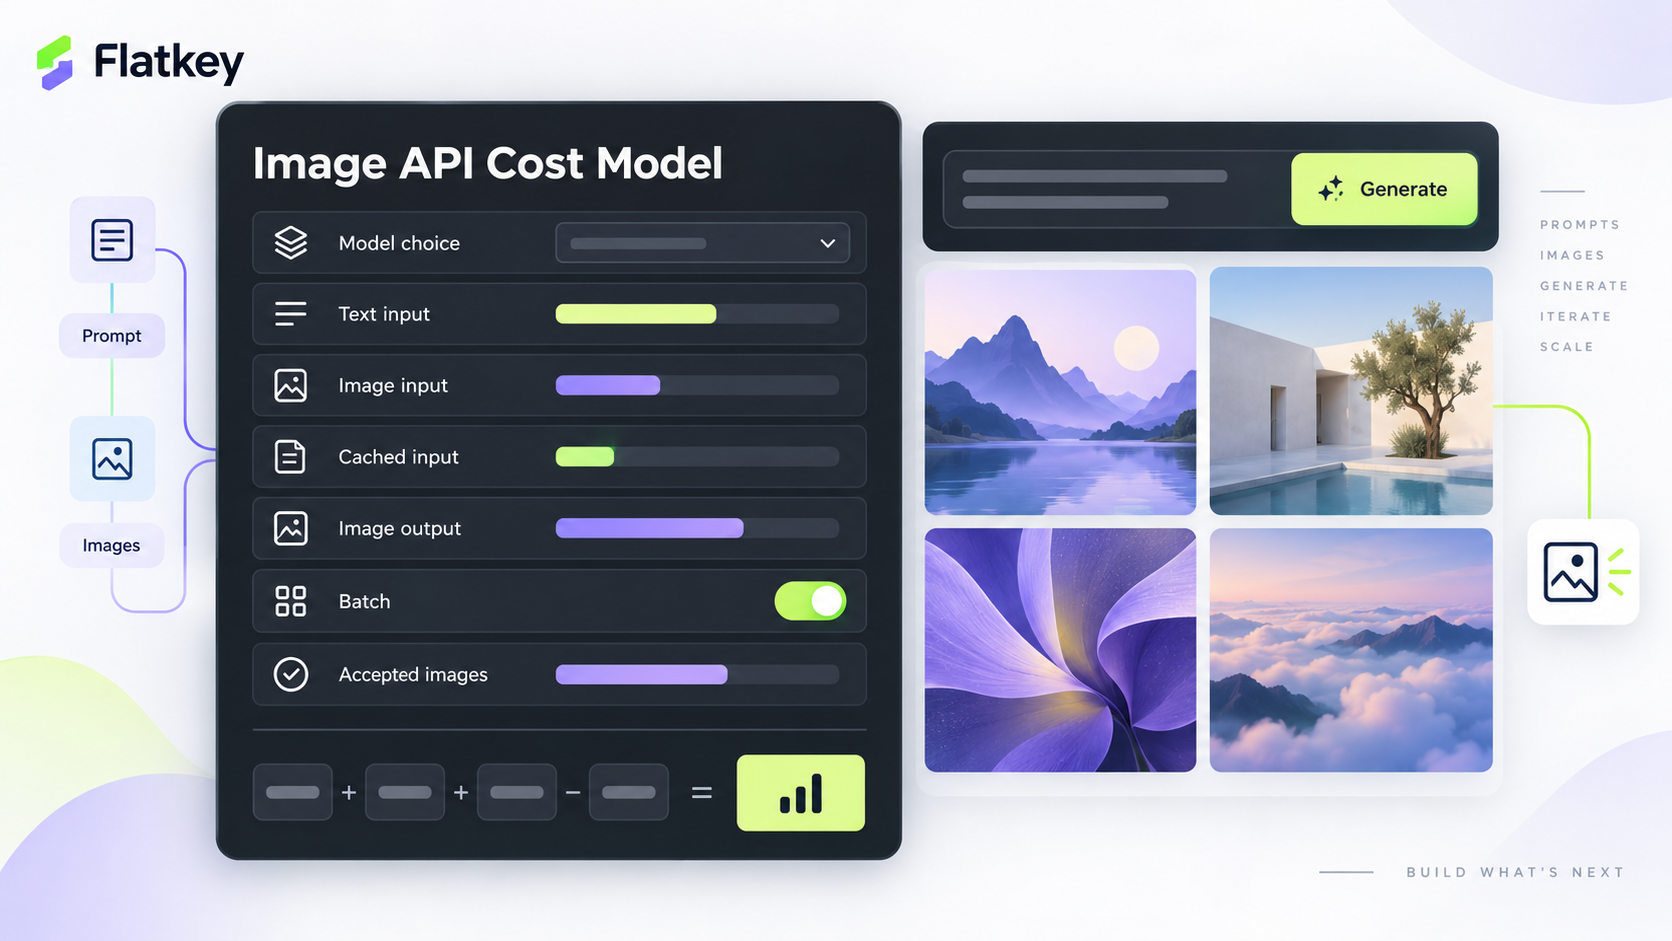
Os preços da API de imagem da OpenAI não são um preço único e fixo por imagem. Na documentação atual da API da OpenAI, o custo de geração de imagens é composto por tokens de entrada de texto, tokens de entrada de imagem, entrada em cache quando aplicável, tokens de saída de imagem e, às vezes, tokens do modelo principal usados pela Responses API.
Para equipes que estão integrando geração de imagens a um produto, a pergunta prática não é "quanto custa uma imagem?" É: quanto custa uma imagem aceita depois de incluir prompts, imagens de referência, tentativas repetidas, prévias em streaming, configurações de qualidade e gerações rejeitadas?
Este guia explica o modelo atual de preços da API de geração de imagens da OpenAI, o que mudou com o GPT Image 2.5, como construir uma fórmula de custo confiável e como controlar os gastos antes que um fluxo criativo fique difícil de auditar.
Resposta rápida: o que os preços da API de imagem da OpenAI incluem
Em 13 de outubro de 2026, a página oficial de preços da OpenAI lista as linhas do GPT Image por modalidade e cobra por 1M tokens. O guia de geração de imagens diz que novas integrações devem usar um dos modelos GPT Image 2.5, gpt-image-2.5-sunburst ou gpt-image-2.5-flare.
A fórmula de orçamento é:
estimated request cost =
  text input tokens x text input rate
+ image input tokens x image input rate
+ cached input tokens x cached input rate, when eligible
+ image output tokens x image output rate
+ mainline model tokens, when using the Responses API image tool
+ streamed partial image tokens, when partial_images > 0
É por isso que os preços da API de imagem da OpenAI mudam entre três requisições que todas retornam "uma imagem". Um prompt curto de texto para imagem, uma edição com duas imagens de referência e uma chamada de ferramenta interativa que transmite prévias parciais podem ter perfis de custo muito diferentes.
Linhas atuais de preços da API GPT Image
A OpenAI lista atualmente estas linhas padrão de geração de imagens. Trate a tabela como referência do dia de publicação e verifique novamente a página oficial de preços antes de comprometer números de aquisição.
| Modelo | Modalidade | Entrada | Entrada em cache | Saída | Observação de orçamento |
|---|---|---|---|---|---|
gpt-image-2.5-sunburst |
Imagem | $8.00 / 1M tokens | $2.00 / 1M tokens | $30.00 / 1M tokens | Use quando a precisão da edição for o mais importante. |
gpt-image-2.5-sunburst |
Texto | $5.00 / 1M tokens | $1.25 / 1M tokens | Não listado | Custo de prompt e instrução. |
gpt-image-2.5-flare |
Imagem | $8.00 / 1M tokens | $2.00 / 1M tokens | $30.00 / 1M tokens | Use para geração diária rápida e de alta qualidade. |
gpt-image-2.5-flare |
Texto | $5.00 / 1M tokens | $1.25 / 1M tokens | Não listado | Custo de prompt e instrução. |
gpt-image-2 |
Imagem | $8.00 / 1M tokens | $2.00 / 1M tokens | $30.00 / 1M tokens | Linha atual anterior; não presuma que seja o melhor novo padrão. |
gpt-image-2 |
Texto | $5.00 / 1M tokens | $1.25 / 1M tokens | Não listado | A mesma taxa de texto das linhas GPT Image 2.5. |
gpt-image-1.5 |
Imagem | $8.00 / 1M tokens | $2.00 / 1M tokens | $32.00 / 1M tokens | Inclui uma linha de saída de texto listada. |
gpt-image-1.5 |
Texto | $5.00 / 1M tokens | $1.25 / 1M tokens | $10.00 / 1M tokens | Relevante apenas se sua rota ainda usar este modelo. |
gpt-image-1-mini |
Imagem | $2.50 / 1M tokens | $0.25 / 1M tokens | $8.00 / 1M tokens | Candidato para rascunho de menor custo ou experimentos de alto volume. |
gpt-image-1-mini |
Texto | $2.00 / 1M tokens | $0.20 / 1M tokens | Não listado | Linha de prompt mais barata do que os modelos principais GPT Image. |
A página de preços da OpenAI também lista preços de Batch para esses modelos de imagem com taxas de token mais baixas. Batch pode ser importante quando o trabalho é assíncrono: backfills de catálogo, variações criativas noturnas, geração de conjunto de testes, execuções de regressão de prompts e lotes internos de QA.
GPT Image 2.5: Sunburst versus Flare
O guia de geração de imagens descreve dois modelos GPT Image 2.5:
| Modelo | Usar quando | Diferença de preço |
|---|---|---|
gpt-image-2.5-sunburst |
A precisão da edição for o mais importante. | As mesmas taxas de token listadas que o Flare. |
gpt-image-2.5-flare |
Você precisa de geração de imagens diária rápida e de alta qualidade. | As mesmas taxas de token listadas que o Sunburst. |
A nuance importante: taxas de token iguais não significam custo de requisição igual. O guia da OpenAI diz que o consumo de tokens pode variar por modelo e configuração de qualidade. Se dois modelos usam a mesma taxa de $30 / 1M tokens de saída de imagem, mas um consome mais tokens de saída para um tamanho e qualidade escolhidos, a imagem gerada custa mais.
Para aquisição, compare o usage real de prompts representativos em vez de assumir que o modelo com a mesma linha de preço tem o mesmo custo por imagem.
API Responses ou API Images
A OpenAI expõe a geração de imagens por dois caminhos:
| API Path | Best Fit | Cost Implication |
|---|---|---|
| Images API | Geração direta de imagens ou edições de imagens em que o trabalho com imagem é a solicitação. | Defina diretamente o modelo de imagem e então orce entrada de texto, entrada de imagem e saída de imagem. |
| Responses API image tool | Experiências conversacionais, em várias etapas ou editáveis com imagens. | Some o uso de tokens do modelo principal ao custo de geração de imagem. |
Isso é importante para os preços da API de imagem da OpenAI porque um fluxo de trabalho da Responses API pode incluir tanto um modelo principal quanto a ferramenta de geração de imagem. Se o seu aplicativo pede a um modelo principal que raciocine sobre o contexto do usuário, decida quando gerar, revise um prompt e então chame o GPT Image, a conta final não é apenas a linha de saída da imagem.
Use a Images API quando o fluxo de trabalho for uma geração direta ou uma edição. Use a Responses API quando o fluxo de trabalho precisar de estado de conversa, orquestração de ferramentas ou de um modelo decidindo se deve gerar ou editar.
O Preço de Entrada em Cache É Mais Restrito do Que Parece
A documentação da OpenAI destaca uma restrição específica: o preço de entrada em cache para o GPT Image 2 e o GPT Image 2.5 se aplica apenas à ferramenta de geração de imagens na Responses API. Ele não se aplica a solicitações diretas da Images API, incluindo /v1/images/edits.
Esse é um erro comum de orçamento. Se uma planilha aplicar tarifas em cache a cada prompt repetido ou edição de imagem, ela subestimará os gastos. Crie linhas de orçamento separadas:
| Workflow | Can Use Cached Image Generation Input Pricing? | What To Do |
|---|---|---|
| Responses API image generation tool | Yes, where eligible. | Rastreie a cobrança em cache externamente, porque as contagens de tokens em cache podem não aparecer em usage. |
| Direct Images API generation | No, based on OpenAI's guide. | Use linhas padrão de entrada e saída. |
| Direct Images API edits | No, based on OpenAI's guide. | Orce tokens de entrada de imagem nas tarifas padrão. |
A regra segura é simples: trate a entrada em cache como um desconto que você verifica na cobrança, e não como uma suposição padrão nas estimativas do produto.
Qualidade, Tamanho e Imagens Parciais
O GPT Image 2.5 adiciona as configurações de qualidade xhigh e max. O mesmo guia diz que gpt-image-2.5-sunburst e gpt-image-2.5-flare oferecem suporte a low, medium, high, xhigh e max, enquanto o GPT Image 2 anterior suporta até high.
Os tamanhos recomendados incluem 1024x1024, 1536x1024 e 1024x1536. O guia também diz que o GPT Image 2.5 suporta dimensões personalizadas como strings WIDTHxHEIGHT com restrições: largura e altura devem ser múltiplos de 16, a proporção deve ficar entre 1:3 e 3:1, nenhum dos lados pode exceder 3840 pixels e o total de pixels deve caber na faixa documentada.
Três controles de orçamento decorrem disso:
- Não deixe a qualidade em
autodurante testes de custo. Use valores explícitos para que os resultados sejam comparáveis. - Teste seus tamanhos reais, não apenas exemplos quadrados.
- Se você transmitir imagens parciais, adicione o custo de prévia. A OpenAI diz que cada imagem parcial solicitada com
partial_imagesincorre em 100 tokens adicionais de saída de imagem.
Para interfaces criativas interativas, prévias parciais podem melhorar a latência percebida. Elas também adicionam um custo mensurável de tokens de saída. Trate-as como uma decisão de produto, e não como um detalhe de implementação escondido dentro da chamada do SDK.
Uma Planilha Prática de Custos
Use esta planilha antes do lançamento.
| Input | Example Value | Where It Comes From | Why It Matters |
|---|---|---|---|
| Requests per month | 50,000 | Product forecast | Top-line volume. |
| Generated images per request | 1.4 | Product design | Variants multiply output cost. |
| Accepted image rate | 42% | QA or production telemetry | Reveals waste from rejected creative output. |
| Average text input tokens | Measure from usage |
API response | Prompts and hidden templates add cost. |
| Average image input tokens | Measure from usage where exposed |
API response | Reference images and edits can dominate input cost. |
| Average image output tokens | Measure by model, size, and quality | API response or calculator | Main driver of generation cost. |
| Partial images per request | 0-3 | UI streaming setting | Adds 100 output tokens per partial image. |
| Retry rate | Production logs | Gateway, app, or provider logs | Retries can double failed paths. |
| Batch share | 0-100% | Job design | Async work may qualify for lower Batch rates. |
Então calcule:
cost per generated image =
  total image workflow spend / generated images

cost per accepted image =
  total image workflow spend / accepted images
O segundo número é o que a equipe de compras deve usar. Um modelo que parece mais barato por imagem gerada pode ser mais caro por imagem aceita se criar mais variantes rejeitadas.
Erros comuns de orçamento
O primeiro erro é tratar o GPT Image como um "preço fixo por imagem". Os preços da API de Imagem da OpenAI atuais são baseados em tokens, e a OpenAI diz explicitamente para as equipes usarem usage para medir o consumo de tokens para seus prompts, tamanhos e configurações de qualidade.
O segundo erro é ignorar o modelo principal nos fluxos da Responses API. Se um modelo como o GPT-5.5 decide quando e como chamar a ferramenta de imagem, o uso de tokens do modelo principal faz parte do custo da solicitação.
O terceiro erro é aplicar taxas de entrada em cache a edições diretas da Images API. O guia da OpenAI diz que o preço de entrada em cache para GPT Image 2 e GPT Image 2.5 não se aplica a solicitações diretas da Images API.
O quarto erro é medir chamadas HTTP bem-sucedidas em vez de imagens aceitas. As equipes de produto normalmente rejeitam algumas imagens geradas por qualidade, adequação à marca, política ou preferência do usuário. A verdadeira unidade é a saída criativa aceita.
O quinto erro é esquecer imagens parciais. Se a interface transmite duas imagens de pré-visualização e uma imagem final, a experiência de pré-visualização tem um custo em tokens que deve entrar no orçamento.
Quando o Flatkey Ajuda
O Flatkey é útil quando sua equipe quer um único lugar para encaminhar e revisar o uso da API de modelos, em vez de reconciliar consoles separados de fornecedores. Para fluxos de trabalho de imagem, isso significa usar a página de preços atual do provedor para entender a mecânica de custo direto e, em seguida, verificar o diretório de modelos, a página de preços e os logs de uso do Flatkey para a rota exata de modelo que sua aplicação usa.
Na prática, o Flatkey ajuda as equipes a fazer perguntas melhores:
- Qual modelo esta solicitação realmente usou?
- Qual chave, ambiente ou cliente gerou o gasto?
- A solicitação foi bem-sucedida, falhou, foi repetida ou rejeitada a jusante?
- Qual foi o custo por imagem aceita, e não apenas por chamada de API?
- Essa carga de trabalho deve rodar diretamente, por meio de um gateway ou em um caminho assíncrono em lote?
Se você já está usando um cliente compatível com a OpenAI, comece com o guia rápido da API do Flatkey, depois compare os custos do fluxo de trabalho de imagem com comparação de preços da API de geração de imagens por IA, gestão de cotas de API de IA e comparação de preços de modelos de IA.
Checklist de Preços da API de Imagem da OpenAI
Antes de publicar um fluxo de trabalho de imagem em produção, confirme:
- O modelo selecionado é atual:
gpt-image-2.5-sunburst,gpt-image-2.5-flareou uma rota mais antiga deliberada. - O caminho da API é explícito: Images API ou ferramenta de imagem da Responses API.
- A qualidade e o tamanho são fixados para testes de custo, em vez de deixados em
auto. - Os fluxos de trabalho com imagem de referência e edição são medidos separadamente dos fluxos de texto para imagem.
- As suposições de entrada em cache correspondem ao caminho da API.
- O streaming de imagens parciais é contabilizado.
- As tentativas e chamadas com falha são visíveis nos logs.
- A taxa de imagens aceitas é medida pelo produto ou pela QA.
- Candidatos a lote são separados de solicitações de usuários em tempo real.
- As finanças podem revisar o custo por modelo, ambiente, cliente e fluxo de trabalho.
Perguntas frequentes
Quanto custa a API de geração de imagens da OpenAI?
Os preços da API de geração de imagens da OpenAI são baseados em tokens. Em 13 de outubro de 2026, a OpenAI lista a entrada de imagem do GPT Image 2.5 em US$ 8,00 / 1M tokens, a entrada de imagem em cache em US$ 2,00 / 1M tokens e a saída de imagem em US$ 30,00 / 1M tokens, com entrada de texto em US$ 5,00 / 1M tokens e entrada de texto em cache em US$ 1,25 / 1M tokens. Seu custo por imagem depende do modelo, do caminho da API, do prompt, das imagens de referência, do tamanho, da qualidade, das pré-visualizações transmitidas e das tentativas.
O GPT Image 2.5 tem preço diferente do GPT Image 2?
A página padrão de preços atualmente lista as mesmas taxas de tokens de texto e imagem para gpt-image-2.5-sunburst, gpt-image-2.5-flare e gpt-image-2. Isso não garante o mesmo custo por imagem porque o consumo real de tokens pode diferir conforme o modelo e a configuração de qualidade.
O preço de entrada em cache se aplica a todas as solicitações de imagem da OpenAI?
Não. O guia de geração de imagens da OpenAI diz que o preço de entrada em cache para GPT Image 2 e GPT Image 2.5 se aplica apenas à ferramenta de geração de imagens na Responses API. Ele não se aplica a solicitações diretas da Images API nem a edições diretas de imagem.
Imagens parciais transmitidas custam extra?
Sim. O guia da OpenAI diz que cada imagem parcial solicitada com o parâmetro partial_images incorre em mais 100 tokens de saída de imagem.
Qual é a melhor maneira de prever os preços da API de imagem da OpenAI para um produto?
Execute prompts representativos por meio do modelo exato, caminho da API, qualidade e tamanho que você planeja lançar. Registre usage, taxa de tentativas, contagem de imagens geradas, contagem de imagens aceitas e se a solicitação usou imagens parciais ou Batch. Preveja o custo por imagem aceita, não apenas o custo por imagem gerada.
Em Resumo
A maneira correta de ler os preços da API de Imagem da OpenAI é como uma fórmula de custo, não como um preço estático por imagem. Comece com as linhas atuais de preços do GPT Image 2.5 e, em seguida, meça o uso real de tokens para seus prompts, imagens de referência, configurações de qualidade e caminho da API.
Se sua equipe roteia a geração de imagens pelo Flatkey, mantenha a mesma disciplina: verifique a rota do modelo, inspecione o uso, separe experimentos da produção e reporte o custo por imagem aceita. Esse é o número que produto, engenharia e compras podem realmente usar.
Fontes Verificadas
- OpenAI Developers, guia de geração de imagens, verificado em 13 de outubro de 2026:
https://developers.openai.com/api/docs/guides/image-generation - OpenAI Developers, página de preços, verificado em 13 de outubro de 2026:
https://developers.openai.com/api/docs/pricing#image-generation - Mapa de tópicos da Flatkey e cobertura anterior dos preços da API de imagem da OpenAI, verificado em 13 de outubro de 2026.