
Fiabilidad y enrutamiento
Últimos artículos en Fiabilidad y enrutamiento.

¿Qué es el enrutamiento de LLM? Reglas, ponderaciones y políticas basadas en costes
¿Qué es el enrutamiento de LLM? Descubre cómo las reglas, las puntuaciones ponderadas, los filtros de capacidades, las alternativas y la evaluación hacen que las API multimodelo sean más fiables.
API proxy CLI: acceso, precios, integración y guía de producción
Descubre qué hace una API proxy CLI, cómo funcionan el acceso y los costes de CLIProxyAPI, cómo probarla de forma segura y cuándo una puerta de enlace gestionada es adecuada para producción.
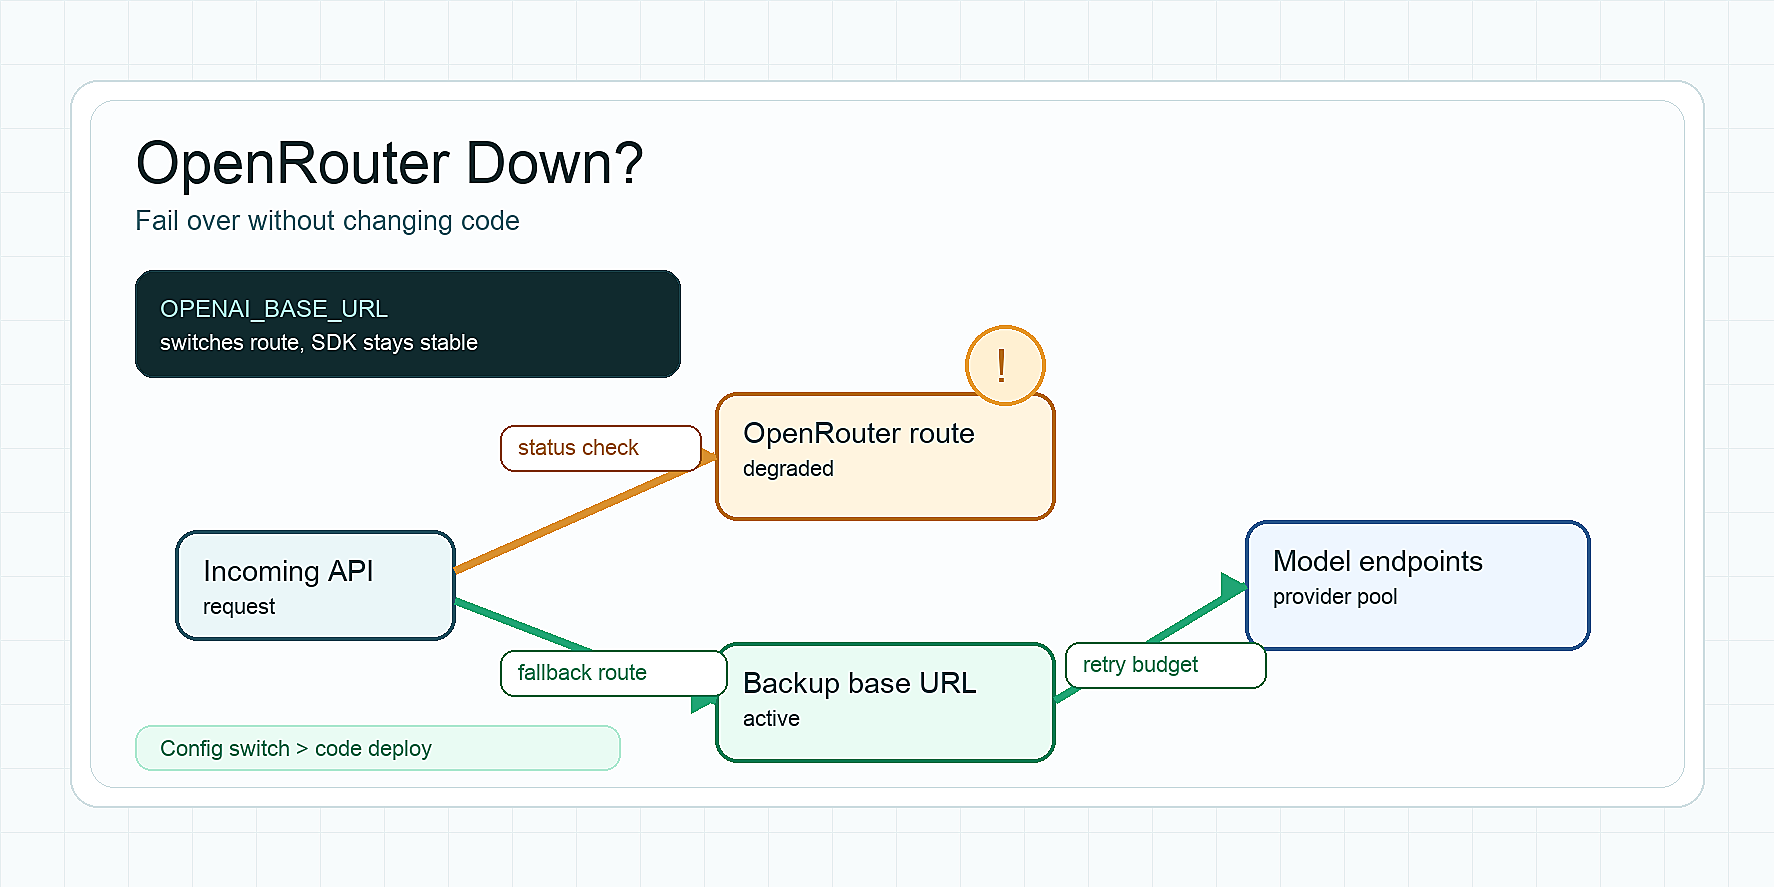
¿OpenRouter no funciona? Cómo hacer failover sin cambiar código
Comprueba si OpenRouter está caído, separa los errores del proveedor de los incidentes de la plataforma y haz failover con base_url, retries, fallback de proveedor y fallback de modelo.
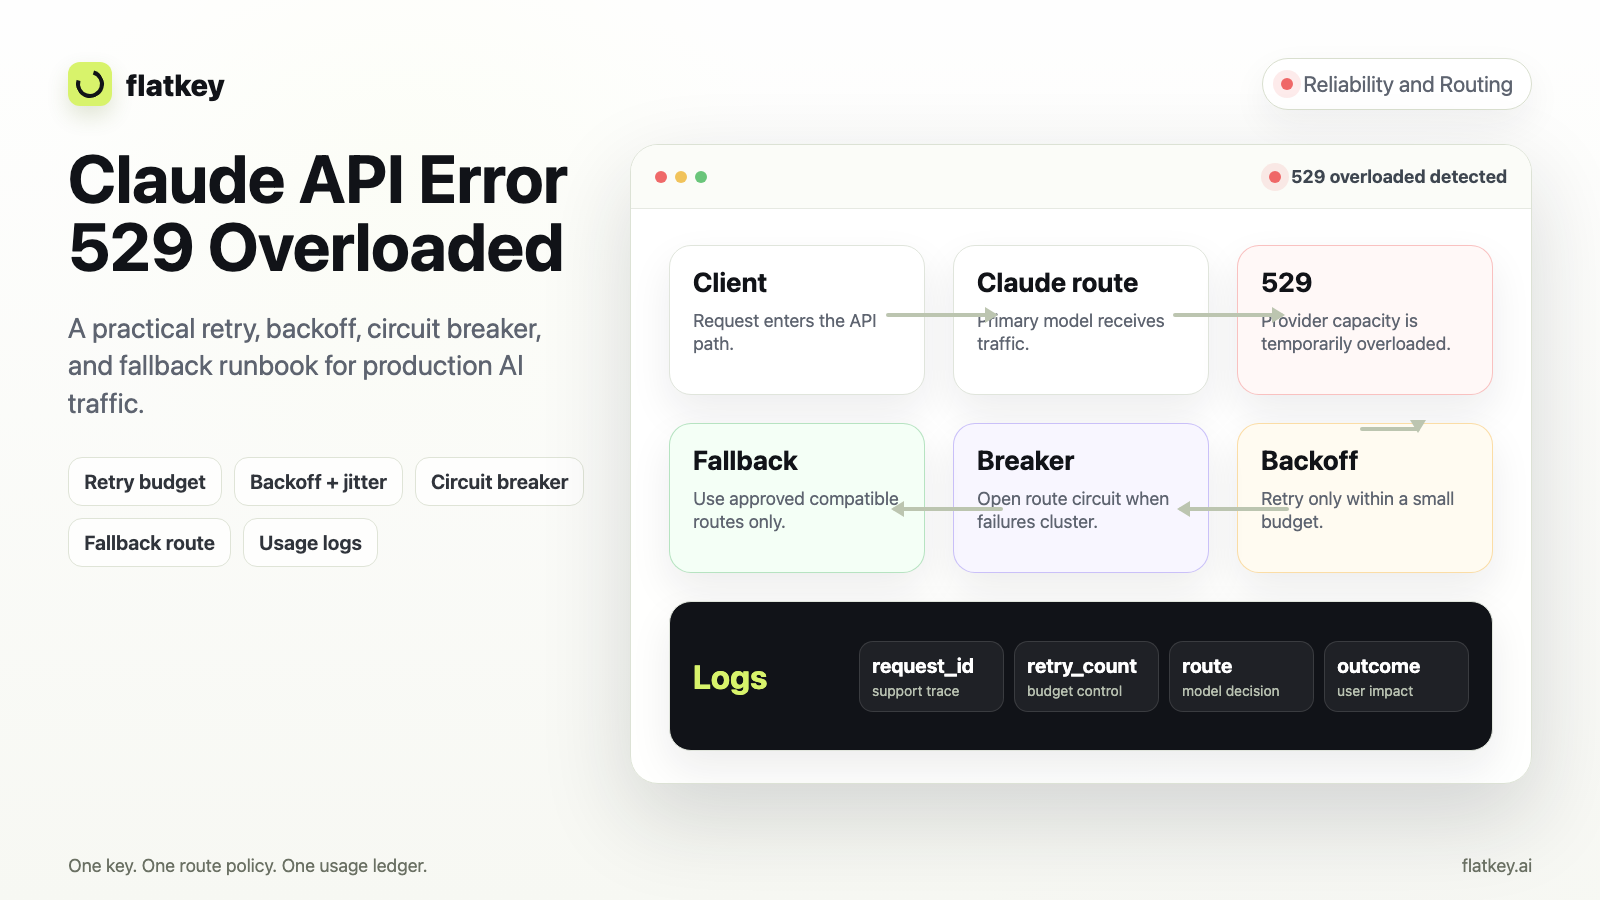
Claude API Error 529 sobrecargado: guía de reintentos, backoff y fallback
Una guía de producción para errores 529 sobrecargado de la API de Claude: clasifica el fallo, define presupuestos de reintentos, añade backoff y jitter, protege los efectos secundarios, corta la repetición de sobrecargas con circuit breakers y elige rutas de fallback seguras.
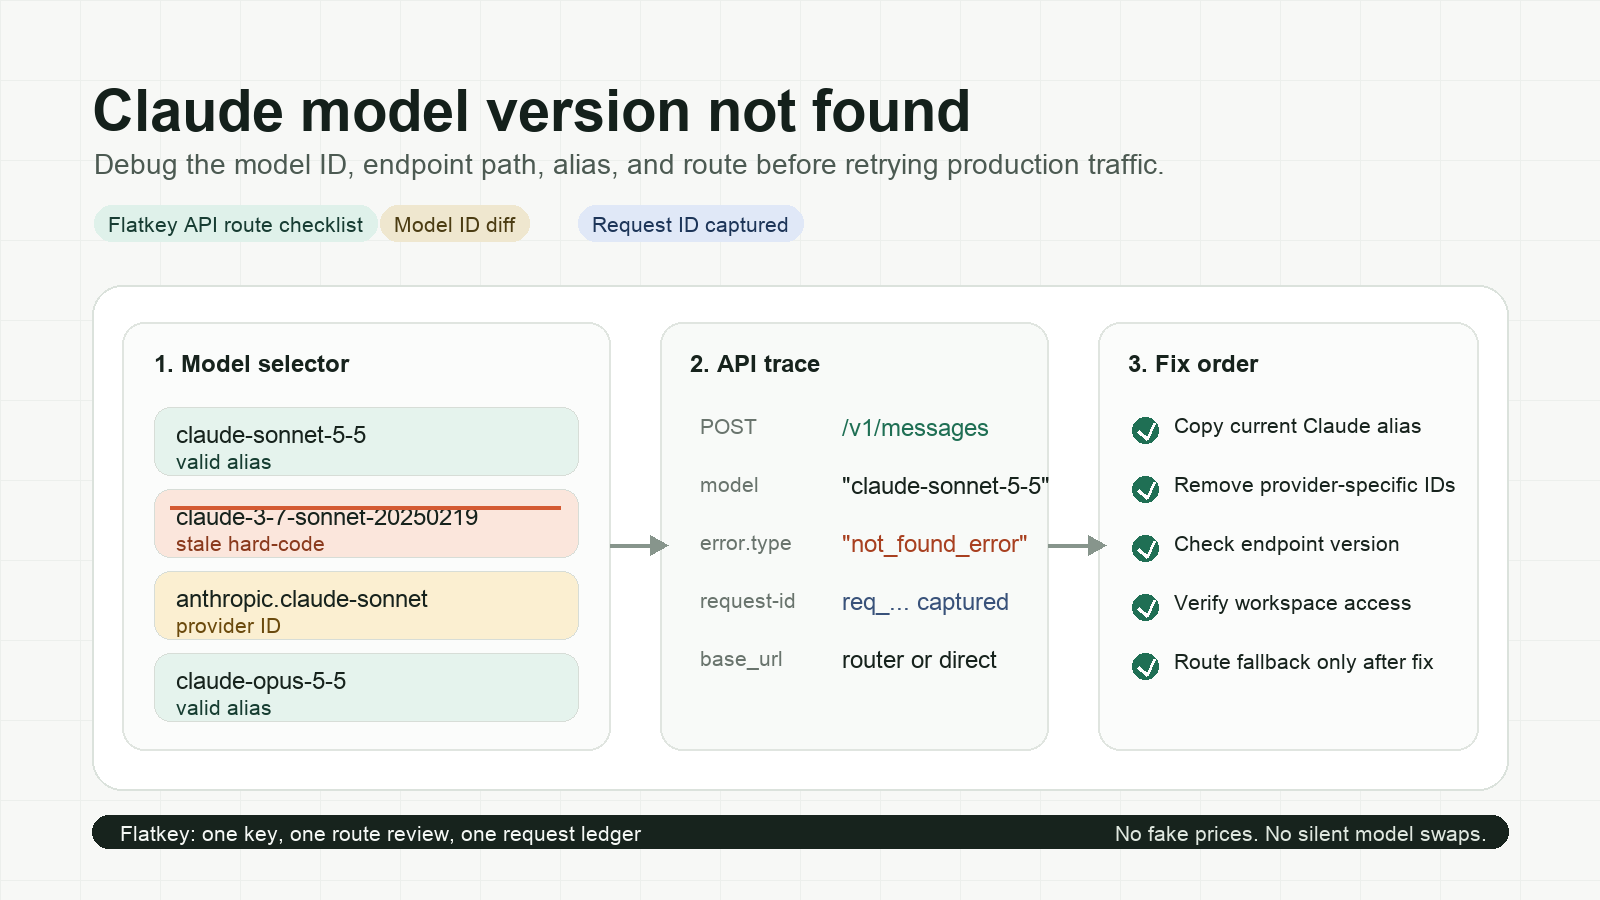
Versión del modelo Claude no encontrada: corrige IDs de modelo, alias y rutas de API incorrectos
Una guía práctica de depuración para errores de versión del modelo Claude no encontrada en APIs nativas de Anthropic, routers, IDs de proveedores en la nube, configuraciones de agentes y fallbacks de producción.
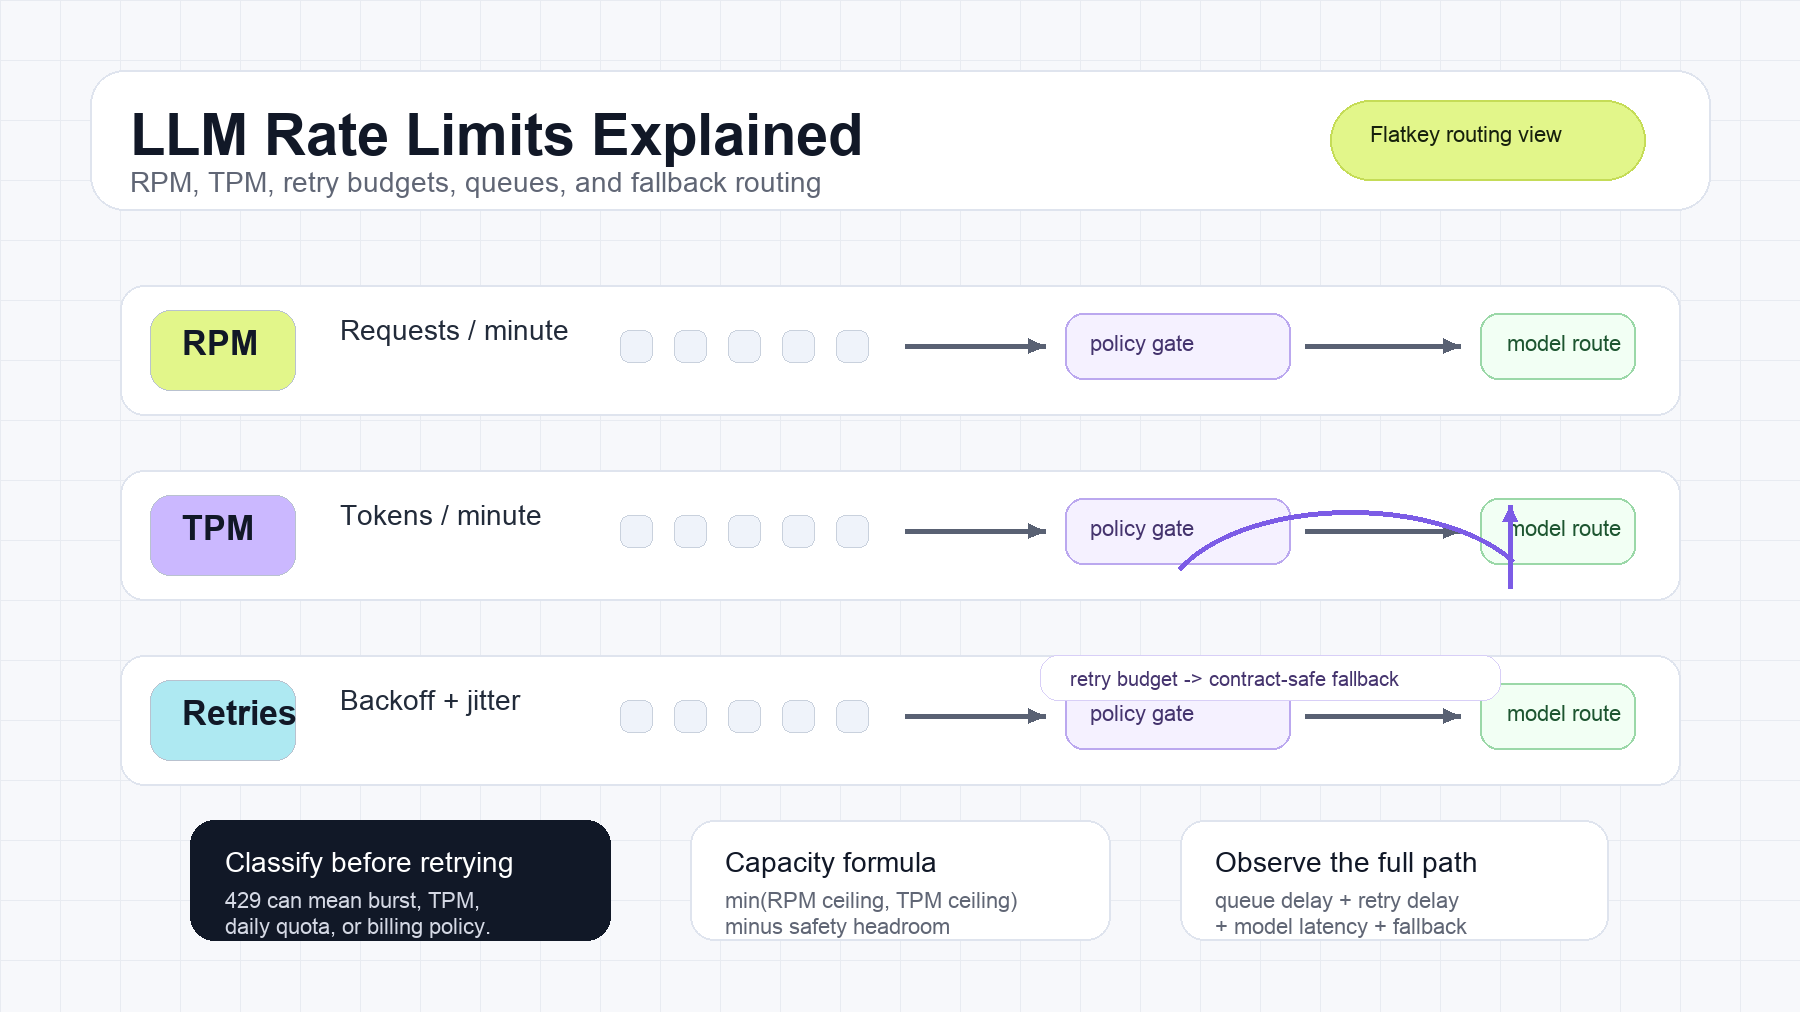
Explicación de los límites de tasa de LLM: RPM, TPM y reintentos
Comprende los límites de tasa de LLM, RPM, TPM, errores 429, Retry-After, retroceso exponencial, presupuestos de reintentos, colas y enrutamiento de fallback.
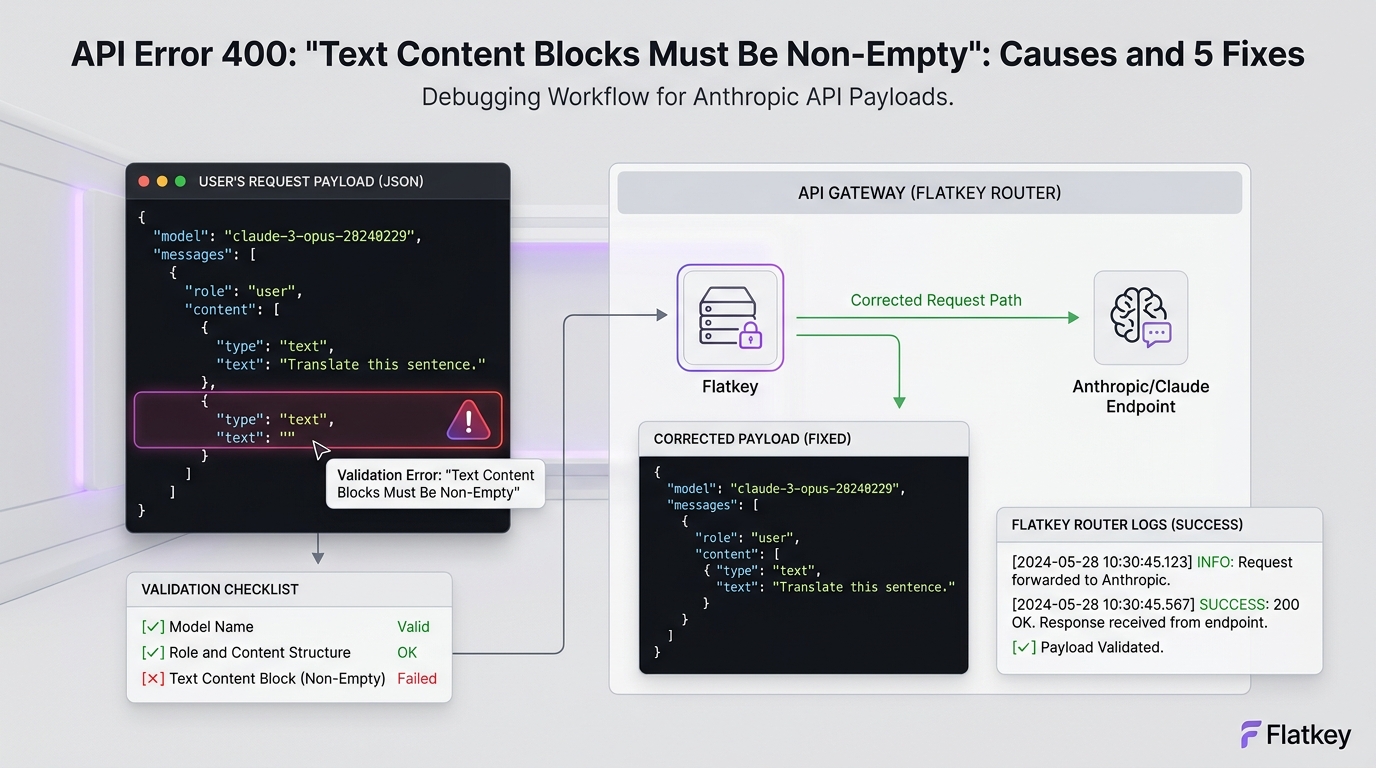
Error de API 400 "Text Content Blocks Must Be Non-Empty": causas y 5 soluciones
Corrige el error de API 400 "Text Content Blocks Must Be Non-Empty" en solicitudes a Anthropic con comprobaciones del payload, código de saneamiento, ejemplos de SDK y pasos de QA.
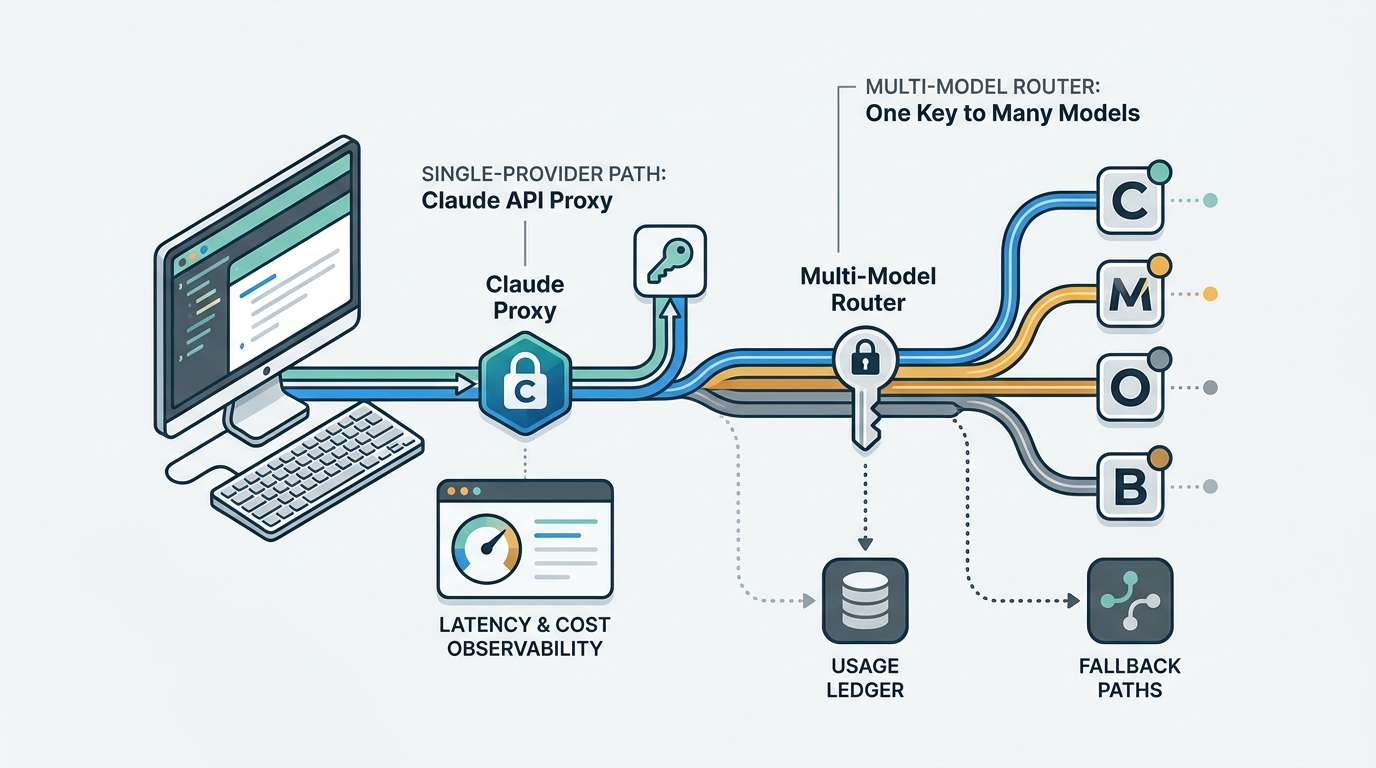
Proxy de la API de Claude vs router multimodelo: cuándo gana una sola clave
Compara un proxy de la API de Claude con un router multimodelo. Usa la tabla de puntuación, la lista de verificación de migración y la prueba rápida de Flatkey para decidir cuándo gana una sola clave.
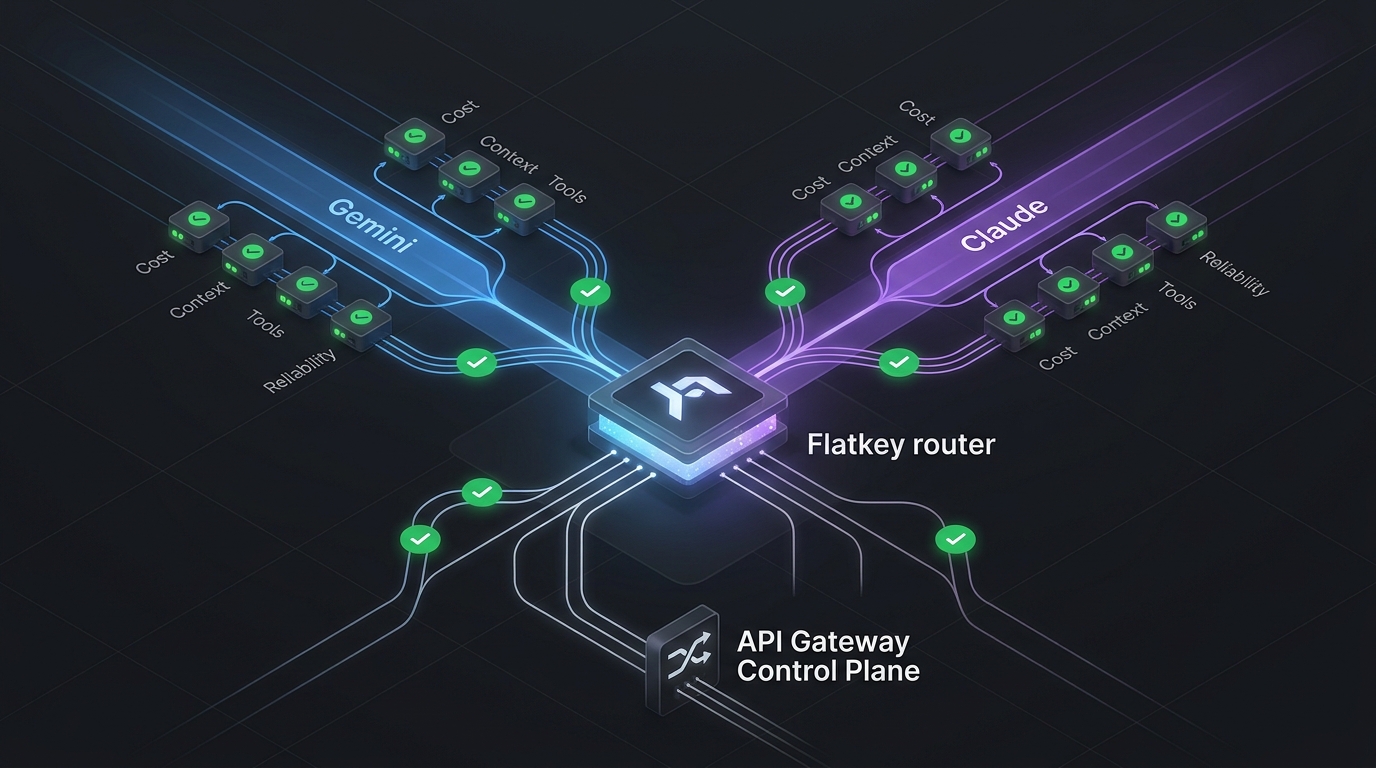
Gemini vs Claude (2026): ¿qué IA deberías usar?
Claude gana en escritura y programación con agentes; Gemini gana en Google Workspace, investigación y multimedia. Compara planes, modelos y precios oficiales de la API (octubre de 2026) y prueba ambos con una sola clave.
Métricas de API de LLM que realmente importan
Una tarjeta de puntuación práctica para medir la fiabilidad, latencia, coste, reintentos, fallbacks, eficiencia del contexto y auditabilidad de una API de LLM.
Métricas de la API de enrutamiento de IA que realmente importan
Una tarjeta de puntuación práctica para operadores que mide si una API de enrutamiento de IA mejora la confiabilidad, la calidad de respaldo, la latencia, el costo y la observabilidad.
Métricas de API de generación de imágenes que realmente importan
Usa métricas prácticas de API de generación de imágenes como el coste por imagen aceptada, el cumplimiento del prompt, el éxito de edición, la latencia, la tasa de reintentos y el impacto en el negocio.
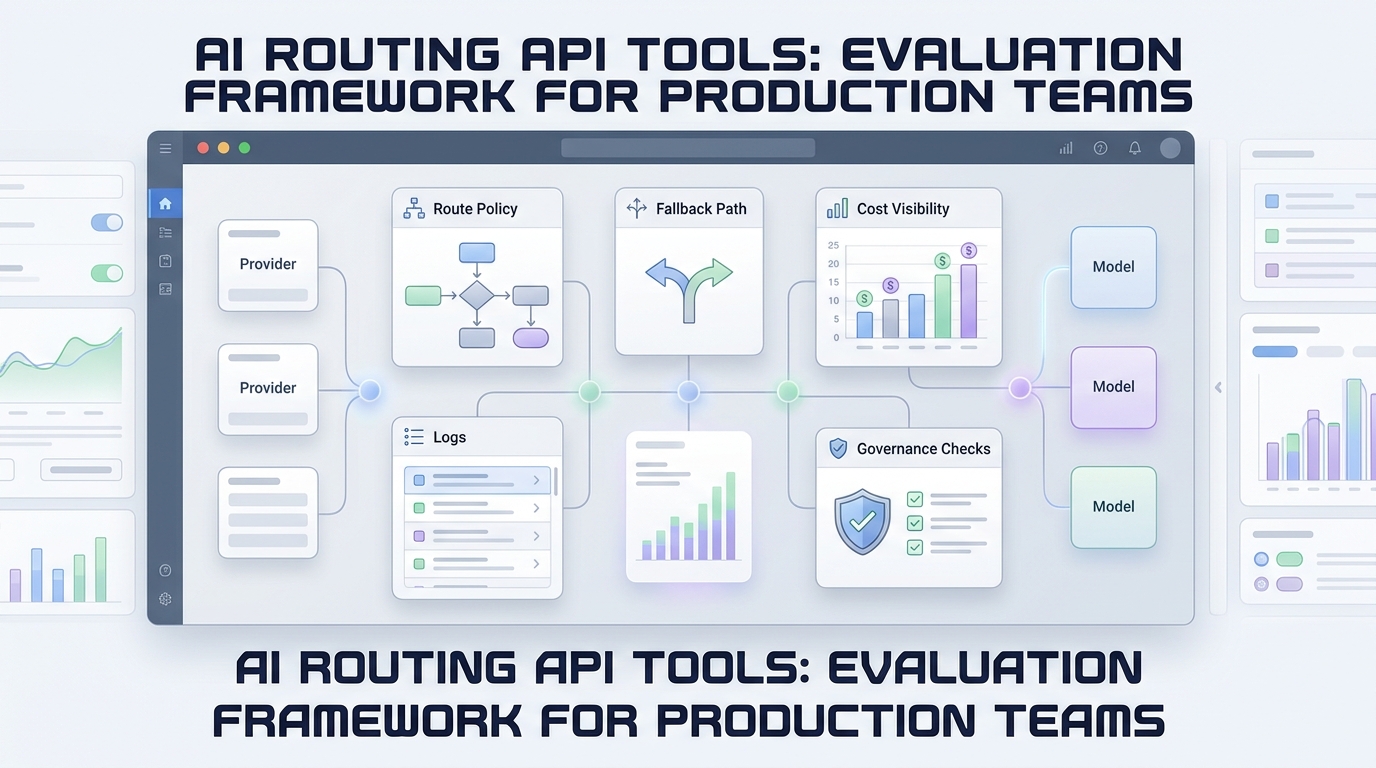
Herramientas de API de enrutamiento de IA: marco de evaluación para equipos de producción
Un marco práctico de evaluación para elegir herramientas de API de enrutamiento de IA que realmente puedan soportar tráfico de producción, control del gasto y gobernanza del enrutamiento.
Estrategia de fallback de modelos: un playbook de 3 flujos de trabajo
Un playbook de fallback de modelos en producción con policy as code, simulacros de fallos, un game day de 60 minutos, gates de release, disparadores de rollback y reglas seguras de recuperación.
Lista de verificación de implementación de observabilidad de IA: 20 pasos para producción
Una lista de verificación para implementar observabilidad de IA en producción con 20 pasos de lanzamiento, un contrato de telemetría, un patrón de código, un runbook de alertas, pruebas de aceptación y transferencia de responsabilidades.
Observabilidad de APIs LLM: métricas, trazas, logs y coste
Una guía de producción para monitorizar APIs LLM con métricas de éxito validadas, trazas distribuidas, logs estructurados seguros, SLOs, alertas y coste por tarea aceptada.
Enrutamiento de fallback para API de LLM: un manual de failover para producción
Un manual de producción para decidir cuándo las solicitudes a LLM deben reintentarse, hacer failover, cambiar de modelo o detenerse, sin romper flujos, herramientas, esquemas ni presupuestos de latencia.
Lista de verificación de preparación para producción de Gemini API para equipos de backend
Una lista de verificación de preparación para producción para equipos de backend que integran Gemini API, que cubre credenciales, contratos de respuesta, reintentos, observabilidad, costos, despliegues e incidentes.
Crea más rápido con una sola pasarela de IA.
Usa flatkey.ai para gestionar modelos, claves, facturación y observabilidad desde una plataforma API.
Empezar