Comparaison des prix des modèles d’IA : coûts des tokens, des images et des vidéos dans un seul tableau de bord
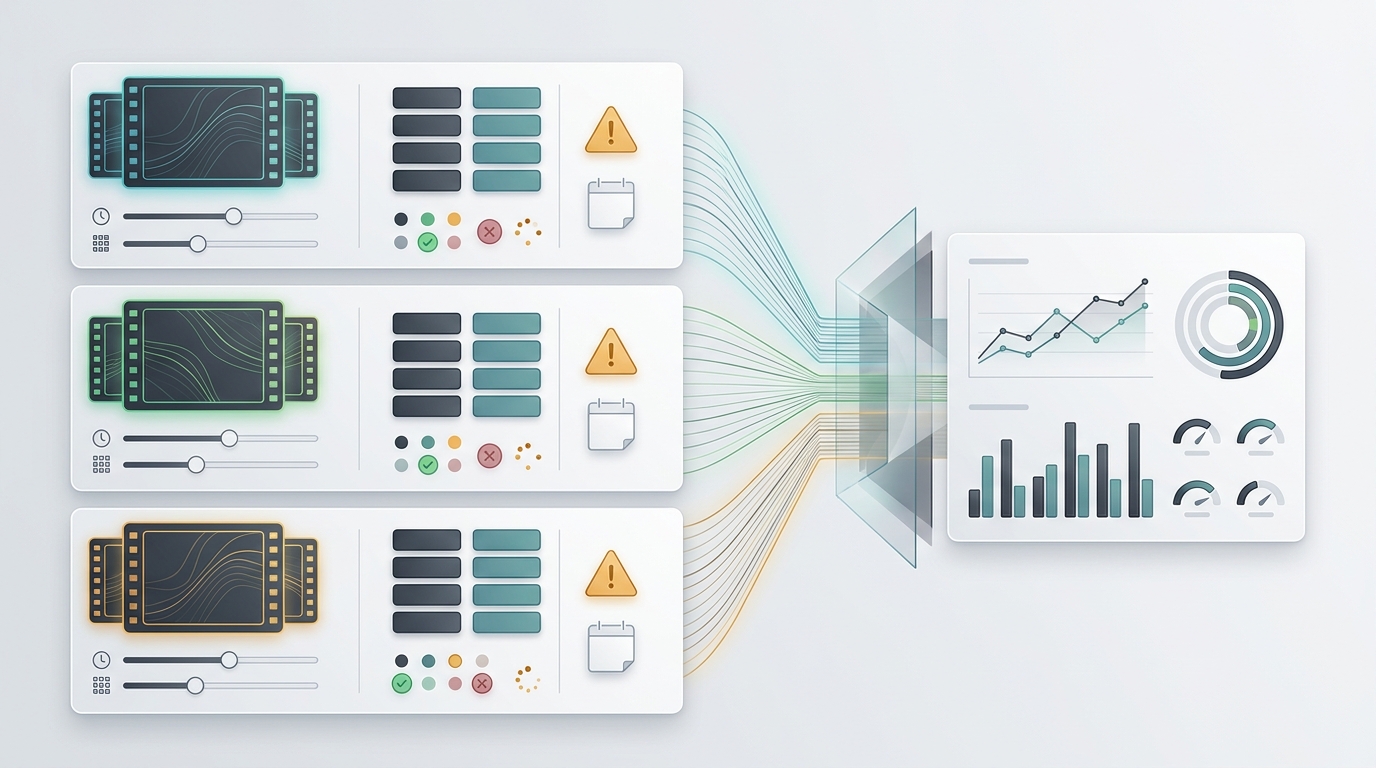
Une comparaison des prix des modèles d’IA n’est utile que si elle correspond à la manière dont votre produit dépense réellement de l’argent. Un tableau statique des prix des tokens est un point de départ. Le coût réel d’inférence varie avec les tokens d’entrée, les entrées mises en cache, les tokens de sortie, les unités de sortie d’image, les secondes de vidéo, les appels d’outils, les reprises, les solutions de secours, les tâches échouées et le pourcentage de résultats générés que les utilisateurs acceptent réellement.
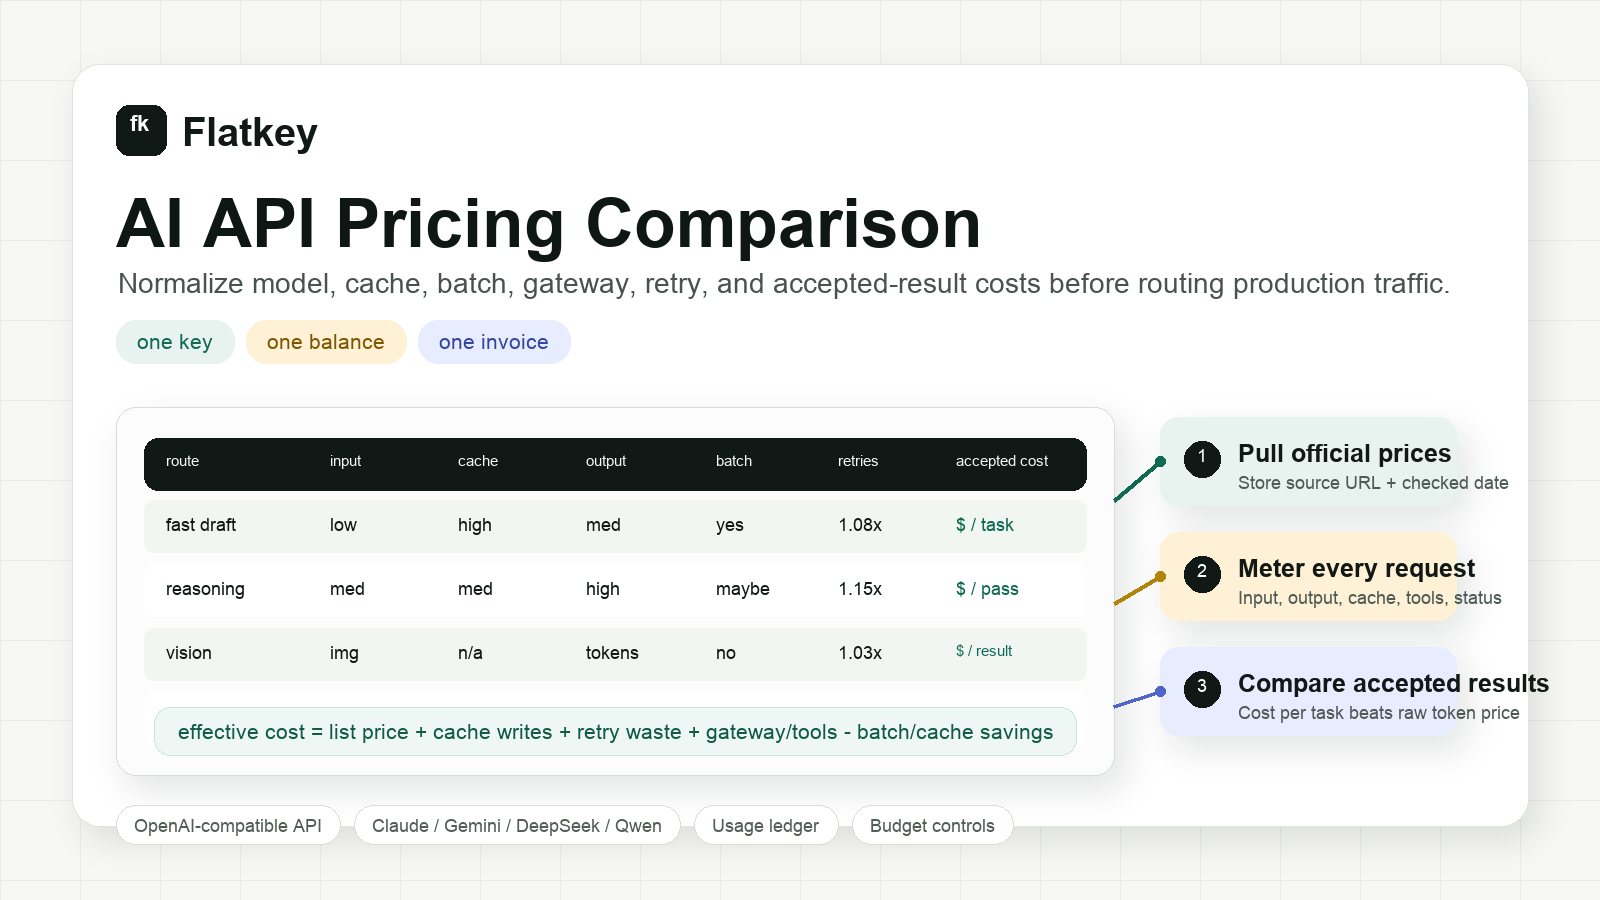
Ce guide offre aux développeurs, aux équipes produit et aux équipes achats un tableau de bord pratique pour comparer les tarifs des modèles d’IA entre le texte, l’image, la vidéo et les routes API multi-fournisseurs. La métrique durable n’est pas la requête listée la moins chère. C’est le coût par résultat accepté.
Flatkey s’intègre bien à ce flux de travail, car il fournit aux équipes une seule clé API, un seul solde prépayé, une seule facture et un journal d’utilisation partagé sur plus de 300 modèles officiels et plus de 1 000 outils pay-per-call. Vous devez toujours vérifier les prix officiels des fournisseurs, mais vous n’avez pas besoin de rapprocher chaque expérience à partir de comptes fournisseurs séparés avant de prendre une décision de routage.
Cadre rapide de comparaison des prix des modèles d’IA
Utilisez ce cadre avant de changer de fournisseur, d’approuver un budget plus important pour un modèle ou de faire transiter le trafic de production via un nouveau modèle.
| Couche de coût | Unité de tarification native | Normaliser en | Champ du tableau de bord |
|---|---|---|---|
| Appels texte et agents | Tokens d’entrée, entrée mise en cache, tokens de sortie, écritures de cache, tâches batch, appels d’outils | Coût par réponse acceptée ou tâche terminée | accepted_task_cost_usd |
| Génération d’images | Tokens de prompt, entrée d’image, tokens d’image de sortie, images générées, résolution, images acceptées | Coût par image acceptée | accepted_image_cost_usd |
| Génération de vidéo | Secondes, clips, résolution, tentatives de file d’attente, tâches asynchrones échouées | Coût par clip accepté ou seconde de clip acceptée | accepted_clip_cost_usd |
| Flux de travail multimodaux | Texte, fichiers, images, vidéo, outils, reprises, solutions de secours mélangés | Coût par flux de travail terminé | workflow_cost_usd |
| Achats et gouvernance | Clés, factures, exports, budgets, listes d’autorisation, besoins d’audit | Coût pour exploiter la route en toute sécurité | operating_cost_note |
La métrique de direction peut être simple : le coût par résultat accepté. Le registre d’ingénierie doit rester détaillé, car la raison de l’évolution du coût peut être un cache miss, un changement de longueur de sortie, une hausse des reprises, un repli vers un modèle de secours ou un taux d’acceptation utilisateur plus faible.
Pourquoi le prix affiché est une réponse incomplète
La ligne de token la moins chère peut devenir la route la plus coûteuse après le lancement. Un modèle avec un prix bas par token d’entrée peut tout de même perdre s’il nécessite des prompts plus longs, produit des réponses plus longues, rate des opportunités de cache, effectue davantage de reprises ou bascule vers une route plus onéreuse en cas de surcharge.
Les coûts des médias rendent le problème plus aigu :
- Un modèle d’image peut sembler bon marché par génération et coûteux par image acceptée si les utilisateurs rejettent de nombreuses sorties.
- Un modèle vidéo peut sembler abordable par seconde et coûteux lorsque les utilisateurs demandent plusieurs aperçus avant d’enregistrer un clip.
- Un agent de codage ou de recherche peut avoir un modèle de chat peu coûteux mais des appels annexes d’outils, de navigateur, d’image ou d’enrichissement coûteux.
- Un compte fournisseur direct peut avoir un prix brut du modèle plus bas mais un coût d’exploitation plus élevé si les achats nécessitent des clés séparées, des factures, des exports d’utilisation et des contrôles budgétaires.
C’est pourquoi une comparaison des prix des modèles d’IA doit préserver les unités de tarification natives, puis normaliser chaque route en économie de résultat accepté.
Sources de tarification actuelles à vérifier
Les tarifs des fournisseurs changent fréquemment. Ne copiez pas un tableau de tarifs une seule fois pour le considérer comme durable. Conservez un tableau des sources avec l’URL officielle, la date de vérification, l’identifiant du modèle ou de la route, l’unité et les notes.
| Fournisseur ou route | Source officielle à vérifier | Dimensions de tarification à capturer | Note du tableau de bord |
|---|---|---|---|
| API OpenAI | Tarification de l’API OpenAI | Entrée, entrée mise en cache, sortie, mode batch, fine-tuning, image, audio, vidéo, traitement régional | Confirmez l’ID exact du modèle, le mode de service et si la tarification batch s’applique. |
| API Anthropic Claude | Tarification Claude | Entrée, sortie, mise en cache des prompts, tarification batch, famille de modèles, fenêtre de contexte | Le comportement d’écriture du cache et de cache hit peut modifier de manière significative l’économie des agents répétés. |
| API Google Gemini | Tarification de l’API Gemini | Niveau gratuit ou payant, entrée, sortie, mise en cache, mode batch, options priority/flex, grounding de recherche, médias | Capturez la famille de modèles et le mode de service, en particulier lorsque la recherche ou le grounding est activé. |
| API DeepSeek | Tarification de l’API DeepSeek | Cache miss d’entrée, cache hit d’entrée, sortie, timing de pointe ou hors pointe, alias du modèle | Les journaux de requêtes doivent inclure l’horodatage et l’état du cache si la tarification varie selon la fenêtre temporelle ou le cache hit. |
| Alibaba Model Studio / Qwen | Modèles Alibaba Model Studio | Famille de modèles, modalité, région, unité de token ou de média, ID du modèle dans la console | Vérifiez la page détaillée exacte du modèle et la région avant d’intégrer des routes Qwen dans un budget. |
| API multi-fournisseur Flatkey | Tarification Flatkey et Modèles Flatkey | Routes de modèles unifiées, un seul solde, registre par requête, appels d’outils, factures, budgets de sous-clés | À utiliser pour la disponibilité des routes, la gouvernance multi-fournisseur et la comparaison basée sur le registre. |
Pour chaque ligne de tarification, stockez trois champs obligatoires : date de vérification, ID du modèle ou de la route et unité. Une valeur en dollars par token n’est pas directement comparable à une valeur en dollars par image, en dollars par seconde de vidéo ou en paiement par appel d’outil.
Le schéma du tableau de bord
Commencez avec un registre unique des requêtes. Ne séparez pas l’usage du texte, des images, des vidéos et des outils dans des systèmes financiers distincts.
{
  "request_id": "req_01j...",
  "workspace_id": "wk_product",
  "environment": "production",
  "feature": "creative_generator",
  "customer_id": "cus_123",
  "provider": "flatkey",
  "model_or_route": "example-route",
  "route_type": "image",
  "billing_unit": "output_image",
  "input_tokens": 1240,
  "output_tokens": 0,
  "cache_read_tokens": 0,
  "cache_write_tokens": 0,
  "tool_calls": 0,
  "images_generated": 4,
  "images_accepted": 1,
  "video_seconds_generated": 0,
  "video_seconds_accepted": 0,
  "retry_count": 1,
  "fallback_count": 0,
  "provider_cost_usd": 0.16,
  "gateway_or_platform_cost_usd": 0.00,
  "total_cost_usd": 0.16,
  "accepted_result": true,
  "latency_ms": 11800,
  "pricing_source_url": "https://provider.example/pricing",
  "pricing_checked_at": "2026-10-12"
}
Ce schéma donne à la finance un chiffre qu’elle peut rapprocher et donne à l’ingénierie les champs nécessaires pour expliquer pourquoi une route de modèle est devenue moins chère ou plus coûteuse.
Formules de coût à utiliser
Texte et appels d’agent
Pour les routes texte, calculez d’abord le coût brut de la requête :
raw_text_cost =
  input_tokens * input_rate
+ output_tokens * output_rate
+ cache_write_tokens * cache_write_rate
+ cache_read_tokens * cache_read_rate
+ tool_call_costs
+ retry_and_fallback_costs
Puis normalisez-le :
accepted_task_cost =
  sum(raw_text_cost for all attempts, retries, and fallbacks)
/ accepted_tasks
Si une requête échoue et que l’utilisateur ne reçoit jamais de réponse, ne le masquez pas. Suivez le coût des appels échoués séparément. Un tableau de bord de tarification devient utile lorsqu’il rend visibles le trafic échoué, retenté et de repli.
Génération d’images
La tarification de l’API d’images n’est pas une unité universelle. Certains modèles exposent des tokens de prompt et des tokens de sortie d’image. D’autres exposent des unités par image, par résolution, par édition ou spécifiques au fournisseur. Conservez l’unité native et normalisez-la en images acceptées :
accepted_image_cost =
  (prompt_cost + input_image_cost + output_image_cost + retry_cost)
/ accepted_images
Suivez séparément images_generated et images_accepted. Une route qui génère quatre images pour chaque image acceptée ne doit pas être comparée directement à une route où les utilisateurs en acceptent une sur une.
Génération de vidéo
La tarification vidéo nécessite la durée, la résolution et l’état du job asynchrone. Un appel vidéo peut être mis en file d’attente, échouer, être annulé, être régénéré ou être accepté plus tard.
accepted_clip_cost =
  sum(video_seconds_generated * per_second_rate by resolution)
+ retry_cost
+ fallback_cost
+ storage_or_tool_costs
Pour les décisions produit, suivez également :
accepted_clip_secondspreview_countregeneration_countfailed_job_counttime_to_first_preview_mstime_to_accepted_clip_ms
Un modèle vidéo peut coûter moins cher par unité indiquée tout en étant moins performant pour le produit si les utilisateurs régénèrent deux fois plus souvent.
Comparer les comptes directs chez les fournisseurs avec une API multi-fournisseurs
Les comptes directs chez les fournisseurs suffisent lorsqu’une famille de modèles couvre la majeure partie de votre charge de travail et qu’une facturation séparée est facile à gérer. Une API multi-fournisseurs devient plus utile lorsque vous avez besoin d’une comparaison continue des modèles, d’un routage de secours ou d’un seul grand livre sur plusieurs fournisseurs.
| Point de décision | Les comptes directs chez les fournisseurs peuvent suffire lorsque... | Une API multi-fournisseurs aide lorsque... |
|---|---|---|
| Choix du modèle | Un fournisseur remporte la plupart des tâches. | Différentes charges de travail ont besoin de routes OpenAI, Claude, Gemini, DeepSeek, Qwen, image, vidéo et outils. |
| Effort d’ingénierie | Votre code appelle déjà un seul fournisseur et change rarement. | Vous voulez un routage compatible OpenAI et moins de réécritures d’intégration. |
| Contrôle des coûts | Une facture et un tableau de bord suffisent. | Vous avez besoin de budgets par sous-clé, de listes d’autorisation de modèles et d’exports d’utilisation par requête. |
| Achats | Des contrats séparés sont gérables. | Des contrats en double, des sièges inactifs et des clés de fournisseurs dispersées ralentissent l’équipe. |
| Fiabilité | Des interruptions occasionnelles du fournisseur sont acceptables. | Vous avez besoin d’une politique de secours et d’un grand livre partagé pour les coûts de nouvelle tentative et de basculement. |
| Flux de travail des agents | L’application appelle seulement des modèles de texte. | Les agents appellent des modèles, la recherche web, des actions de navigateur, des outils d’enrichissement, des images et de la vidéo. |
Flatkey est conçu pour la deuxième colonne : une clé API, un solde, une facture et un registre des requêtes sur de nombreuses routes officielles de modèles et d’outils. Cela ne remplace pas la tarification officielle des fournisseurs. Cela donne à votre équipe un endroit unique pour router, mesurer, gouverner et rapprocher ces coûts. Pour l’angle des frais de passerelle et des coûts d’exploitation, voir tarification des passerelles IA.
Cinq exemples de charges de travail
1. Chat de support
Le chat de support comporte généralement une entrée modérée, une sortie courte et un volume élevé. Comparez :
- Taux de cache des prompts pour les prompts système et le texte des politiques.
- Budget de tokens de sortie par type de réponse.
- Taux d’escalade vers un modèle plus puissant.
- Coût par conversation résolue, et pas seulement coût par message.
Pour cette charge de travail, un modèle rapide moins cher peut l’emporter s’il maintient une qualité de résolution élevée. Si le modèle moins cher augmente le taux de transfert ou de modification, les économies apparentes en tokens disparaissent.
2. Agent de codage
Les agents de codage ont souvent un grand contexte, des appels d’outils, une sortie longue et de multiples tentatives. Comparez :
- Taille du contexte après une recherche dans le dépôt ou la lecture de fichiers.
- Instructions de projet pouvant être mises en cache.
- Nombre d’appels d’outils par tâche acceptée.
- Gaspillage dû aux nouvelles tentatives sur des routes surchargées.
- Coût par modification fusionnée ou correctif accepté.
C’est là qu’une comparaison des prix des modèles d’IA a besoin d’un grand livre. Une seule exécution d’agent peut inclure des appels de modèle, des appels d’outils, des appels de secours et des tentatives échouées.
3. Génération de réponses RAG
Les charges de travail RAG sont dominées par le contexte récupéré et la longueur de la réponse. Comparez :
- Nombre moyen de tokens récupérés.
- Part du préfixe de prompt stable.
- Comportement du cache pour les documents répétés.
- Coûts de citation ou d’ancrage.
- Taux de réussite de l’évaluateur pour la factualité.
Ne choisissez pas un modèle uniquement parce que ses tokens d’entrée sont bon marché. S’il a besoin de deux fois plus de contexte ou produit des réponses qui échouent à l’évaluation, le coût par réponse acceptée peut être plus élevé. Si c’est la principale question de migration, utilisez le tableau de calcul plus détaillé dans comment comparer les prix des modèles d’IA.
4. Classification par lot
La classification par lot peut souvent tolérer des résultats différés. Comparez :
- Si le fournisseur propose un niveau batch, flex ou de traitement différé.
- Taille maximale des lots et fenêtre d’achèvement.
- Coût de relecture des erreurs.
- Taux de validation du schéma de sortie.
- Coût total par ligne acceptée.
Si un fournisseur propose une tarification batch plus basse, les économies ne s’appliquent que lorsque votre flux de travail peut attendre et que votre processus de reprise est propre.
5. Génération d’images et de vidéos
Les API d’images et de vidéos ne rentrent que rarement dans un tableur basé uniquement sur les tokens. Comparez :
- Unité de sortie : image, seconde, clip, résolution, token ou crédit.
- Règles de facturation en cas d’échec de génération.
- Taux d’édition et de régénération.
- Taux d’approbation humaine.
- Coût par actif créatif accepté.
Pour les pipelines médias, conservez les modèles de tokens et les modèles de génération dans des onglets de feuille de calcul séparés, puis regroupez-les en coût de flux de travail accepté. Les économies unitaires sont trop différentes pour une seule ligne agrégée.
Flux de travail de comparaison des prix en sept étapes
- Figez la charge de travail. Choisissez une famille de tâches réelle, comme les réponses du support, les correctifs d’un agent de codage, les réponses RAG, la classification par lots, la génération d’images ou la génération de vidéos.
- Collectez les prix officiels actuels. Utilisez les pages de tarification des fournisseurs, les pages des modèles Flatkey et une date de vérification. Évitez les grilles tarifaires copiées sans URL source.
- Rejouez un trafic représentatif. Utilisez les mêmes prompts, entrées, plafonds de sortie, politique d’outils et validateurs sur tous les chemins.
- Consignez chaque unité facturable. Capturez les tokens d’entrée, les tokens mis en cache, les tokens de sortie, les unités multimédias, les appels d’outils, les tentatives de nouvelle exécution, les erreurs et le statut.
- Évaluez les résultats acceptés. Utilisez une revue humaine, des validateurs automatisés ou des contrôles réussite/échec spécifiques à la tâche.
- Calculez le coût effectif. Divisez le coût total du chemin par les résultats acceptés, et non par le nombre total de requêtes.
- Ajoutez des contrôles opérationnels. Déterminez si le chemin gagnant respecte aussi les plafonds budgétaires, les besoins de facturation, la gouvernance des clés, la rétention des données et le repli en cas d’incident.
Le résultat est une décision de tarification que l’ingénierie, le produit et les achats peuvent tous défendre.
Vues minimales du tableau de bord
Comparaison des chemins
Affichez les chemins texte, image et vidéo dans un seul tableau.
| Chemin | Unité native | Champ de coût natif | Champ d’acceptation | KPI normalisé |
|---|---|---|---|---|
| Modèle texte | Tokens | Tokens d’entrée, de sortie et de cache | Réponse acceptée | Coût par réponse acceptée |
| Agent de codage | Tokens plus outils | Coûts des tokens et des outils | PR fusionnée, ticket résolu, tâche terminée | Coût par flux de travail terminé |
| Modèle d’image | Unités image ou token | Images générées, tokens d’image de sortie | Image acceptée | Coût par image acceptée |
| Modèle vidéo | Secondes, clips ou unités fournisseur | Secondes générées selon la résolution | Clip accepté | Coût par clip accepté |
Budget par fonctionnalité
Regroupez par fonctionnalité, pas seulement par fournisseur. Pour les équipes produit, c’est plus utile qu’une facture fournisseur, car cela montre si c’est l’onboarding, le chat, la génération créative, la recherche ou l’export qui génère les dépenses.
Colonnes suggérées :
featureroute_typerequestsaccepted_resultsacceptance_ratetotal_cost_usdcost_per_accepted_resultp95_latency_msfallback_rateretry_rate
Dérive du fournisseur et du modèle
Chaque fournisseur modifie la disponibilité des modèles, les prix et l’état du cycle de vie. Stockez :
- URL de la source tarifaire.
- Date de vérification de la tarification.
- Version du modèle ou ID du chemin.
- Type d’unité.
- Politique de cache.
- Politique de remise pour les lots, si utilisée.
- Notes de dépréciation ou de cycle de vie.
Cela permet à une comparaison des prix des modèles d’IA de rester utile après le lancement, et pas seulement lors de la sélection initiale du modèle.
Garde-fous de marge
Ajoutez une règle simple de marge à chaque fonctionnalité IA :
max_ai_cost_per_customer_action =
  expected_revenue_per_action * target_ai_cost_percentage
Exemple :
Si une action client génère 0,40 $ de marge brute
et que le coût IA doit rester sous 20 %,
alors le budget du chemin est de 0,08 $ par résultat accepté.
Cela permet d’ancrer la sélection du modèle dans l’activité, et non dans des scores de benchmark abstraits.
Erreurs courantes
| Erreur | Que faire à la place |
|---|---|
| Comparer uniquement les tarifs des tokens d’entrée | Comparez les entrées, les entrées mises en cache, les sorties, les médias, les outils, les nouvelles tentatives et les résultats acceptés. |
| Mélanger texte, image, vidéo et outils en une seule unité | Conservez les unités natives, puis normalisez chaque chemin au coût par résultat accepté. |
| Ignorer la mise en cache des prompts | Mesurez les préfixes de prompt stables et le taux de cache hit. |
| Ignorer l’éligibilité au traitement par lots | Séparez les charges de travail sensibles à la latence et les charges hors ligne. |
| Faire confiance à des tableaux de prix copiés et obsolètes | Stockez les URL officielles des sources et les dates de vérification. |
| Considérer le coût de la passerelle comme une simple majoration | Incluez la gouvernance, le basculement, les exports d’utilisation, les factures et le temps d’ingénierie. |
| Choisir la requête la moins chère | Choisissez le résultat accepté le moins cher qui respecte les exigences de qualité et de fiabilité. |
Questions fréquentes
Quelle est la meilleure façon de comparer les prix des modèles d’IA ?
La meilleure façon de comparer les prix des modèles d’IA est de préserver l’unité de facturation native de chaque fournisseur, puis de normaliser chaque chemin en coût par résultat accepté. Pour le texte, cela peut être le coût par réponse acceptée. Pour les images, utilisez le coût par image acceptée. Pour la vidéo, utilisez le coût par clip accepté ou par seconde de clip acceptée.
Que doit inclure un tableau de comparaison des modèles d’IA ?
Un tableau de comparaison des modèles d’IA doit inclure l’ID du modèle ou du chemin, le fournisseur, l’URL de la source tarifaire, la date de vérification, les tokens d’entrée, l’entrée mise en cache, les tokens de sortie, les unités multimédias, les appels d’outils, le taux de nouvelle tentative, le taux de repli, le taux d’acceptation, la latence et le coût par résultat accepté.
Les tableaux de prix doivent-ils inclure les prix exacts des fournisseurs ?
Utilisez les prix exacts dans votre feuille de calcul interne, mais enregistrez l’URL source et la date de vérification à côté de chaque ligne. Les articles statiques publics devraient éviter les tableaux de tarifs copiés sans source, car les prix des fournisseurs, les noms des modèles, les remises et le statut du cycle de vie peuvent changer rapidement.
Comment comparez-vous les coûts des tokens avec les coûts des images et des vidéos ?
N’obligez pas chaque route à passer par des tokens. Conservez les unités natives dans le registre, puis ajoutez des champs normalisés tels que accepted_task_cost_usd, accepted_image_cost_usd et accepted_clip_cost_usd.
En quoi Flatkey aide-t-il dans la comparaison des prix des modèles d’IA ?
Flatkey est utile lorsque vous voulez une seule clé, un seul solde, une seule facture et un seul registre d’utilisation sur de nombreuses routes de modèles et d’outils. Cela facilite la comparaison des coûts de texte, d’image, de vidéo et d’agent sans avoir d’abord à rapprocher des comptes de fournisseurs séparés.
À quelle fréquence faut-il revérifier les tarifs ?
Revérifiez les tarifs avant chaque changement majeur d’acheminement, revue de contrat ou prévision budgétaire. Pour les charges de travail de production à évolution rapide, actualisez chaque semaine les prix des routes critiques et immédiatement après qu’un fournisseur lance, renomme, retire ou reprice un modèle que vous utilisez.
Conclusion
Une comparaison des prix des modèles d’IA n’est pas un simple tableau de prix plus esthétique. C’est un système d’exploitation pour la sélection des modèles.
Conservez les unités du fournisseur. Ajoutez le suivi de l’acceptation. Normalisez chaque route en coût par résultat accepté. Puis choisissez la route qui améliore la marge produit, la fiabilité et la gouvernance, et non celle qui semble la moins chère prise isolément.
Avec Flatkey, cette comparaison peut reposer sur une seule clé, un seul solde et un seul registre, afin que les développeurs, les équipes produit et les équipes achats puissent passer de factures de fournisseurs dispersées à des décisions de coût au niveau des routes.