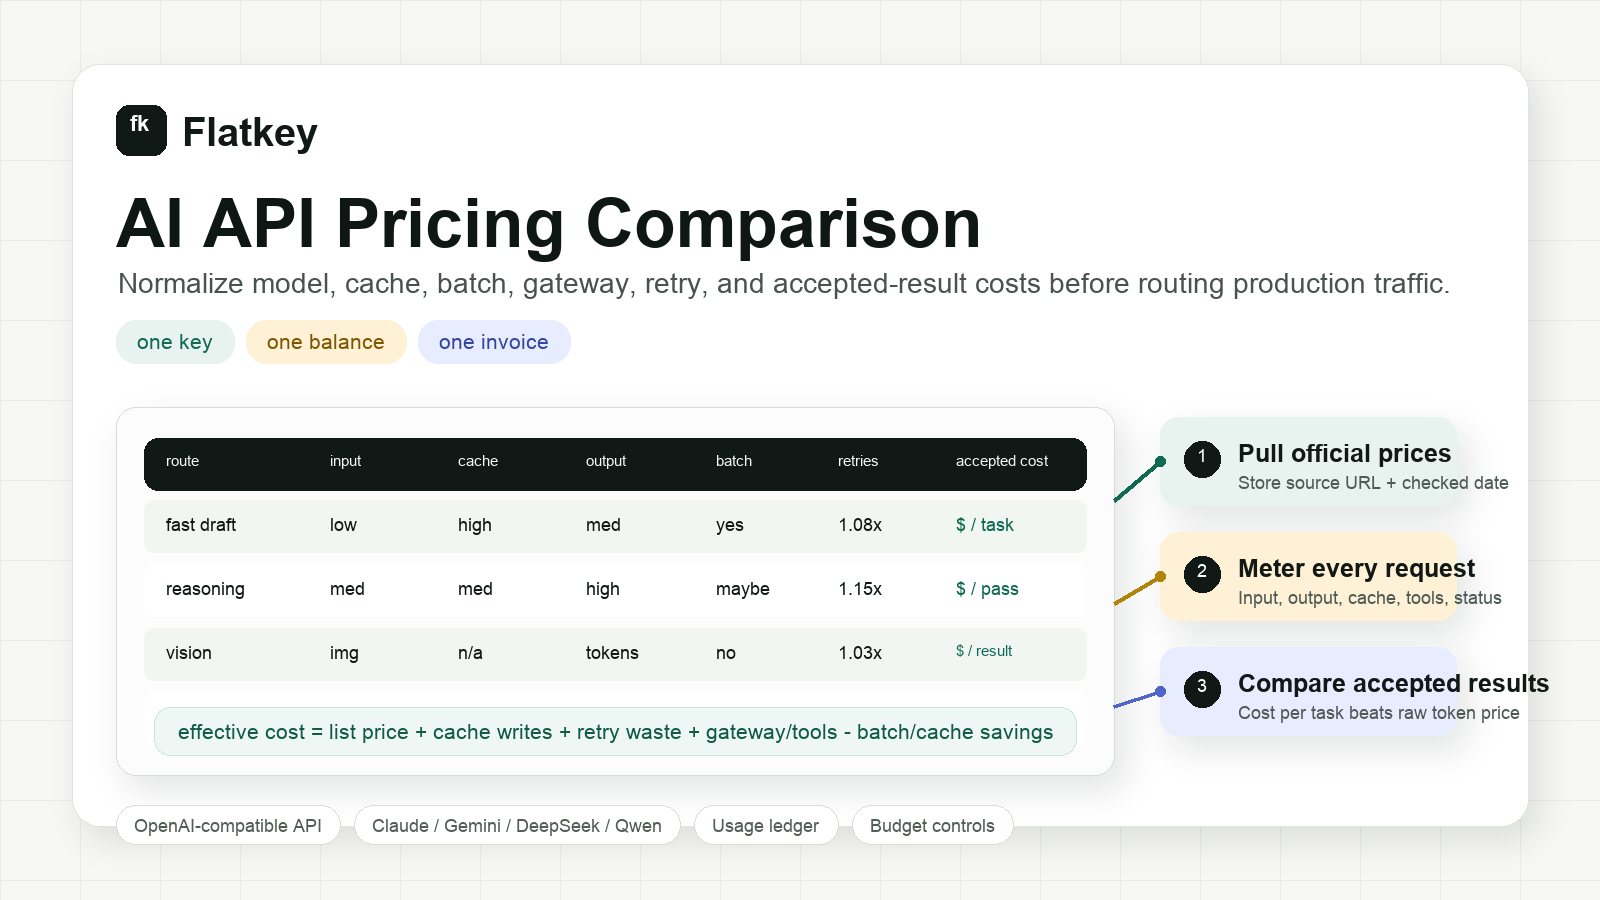
Comparación de precios de modelos de IA: costos de tokens, imágenes y video en un solo panel
Una comparación de precios de modelos de IA solo es útil si coincide con la forma en que tu producto realmente gasta dinero. Una tabla estática de precios por token es un punto de partida. El costo real de inferencia cambia con los tokens de entrada, la entrada en caché, los tokens de salida, las unidades de salida de imagen, los segundos de video, las llamadas a herramientas, los reintentos, los fallbacks, los trabajos fallidos y el porcentaje de resultados generados que los usuarios realmente aceptan.
Esta guía ofrece a desarrolladores, equipos de producto y equipos de compras un panel práctico para comparar precios de modelos de IA en rutas de texto, imagen, video y API de múltiples proveedores. La métrica duradera no es la solicitud más barata listada. Es el costo por resultado aceptado.
Flatkey encaja en este flujo de trabajo porque ofrece a los equipos una API key, un saldo prepago, una factura y un registro de uso compartido en más de 300 modelos oficiales y más de 1,000 herramientas de pago por llamada. Aun así, debes revisar los precios oficiales de los proveedores, pero no necesitas conciliar cada experimento de cuentas de proveedores separadas antes de tomar una decisión de ruta.
Marco rápido de comparación de precios de modelos de IA
Usa este marco antes de cambiar de proveedor, aprobar un presupuesto mayor para un modelo o enrutar tráfico de producción a través de un nuevo modelo.
| Capa de costo | Unidad de precio nativa | Normalizar a | Campo del panel |
|---|---|---|---|
| Llamadas de texto y agentes | Tokens de entrada, entrada en caché, tokens de salida, escrituras en caché, trabajos por lotes, llamadas a herramientas | Costo por respuesta aceptada o tarea completada | accepted_task_cost_usd |
| Generación de imágenes | Tokens de prompt, entrada de imagen, tokens de imagen de salida, imágenes generadas, resolución, imágenes aceptadas | Costo por imagen aceptada | accepted_image_cost_usd |
| Generación de video | Segundos, clips, resolución, intentos en cola, trabajos asíncronos fallidos | Costo por clip aceptado o segundo de clip aceptado | accepted_clip_cost_usd |
| Flujos de trabajo multimodales | Texto mixto, archivos, imágenes, video, herramientas, reintentos, fallbacks | Costo por flujo de trabajo completado | workflow_cost_usd |
| Compras y gobernanza | Keys, facturas, exportaciones, presupuestos, listas permitidas, necesidades de auditoría | Costo de operar la ruta de forma segura | operating_cost_note |
La métrica ejecutiva puede ser simple: costo por resultado aceptado. El registro de ingeniería debe seguir siendo detallado, porque la razón por la que cambió el costo puede ser un fallo de caché, un cambio en la longitud de salida, un aumento de reintentos, un fallback del modelo o una menor tasa de aceptación del usuario.
Por qué el precio de lista es una respuesta incompleta
La fila de tokens más barata puede convertirse en la ruta más cara después del lanzamiento. Un modelo con un precio bajo por token de entrada puede seguir perdiendo si necesita prompts más largos, produce respuestas más largas, pierde oportunidades de caché, reintenta con más frecuencia o cae en una ruta más cara durante un pico de carga.
Los costos de medios hacen que el problema sea más agudo:
- Un modelo de imágenes puede parecer barato por generación y caro por imagen aceptada si los usuarios rechazan muchas salidas.
- Un modelo de video puede parecer asequible por segundo y caro cuando los usuarios solicitan varias vistas previas antes de guardar un clip.
- Un agente de codificación o investigación puede tener un modelo de chat barato, pero llamadas secundarias costosas a herramientas, navegador, imágenes o enriquecimiento.
- Una cuenta directa de proveedor puede tener un precio bruto del modelo más bajo, pero un costo operativo mayor si compras necesita claves, facturas, exportaciones de uso y controles de presupuesto separados.
Por eso, una comparación de precios de modelos de IA debe conservar las unidades de precio nativas y luego normalizar cada ruta a una economía de resultados aceptados.
Fuentes de precios actuales que revisar
Los precios de los proveedores cambian con frecuencia. No copies una tabla de tarifas una sola vez y la trates como duradera. Mantén una tabla de fuentes con la URL oficial, la fecha de revisión, el modelo o ID de ruta, la unidad y las notas.
| Proveedor o ruta | Fuente oficial que consultar | Dimensiones de precios a capturar | Nota del panel |
|---|---|---|---|
| OpenAI API | Precios de la API de OpenAI | Entrada, entrada en caché, salida, modo por lotes, ajuste fino, imagen, audio, video, procesamiento regional | Confirma el ID exacto del modelo, el modo de servicio y si se aplica el precio por lotes. |
| Anthropic Claude API | Precios de Claude | Entrada, salida, caché de prompts, precios por lotes, familia de modelos, ventana de contexto | El comportamiento de escritura en caché y de acierto de caché puede cambiar de forma material la economía de agentes repetidos. |
| Google Gemini API | Precios de la API de Gemini | Nivel gratuito o de pago, entrada, salida, almacenamiento en caché, modo por lotes, opciones de prioridad/flex, grounding de búsqueda, medios | Captura la familia del modelo y el modo de servicio, especialmente cuando la búsqueda o el grounding están habilitados. |
| DeepSeek API | Precios de la API de DeepSeek | Fallo de caché de entrada, acierto de caché de entrada, salida, horario de pico o valle, alias del modelo | Los registros de solicitudes necesitan marca de tiempo y estado de caché si los precios varían por ventana horaria o por acierto de caché. |
| Alibaba Model Studio / Qwen | Modelos de Alibaba Model Studio | Familia de modelos, modalidad, región, token o unidad de medios, ID del modelo en la consola | Comprueba la página exacta de detalles del modelo y la región antes de incorporar rutas de Qwen a un presupuesto. |
| API multi-proveedor de Flatkey | Precios de Flatkey y Modelos de Flatkey | Rutas de modelos unificadas, un saldo, libro mayor por solicitud, llamadas a herramientas, facturas, presupuestos de subclaves | Úsalo para disponibilidad de rutas, gobernanza multi-proveedor y comparación basada en libro mayor. |
Para cada fila de precios, almacena tres campos obligatorios: fecha de comprobación, ID del modelo o ruta y unidad. Un valor de dólares por token no es directamente comparable con un valor de dólares por imagen, dólares por segundo de video o pago por llamada a herramienta.
El esquema del panel
Empieza con un libro mayor único de solicitudes. No separes el uso de texto, imagen, video y herramientas en sistemas financieros desconectados.
{
  "request_id": "req_01j...",
  "workspace_id": "wk_product",
  "environment": "production",
  "feature": "creative_generator",
  "customer_id": "cus_123",
  "provider": "flatkey",
  "model_or_route": "example-route",
  "route_type": "image",
  "billing_unit": "output_image",
  "input_tokens": 1240,
  "output_tokens": 0,
  "cache_read_tokens": 0,
  "cache_write_tokens": 0,
  "tool_calls": 0,
  "images_generated": 4,
  "images_accepted": 1,
  "video_seconds_generated": 0,
  "video_seconds_accepted": 0,
  "retry_count": 1,
  "fallback_count": 0,
  "provider_cost_usd": 0.16,
  "gateway_or_platform_cost_usd": 0.00,
  "total_cost_usd": 0.16,
  "accepted_result": true,
  "latency_ms": 11800,
  "pricing_source_url": "https://provider.example/pricing",
  "pricing_checked_at": "2026-10-12"
}
Este esquema ofrece a finanzas un número que puede conciliar y da a ingeniería los campos necesarios para explicar por qué una ruta de modelo se volvió más barata o más cara.
Fórmulas de costo a usar
Texto y llamadas de agentes
Para rutas de texto, calcula primero el costo bruto de la solicitud:
raw_text_cost =
  input_tokens * input_rate
+ output_tokens * output_rate
+ cache_write_tokens * cache_write_rate
+ cache_read_tokens * cache_read_rate
+ tool_call_costs
+ retry_and_fallback_costs
Luego normalízalo:
accepted_task_cost =
  sum(raw_text_cost for all attempts, retries, and fallbacks)
/ accepted_tasks
Si una solicitud falla y el usuario nunca recibe una respuesta, no lo ocultes. Haz un seguimiento separado del costo de las llamadas fallidas. Un panel de precios se vuelve útil cuando hace visible el tráfico fallido, reintentado y de respaldo.
Generación de imágenes
Los precios de la API de imágenes no son una unidad universal. Algunos modelos exponen tokens de prompt y tokens de salida de imagen. Otros exponen unidades por imagen, resolución, edición o específicas del proveedor. Conserva la unidad nativa y normaliza a imágenes aceptadas:
accepted_image_cost =
  (prompt_cost + input_image_cost + output_image_cost + retry_cost)
/ accepted_images
Haz un seguimiento de images_generated y images_accepted por separado. Una ruta que genera cuatro imágenes por cada imagen aceptada no debe compararse directamente con una ruta en la que los usuarios aceptan una de una.
Generación de video
Los precios de video necesitan duración, resolución y estado de trabajo asíncrono. Una llamada de video puede ponerse en cola, fallar, cancelarse, regenerarse o aceptarse más tarde.
accepted_clip_cost =
  sum(video_seconds_generated * per_second_rate by resolution)
+ retry_cost
+ fallback_cost
+ storage_or_tool_costs
Para las decisiones de producto, también haz seguimiento de:
accepted_clip_secondspreview_countregeneration_countfailed_job_counttime_to_first_preview_mstime_to_accepted_clip_ms
Un modelo de video puede ser más barato por unidad listada y aun así ser peor para el producto si los usuarios regeneran el doble de veces.
Comparar cuentas directas de proveedores con una API mult proveedor
Las cuentas directas de proveedores son suficientes cuando una familia de modelos maneja la mayor parte de tu carga de trabajo y la facturación separada es fácil de administrar. Una API mult proveedor resulta más útil cuando necesitas comparación continua de modelos, enrutamiento de respaldo o un único libro mayor entre muchos proveedores.
| Punto de decisión | Las cuentas directas de proveedores pueden ser suficientes cuando... | Una API mult proveedor ayuda cuando... |
|---|---|---|
| Elección del modelo | Un proveedor gana en la mayoría de las tareas. | Diferentes cargas de trabajo necesitan rutas de OpenAI, Claude, Gemini, DeepSeek, Qwen, imagen, video y herramientas. |
| Esfuerzo de ingeniería | Tu código ya llama a un proveedor y rara vez cambia. | Quieres un enrutamiento compatible con OpenAI y menos reescrituras de integración. |
| Control de costos | Una factura y un panel son aceptables. | Necesitas presupuestos por subclave, listas de अनुमति de modelos y exportaciones de uso por solicitud. |
| Adquisiciones | Los contratos separados son manejables. | Los contratos duplicados, las plazas inactivas y las claves de proveedor dispersas ralentizan al equipo. |
| Confiabilidad | Las caídas ocasionales del proveedor son aceptables. | Necesitas una política de respaldo y un libro mayor compartido para el costo de reintentos y respaldo. |
| Flujos de trabajo de agentes | La aplicación solo llama a modelos de texto. | Los agentes llaman a modelos, búsqueda web, acciones del navegador, herramientas de enriquecimiento, imágenes y video. |
Flatkey está diseñado para la segunda columna: una clave de API, un saldo, una factura y un libro mayor de solicitudes en múltiples rutas oficiales de modelos y herramientas. Eso no reemplaza los precios oficiales del proveedor. Le da a tu equipo un solo lugar para enrutar, medir, gobernar y conciliar esos costos. Para la perspectiva de tarifas de gateway y costos operativos, consulta precios de gateway de IA.
Cinco ejemplos de cargas de trabajo
1. Chat de soporte
El chat de soporte suele tener entrada moderada, salida breve y alto volumen. Compara:
- Tasa de acierto de caché de prompts para prompts del sistema y texto de políticas.
- Presupuesto de tokens de salida por tipo de respuesta.
- Tasa de escalamiento a un modelo más potente.
- Costo por conversación resuelta, no solo costo por mensaje.
Para esta carga de trabajo, un modelo rápido más barato puede ganar si mantiene alta la calidad de resolución. Si el modelo más barato aumenta la tasa de derivación o de edición, el ahorro aparente de tokens desaparece.
2. Agente de programación
Los agentes de programación a menudo tienen contexto grande, llamadas a herramientas, salida larga y múltiples reintentos. Compara:
- Tamaño del contexto después de la búsqueda en el repositorio o la lectura de archivos.
- Instrucciones del proyecto que se pueden cachear.
- Cantidad de llamadas a herramientas por tarea aceptada.
- Pérdida por reintentos en rutas sobrecargadas.
- Costo por cambio fusionado o parche aceptado.
Aquí es donde una comparación de precios de modelos de IA necesita un libro mayor. Una sola ejecución del agente puede incluir llamadas al modelo, llamadas a herramientas, llamadas de respaldo e intentos fallidos.
3. Generación de პასუხes RAG
Las cargas de trabajo RAG están dominadas por el contexto recuperado y la longitud de la respuesta. Compara:
- Cantidad promedio de tokens recuperados.
- Proporción estable del prefijo del prompt.
- Comportamiento de caché para documentos repetidos.
- Costos de citas o grounding.
- Tasa de aprobación del evaluador para la factualidad.
No elijas un modelo solo porque sus tokens de entrada sean baratos. Si necesita el doble de contexto o produce respuestas que fallan en la evaluación, el costo de la respuesta aceptada puede ser mayor. Si esta es la principal pregunta de migración, usa la hoja de trabajo más detallada en cómo comparar precios de modelos de IA.
4. Clasificación por lotes
La clasificación por lotes a menudo puede tolerar resultados retrasados. Compara:
- Si el proveedor tiene un nivel por lotes, flexible o de procesamiento diferido.
- Tamaño máximo del lote y ventana de finalización.
- Costo de repetición de errores.
- Tasa de aprobación de validación del esquema de salida.
- Costo total por fila aceptada.
Si un proveedor ofrece un precio por lotes más bajo, el ahorro solo aplica cuando tu flujo de trabajo puede esperar y tu proceso de reintento es limpio.
5. Generación de imágenes y video
Las API de imágenes y video rara vez encajan en una hoja de cálculo solo de tokens. Compara:
- Unidad de salida: imagen, segundo, clip, resolución, token o crédito.
- Reglas de facturación por generación fallida.
- Tasa de edición y regeneración.
- Tasa de aprobación humana.
- Costo por activo creativo aceptado.
Para los flujos de medios, mantén los modelos de tokens y los modelos de generación en pestañas separadas de la hoja de cálculo, y luego súmalos en el costo del flujo de trabajo aceptado. La economía unitaria es demasiado diferente para una sola fila combinada.
Flujo de trabajo de comparación de precios en siete pasos
- Fije la carga de trabajo. Elija una familia de tareas real, como respuestas de soporte, parches de agentes de codificación, respuestas RAG, clasificación por lotes, generación de imágenes o generación de video.
- Recopile los precios oficiales actuales. Use las páginas de precios del proveedor, las páginas de modelos de Flatkey y una fecha verificada. Evite tarjetas de tarifas copiadas sin URL de origen.
- Repita el tráfico representativo. Use los mismos prompts, entradas, límites de salida, política de herramientas y validadores en todas las rutas.
- Registre cada unidad facturable. Capture tokens de entrada, tokens almacenados en caché, tokens de salida, unidades de medios, llamadas a herramientas, intentos de reintento, errores y estado.
- Puntúe los resultados aceptados. Use revisión humana, validadores automatizados o comprobaciones de aprobado/reprobado específicas de la tarea.
- Calcule el costo efectivo. Divida el costo total de la ruta por los resultados aceptados, no por el total de solicitudes.
- Añada controles operativos. Decida si la ruta ganadora también cumple con los límites de presupuesto, las necesidades de facturación, la gobernanza de claves, la retención de datos y la alternativa de respaldo ante incidentes.
El resultado es una decisión de precios que ingeniería, producto y compras pueden defender.
Vistas mínimas del panel
Comparación de rutas
Muestre rutas de texto, imagen y video en una sola tabla.
| Ruta | Unidad nativa | Campo de costo nativo | Campo de aceptación | KPI normalizado |
|---|---|---|---|---|
| Modelo de texto | Tokens | Tokens de entrada, salida y caché | Respuesta aceptada | Costo por respuesta aceptada |
| Agente de codificación | Tokens más herramientas | Costos de tokens y herramientas | PR fusionado, ticket resuelto, tarea completada | Costo por flujo de trabajo completado |
| Modelo de imagen | Unidades de imagen o de token | Imágenes generadas, tokens de imagen de salida | Imagen aceptada | Costo por imagen aceptada |
| Modelo de video | Segundos, clips o unidades del proveedor | Segundos generados por resolución | Clip aceptado | Costo por clip aceptado |
Presupuesto por función
Agrupe por función, no solo por proveedor. Para los equipos de producto, esto es más útil que una factura de un proveedor porque muestra si el gasto lo impulsan el onboarding, el chat, la generación creativa, la búsqueda o la exportación.
Columnas sugeridas:
featureroute_typerequestsaccepted_resultsacceptance_ratetotal_cost_usdcost_per_accepted_resultp95_latency_msfallback_rateretry_rate
Deriva del proveedor y del modelo
Cada proveedor cambia la disponibilidad del modelo, los precios y el estado del ciclo de vida. Almacene:
- URL de la fuente de precios.
- Fecha de verificación de precios.
- Versión del modelo o ID de la ruta.
- Tipo de unidad.
- Política de caché.
- Política de descuento por lotes, si se usa.
- Notas de obsolescencia o ciclo de vida.
Esto mantiene útil una comparación de precios de modelos de IA después del lanzamiento, no solo durante la selección inicial del modelo.
Límites de margen
Añada una regla simple de margen a cada función de IA:
max_ai_cost_per_customer_action =
  expected_revenue_per_action * target_ai_cost_percentage
Ejemplo:
Si una acción del cliente genera $0.40 de margen bruto
y el costo de IA debe mantenerse por debajo del 20%,
entonces el presupuesto de la ruta es $0.08 por resultado aceptado.
Esto mantiene la selección del modelo vinculada al negocio en lugar de a puntajes abstractos de referencia.
Errores comunes
| Error | Qué hacer en su lugar |
|---|---|
| Comparar solo las tarifas de tokens de entrada | Compare entrada, entrada almacenada en caché, salida, medios, herramientas, reintentos y resultados aceptados. |
| Mezclar texto, imagen, video y herramientas en una sola unidad | Conserve las unidades nativas y luego normalice cada ruta al costo por resultado aceptado. |
| Ignorar el almacenamiento en caché de prompts | Mida los prefijos de prompt estables y la tasa de aciertos de caché. |
| Ignorar la elegibilidad para lotes | Separe las cargas de trabajo sensibles a la latencia y las fuera de línea. |
| Confiar en tablas de precios copiadas y obsoletas | Almacene las URL oficiales de origen y las fechas de verificación. |
| Tratar el costo de la pasarela como solo un recargo | Incluya gobernanza, conmutación por error, exportaciones de uso, facturas y tiempo de ingeniería. |
| Elegir la solicitud más barata | Elija el resultado aceptado más barato que cumpla los requisitos de calidad y fiabilidad. |
Preguntas frecuentes
¿Cuál es la mejor manera de comparar los precios de los modelos de IA?
La mejor manera de comparar los precios de los modelos de IA es conservar la unidad de facturación nativa de cada proveedor y luego normalizar cada ruta al costo por resultado aceptado. Para texto, eso puede ser el costo por respuesta aceptada. Para imágenes, use el costo por imagen aceptada. Para video, use el costo por clip aceptado o por segundo de clip aceptado.
¿Qué debe incluir un gráfico de comparación de modelos de IA?
Un gráfico de comparación de modelos de IA debe incluir el modelo o ID de ruta, el proveedor, la URL de la fuente de precios, la fecha de verificación, los tokens de entrada, la entrada almacenada en caché, los tokens de salida, las unidades de medios, las llamadas a herramientas, la tasa de reintentos, la tasa de fallback, la tasa de aceptación, la latencia y el costo por resultado aceptado.
¿Las tablas de precios deberían incluir los precios exactos del proveedor?
Use precios exactos dentro de tu hoja de trabajo interna, pero guarda la URL de origen y la fecha de verificación junto a cada fila. Los artículos estáticos públicos deben evitar tablas de tarifas copiadas sin fuente, porque los precios del proveedor, los nombres de los modelos, los descuentos y el estado del ciclo de vida pueden cambiar rápidamente.
¿Cómo comparas los costos de tokens con los costos de imágenes y video?
No fuerces todas las rutas a convertirse en tokens. Mantén las unidades nativas en el libro mayor y luego agrega campos normalizados como accepted_task_cost_usd, accepted_image_cost_usd y accepted_clip_cost_usd.
¿Dónde ayuda Flatkey con la comparación de precios de modelos de IA?
Flatkey ayuda cuando quieres una sola clave, un solo saldo, una sola factura y un solo libro mayor de uso en muchas rutas de modelos y herramientas. Eso facilita comparar los costos de texto, imagen, video y agentes sin tener que conciliar primero cuentas separadas de distintos proveedores.
¿Con qué frecuencia se deben volver a revisar los precios?
Vuelve a revisar los precios antes de cada cambio importante de enrutamiento, revisión de contrato o previsión presupuestaria. Para cargas de trabajo de producción que cambian rápidamente, actualiza los precios críticos de las rutas semanalmente e inmediatamente después de que un proveedor lance, renombre, descontinúe o cambie el precio de un modelo que uses.
Conclusión final
Una comparación de precios de modelos de IA no es una tabla de precios más bonita. Es un sistema operativo para la selección de modelos.
Mantén las unidades del proveedor. Añade seguimiento de aceptación. Normaliza cada ruta al costo por resultado aceptado. Luego elige la ruta que mejore el margen del producto, la confiabilidad y la gobernanza, no la ruta que parezca más barata de forma aislada.
Con Flatkey, esa comparación puede vivir sobre una sola clave, un solo saldo y un solo libro mayor, para que los desarrolladores, los equipos de producto y los equipos de compras puedan pasar de facturas dispersas de proveedores a decisiones de costo por ruta.