
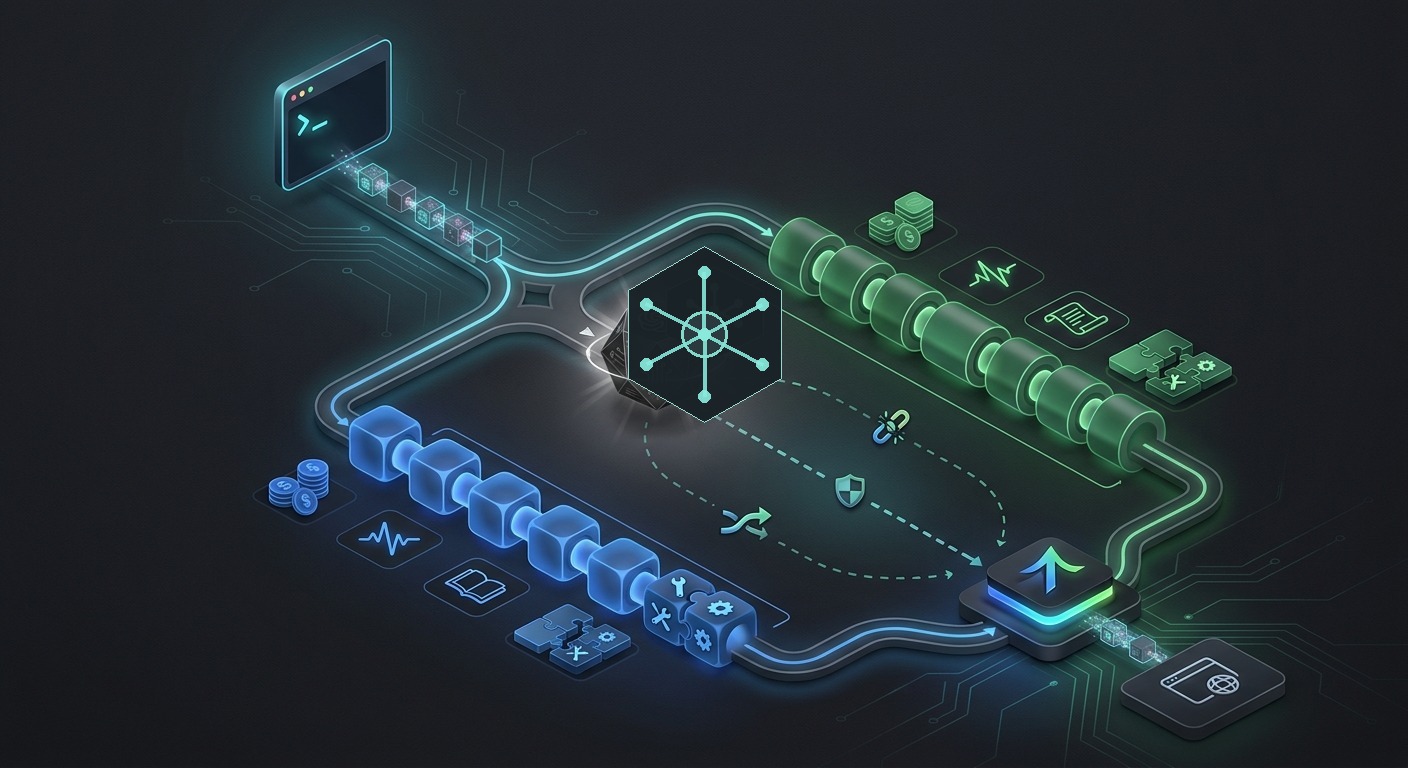
Routage API Claude vs GPT : quand privilégier des modèles propres au fournisseur ou une passerelle n’est pas seulement une question de qualité de modèle. C’est une question de routage en production : quelles requêtes doivent rester sur une API native du fournisseur, lesquelles peuvent passer par une route compatible OpenAI, et lesquelles doivent être placées derrière une passerelle afin que le choix du modèle, la facturation, les journaux et les mécanismes de repli ne se dispersent pas dans chaque service.
Utilisez les API directes des fournisseurs lorsque la charge de travail dépend d’un comportement natif d’Anthropic ou d’OpenAI. Utilisez une passerelle lorsque le plus gros problème est la prolifération opérationnelle : trop de clés, de factures, d’identifiants de modèle, de vérifications d’état, de règles de relance et de rapports d’utilisation entre les équipes.
Flatkey s’inscrit dans le modèle de passerelle. Sa documentation décrit une URL de base REST compatible OpenAI à https://router.flatkey.ai/v1, une seule clé API, un catalogue de modèles unique et des journaux d’utilisation pour examiner les appels aux modèles. Cela le rend utile lorsque Claude, GPT, Gemini, DeepSeek, Qwen, les modèles d’image, les modèles vidéo et les outils d’agent font partie de la même surface d’exploitation.
La réponse la plus sûre est généralement hybride. Routez les fonctionnalités natives de manière native jusqu’à ce que la passerelle prouve sa compatibilité. Routez le chat standard, l’évaluation, les automatisations internes et les expérimentations multi-modèles via une passerelle lorsque l’accès partagé et l’observabilité comptent davantage que le contrôle spécifique au fournisseur.
Réponse rapide : Claude en direct, GPT en direct ou passerelle ?
| Choix de routage | À privilégier lorsque | À vérifier avant le lancement |
|---|---|---|
| API Claude directe | Le produit dépend du comportement de l’API Messages d’Anthropic, des identifiants de modèle Claude, de l’utilisation des outils Claude, du cache de prompts, de Message Batches ou des contrôles de compte Anthropic. | Identifiant de modèle actuel, forme de la requête, événements de streaming, flux d’utilisation des outils, comportement du cache, adéquation des lots, limites de débit, paramètres de données, page d’état et unités de facturation. |
| API GPT/OpenAI directe | Le produit dépend du comportement de l’API Responses d’OpenAI, des outils hébergés, de Structured Outputs, de la compatibilité avec Chat Completions, des niveaux de service ou des contrôles de projet OpenAI. | Identifiant de modèle actuel, forme Responses par rapport à Chat Completions, appels d’outils, gestion des schémas, consommateur d’événements de streaming, paramètres de stockage, limites de débit, page d’état et reporting d’utilisation. |
| Route via passerelle | Le produit a besoin d’un accès multi-fournisseurs, d’une seule URL de base, d’une vue unique de l’utilisation, d’une évaluation des modèles simplifiée, d’une politique de repli et d’un examen de la facturation entre équipes. | Famille d’endpoints prise en charge, disponibilité des modèles, parité des fonctionnalités, comportement de repli, champs des journaux d’utilisation, unité tarifaire, propriété des quotas et chemin de retour arrière. |
C’est la décision pratique derrière Routage API Claude vs GPT : quand privilégier des modèles propres au fournisseur ou une passerelle. Ne demandez pas quel fournisseur est meilleur en théorie. Demandez quel chemin donne à une charge de travail précise le bon support de fonctionnalités, la bonne observabilité, le bon contrôle des coûts et le bon mécanisme de reprise.
Pourquoi le routage API Claude vs GPT devient compliqué
Un prototype demande généralement : « Quel modèle a donné la meilleure réponse ? » Un système de production pose des questions plus difficiles :
- Ce flux de travail a-t-il besoin d’une forme d’API native au fournisseur ?
- La route préservera-t-elle les appels d’outils, la sortie structurée, le streaming, le comportement de cache et les raisons d’arrêt ?
- Qui possède la clé API, le quota, le compte fournisseur et la facture ?
- Les finances peuvent-elles relier une hausse d’utilisation à un modèle, une équipe, un environnement ou un client ?
- Que se passe-t-il lorsqu’un alias de modèle change, qu’une limite de débit du fournisseur se resserre ou qu’une route commence à renvoyer
429? - L’équipe peut-elle revenir en arrière sans modifier chaque service ?
Les routes Claude et GPT peuvent toutes deux être de bons choix, mais la route elle-même devient partie intégrante du produit. Un modèle performant derrière une route non observable peut toujours créer un risque opérationnel.
Privilégiez l’API Claude directe lorsque le comportement natif de Claude est requis
Choisissez un accès direct à l’API Claude lorsque votre charge de travail est intentionnellement construite autour du comportement natif d’Anthropic.
Ce peut être le bon choix lorsque vous avez besoin de :
- La sémantique des requêtes et réponses de l’API Messages d’Anthropic comme source de vérité.
- Des identifiants et alias de modèles Claude exactement tels qu’Anthropic les documente.
- Du comportement d’utilisation des outils de Claude, y compris la gestion de
tool_useettool_result. - Du comportement de mise en cache des prompts pour le contexte répété.
- De Message Batches pour les charges de travail hors ligne qui n’ont pas besoin de réponses immédiates.
- Des limites de débit, du reporting d’utilisation, des contrôles de données et du support de compte propres à Anthropic.
La route directe est également plus simple lors d’un examen d’incident lorsque vous avez besoin de détails de requête natifs Anthropic, de chemins de support, de preuves de facturation ou de paramètres de compte.
Le compromis, c’est la portée. Si le même produit utilise aussi GPT, Gemini, de l’inférence open source, la génération d’images, la génération de vidéos et des outils d’agent, chaque route fournisseur directe ajoute une clé, une console, une facture, une page d’état, une politique de limites et une exportation d’utilisation supplémentaires.
Privilégiez l’API GPT/OpenAI directe lorsque les fonctionnalités natives d’OpenAI définissent le flux de travail
Choisissez un accès direct à l’API OpenAI lorsque la charge de travail dépend du comportement natif de l’API OpenAI.
Ce peut être le bon choix lorsque vous avez besoin de :
- De l’API Responses d’OpenAI pour le raisonnement, les outils, les flux avec état ou les entrées multimodales.
- D’outils hébergés par OpenAI tels que la recherche web, la recherche de fichiers, l’interpréteur de code, la génération d’images, l’utilisation d’ordinateur ou MCP à distance.
- De sorties structurées selon les contrôles de schéma actuels d’OpenAI.
- Des identifiants de modèles OpenAI, des paramètres de projet, des niveaux de service, des paramètres de stockage et du reporting d’utilisation.
- Du support direct du fournisseur pour un comportement critique au lancement.
La route GPT directe peut être la voie la plus simple lorsque votre application est déjà conçue autour de la surface d’API actuelle d’OpenAI et que vous avez besoin d’une fidélité au niveau des fonctionnalités plutôt que d’une abstraction multi-fournisseur.
Le compromis est le même que pour Claude en direct : le contrôle natif du fournisseur s’accompagne d’opérations natives du fournisseur. Vous êtes responsable du compte, des clés, des quotas, des journaux, du chemin de facturation, des contrôles d’état et de la logique de repli pour cette route.
Privilégiez une passerelle lorsque la route est un problème d’exploitation
Utilisez une passerelle lorsque l’équipe a davantage besoin d’une couche opérationnelle unique sur de nombreux modèles que de chaque fonctionnalité native de fournisseur sur chaque route.
Dans Claude vs GPT API Routing: When to Prefer Provider-Specific Models or a Gateway, une passerelle est utile lorsque :
- Les développeurs doivent tester les modèles Claude, GPT, Gemini, DeepSeek, Qwen, image ou vidéo sans ouvrir de comptes distincts chez chaque fournisseur pour chaque expérience.
- Les clients existants compatibles OpenAI doivent conserver une URL de base stable tandis que le choix du modèle change selon la charge de travail.
- Le service financier veut un seul endroit pour examiner l’utilisation au niveau des requêtes et les justificatifs de facturation.
- Les équipes plateforme ont besoin d’une propriété partagée des clés, d’un examen des quotas, de vérifications des routes et de plans de retour arrière.
- Les créateurs d’agents ont besoin d’une manière cohérente de tester le chat, le streaming, les appels d’outils et les journaux d’utilisation.
- Les équipes achats veulent une liste claire des modèles approuvés, des unités tarifaires et des responsables internes avant la mise en production d’une nouvelle route.
Le positionnement de Flatkey est construit autour de ce schéma : une clé, un solde, une facture, un accès officiel aux modèles, des journaux d’utilisation et un routeur compatible OpenAI. La réserve importante est simple : une passerelle ne doit pas être considérée comme une équivalence fonctionnelle automatique. Si une charge de travail dépend d’un comportement natif du fournisseur, testez ce comportement exact via la passerelle avant d’envoyer du trafic de production.
Pour le schéma de migration plus large, associez ce guide à la checklist alternative à l’API OpenAI de Flatkey et au workflow API IA unifiée.
Une matrice de décision de routage API Claude vs GPT
Utilisez cette matrice lors de l’examen d’implémentation.
| Domaine de décision | API Claude directe | API GPT/OpenAI directe | Route via passerelle |
|---|---|---|---|
| Dépendance à des fonctionnalités natives | Très adaptée à l’API Messages d’Anthropic, à l’utilisation d’outils Claude, à la mise en cache des prompts et à Message Batches. | Très adaptée à l’API Responses d’OpenAI, aux outils hébergés, aux Structured Outputs et aux contrôles de projet OpenAI. | Adaptée une fois que l’ensemble exact de fonctionnalités a passé un test rapide de route. |
| Migration du SDK | Idéale lorsque l’application utilise déjà les schémas de requête/SDK Anthropic. | Idéale lorsque l’application utilise déjà les schémas de requête/SDK OpenAI. | Idéale lorsque l’application peut utiliser une seule URL de base compatible OpenAI pour tous les modèles pris en charge. |
| Évaluation des modèles | Bonne pour des tests approfondis spécifiques à Claude. | Bonne pour des tests approfondis spécifiques à GPT/OpenAI. | Bonne pour comparer les modèles pris en charge sous une même couche de journalisation et de facturation. |
| Examen de la facturation | Données de facturation et d’utilisation propres au fournisseur. | Données de facturation et d’utilisation propres au fournisseur. | Examen partagé de l’utilisation et de la facturation lorsque les journaux de la passerelle exposent les champs nécessaires. |
| Solution de secours | Votre application gère la logique de retry et de fallback. | Votre application gère la logique de retry et de fallback. | La passerelle peut simplifier le basculement de route, mais votre application a toujours besoin de validateurs et de conditions d’arrêt. |
| Vérifications d’état | Statut Anthropic plus journaux de l’application. | Statut OpenAI plus journaux de l’application. | Statut du fournisseur, statut de la passerelle et journaux de route au niveau de l’application. |
| Examen de conformité | Les contrôles directs du fournisseur sont plus faciles à cartographier. | Les contrôles directs du fournisseur sont plus faciles à cartographier. | Utile pour les contrôles centralisés, mais les acheteurs ont toujours besoin de preuves du fournisseur et de la passerelle. |
La règle fondamentale : acheminer les fonctionnalités natives nativement ; acheminer la complexité opérationnelle via une passerelle.
Adapter la route à la charge de travail
Ne choisissez pas une réponse globale unique pour chaque requête. Commencez par la charge de travail.
| Charge de travail | Route qui convient souvent en premier | Pourquoi |
|---|---|---|
| Agent natif du fournisseur utilisant le comportement d’outils Anthropic | API Claude directe | Le contrat des outils et les blocs de réponse peuvent être l’exigence produit. |
| Workflow OpenAI Responses avec outils hébergés | API GPT/OpenAI directe | Le workflow dépend des outils, de l’état et du comportement de schéma natifs d’OpenAI. |
| Chat standard ou synthèse sur plusieurs modèles | Route via passerelle | La forme de la requête est généralement plus facile à comparer derrière une seule couche de routage. |
| Évaluation hors ligne ou backfill | Route via passerelle ou API batch du fournisseur | La meilleure réponse dépend de la prise en charge du batch, du coût de la sortie acceptée et de la tolérance au délai. |
| Utilisation multi-équipes sensible aux finances | Route via passerelle | Une vue unique de l’usage et un seul chemin de facturation peuvent compter davantage que les consoles natives des fournisseurs. |
| Charge de travail réglementée ou revue par un fournisseur | Fournisseur direct ou hybride | Des preuves directes peuvent être requises tant que les contrôles de la passerelle ne sont pas approuvés. |
Pour une réflexion voisine sur la comparaison des modèles, voir l’article de Flatkey Gemini vs Claude API routing et le guide du catalogue de modèles d’IA.
Liste de contrôle préalable avant de déplacer le trafic
Avant de modifier la production Claude vs GPT API Routing: When to Prefer Provider-Specific Models or a Gateway, conservez des preuves pour chaque route candidate.
- ID et alias du modèle : capturez l’ID exact du modèle, le fournisseur, la famille de l’endpoint et la date de vérification.
- Forme de l’endpoint : confirmez si la route utilise Anthropic Messages, OpenAI Chat Completions, OpenAI Responses ou une autre famille d’API.
- Adéquation fonctionnelle : testez les outils, la sortie structurée, le streaming, la vision, les fichiers, le cache de prompts, les outils hébergés, MCP ou le batch uniquement si la charge de travail en a besoin.
- Lecture de l’usage : confirmez où apparaissent les jetons d’entrée, les jetons de sortie, les jetons mis en cache, les comptes de requêtes, les unités média, la latence, les erreurs et les coûts.
- Unité de tarification : vérifiez si la route facture au jeton, à la requête, à l’image, à la seconde, à l’unité de batch, à la lecture/écriture du cache ou à une autre unité.
- Statut et santé : enregistrez l’état du fournisseur et les preuves de santé de la route de passerelle au moment du lancement.
- Comportement en cas d’échec : consignez le comportement pour
401,403, modèle introuvable,429, dépassement de délai, échec d’appel d’outil, échec de schéma et interruption de streaming. - Règle de repli : définissez quand réessayer, changer de modèle, mettre en file d’attente, dégrader la sortie ou arrêter.
- Responsable : désignez un responsable pour les clés, les quotas, la revue budgétaire et les changements de route.
- Retour arrière : conservez un chemin testé vers la route précédente jusqu’à ce que la nouvelle route dispose d’éléments de preuve en production.
Cette liste de contrôle est importante, car le routage API Claude vs GPT échoue généralement de manière ordinaire : un alias de modèle obsolète, une incompatibilité de base URL, un analyseur qui attend une mauvaise forme d’événement, ou une revue financière sans preuve au niveau de la requête.
Un tableau de score de routage que vous pouvez copier
Utilisez ce tableau de score après le test de fumée de prévol. Notez chaque route de 1 à 5 pour la même charge de travail.
| Critère | Poids | Claude direct | GPT/OpenAI direct | Passerelle | Notes |
|---|---|---|---|---|---|
| Adéquation aux fonctionnalités natives | 20% | La route prend-elle en charge exactement le comportement d’API requis ? | |||
| Taux de sortie acceptée | 20% | La sortie passe-t-elle le validateur de charge de travail ? | |||
| Coût par sortie acceptée | 15% | Inclure les nouvelles tentatives, le fallback, le cache, les outils et les sorties rejetées. | |||
| Latence et taux de timeout | 15% | Mesurez le p50, le p90, le p99 et le comportement du premier jeton en streaming. | |||
| Observabilité | 15% | Les équipes d’ingénierie et de finance peuvent-elles examiner les mêmes preuves de requête ? | |||
| Fallback et rollback | 10% | Le système peut-il se rétablir sans perte de qualité cachée ? | |||
| Gouvernance | 5% | Les clés, propriétaires, budgets et modèles approuvés sont-ils clairs ? |
Le gagnant est la route qui passe la charge de travail, et non le fournisseur avec la sortie de modèle la plus bruyante.
route_review:
  workload: support_summary
  candidates:
    - direct_claude
    - direct_openai
    - flatkey_gateway
  required_features:
    - streaming
    - json_schema_output
    - usage_readback
  launch_rule:
    minimum_score: 4
    accepted_output_rate: ">= target set by owner"
    rollback_path_required: true
Si vous mesurez la route après le lancement, utilisez le cadre des métriques d’API de routage IA de Flatkey comme étape suivante.
Comment Flatkey modifie le flux de travail
Flatkey ne supprime pas la nécessité de choisir le bon modèle. Il modifie l’endroit où se situe la charge liée à l’accès, à l’utilisation et à la facturation.
Avec Flatkey, une équipe peut tester une route compatible avec OpenAI comme ceci :
curl https://router.flatkey.ai/v1/chat/completions \
  -H "Authorization: Bearer $FLATKEY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "your-verified-model-id",
    "messages": [
      { "role": "user", "content": "Run a smoke test for this route." }
    ]
  }'
Ce chemin est utile lorsque l’application parle déjà une forme de complétion de chat compatible avec OpenAI et que l’équipe veut un seul endroit pour évaluer les modèles pris en charge. Il est également utile lorsque les équipes finance et plateforme ont besoin d’une visibilité partagée sur les coûts avant que les expériences ne deviennent les valeurs par défaut en production.
Avant le lancement, vérifiez encore le modèle dans le catalogue Flatkey actuel, la page de tarification et le tableau de bord d’utilisation. Vérifiez la famille de l’endpoint, la disponibilité, l’unité de tarification, les journaux de requêtes, le propriétaire du quota et le comportement de repli. Faites de même pour tout chemin direct Claude ou GPT que vous conservez en dehors de la passerelle.
Schéma de migration sûr
Une migration propre du routage API Claude vs GPT se déroule par étapes.
- Établissez la ligne de base du route actuel : enregistrez les prompts, les identifiants de modèle, les sorties attendues, l’utilisation des tokens, la latence, le taux d’erreur et les hypothèses de coût actuelles.
- Exécutez des tests natifs au fournisseur : testez le comportement direct de Claude et de GPT pour les fonctionnalités réellement utilisées par votre charge de travail.
- Exécutez des tests via la passerelle : envoyez les mêmes cas représentatifs via le chemin Flatkey et comparez la forme des sorties, les erreurs, la latence et les journaux d’utilisation.
- Déplacez d’abord le trafic à faible risque : commencez par les outils internes, les jobs d’évaluation ou un petit pourcentage du trafic non critique.
- Surveillez les preuves de routage : comparez le taux de sortie acceptée, le nombre de requêtes, l’utilisation des tokens, le coût, les
429, les timeouts et les erreurs de modèle introuvable. - Documentez les conditions d’arrêt : définissez le signal exact qui renvoie le trafic vers le route précédent.
- Ne validez qu’après confirmation : ne considérez pas la migration comme terminée tant que l’utilisation, la facturation et les preuves de routage ne sont pas visibles par les équipes qui en sont responsables.
Cela maintient séparées la décision de modèle et la décision de route. Un modèle peut être performant alors que le route n’est pas prêt. Une passerelle peut être utile sur le plan opérationnel alors qu’une fonctionnalité native mérite encore un chemin direct chez le fournisseur.
Erreurs courantes
| Erreur | Pourquoi cela nuit | Meilleure décision de route |
|---|---|---|
| Considérer la compatibilité OpenAI comme une parité fonctionnelle universelle | Le texte de chat peut fonctionner alors que les outils, le streaming, la sortie structurée ou les entrées multimodales diffèrent. | Effectuez un test de fumée sur l’ensemble exact de fonctionnalités avant le lancement. |
| Copier les identifiants de modèle depuis d’anciens contenus | Les identifiants de modèle, les alias et la disponibilité peuvent changer selon le fournisseur et la passerelle. | Copiez les identifiants depuis la documentation actuelle du fournisseur, la console ou le catalogue Flatkey. |
| Comparer uniquement la qualité des réponses | La facturation, les journaux, la propriété des clés, le quota, le repli et la gestion des statuts deviennent des coûts de production. | Comparez les opérations de routage en même temps que la qualité des sorties. |
| Déplacer tout le trafic d’un coup | Un parseur, un alias de modèle ou un problème de quota peut provoquer une panne totale. | Faites un déploiement progressif du route et gardez un retour en arrière prêt. |
| Laisser chaque équipe choisir son propre compte fournisseur | Les équipes finance et plateforme perdent en visibilité. | Utilisez une passerelle partagée ou un workflow d’approbation pour les routes de production. |
Vérifications des sources à garder ouvertes
Utilisez la documentation en direct lors de la finalisation d’un route :
- Modèles OpenAI, outils et documentation sur les Structured Outputs.
- Tarification de l’API OpenAI pour les unités de tarification et les lignes de modèles actuelles.
- Modèles Claude, utilisation des outils, mise en cache des prompts et documentation sur les lots de messages.
- Démarrage rapide Flatkey, aperçu de l’API REST et guide du SDK OpenAI.
- catalogue de modèles, page de tarification et page de statut actuels de Flatkey.
Ne codez pas en dur dans une politique de production des prix de modèles volatils tirés d’un article de blog. Enregistrez la ligne source actuelle du fournisseur ou de la passerelle au moment où vous approuvez la route.
Recommandation finale
Pour Routage API Claude vs GPT : quand privilégier des modèles propres au fournisseur ou une passerelle, commencez par la charge de travail et ses dépendances API.
- Si la charge de travail dépend d’un comportement natif Anthropic, utilisez Claude directement jusqu’à ce qu’une passerelle démontre le même comportement.
- Si la charge de travail dépend des Responses natives d’OpenAI, des outils hébergés ou du comportement des Structured Outputs, utilisez OpenAI directement jusqu’à ce qu’une passerelle démontre le même comportement.
- Si la charge de travail est du chat standard, de l’évaluation, de l’automatisation interne ou de l’exploration multi-modèles, utilisez une passerelle lorsque une clé unique, une URL de base unique, les journaux d’utilisation, la revue de facturation et la politique de repli comptent plus que la spécificité du fournisseur natif.
Flatkey mérite d’être évalué lorsque la douleur de l’équipe n’est pas « Quel modèle existe ? », mais « Comment exploiter en toute sécurité de nombreux modèles sans multiplier les comptes, les clés, les factures et les vérifications de routage ? »
Commencez par le catalogue de modèles, la page de tarification et les journaux d’utilisation. Exécutez la checklist de prévol. Ne promouvez la route que lorsque la sortie passe votre validateur de charge de travail et que les preuves d’utilisation sont visibles pour les personnes responsables de l’ingénierie, de la plateforme et de la finance.
Questions fréquentes
Le routage API Claude vs GPT concerne-t-il uniquement la qualité des modèles ?
Non. La qualité des modèles compte, mais le routage API Claude vs GPT inclut aussi la forme de l’endpoint, le comportement des outils, la sortie structurée, le streaming, les unités de tarification, les pages de statut, les quotas, les journaux et le retour en arrière.
Quand dois-je éviter une passerelle ?
Évitez de faire transiter une charge de travail par une passerelle tant que vous n’avez pas vérifié chaque fonctionnalité spécifique au fournisseur dont elle dépend. Les API directes du fournisseur sont plus sûres pour les premiers lancements qui dépendent d’un comportement natif pas encore testé via la passerelle.
Puis-je conserver à la fois des routes directes vers le fournisseur et Flatkey ?
Oui. Beaucoup d’équipes le devraient. Conservez des routes Claude directes ou GPT directes pour les charges de travail spécifiques aux fonctionnalités, et utilisez Flatkey pour l’accès multi-modèles, l’évaluation, la visibilité de la facturation et le contrôle opérationnel lorsque la route testée prend en charge la charge de travail.
Quel est le premier test pour une route Flatkey ?
Commencez par un petit test de fumée de complétion de chat, puis vérifiez l’ID du modèle, la famille de l’endpoint, le journal d’utilisation, l’unité de tarification, la gestion des erreurs et le rollback. Ne transférez pas le trafic de production tant que les équipes responsables de la plateforme et de la finance ne peuvent pas lire les mêmes éléments de preuve.
Quels liens Flatkey doivent étayer cette décision ?
Utilisez le catalogue des modèles, la page de tarification, le guide de l’API IA unifiée, le guide d’alternative à l’API OpenAI et l’article sur les métriques de routage API IA lorsque vous construisez la revue de routage.


