
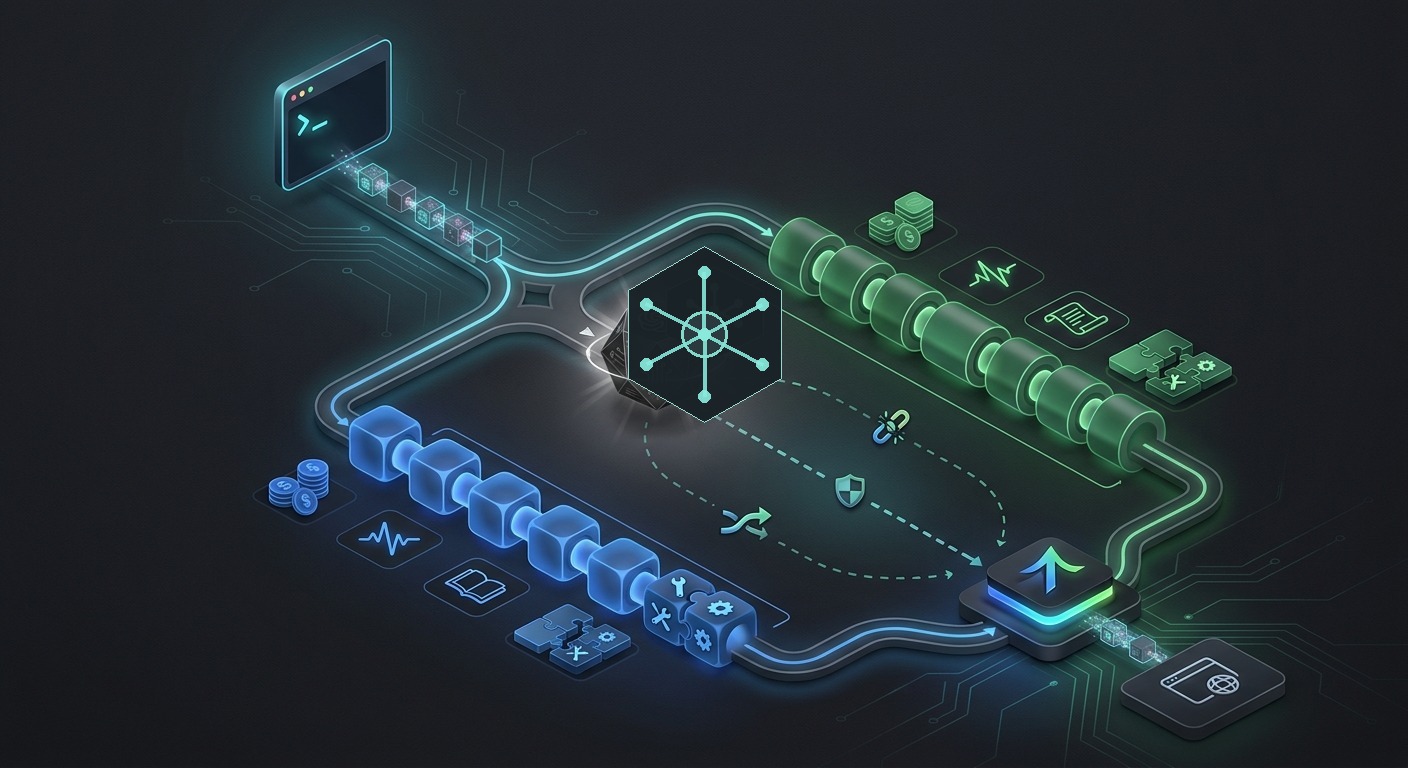
Roteamento de API Claude vs GPT: Quando Preferir Modelos Específicos do Fornecedor ou um Gateway não é apenas uma questão de qualidade do modelo. É uma questão de roteamento em produção: quais solicitações devem permanecer em uma API nativa do fornecedor, quais podem ser executadas por um caminho compatível com OpenAI e quais devem ficar atrás de um gateway para que a escolha do modelo, a cobrança, os logs e o fallback não se espalhem por todos os serviços.
Use APIs diretas do fornecedor quando a carga de trabalho depender do comportamento nativo da Anthropic ou da OpenAI. Use um gateway quando o problema maior for a dispersão operacional: muitas chaves, faturas, IDs de modelo, verificações de status, regras de retry e relatórios de uso entre equipes.
A Flatkey se encaixa no padrão de gateway. Sua documentação descreve uma base URL REST compatível com OpenAI em https://router.flatkey.ai/v1, uma chave de API, um catálogo de modelos e logs de uso para revisar chamadas de modelo. Isso a torna útil quando Claude, GPT, Gemini, DeepSeek, Qwen, modelos de imagem, modelos de vídeo e ferramentas de agentes fazem parte da mesma superfície operacional.
A resposta segura geralmente é híbrida. Encaminhe os recursos nativos de forma nativa até que o gateway prove compatibilidade. Encaminhe chat padrão, avaliação, automações internas e experimentos com múltiplos modelos por meio de um gateway quando acesso compartilhado e observabilidade importarem mais do que o controle específico do fornecedor.
Resposta rápida: Claude direto, GPT direto ou gateway?
| Escolha de roteamento | Prefira quando | Verifique antes do lançamento |
|---|---|---|
| API Claude direta | O produto depende do comportamento da Messages API da Anthropic, dos IDs de modelo Claude, do uso de ferramentas do Claude, do prompt caching, de Message Batches ou dos controles de conta da Anthropic. | ID de modelo atual, formato da solicitação, eventos de streaming, fluxo de uso de ferramentas, comportamento de cache, adequação de batch, limites de taxa, configurações de dados, página de status e unidades de cobrança. |
| API GPT/OpenAI direta | O produto depende do comportamento da Responses API da OpenAI, de ferramentas hospedadas, Structured Outputs, compatibilidade com Chat Completions, service tiers ou controles de projeto da OpenAI. | ID de modelo atual, formato Responses versus Chat Completions, chamadas de ferramenta, tratamento de schema, consumidor de eventos de streaming, configurações de armazenamento, limites de taxa, página de status e relatórios de uso. |
| Rota via gateway | O produto precisa de acesso multi-fornecedor, uma base URL, uma visão única de uso, avaliação de modelos mais simples, política de fallback e revisão de cobrança entre equipes. | Família de endpoints suportada, disponibilidade de modelos, paridade de recursos, comportamento de fallback, campos do log de uso, unidade de preço, propriedade da cota e caminho de rollback. |
Essa é a decisão prática por trás de Roteamento de API Claude vs GPT: Quando Preferir Modelos Específicos do Fornecedor ou um Gateway. Não pergunte qual fornecedor é melhor em abstrato. Pergunte qual rota dá a uma carga de trabalho específica o suporte de recursos, a observabilidade, o controle de custos e o caminho de recuperação corretos.
Por que o roteamento de API Claude vs GPT fica confuso
Um protótipo geralmente pergunta: "Qual modelo deu a melhor resposta?" Um sistema de produção faz perguntas mais difíceis:
- Este fluxo de trabalho precisa de uma forma nativa da API do fornecedor?
- A rota preservará chamada de ferramentas, saída estruturada, streaming, comportamento de cache e motivos de parada?
- Quem é o proprietário da chave de API, da cota, da conta do fornecedor e da fatura?
- As finanças conseguem associar um pico de uso a um modelo, equipe, ambiente ou cliente?
- O que acontece quando um alias de modelo muda, um limite de taxa do fornecedor fica mais rígido ou uma rota começa a retornar
429? - A equipe consegue reverter sem editar todos os serviços?
As rotas Claude e GPT podem ser boas escolhas, mas a própria rota passa a fazer parte do produto. Um modelo forte atrás de uma rota não observável ainda pode criar risco operacional.
Prefira a API direta do Claude quando o comportamento nativo do Claude for o requisito
Escolha o acesso direto à API do Claude quando sua carga de trabalho for construída intencionalmente em torno do comportamento nativo da Anthropic.
Essa pode ser a escolha certa quando você precisa de:
- Semântica de requisição e resposta da Anthropic Messages API como fonte da verdade.
- IDs e aliases de modelos do Claude exatamente como a Anthropic os documenta.
- Comportamento de uso de ferramentas do Claude, incluindo o tratamento de
tool_useetool_result. - Comportamento de cache de prompt para contexto repetido.
- Message Batches para cargas de trabalho offline que não precisam de respostas imediatas.
- Limites de taxa, relatórios de uso, controles de dados e suporte de conta específicos da Anthropic.
A rota direta também é mais simples durante a análise de incidentes, quando você precisa de detalhes de requisição nativos da Anthropic, caminhos de suporte, evidências de faturamento ou configurações de conta.
A desvantagem é o escopo. Se o mesmo produto também usa GPT, Gemini, inferência de código aberto, geração de imagens, geração de vídeo e ferramentas de agente, cada rota direta de fornecedor adiciona outra chave, console, fatura, página de status, política de limite e exportação de uso.
Prefira a API direta do GPT/OpenAI quando os recursos nativos da OpenAI definirem o fluxo de trabalho
Escolha o acesso direto à API da OpenAI quando a carga de trabalho depender do comportamento nativo da API da OpenAI.
Essa pode ser a escolha certa quando você precisa de:
- A OpenAI Responses API para raciocínio, ferramentas, fluxos com estado ou entradas multimodais.
- Ferramentas hospedadas pela OpenAI, como busca na web, busca em arquivos, interpretador de código, geração de imagens, uso de computador ou MCP remoto.
- Saídas Estruturadas sob os controles atuais de schema da OpenAI.
- IDs de modelos da OpenAI, configurações de projeto, níveis de serviço, configurações de armazenamento e relatórios de uso.
- Suporte direto do fornecedor para comportamento crítico no lançamento.
A rota direta do GPT pode ser o caminho mais limpo quando seu aplicativo já foi escrito em torno da superfície atual da API da OpenAI e você precisa de fidelidade no nível do recurso mais do que de abstração multi-fornecedor.
A desvantagem é a mesma da API direta do Claude: controle nativo do fornecedor vem com operações nativas do fornecedor. Você é responsável pela conta, chaves, cotas, logs, caminho de faturamento, verificações de status e lógica de fallback dessa rota.
Prefira um gateway quando a rota for um problema operacional
Use um gateway quando a equipe precisar de uma camada operacional única para vários modelos mais do que precisar de todos os recursos nativos do fornecedor em cada rota.
Em Roteamento de API Claude vs GPT: Quando Preferir Modelos Específicos do Fornecedor ou um Gateway, um gateway é útil quando:
- Os desenvolvedores precisam testar modelos Claude, GPT, Gemini, DeepSeek, Qwen, de imagem ou de vídeo sem abrir contas separadas em cada fornecedor para cada experimento.
- Clientes existentes compatíveis com a OpenAI devem manter uma base URL estável enquanto a escolha do modelo muda conforme a carga de trabalho.
- O departamento financeiro quer um único lugar para revisar o uso por solicitação e as evidências de faturamento.
- As equipes de plataforma precisam de propriedade compartilhada de chaves, revisão de cotas, verificações de rotas e planos de reversão.
- Os criadores de agentes precisam de uma forma consistente de testar chat, streaming, chamadas de ferramentas e logs de uso.
- O time de compras quer uma lista clara de modelos aprovados, unidades de precificação e responsáveis internos antes que uma nova rota entre em produção.
O posicionamento da Flatkey é construído em torno desse padrão: uma chave, um saldo, uma fatura, acesso oficial ao modelo, logs de uso e um roteador compatível com a OpenAI. A ressalva importante é simples: um gateway não deve ser tratado como paridade automática de recursos. Se uma carga de trabalho depender de um comportamento nativo do fornecedor, teste exatamente esse comportamento por meio do gateway antes de enviar tráfego de produção.
Para o padrão de migração mais amplo, combine este guia com a checklist da alternativa à API da OpenAI da Flatkey e com o fluxo de trabalho de API unificada de IA.
Uma matriz de decisão de roteamento da API Claude vs GPT
Use esta matriz durante a revisão de implementação.
| Área de decisão | API Claude direta | API GPT/OpenAI direta | Rota via gateway |
|---|---|---|---|
| Dependência de recurso nativo | Boa opção para a Messages API da Anthropic, uso de ferramentas do Claude, cache de prompts e Message Batches. | Boa opção para a Responses API da OpenAI, ferramentas hospedadas, Structured Outputs e controles de projeto da OpenAI. | Boa opção depois que o conjunto exato de recursos passar em um teste rápido de rota. |
| Migração de SDK | Melhor quando o app já usa padrões de SDK/requisição da Anthropic. | Melhor quando o app já usa padrões de SDK/requisição da OpenAI. | Melhor quando o app pode usar uma única base URL compatível com a OpenAI para todos os modelos suportados. |
| Avaliação de modelo | Boa para testes profundos específicos do Claude. | Boa para testes profundos específicos do GPT/OpenAI. | Boa para comparar modelos suportados sob um único wrapper de logs e faturamento. |
| Revisão de faturamento | Dados de faturamento e uso específicos do fornecedor. | Dados de faturamento e uso específicos do fornecedor. | Revisão compartilhada de uso e faturamento quando os logs do gateway expõem os campos necessários. |
| Fallback | Seu app é responsável pela lógica de retry e fallback. | Seu app é responsável pela lógica de retry e fallback. | O gateway pode simplificar a troca de rotas, mas seu app ainda precisa de validadores e condições de parada. |
| Verificações de status | Status da Anthropic mais os logs do app. | Status da OpenAI mais os logs do app. | Status do fornecedor, status do gateway e logs de rota no nível do app. |
| Revisão de conformidade | Os controles diretos do fornecedor são mais fáceis de mapear. | Os controles diretos do fornecedor são mais fáceis de mapear. | Útil para controles centralizados, mas os compradores ainda precisam de evidências do fornecedor e do gateway. |
A regra central: encaminhe recursos nativos de forma nativa; encaminhe a complexidade operacional por meio de um gateway.
Combine a rota com a carga de trabalho
Não escolha uma resposta global para cada solicitação. Comece pela carga de trabalho.
| Carga de trabalho | Rota que costuma se encaixar primeiro | Por quê |
|---|---|---|
| Agente nativo do fornecedor usando o comportamento de ferramentas da Anthropic | API Claude direta | O contrato da ferramenta e os blocos de resposta podem ser o requisito do produto. |
| Fluxo de trabalho OpenAI Responses com ferramentas hospedadas | API GPT/OpenAI direta | O fluxo de trabalho depende de ferramentas nativas da OpenAI, estado e comportamento de esquema. |
| Chat padrão ou sumarização em vários modelos | Rota via gateway | O formato da solicitação geralmente é mais fácil de comparar por trás de uma camada de rota única. |
| Avaliação offline ou backfill | Rota via gateway ou API em lote do fornecedor | A melhor resposta depende do suporte a lote, do custo do output aceito e da tolerância a atraso. |
| Uso sensível a finanças em várias equipes | Rota via gateway | Uma visão única de uso e um caminho único de fatura podem importar mais do que consoles nativos do fornecedor. |
| Carga de trabalho regulada ou revisada pelo fornecedor | Fornecedor direto ou híbrido | Evidência direta pode ser exigida até que os controles do gateway sejam aprovados. |
Para um pensamento adjacente de comparação de modelos, veja o artigo da Flatkey sobre roteamento de API Gemini vs Claude e o guia de catálogo de modelos de IA.
Checklist de pré-lançamento antes de mover o tráfego
Antes de बदलiar a produção Claude vs GPT API Routing: When to Prefer Provider-Specific Models or a Gateway, salve evidências para cada rota candidata.
- ID do modelo e alias: Capture o ID exato do modelo, o fornecedor, a família do endpoint e a data verificada.
- Formato do endpoint: Confirme se a rota usa Anthropic Messages, OpenAI Chat Completions, OpenAI Responses ou outra família de API.
- Adequação de recursos: Teste ferramentas, saída estruturada, streaming, visão, arquivos, cache de prompt, ferramentas hospedadas, MCP ou batch somente se a carga de trabalho precisar deles.
- Leitura de uso: Confirme onde aparecem tokens de entrada, tokens de saída, tokens em cache, contagens de solicitações, unidades de mídia, latência, erros e custos.
- Unidade de preço: Verifique se a rota cobra por token, solicitação, imagem, segundo, unidade de lote, leitura/gravação de cache ou outra unidade.
- Status e integridade: Salve evidências de status do fornecedor e de integridade da rota do gateway no momento do lançamento.
- Comportamento de falha: Registre o comportamento de
401,403, modelo não encontrado,429, timeout, falha de chamada de ferramenta, falha de esquema e interrupção de streaming. - Regra de fallback: Defina quando tentar novamente, alternar modelos, enfileirar, degradar a saída ou parar.
- Responsável: Atribua um responsável por chaves, cotas, revisão de orçamento e mudanças de rota.
- Rollback: Mantenha um caminho testado de volta para a rota anterior até que a nova rota tenha evidências em produção.
Esta checklist importa porque o roteamento de API Claude vs GPT normalmente falha de formas comuns: um alias de modelo desatualizado, uma incompatibilidade de base URL, um parser esperando o formato de evento errado ou uma revisão financeira sem evidências no nível da requisição.
Uma scorecard de roteamento que você pode copiar
Use esta scorecard após o smoke test de preflight. Dê uma nota de 1 a 5 para cada rota para a mesma carga de trabalho.
| Critério | Peso | Claude direto | GPT/OpenAI direto | Gateway | Notas |
|---|---|---|---|---|---|
| Adequação a recursos nativos | 20% | A rota suporta exatamente o comportamento de API necessário? | |||
| Taxa de saída aceita | 20% | A saída passa no validador da carga de trabalho? | |||
| Custo por saída aceita | 15% | Inclua retries, fallback, cache, ferramentas e saídas rejeitadas. | |||
| Latência e taxa de timeout | 15% | Meça p50, p90, p99 e o comportamento do primeiro token no streaming. | |||
| Observabilidade | 15% | Engenharia e finanças conseguem inspecionar a mesma evidência da requisição? | |||
| Fallback e rollback | 10% | O sistema consegue se recuperar sem perda oculta de qualidade? | |||
| Governança | 5% | As chaves, responsáveis, orçamentos e modelos aprovados estão claros? |
O vencedor é a rota que passa na carga de trabalho, não o fornecedor com o lançamento de modelo mais barulhento.
route_review:
  workload: support_summary
  candidates:
    - direct_claude
    - direct_openai
    - flatkey_gateway
  required_features:
    - streaming
    - json_schema_output
    - usage_readback
  launch_rule:
    minimum_score: 4
    accepted_output_rate: ">= target set by owner"
    rollback_path_required: true
Se você estiver medindo a rota após o lançamento, use a estrutura de métricas de API de roteamento de IA da Flatkey como o próximo passo.
Como a Flatkey muda o fluxo de trabalho
A Flatkey não elimina a necessidade de escolher o modelo certo. Ela muda onde fica o peso de acesso, uso e cobrança.
Com a Flatkey, uma equipe pode testar uma rota compatível com OpenAI assim:
curl https://router.flatkey.ai/v1/chat/completions \
  -H "Authorization: Bearer $FLATKEY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "your-verified-model-id",
    "messages": [
      { "role": "user", "content": "Run a smoke test for this route." }
    ]
  }'
Esse caminho é útil quando a aplicação já fala um formato de chat completions compatível com OpenAI e a equipe quer um único lugar para avaliar os modelos suportados. Também é útil quando as equipes de finanças e plataforma precisam de visibilidade compartilhada de custos antes que experimentos se tornem padrões de produção.
Antes do lançamento, ainda verifique o modelo no catálogo atual da Flatkey, na página de preços e no painel de uso. Confira a família do endpoint, disponibilidade, unidade de precificação, logs de solicitações, proprietário da cota e comportamento de fallback. Faça o mesmo para qualquer rota direta Claude ou rota direta GPT que você mantenha fora do gateway.
Padrão de migração segura
Uma migração limpa de roteamento de API Claude vs GPT é feita em etapas.
- Estabeleça a linha de base da rota atual: Salve prompts, IDs de modelo, saídas esperadas, uso de tokens, latência, taxa de erro e suposições atuais de custo.
- Execute testes nativos do fornecedor: Teste o comportamento direto do Claude e do GPT direto para os recursos que sua carga de trabalho realmente usa.
- Execute testes do gateway: Envie os mesmos casos representativos pela rota da Flatkey e compare a estrutura da saída, erros, latência e logs de uso.
- Migre primeiro o tráfego de baixo risco: Comece com ferramentas internas, jobs de avaliação ou uma pequena porcentagem do tráfego não crítico.
- Monitore evidências da rota: Compare a taxa de saídas aceitas, contagem de solicitações, uso de tokens, custo,
429s, timeouts e erros de modelo não encontrado. - Documente as condições de parada: Defina o sinal exato que envia o tráfego de volta para a rota anterior.
- Promova apenas após a confirmação: Não considere a migração concluída até que uso, faturamento e evidências da rota estejam visíveis para as equipes que os administram.
Isso mantém a decisão de modelo e a decisão de rota separadas. Um modelo pode ser forte enquanto a rota não está pronta. Um gateway pode ser operacionalmente útil enquanto um recurso nativo ainda merece um caminho direto do provedor.
Erros comuns
| Erro | Por que prejudica | Melhor decisão de rota |
|---|---|---|
| Tratar compatibilidade com OpenAI como paridade universal de recursos | Texto de chat pode funcionar enquanto ferramentas, streaming, saída estruturada ou entradas multimodais diferem. | Faça um smoke test do conjunto exato de recursos antes do lançamento. |
| Copiar IDs de modelo de conteúdo antigo | IDs de modelo, aliases e disponibilidade podem mudar conforme o fornecedor e o gateway. | Copie os IDs da documentação atual do fornecedor, do console ou do catálogo da Flatkey. |
| Comparar apenas a qualidade da resposta | Faturamento, logs, propriedade da chave, cota, fallback e tratamento de status se tornam custos de produção. | Compare as operações da rota juntamente com a qualidade da saída. |
| Mover todo o tráfego de uma vez | Um problema de parser, alias de modelo ou cota pode se tornar uma interrupção total. | Faça canary da rota e mantenha o rollback pronto. |
| Permitir que cada equipe escolha sua própria conta de provedor | As equipes de finanças e plataforma perdem visibilidade. | Use um gateway compartilhado ou um fluxo de aprovação para rotas de produção. |
Verificações de origem para manter abertas
Use a documentação ao vivo ao finalizar uma rota:
- Modelos da OpenAI, ferramentas e documentação de Structured Outputs.
- Preços da API da OpenAI para as unidades de preço e linhas de modelo atuais.
- Modelos Claude, uso de ferramentas, cache de prompts e documentação de Message Batches.
- Quickstart da Flatkey, visão geral da API REST e guia do SDK da OpenAI.
- Catálogo de modelos, página de preços e página de status atuais da Flatkey.
Não codifique em políticas de produção preços voláteis de modelos de uma postagem de blog. Salve a linha atual da origem do provedor ou gateway no momento em que você aprovar a rota.
Recomendação final
Para Roteamento de API Claude vs GPT: Quando Preferir Modelos Específicos do Fornecedor ou um Gateway, comece pela carga de trabalho e pelas suas dependências de API.
- Se a carga de trabalho depender do comportamento nativo da Anthropic, use o Claude diretamente até que um gateway comprove o mesmo comportamento.
- Se a carga de trabalho depender das Responses nativas da OpenAI, de ferramentas hospedadas ou do comportamento de Structured Outputs, use a OpenAI diretamente até que um gateway comprove o mesmo comportamento.
- Se a carga de trabalho for chat padrão, avaliação, automação interna ou exploração de múltiplos modelos, use um gateway quando uma única chave, uma única URL base, logs de uso, revisão de faturamento e política de fallback importarem mais do que a especificidade do provedor nativo.
A Flatkey vale a pena ser avaliada quando a dor da equipe não é "Qual modelo existe?" mas sim "Como operamos com segurança muitos modelos sem multiplicar contas, chaves, faturas e verificações de rota?"
Comece com o catálogo de modelos, a página de preços e os logs de uso. Execute a checklist de pré-voo. Promova a rota somente quando a saída passar no validador da sua carga de trabalho e a evidência de uso estiver visível para as pessoas responsáveis por engenharia, plataforma e finanças.
Perguntas frequentes
O roteamento de API Claude vs GPT é apenas sobre qualidade do modelo?
Não. A qualidade do modelo importa, mas o roteamento de API Claude vs GPT também inclui formato do endpoint, comportamento de ferramentas, saída estruturada, streaming, unidades de preço, páginas de status, cotas, logs e rollback.
Quando devo evitar um gateway?
Evite rotear uma carga de trabalho por meio de um gateway até ter verificado cada recurso específico do provedor do qual ela depende. As APIs diretas do provedor são mais seguras para os primeiros lançamentos que dependem de comportamento nativo ainda não testado através do gateway.
Posso manter tanto rotas diretas do provedor quanto a Flatkey?
Sim. Muitas equipes devem fazer isso. Mantenha rotas diretas da Claude ou do GPT direto para cargas de trabalho específicas de recursos e use a Flatkey para acesso a múltiplos modelos, avaliação, visibilidade de cobrança e controle operacional, quando a rota testada suportar a carga de trabalho.
Qual é o primeiro teste para uma rota da Flatkey?
Comece com um pequeno teste rápido de chat completion e, em seguida, verifique o ID do modelo, a família do endpoint, o log de uso, a unidade de preço, o tratamento de erros e a reversão. Não mova o tráfego de produção até que as equipes responsáveis pela plataforma e pelas finanças possam ler a mesma evidência.
Quais links da Flatkey devem apoiar essa decisão?
Use o catálogo de modelos, a página de preços, o guia da API unificada de IA, o guia de alternativa à API da OpenAI e o artigo métricas de API de roteamento de IA quando você montar a revisão da rota.


