
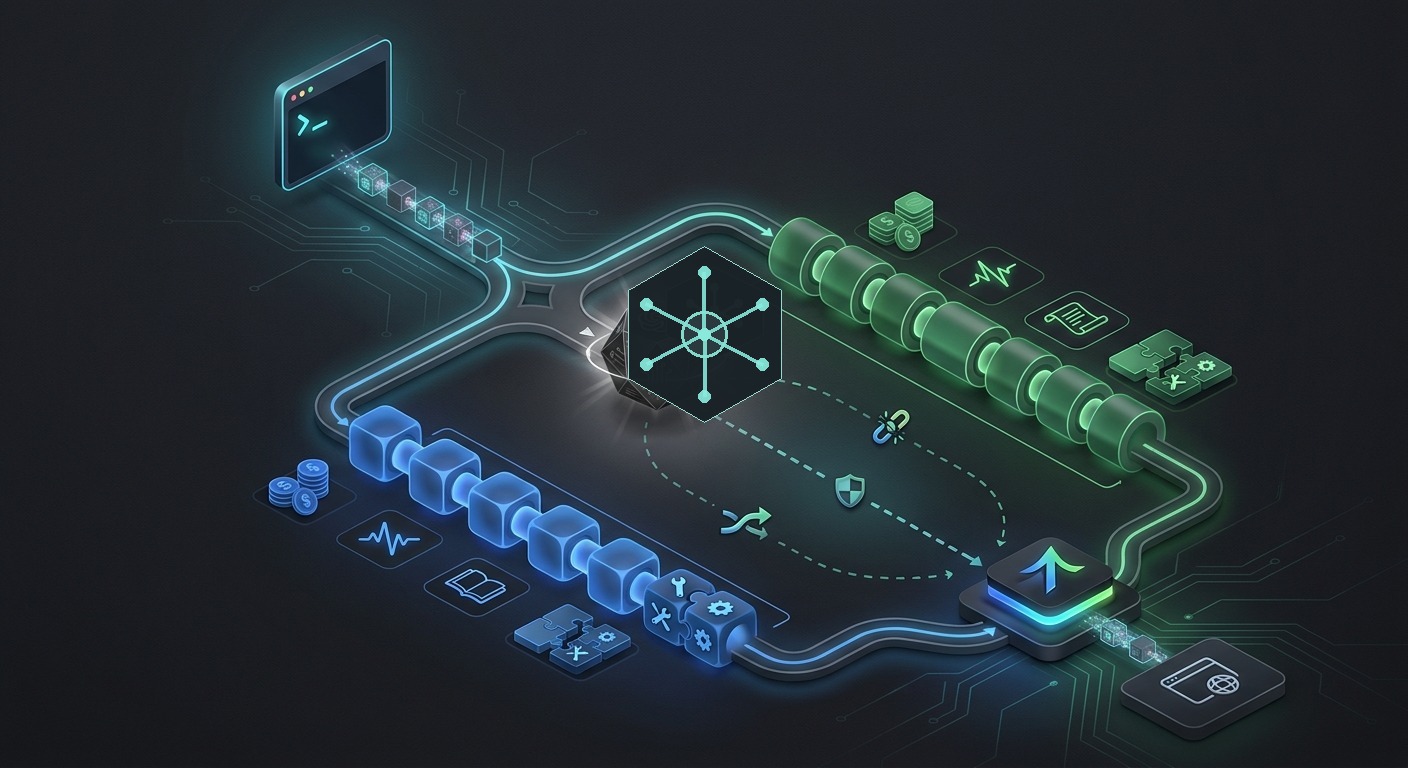
Claude vs GPT API Routing: Cuándo Preferir Modelos Específicos del Proveedor o un Gateway no es solo una cuestión de calidad del modelo. Es una cuestión de enrutamiento en producción: qué solicitudes deben permanecer en una API nativa del proveedor, cuáles pueden ejecutarse a través de una ruta compatible con OpenAI y cuáles deben situarse detrás de un gateway para que la elección del modelo, la facturación, los registros y el fallback no se extiendan por cada servicio.
Usa APIs directas del proveedor cuando la carga de trabajo dependa del comportamiento nativo de Anthropic u OpenAI. Usa un gateway cuando el problema más grande sea la dispersión operativa: demasiadas claves, facturas, IDs de modelos, comprobaciones de estado, reglas de reintento e informes de uso entre equipos.
Flatkey encaja en el patrón de gateway. Su documentación describe una base URL REST compatible con OpenAI en https://router.flatkey.ai/v1, una sola API key, un catálogo de modelos y registros de uso para revisar las llamadas a modelos. Eso lo hace útil cuando Claude, GPT, Gemini, DeepSeek, Qwen, modelos de imagen, modelos de vídeo y herramientas de agentes forman parte de la misma superficie operativa.
La respuesta segura suele ser híbrida. Enruta las funciones nativas de forma nativa hasta que el gateway demuestre compatibilidad. Enruta el chat estándar, la evaluación, las automatizaciones internas y los experimentos multmodelo a través de un gateway cuando el acceso compartido y la observabilidad importen más que el control específico del proveedor.
Respuesta rápida: ¿Claude directo, GPT directo o gateway?
| Opción de enrutamiento | Prefiérela cuando | Verifica antes del lanzamiento |
|---|---|---|
| API de Claude directa | El producto depende del comportamiento de la Messages API de Anthropic, de los IDs de modelo de Claude, del uso de herramientas de Claude, del prompt caching, de Message Batches o de los controles de cuenta de Anthropic. | ID de modelo actual, forma de la solicitud, eventos de streaming, flujo de uso de herramientas, comportamiento de caché, ajuste para lotes, límites de tasa, configuración de datos, página de estado y unidades de facturación. |
| API de GPT/OpenAI directa | El producto depende del comportamiento de la Responses API de OpenAI, de herramientas alojadas, de Structured Outputs, de compatibilidad con Chat Completions, de niveles de servicio o de controles de proyecto de OpenAI. | ID de modelo actual, estructura de Responses frente a Chat Completions, llamadas a herramientas, manejo de esquemas, consumidor de eventos de streaming, configuración de almacenamiento, límites de tasa, página de estado e informes de uso. |
| Ruta de gateway | El producto necesita acceso multproveedor, una base URL, una vista única de uso, evaluación de modelos más sencilla, política de fallback y revisión de facturación entre equipos. | Familia de endpoints admitida, disponibilidad de modelos, paridad de funciones, comportamiento de fallback, campos del registro de uso, unidad de precio, propiedad de cuota y ruta de reversión. |
Esa es la decisión práctica detrás de Claude vs GPT API Routing: Cuándo Preferir Modelos Específicos del Proveedor o un Gateway. No preguntes qué proveedor es mejor en abstracto. Pregunta qué ruta le da a una carga de trabajo específica el soporte de funciones, la observabilidad, el control de costes y la vía de recuperación adecuados.
Por qué el enrutamiento de API de Claude vs GPT se complica
Un prototipo suele preguntar: "¿Qué modelo dio la mejor respuesta?" Un sistema de producción plantea preguntas más difíciles:
- ¿Este flujo de trabajo necesita una forma de API nativa del proveedor?
- ¿La ruta preservará la llamada a herramientas, la salida estructurada, el streaming, el comportamiento de caché y los motivos de parada?
- ¿Quién es propietario de la clave de API, la cuota, la cuenta del proveedor y la factura?
- ¿Puede finanzas vincular un pico de uso a un modelo, equipo, entorno o cliente?
- ¿Qué sucede cuando cambia un alias de modelo, se endurece un límite de tasa del proveedor o una ruta empieza a devolver
429? - ¿Puede el equipo revertir sin editar cada servicio?
Las rutas de Claude y GPT pueden ser buenas opciones, pero la ruta en sí se convierte en parte del producto. Un modelo sólido detrás de una ruta no observable aún puede crear riesgo operativo.
Prefiera la API directa de Claude cuando el requisito sea el comportamiento nativo de Claude
Elija el acceso directo a la API de Claude cuando su carga de trabajo esté construida intencionalmente alrededor del comportamiento nativo de Anthropic.
Puede ser la elección correcta cuando necesite:
- La semántica de solicitud y respuesta de la API de Mensajes de Anthropic como fuente de verdad.
- Los IDs y alias de los modelos de Claude exactamente como Anthropic los documenta.
- El comportamiento de uso de herramientas de Claude, incluido el manejo de
tool_useytool_result. - El comportamiento de caché de prompts para contexto repetido.
- Message Batches para cargas de trabajo offline que no necesitan respuestas inmediatas.
- Límites de tasa, informes de uso, controles de datos y soporte de cuenta específicos de Anthropic.
La ruta directa también es más sencilla durante la revisión de incidentes cuando necesita detalles de solicitudes nativos de Anthropic, rutas de soporte, evidencia de facturación o configuraciones de la cuenta.
La contrapartida es el alcance. Si el mismo producto también usa GPT, Gemini, inferencia de código abierto, generación de imágenes, generación de video y herramientas de agentes, cada ruta directa del proveedor añade otra clave, consola, factura, página de estado, política de límites y exportación de uso.
Prefiera la API directa de GPT/OpenAI cuando las funciones nativas de OpenAI definan el flujo de trabajo
Elija el acceso directo a la API de OpenAI cuando la carga de trabajo dependa del comportamiento nativo de la API de OpenAI.
Puede ser la elección correcta cuando necesite:
- La API Responses de OpenAI para razonamiento, herramientas, flujos con estado o entradas multimodales.
- Herramientas alojadas por OpenAI como búsqueda web, búsqueda de archivos, intérprete de código, generación de imágenes, uso de computadora o MCP remoto.
- Salidas estructuradas bajo los controles de esquema actuales de OpenAI.
- IDs de modelo de OpenAI, configuraciones de proyecto, niveles de servicio, configuraciones de almacenamiento e informes de uso.
- Soporte directo del proveedor para comportamiento crítico para el lanzamiento.
La ruta directa de GPT puede ser el camino más limpio cuando su aplicación ya está escrita alrededor de la superficie de API actual de OpenAI y necesita fidelidad a nivel de función más que abstracción multi-proveedor.
La contrapartida es la misma que con Claude directo: el control nativo del proveedor viene con operaciones nativas del proveedor. Usted es responsable de la cuenta, las claves, las cuotas, los registros, la ruta de facturación, las comprobaciones de estado y la lógica de fallback para esa ruta.
Prefiera un gateway cuando la ruta sea un problema de operaciones
Use un gateway cuando el equipo necesite una capa operativa única para muchos modelos más de lo que necesita cada función nativa del proveedor en cada ruta.
En Claude vs GPT API Routing: Cuándo Preferir Modelos Específicos del Proveedor o un Gateway, un gateway es útil cuando:
- Los desarrolladores necesitan probar modelos de Claude, GPT, Gemini, DeepSeek, Qwen, imagen o video sin abrir cuentas separadas de cada proveedor para cada experimento.
- Los clientes existentes compatibles con OpenAI deben mantener una base URL estable mientras la elección del modelo cambia según la carga de trabajo.
- Finanzas quiere un solo lugar para revisar el uso a nivel de solicitud y la evidencia de facturación.
- Los equipos de plataforma necesitan propiedad compartida de claves, revisión de cuotas, comprobaciones de rutas y planes de reversión.
- Los creadores de agentes necesitan una forma coherente de probar chat, streaming, llamadas a herramientas y registros de uso.
- Compras quiere una lista clara de modelos aprobados, unidades de precios y responsables internos antes de que una nueva ruta entre en producción.
El posicionamiento de Flatkey se construye alrededor de ese patrón: una clave, un saldo, una factura, acceso oficial a modelos, registros de uso y un router compatible con OpenAI. La advertencia importante es simple: un gateway no debe tratarse como paridad automática de funcionalidades. Si una carga de trabajo depende de un comportamiento nativo del proveedor, prueba ese comportamiento exacto a través del gateway antes de enviar tráfico de producción.
Para el patrón de migración más amplio, combina esta guía con la lista de comprobación de alternativa a la API de OpenAI de Flatkey y el flujo de trabajo de API unificada de IA.
Una matriz de decisión de routing de API Claude vs GPT
Usa esta matriz durante la revisión de implementación.
| Área de decisión | API de Claude directa | API de GPT/OpenAI directa | Ruta de gateway |
|---|---|---|---|
| Dependencia de funciones nativas | Encaja bien con Anthropic Messages API, uso de herramientas de Claude, prompt caching y Message Batches. | Encaja bien con OpenAI Responses API, herramientas alojadas, Structured Outputs y controles de proyecto de OpenAI. | Encaja bien después de que el conjunto exacto de funciones pase una prueba rápida de ruta. |
| Migración de SDK | Mejor cuando la aplicación ya usa patrones de SDK/solicitud de Anthropic. | Mejor cuando la aplicación ya usa patrones de SDK/solicitud de OpenAI. | Mejor cuando la aplicación puede usar una sola base URL compatible con OpenAI en todos los modelos admitidos. |
| Evaluación de modelos | Bueno para pruebas profundas específicas de Claude. | Bueno para pruebas profundas específicas de GPT/OpenAI. | Bueno para comparar modelos admitidos bajo un solo envoltorio de registro y facturación. |
| Revisión de facturación | Datos de facturación y uso específicos del proveedor. | Datos de facturación y uso específicos del proveedor. | Revisión compartida de uso y facturación cuando los registros del gateway exponen los campos necesarios. |
| Fallback | Tu aplicación se encarga de la lógica de reintento y fallback. | Tu aplicación se encarga de la lógica de reintento y fallback. | El gateway puede simplificar el cambio de ruta, pero tu aplicación sigue necesitando validadores y condiciones de parada. |
| Comprobaciones de estado | Estado de Anthropic más registros de la aplicación. | Estado de OpenAI más registros de la aplicación. | Estado del proveedor, estado del gateway y registros de ruta a nivel de aplicación. |
| Revisión de cumplimiento | Los controles directos del proveedor son más fáciles de mapear. | Los controles directos del proveedor son más fáciles de mapear. | Útil para controles centralizados, pero los compradores aún necesitan evidencia del proveedor y del gateway. |
La regla principal: enruta las funciones nativas de forma nativa; enruta la complejidad operativa a través de un gateway.
Ajusta la ruta a la carga de trabajo
No elijas una única respuesta global para cada solicitud. Empieza por la carga de trabajo.
| Carga de trabajo | Ruta que a menudo encaja primero | Por qué |
|---|---|---|
| Agente nativo del proveedor usando el comportamiento de herramientas de Anthropic | API de Claude directa | El contrato de herramientas y los bloques de respuesta pueden ser el requisito del producto. |
| Flujo de trabajo de OpenAI Responses con herramientas alojadas | API de GPT/OpenAI directa | El flujo de trabajo depende de herramientas, estado y comportamiento de esquema nativos de OpenAI. |
| Chat estándar o resumen a través de varios modelos | Ruta de gateway | La forma de la solicitud suele ser más fácil de comparar detrás de una sola capa de ruta. |
| Evaluación sin conexión o backfill | Ruta de gateway o API batch del proveedor | La mejor respuesta depende del soporte batch, del coste de salida aceptado y de la tolerancia al retraso. |
| Uso multi-equipo sensible a finanzas | Ruta de gateway | Una sola vista de uso y un único flujo de facturación pueden importar más que las consolas nativas del proveedor. |
| Carga de trabajo regulada o revisada por el proveedor | Proveedor directo o híbrido | Puede requerirse evidencia directa hasta que se aprueben los controles del gateway. |
Para un pensamiento adyacente de comparación de modelos, consulta el artículo de Flatkey Gemini vs Claude API routing y la guía del catálogo de modelos de IA.
Lista de verificación previa antes de mover tráfico
Antes de cambiar la producción de Claude vs GPT API Routing: When to Prefer Provider-Specific Models or a Gateway, guarda evidencia de cada ruta candidata.
- ID de modelo y alias: Registra el ID exacto del modelo, el proveedor, la familia de endpoint y la fecha de verificación.
- Forma del endpoint: Confirma si la ruta usa Anthropic Messages, OpenAI Chat Completions, OpenAI Responses u otra familia de API.
- Ajuste de funciones: Prueba herramientas, salida estructurada, streaming, visión, archivos, caché de prompts, herramientas alojadas, MCP o batch solo si la carga de trabajo los necesita.
- Lectura de uso: Confirma dónde aparecen los tokens de entrada, tokens de salida, tokens en caché, recuentos de solicitudes, unidades de medios, latencia, errores y costes.
- Unidad de precio: Comprueba si la ruta factura por token, solicitud, imagen, segundo, unidad batch, lectura/escritura de caché u otra unidad.
- Estado y salud: Guarda evidencia del estado del proveedor y de la salud de la ruta del gateway en el momento del lanzamiento.
- Comportamiento ante fallos: Registra el comportamiento de
401,403, modelo no encontrado,429, timeout, fallo de llamada a herramienta, fallo de esquema e interrupción de streaming. - Regla de fallback: Define cuándo reintentar, cambiar de modelo, poner en cola, degradar la salida o detenerse.
- Responsable: Asigna un responsable para claves, cuotas, revisión de presupuesto y cambios de ruta.
- Rollback: Mantén una ruta probada para volver a la ruta anterior hasta que la nueva ruta tenga evidencia de producción.
Esta lista de verificación importa porque el enrutamiento de API de Claude frente a GPT suele fallar de formas ordinarias: un alias de modelo desactualizado, una discrepancia en la URL base, un analizador que espera la forma de evento incorrecta o una revisión financiera sin evidencia a nivel de solicitud.
Una tabla de puntuación de rutas que puedes copiar
Usa esta tabla de puntuación después de la prueba de humo de preflight. Puntúa cada ruta del 1 al 5 para la misma carga de trabajo.
| Criterio | Peso | Claude directo | GPT/OpenAI directo | Gateway | Notas |
|---|---|---|---|---|---|
| Ajuste a la funcionalidad nativa | 20% | ¿La ruta admite exactamente el comportamiento de API requerido? | |||
| Tasa de salida aceptada | 20% | ¿La salida pasa el validador de la carga de trabajo? | |||
| Coste por salida aceptada | 15% | Incluye reintentos, fallback, caché, herramientas y salidas rechazadas. | |||
| Latencia y tasa de timeout | 15% | Mide p50, p90, p99 y el comportamiento del primer token en streaming. | |||
| Observabilidad | 15% | ¿Pueden ingeniería y finanzas inspeccionar la misma evidencia de la solicitud? | |||
| Fallback y rollback | 10% | ¿Puede el sistema recuperarse sin una pérdida de calidad oculta? | |||
| Gobernanza | 5% | ¿Están claros las claves, los responsables, los presupuestos y los modelos aprobados? |
La ganadora es la ruta que aprueba la carga de trabajo, no el proveedor con el lanzamiento de modelo más ruidoso.
route_review:
  workload: support_summary
  candidates:
    - direct_claude
    - direct_openai
    - flatkey_gateway
  required_features:
    - streaming
    - json_schema_output
    - usage_readback
  launch_rule:
    minimum_score: 4
    accepted_output_rate: ">= target set by owner"
    rollback_path_required: true
Si estás midiendo la ruta después del lanzamiento, usa el marco de métricas de API de enrutamiento de IA de Flatkey como siguiente paso.
Cómo Flatkey cambia el flujo de trabajo
Flatkey no elimina la necesidad de elegir el modelo correcto. Cambia dónde recaen la carga de acceso, uso y facturación.
Con Flatkey, un equipo puede probar una ruta compatible con OpenAI así:
curl https://router.flatkey.ai/v1/chat/completions \
  -H "Authorization: Bearer $FLATKEY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "your-verified-model-id",
    "messages": [
      { "role": "user", "content": "Run a smoke test for this route." }
    ]
  }'
Ese camino es útil cuando la aplicación ya habla una forma de chat-completion compatible con OpenAI y el equipo quiere un solo lugar para evaluar los modelos compatibles. También es útil cuando los equipos de finanzas y de plataforma necesitan una visibilidad compartida de los costes antes de que los experimentos se conviertan en valores predeterminados de producción.
Antes del lanzamiento, verifica igualmente el modelo en el catálogo actual de Flatkey, la página de precios y el panel de uso. Comprueba la familia de endpoint, la disponibilidad, la unidad de precios, los registros de solicitudes, el propietario de la cuota y el comportamiento de fallback. Haz lo mismo con cualquier ruta directa de Claude o ruta directa de GPT que mantengas fuera del gateway.
Patrón de migración segura
Una migración limpia de enrutamiento de API de Claude vs GPT se realiza por etapas.
- Establece la línea base de la ruta actual: Guarda prompts, IDs de modelo, resultados esperados, uso de tokens, latencia, tasa de error y supuestos de coste actuales.
- Ejecuta pruebas nativas del proveedor: Prueba el comportamiento directo de Claude y de GPT para las funciones que realmente usa tu carga de trabajo.
- Ejecuta pruebas del gateway: Envía los mismos casos representativos a través de la ruta de Flatkey y compara la forma de la salida, los errores, la latencia y los registros de uso.
- Mueve primero el tráfico de bajo riesgo: Empieza con herramientas internas, trabajos de evaluación o un pequeño porcentaje de tráfico no crítico.
- Vigila la evidencia de la ruta: Compara la tasa de salida aceptada, el recuento de solicitudes, el uso de tokens, el coste, los
429, los timeouts y los errores de modelo no encontrado. - Documenta las condiciones de parada: Define la señal exacta que devuelve el tráfico a la ruta anterior.
- Promociona solo después de la confirmación: No des por completada la migración hasta que el uso, la facturación y la evidencia de la ruta sean visibles para los equipos que los administran.
Esto mantiene separadas la decisión del modelo y la decisión de la ruta. Un modelo puede ser sólido aunque la ruta no esté lista. Un gateway puede ser operativamente útil aunque una función nativa siga mereciendo una ruta directa del proveedor.
Errores comunes
| Error | Por qué perjudica | Mejor decisión de ruta |
|---|---|---|
| Tratar OpenAI-compatible como paridad universal de funciones | El texto de chat puede funcionar mientras que las herramientas, el streaming, la salida estructurada o las entradas multimodales difieren. | Haz una prueba rápida del conjunto exacto de funciones antes del lanzamiento. |
| Copiar IDs de modelo de contenido antiguo | Los IDs de modelo, alias y disponibilidad pueden cambiar según el proveedor y el gateway. | Copia los IDs de la documentación actual del proveedor, la consola o el catálogo de Flatkey. |
| Comparar solo la calidad de la respuesta | La facturación, los registros, la propiedad de claves, la cuota, el fallback y el manejo del estado se convierten en costes de producción. | Compara las operaciones de la ruta junto con la calidad de la salida. |
| Mover todo el tráfico a la vez | Un problema de parser, alias de modelo o cuota puede convertirse en una interrupción total. | Haz canary de la ruta y mantén listo el rollback. |
| Permitir que cada equipo elija su propia cuenta de proveedor | Los equipos de finanzas y plataforma pierden visibilidad. | Usa un gateway compartido o un flujo de aprobación para las rutas de producción. |
Comprobaciones de origen que mantener abiertas
Usa documentación en vivo al finalizar una ruta:
- Modelos de OpenAI, herramientas y Structured Outputs.
- Precios de la API de OpenAI para las unidades de precio y las filas de modelos actuales.
- Modelos de Claude, uso de herramientas, caché de prompts y documentación de Message Batches.
- Inicio rápido de Flatkey, resumen de la API REST y guía del SDK de OpenAI.
- catálogo de modelos actual de Flatkey, página de precios y página de estado.
No codifiques en la política de producción precios de modelos volátiles de una entrada de blog. Guarda la fila actual de origen, ya sea del proveedor o del gateway, en el momento en que apruebes la ruta.
Recomendación final
Para Claude vs GPT API Routing: When to Prefer Provider-Specific Models or a Gateway, empieza por la carga de trabajo y sus dependencias de API.
- Si la carga de trabajo depende del comportamiento nativo de Anthropic, usa Claude directamente hasta que un gateway demuestre el mismo comportamiento.
- Si la carga de trabajo depende de Responses nativo de OpenAI, herramientas alojadas o del comportamiento de Structured Outputs, usa OpenAI directamente hasta que un gateway demuestre el mismo comportamiento.
- Si la carga de trabajo es chat estándar, evaluación, automatización interna o exploración multimodelo, usa un gateway cuando una sola clave, una URL base, los registros de uso, la revisión de facturación y la política de fallback importen más que la especificidad nativa del proveedor.
Vale la pena evaluar Flatkey cuando el problema del equipo no es "¿Qué modelo existe?" sino "¿Cómo operamos de forma segura muchos modelos sin multiplicar cuentas, claves, facturas y comprobaciones de rutas?"
Empieza con el catálogo de modelos, la página de precios y los registros de uso. Ejecuta la lista de verificación previa. Promueve la ruta solo cuando la salida pase tu validador de carga de trabajo y la evidencia de uso sea visible para las personas responsables de ingeniería, plataforma y finanzas.
Preguntas frecuentes
¿Claude vs GPT API Routing trata solo de la calidad del modelo?
No. La calidad del modelo importa, pero Claude vs GPT API Routing también incluye la forma del endpoint, el comportamiento de las herramientas, la salida estructurada, el streaming, las unidades de precio, las páginas de estado, las cuotas, los registros y la reversión.
¿Cuándo debería evitar un gateway?
Evita enrutar una carga de trabajo a través de un gateway hasta que hayas verificado cada función específica del proveedor de la que depende. Las APIs directas del proveedor son más seguras para los primeros lanzamientos que dependen de un comportamiento nativo que aún no se ha probado a través del gateway.
¿Puedo mantener tanto las rutas directas del proveedor como Flatkey?
Sí. Muchos equipos deberían hacerlo. Mantengan rutas directas de Claude o GPT directas para cargas de trabajo específicas de una función, y usen Flatkey para acceso multimodelo, evaluación, visibilidad de facturación y control operativo donde la ruta probada admita la carga de trabajo.
¿Cuál es la primera prueba para una ruta de Flatkey?
Comience con una pequeña prueba de humo de chat-completion, luego verifique el ID del modelo, la familia de endpoints, el registro de uso, la unidad de precio, el manejo de errores y el rollback. No mueva tráfico de producción hasta que los equipos responsables de plataforma y finanzas puedan leer la misma evidencia.
¿Qué enlaces de Flatkey deberían respaldar esta decisión?
Use el catálogo de modelos, la página de precios, la guía de API unificada de IA, la guía de alternativa a la API de OpenAI y el artículo de métricas de API de enrutamiento de IA cuando construya la revisión de la ruta.


