Prix de DeepSeek V4 Flash (octobre 2026) : heures pleines, heures creuses et accès gratuit
Au 25 octobre 2026, le modèle Flash de DeepSeek coûte 0,30 $ par million de tokens d'entrée et 1,20 $ par million de tokens de sortie en heures pleines, et exactement moitié moins en heures creuses (0,15 $ en entrée, 0,60 $ en sortie), avec une entrée en cache à partir de 0,003 $ par million de tokens. Le nom de modèle à appeler est désormais deepseek-flash, servi par DeepSeek-V4.1-Flash-1017. L'ancien nom deepseek-v4-flash fonctionne toujours, mais DeepSeek a retiré ce modèle et redirige ces requêtes vers V4.1 Flash au même prix Flash.
Il n'existe pas de niveau API gratuit permanent. L'application de chat DeepSeek est gratuite, et l'usage de l'API est débité du solde de votre compte, en commençant par tout solde offert (promotionnel). Ce guide couvre le tableau de prix complet, le calendrier des heures pleines, le coût d'une charge de travail réelle, la comparaison entre Flash et V4 Pro, et les options honnêtes pour l'essayer gratuitement ou presque. Tous les chiffres proviennent de la page de tarification officielle de DeepSeek, consultée le 25 octobre 2026.
Tableau des prix de DeepSeek V4 Flash
Prix en USD par million de tokens sur l'API officielle de DeepSeek.
DeepSeek Flash (deepseek-flash) |
DeepSeek V4 Pro (deepseek-v4-pro) |
|
|---|---|---|
| Version du modèle | DeepSeek-V4.1-Flash-1017 | DeepSeek-V4-Pro-0813 |
| Entrée, cache hit (creuses / pleines) | 0,003 $ / 0,006 $ | 0,022 $ / 0,044 $ |
| Entrée, cache miss (creuses / pleines) | 0,15 $ / 0,30 $ | 0,66 $ / 1,32 $ |
| Sortie (creuses / pleines) | 0,60 $ / 1,20 $ | 1,98 $ / 3,96 $ |
| Longueur de contexte | 1M de tokens | 1M de tokens |
| Sortie maximale | 384K tokens | 384K tokens |
| Entrée image | Oui | Non |
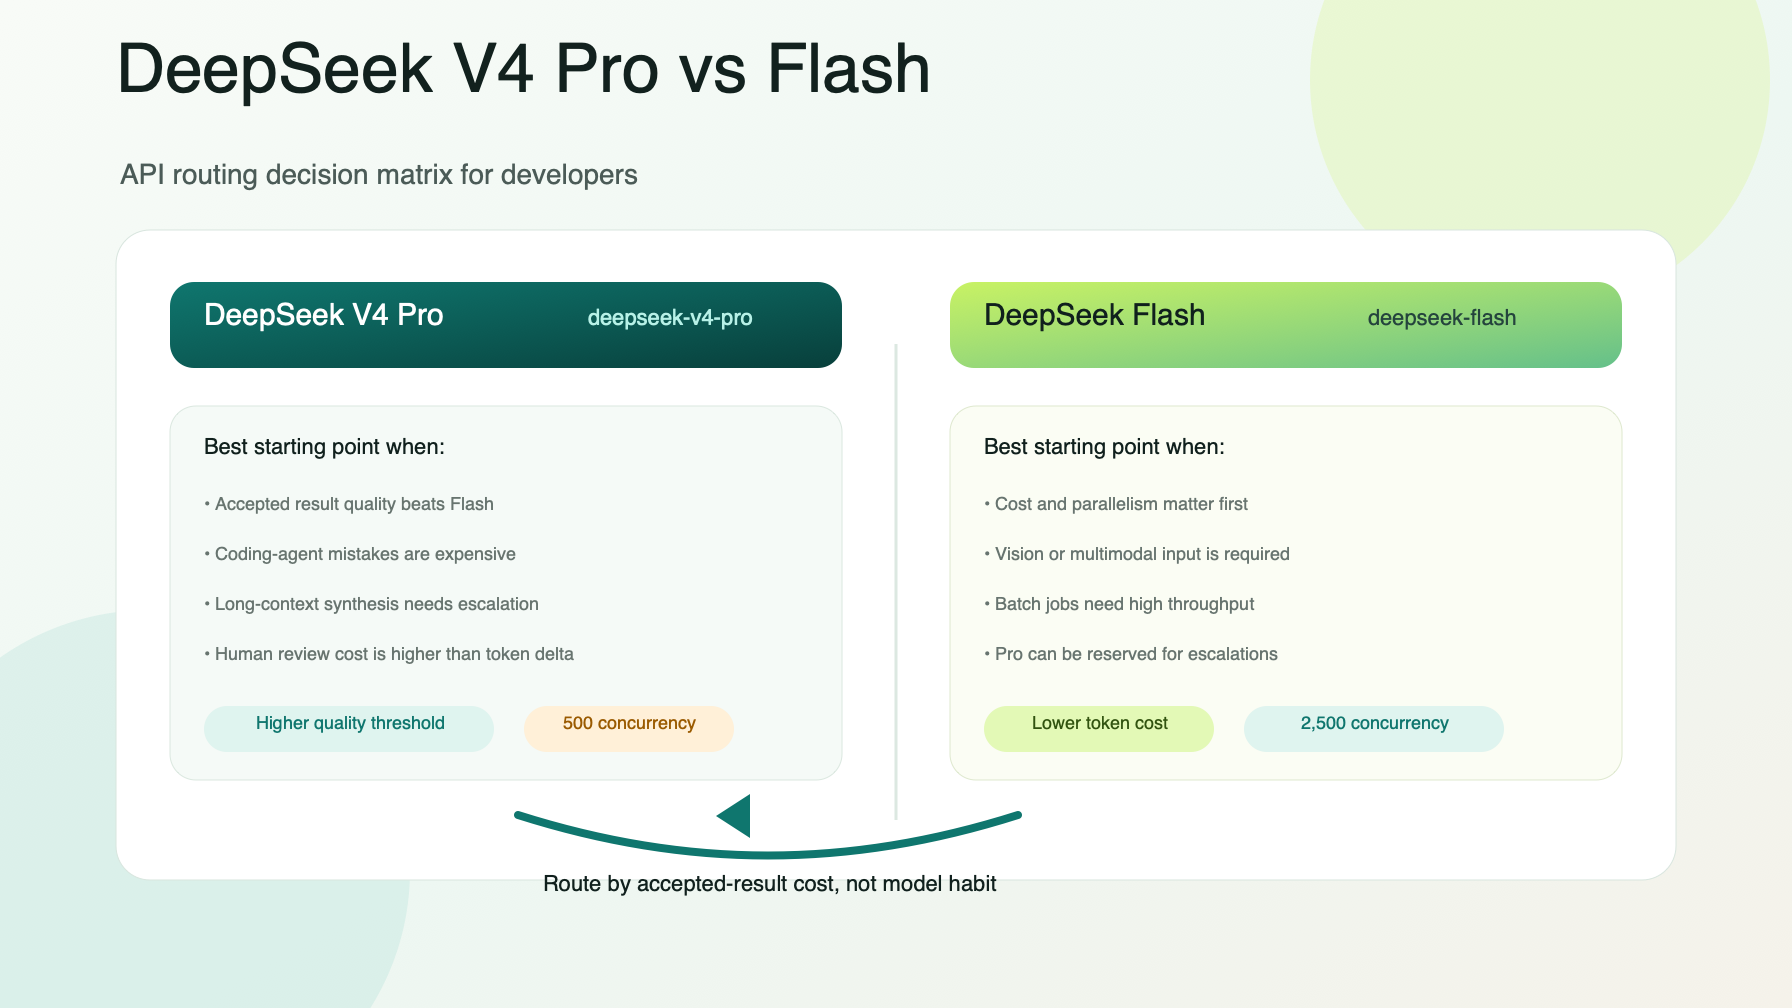
| Limite de concurrence | 2 500 | 500 |
Les deux modèles prennent en charge la sortie JSON, les appels d'outils, la Responses API, un endpoint compatible Anthropic et la complétion à partir d'un préfixe de chat (bêta). La complétion fill-in-the-middle (FIM) ne fonctionne qu'en mode sans raisonnement. DeepSeek vend aussi un outil Search/Fetch à 0,75 $ pour 1 000 requêtes réussies, gratuit dans les intégrations Harness, Claude Code et Codex jusqu'au début de la facturation le 1er novembre 2026 à 00:00, heure de Pékin.
Heures pleines et heures creuses
Les tarifs en heures creuses représentent la moitié des tarifs en heures pleines. Selon DeepSeek, les heures pleines vont de 01:00 à 04:00 et de 06:00 à 10:00 UTC, du lundi au vendredi, hors jours fériés chinois. Toutes les autres heures sont creuses, y compris l'intégralité du samedi et du dimanche et chaque jour férié chinois.
| Fuseau horaire | Plage pleine 1 | Plage pleine 2 |
|---|---|---|
| UTC | 01:00–04:00 | 06:00–10:00 |
| Pékin (UTC+8) | 09:00–12:00 | 14:00–18:00 |
| New York (EDT, UTC−4) | 21:00–00:00 (la veille) | 02:00–06:00 |
| Londres (GMT, UTC+0 à partir du 25 octobre) | 01:00–04:00 | 06:00–10:00 |
En pratique, les heures pleines couvrent la journée de travail chinoise. Si vos utilisateurs sont en Amérique ou en Europe, une grande partie de votre trafic diurne tombe déjà en heures creuses. Les traitements par lots, les évaluations et les backfills sont les plus faciles à déplacer : planifiez-les le week-end ou en dehors des deux plages UTC et ils coûteront moitié moins.
Ce qui a changé : V4 Flash est devenu V4.1 Flash
Beaucoup de pages présentent encore « DeepSeek V4 Flash » comme le modèle actuel. En octobre 2026, ce n'est plus le cas. Le guide de démarrage rapide de l'API DeepSeek indique d'utiliser deepseek-flash comme nom de modèle, désormais servi par DeepSeek-V4.1-Flash-1017. Les anciens noms deepseek-v4-flash et deepseek-v4-flash-vision-exp sont toujours acceptés, mais leurs modèles sont retirés : dans tous les cas, vous obtenez la sortie de V4.1 Flash au prix Flash.
Ce que cela implique pour vous :
- Votre code continue de fonctionner. Aucune requête n'échouera simplement parce qu'elle mentionne
deepseek-v4-flash. - Vos évaluations peuvent dériver. Vous testez maintenant un autre checkpoint du modèle. Relancez vos contrôles qualité si vous avez validé Flash il y a plusieurs mois. Notre checklist de migration vers DeepSeek V4 indique ce qu'il faut retester.
- Mettez à jour votre configuration. Passez à
deepseek-flashpour que les logs et les tableaux de bord affichent ce qui tourne réellement. Vous pouvez suivre les prochains changements dans le journal des modifications de l'API DeepSeek.
Ce que coûte une charge de travail réelle
Les prix par million de tokens sont difficiles à se représenter, alors voici un exemple chiffré. Imaginons un assistant de support qui traite 10 000 requêtes par jour. Chaque requête envoie un prompt de 3 000 tokens, dont un prompt système et un bloc de connaissances de 2 000 tokens réutilisés (cache hit), et renvoie 500 tokens.
Cela représente 20M de tokens d'entrée en cache hit, 10M de tokens d'entrée en cache miss et 5M de tokens de sortie par jour.
| Coût quotidien | Flash, pleines | Flash, creuses | V4 Pro, pleines | V4 Pro, creuses |
|---|---|---|---|---|
| Entrée cache hit (20M) | 0,12 $ | 0,06 $ | 0,88 $ | 0,44 $ |
| Entrée cache miss (10M) | 3,00 $ | 1,50 $ | 13,20 $ | 6,60 $ |
| Sortie (5M) | 6,00 $ | 3,00 $ | 19,80 $ | 9,90 $ |
| Total par jour | 9,12 $ | 4,56 $ | 33,88 $ | 16,94 $ |
| Total sur 30 jours | 273,60 $ | 136,80 $ | 1 016,40 $ | 508,20 $ |
Trois leviers pèsent le plus sur cette facture. Les tokens de sortie constituent la plus grosse ligne : plafonnez max_tokens et demandez des réponses courtes quand c'est possible. Le prix en cache hit représente environ 2 % du prix en cache miss : placez la partie réutilisable du prompt au début et gardez-la identique d'une requête à l'autre. Enfin, l'heure de la journée divise tout par deux : déplacez le travail flexible en heures creuses.
Voici le même calcul sous forme d'une petite fonction Python à adapter :
# DeepSeek official prices per 1M tokens, checked October 25, 2026
PRICES = {
    "flash": {"hit": (0.003, 0.006), "miss": (0.15, 0.30), "out": (0.60, 1.20)},
    "pro":   {"hit": (0.022, 0.044), "miss": (0.66, 1.32), "out": (1.98, 3.96)},
}

def daily_cost(model, hit_m, miss_m, out_m, peak=True):
    i = 1 if peak else 0
    p = PRICES[model]
    return hit_m * p["hit"][i] + miss_m * p["miss"][i] + out_m * p["out"][i]

print(round(daily_cost("flash", 20, 10, 5, peak=True), 2))   # 9.12
print(round(daily_cost("flash", 20, 10, 5, peak=False), 2))  # 4.56
Comment fonctionne la tarification du cache DeepSeek
Le cache DeepSeek est automatique : vous n'avez aucun paramètre à ajouter. D'après le guide de cache de contexte de DeepSeek, chaque requête écrit des unités de cache sur disque, et une requête ultérieure n'obtient un cache hit que si son préfixe correspond entièrement à une unité stockée. La réponse indique le résultat dans usage.prompt_cache_hit_tokens et usage.prompt_cache_miss_tokens.
Pour obtenir plus de cache hits :
- Placez en premier le prompt système, les définitions d'outils et les documents de référence, et gardez-les identiques octet pour octet.
- Placez à la fin la question de l'utilisateur et tout ce qui change (horodatages, identifiants).
- Dans un chat à plusieurs tours, ajoutez les nouveaux tours au lieu de réécrire les précédents.
Pour une vue plus large du fonctionnement du cache chez les différents fournisseurs, consultez notre guide des coûts et du ROI du prompt caching.
Flash ou V4 Pro : quand payer plus
Flash coûte environ un quart de V4 Pro en entrée et environ 30 % en sortie. Utilisez Flash par défaut pour le chat, l'extraction, la classification, les résumés, les réponses RAG et les sous-étapes d'agents. Il prend aussi en charge l'entrée image et offre une limite de concurrence bien plus élevée (2 500 contre 500). Ne basculez une tâche vers V4 Pro que si vos propres évaluations montrent que Flash échoue dessus, généralement sur des raisonnements complexes en plusieurs étapes ou de gros changements de code. Notre comparatif DeepSeek V4 Pro vs Flash et le guide des prix de l'API DeepSeek V4 Pro vont plus loin.
DeepSeek V4 Flash est-il gratuit ?
Pas sur l'API. Voici ce qui est gratuit ou non au 25 octobre 2026 :
| Option | Coût | Ce que vous obtenez |
|---|---|---|
| Application de chat DeepSeek (web et mobile) | Gratuit | Discuter avec les modèles actuels de DeepSeek ; ce n'est pas une API |
| API DeepSeek, solde offert | Gratuit tant qu'il dure | Crédit promotionnel, si votre compte en a ; utilisé avant votre solde payant |
| API DeepSeek, solde payant | Paiement à l'usage | Les prix du tableau ci-dessus ; sans abonnement |
| Checkpoints à poids ouverts | Téléchargement gratuit | Auto-hébergement sur vos propres GPU ; consultez l'organisation DeepSeek sur Hugging Face pour savoir quels modèles et licences sont publiés |
La page de tarification de DeepSeek précise que les frais sont déduits de votre solde rechargé ou de votre solde offert, le solde offert étant utilisé en premier lorsque vous avez les deux. Elle ne promet aucun quota gratuit permanent pour les nouveaux comptes : considérez donc toute offre de « clé API DeepSeek gratuite » comme une promotion tierce et lisez ses conditions. Pour une liste plus large d'options vraiment gratuites, consultez notre guide des API LLM gratuites.
L'option payante la moins chère suffit généralement pour tester : aux tarifs des heures creuses, mille prompts de test de 1 000 tokens avec des réponses de 300 tokens coûtent environ 0,33 $ sur Flash.
Appeler DeepSeek Flash depuis votre code
L'API DeepSeek est compatible OpenAI à l'adresse https://api.deepseek.com, et propose aussi un endpoint au format Anthropic à https://api.deepseek.com/anthropic (voir le guide de l'API Anthropic).
curl https://api.deepseek.com/chat/completions \
  -H "Authorization: Bearer $DEEPSEEK_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-flash",
    "messages": [
      {"role": "system", "content": "You are a concise support assistant."},
      {"role": "user", "content": "Summarize our refund policy in two sentences."}
    ],
    "max_tokens": 300
  }'
from openai import OpenAI

client = OpenAI(api_key="YOUR_DEEPSEEK_KEY", base_url="https://api.deepseek.com")
r = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{"role": "user", "content": "Give me three test cases for a date parser."}],
    max_tokens=300,
)
print(r.choices[0].message.content)
print(r.usage)  # check prompt_cache_hit_tokens / prompt_cache_miss_tokens
Utiliser DeepSeek Flash via Flatkey
Si vous utilisez aussi des modèles Claude, Gemini, Qwen ou GPT, vous pouvez accéder à DeepSeek via Flatkey avec une seule clé API et un seul solde. Au 25 octobre 2026, la page du modèle DeepSeek V4.1 Flash sur Flatkey affiche des prix à partir de 0,09 $ par million de tokens d'entrée, 0,0018 $ par million de tokens en cache et 0,36 $ par million de tokens de sortie, et l'ancienne route deepseek-v4-flash est affichée à partir de 0,132 $ en entrée et 0,396 $ en sortie. Les prix « à partir de » correspondent au palier le plus bas affiché : vérifiez sur la page du modèle le palier qui s'applique à votre trafic.
from openai import OpenAI

client = OpenAI(api_key="YOUR_FLATKEY_KEY", base_url="https://router.flatkey.ai/v1")
r = client.chat.completions.create(
    model="deepseek-v4-1-flash",
    messages=[{"role": "user", "content": "Classify this ticket: 'card charged twice'"}],
)
print(r.choices[0].message.content)
Le guide de démarrage rapide du routeur montre comment tout configurer en quelques minutes, et notre aperçu des prix de l'API DeepSeek compare DeepSeek à d'autres modèles à bas coût.
FAQ
Combien coûte DeepSeek V4 Flash ?
Au 25 octobre 2026, DeepSeek Flash coûte en heures pleines 0,30 $ par million de tokens d'entrée en cache miss, 0,006 $ par million de tokens d'entrée en cache hit et 1,20 $ par million de tokens de sortie, et moitié moins en heures creuses : 0,15 $, 0,003 $ et 0,60 $.
Quelles sont les heures pleines de DeepSeek ?
Les heures pleines vont de 01:00 à 04:00 et de 06:00 à 10:00 UTC, du lundi au vendredi, hors jours fériés chinois, soit 09:00–12:00 et 14:00–18:00 heure de Pékin. Tout le reste, week-ends compris, est en heures creuses à moitié prix.
L'API DeepSeek est-elle gratuite ?
Non. L'application de chat est gratuite, mais l'API est facturée à l'usage. Si votre compte dispose d'un solde offert, DeepSeek l'utilise avant votre solde payant.
deepseek-v4-flash est-il toujours disponible ?
Le nom est toujours accepté, mais le modèle est retiré. Les requêtes vers deepseek-v4-flash sont servies par DeepSeek-V4.1-Flash-1017 et facturées au prix Flash. Utilisez deepseek-flash dans le nouveau code.
Quelle est la fenêtre de contexte de DeepSeek Flash ?
1M de tokens, avec jusqu'à 384K tokens de sortie, selon la page de tarification de DeepSeek.
DeepSeek Flash est-il moins cher que V4 Pro ?
Oui. En heures pleines, l'entrée Flash coûte 0,30 $ contre 1,32 $ par million de tokens, et la sortie 1,20 $ contre 3,96 $. Flash offre aussi une limite de concurrence plus élevée et accepte les images en entrée.
Sources
- Modèles et tarifs DeepSeek (consulté le 25 octobre 2026)
- Démarrage rapide de l'API DeepSeek (octobre 2026)
- Guide du cache de contexte DeepSeek (octobre 2026)
- Guide de l'API Anthropic de DeepSeek (octobre 2026)
- Limites de débit DeepSeek (octobre 2026)
- Journal des modifications de l'API DeepSeek (octobre 2026)
- Page du modèle DeepSeek V4.1 Flash sur Flatkey (octobre 2026)