Precio de DeepSeek V4 Flash (octubre de 2026): horas punta, horas valle y acceso gratuito
El modelo Flash de DeepSeek cuesta 0,30 $ por millón de tokens de entrada y 1,20 $ por millón de tokens de salida en hora punta, y exactamente la mitad en hora valle (0,15 $ de entrada y 0,60 $ de salida), con la entrada en caché desde solo 0,003 $ por millón de tokens, a 25 de octubre de 2026. El nombre de modelo que debes usar ahora es deepseek-flash, servido por DeepSeek-V4.1-Flash-1017. El antiguo nombre deepseek-v4-flash sigue funcionando, pero DeepSeek ha retirado ese modelo y redirige esas peticiones a V4.1 Flash con el mismo precio de Flash.
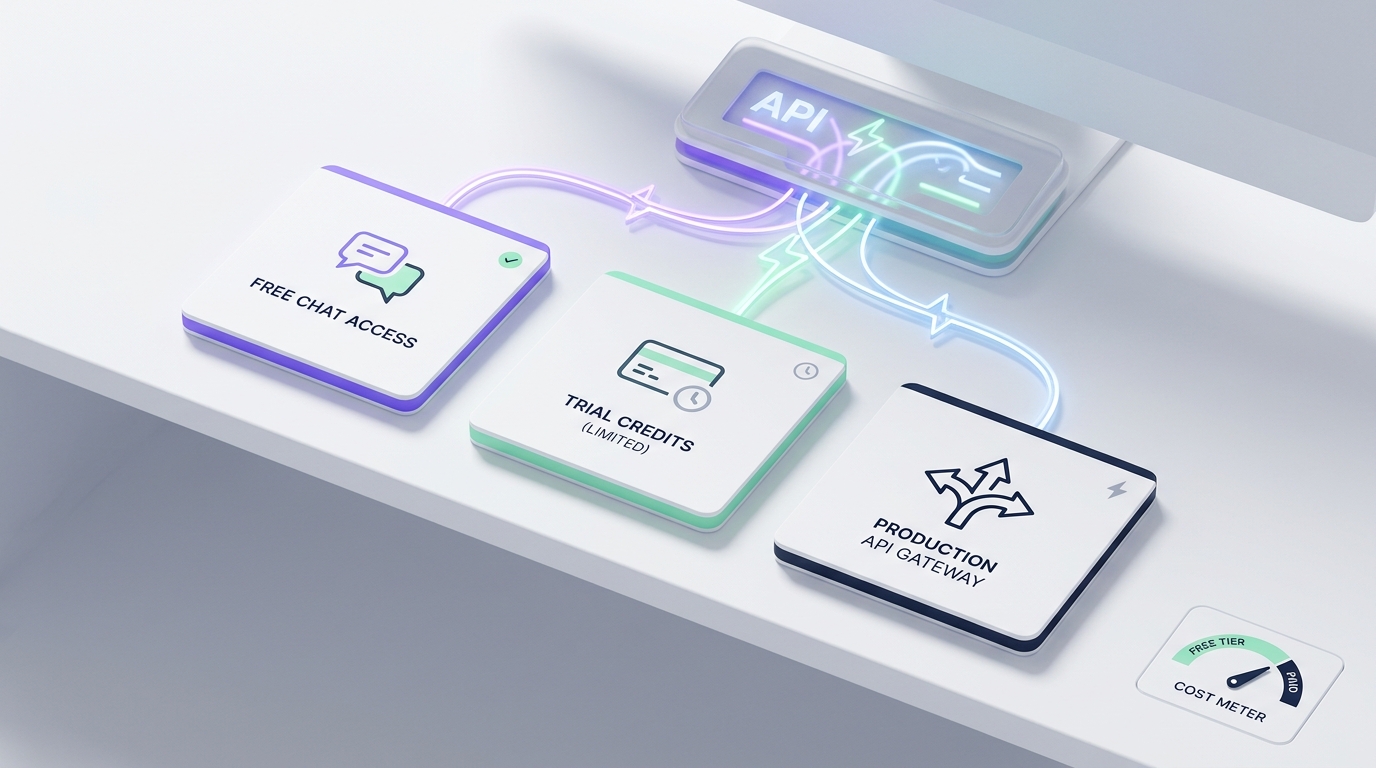
No existe un nivel gratuito permanente de la API. La app de chat de DeepSeek es gratuita, y el uso de la API se descuenta del saldo de tu cuenta, gastando primero cualquier saldo concedido (promocional). Esta guía cubre la tabla de precios completa, el horario de hora punta, lo que cuesta una carga de trabajo real, la comparación entre Flash y V4 Pro, y las opciones honestas para probarlo gratis o casi gratis. Todas las cifras proceden de la página oficial de precios de DeepSeek, consultada el 25 de octubre de 2026.
Tabla de precios de DeepSeek V4 Flash
Precios en USD por millón de tokens en la API oficial de DeepSeek.
DeepSeek Flash (deepseek-flash) |
DeepSeek V4 Pro (deepseek-v4-pro) |
|
|---|---|---|
| Versión del modelo | DeepSeek-V4.1-Flash-1017 | DeepSeek-V4-Pro-0813 |
| Entrada, acierto de caché (valle / punta) | 0,003 $ / 0,006 $ | 0,022 $ / 0,044 $ |
| Entrada, fallo de caché (valle / punta) | 0,15 $ / 0,30 $ | 0,66 $ / 1,32 $ |
| Salida (valle / punta) | 0,60 $ / 1,20 $ | 1,98 $ / 3,96 $ |
| Longitud de contexto | 1M de tokens | 1M de tokens |
| Salida máxima | 384K tokens | 384K tokens |
| Entrada de imágenes | Sí | No |
| Límite de concurrencia | 2.500 | 500 |
Ambos modelos admiten salida JSON, llamadas a herramientas, la Responses API, un endpoint compatible con Anthropic y el completado con prefijo de chat (beta). El completado fill-in-the-middle (FIM) solo funciona en modo sin razonamiento. DeepSeek también vende una herramienta Search/Fetch a 0,75 $ por cada 1.000 peticiones correctas, que es gratuita dentro de las integraciones de Harness, Claude Code y Codex hasta que empiece a facturarse a las 00:00 hora de Pekín del 1 de noviembre de 2026.
Horas punta y horas valle
Las tarifas de hora valle son la mitad de las de hora punta. Según DeepSeek, las horas punta son de 01:00 a 04:00 y de 06:00 a 10:00 UTC, de lunes a viernes, excepto los festivos oficiales de China. Todas las demás horas son valle, incluidos el sábado y el domingo completos y todos los festivos oficiales chinos.
| Zona horaria | Franja punta 1 | Franja punta 2 |
|---|---|---|
| UTC | 01:00–04:00 | 06:00–10:00 |
| Pekín (UTC+8) | 09:00–12:00 | 14:00–18:00 |
| Nueva York (EDT, UTC−4) | 21:00–00:00 (día anterior) | 02:00–06:00 |
| Londres (GMT, UTC+0 desde el 25 de octubre) | 01:00–04:00 | 06:00–10:00 |
En la práctica, la hora punta cubre la jornada laboral china. Si tus usuarios están en América o Europa, buena parte de tu tráfico diurno ya cae en hora valle. Los trabajos por lotes, las evaluaciones y los backfills son los más fáciles de mover: prográmalos para el fin de semana o fuera de las dos franjas UTC y costarán la mitad.
Qué ha cambiado: V4 Flash ahora es V4.1 Flash
Muchas páginas siguen hablando de "DeepSeek V4 Flash" como si fuera el modelo actual. En octubre de 2026 ya no lo es. El inicio rápido de la API de DeepSeek indica que se use deepseek-flash como nombre de modelo, que ahora sirve DeepSeek-V4.1-Flash-1017. Los nombres heredados deepseek-v4-flash y deepseek-v4-flash-vision-exp se siguen aceptando, pero sus modelos están retirados, así que en ambos casos obtienes la salida de V4.1 Flash y el precio de Flash.
Qué significa esto para ti:
- Tu código sigue funcionando. Ninguna petición fallará solo porque diga
deepseek-v4-flash. - Tus evaluaciones pueden variar. Ahora estás probando otro checkpoint del modelo. Vuelve a ejecutar tus controles de calidad si aprobaste Flash hace meses. Nuestra lista de comprobación para migrar a DeepSeek V4 explica qué volver a probar.
- Actualiza tu configuración. Cambia a
deepseek-flashpara que los logs y paneles muestren lo que realmente se está ejecutando. Puedes seguir los próximos cambios en el registro de cambios de la API de DeepSeek.
Lo que cuesta una carga de trabajo real
Los precios por millón de tokens son difíciles de imaginar, así que veamos un ejemplo. Supón que un asistente de soporte atiende 10.000 peticiones al día. Cada petición envía un prompt de 3.000 tokens, de los cuales un prompt de sistema y un bloque de conocimiento de 2.000 tokens se reutilizan (acierto de caché), y devuelve 500 tokens.
Eso supone 20M de tokens de entrada con acierto de caché, 10M de tokens de entrada con fallo de caché y 5M de tokens de salida al día.
| Coste diario | Flash, punta | Flash, valle | V4 Pro, punta | V4 Pro, valle |
|---|---|---|---|---|
| Entrada con acierto de caché (20M) | 0,12 $ | 0,06 $ | 0,88 $ | 0,44 $ |
| Entrada con fallo de caché (10M) | 3,00 $ | 1,50 $ | 13,20 $ | 6,60 $ |
| Salida (5M) | 6,00 $ | 3,00 $ | 19,80 $ | 9,90 $ |
| Total diario | 9,12 $ | 4,56 $ | 33,88 $ | 16,94 $ |
| Total en 30 días | 273,60 $ | 136,80 $ | 1.016,40 $ | 508,20 $ |
Tres factores mueven más esta factura. Los tokens de salida son la partida más grande, así que limita max_tokens y pide respuestas breves cuando puedas. El precio con acierto de caché es aproximadamente el 2 % del precio con fallo, así que coloca la parte reutilizable del prompt al principio y mantenla idéntica entre peticiones. Y la hora del día lo reduce todo a la mitad, así que mueve el trabajo flexible a hora valle.
Este es el mismo cálculo como una pequeña función de Python que puedes adaptar:
# DeepSeek official prices per 1M tokens, checked October 25, 2026
PRICES = {
    "flash": {"hit": (0.003, 0.006), "miss": (0.15, 0.30), "out": (0.60, 1.20)},
    "pro":   {"hit": (0.022, 0.044), "miss": (0.66, 1.32), "out": (1.98, 3.96)},
}

def daily_cost(model, hit_m, miss_m, out_m, peak=True):
    i = 1 if peak else 0
    p = PRICES[model]
    return hit_m * p["hit"][i] + miss_m * p["miss"][i] + out_m * p["out"][i]

print(round(daily_cost("flash", 20, 10, 5, peak=True), 2))   # 9.12
print(round(daily_cost("flash", 20, 10, 5, peak=False), 2))  # 4.56
Cómo funcionan los precios de caché de DeepSeek
La caché de DeepSeek es automática: no tienes que añadir ningún parámetro. Según la guía de caché de contexto de DeepSeek, cada petición escribe unidades de caché en disco, y una petición posterior solo obtiene un acierto cuando su prefijo coincide por completo con una unidad almacenada. La respuesta te indica el resultado en usage.prompt_cache_hit_tokens y usage.prompt_cache_miss_tokens.
Para conseguir más aciertos:
- Coloca primero el prompt de sistema, las definiciones de herramientas y los documentos de referencia, y mantenlos idénticos byte a byte.
- Coloca al final la pregunta del usuario y todo lo que cambie (marcas de tiempo, ID).
- En chats de varios turnos, añade los turnos nuevos en lugar de reescribir los anteriores.
Si quieres una visión más amplia de cómo funciona la caché en distintos proveedores, consulta nuestra guía de costes y ROI del prompt caching.
Flash frente a V4 Pro: cuándo pagar más
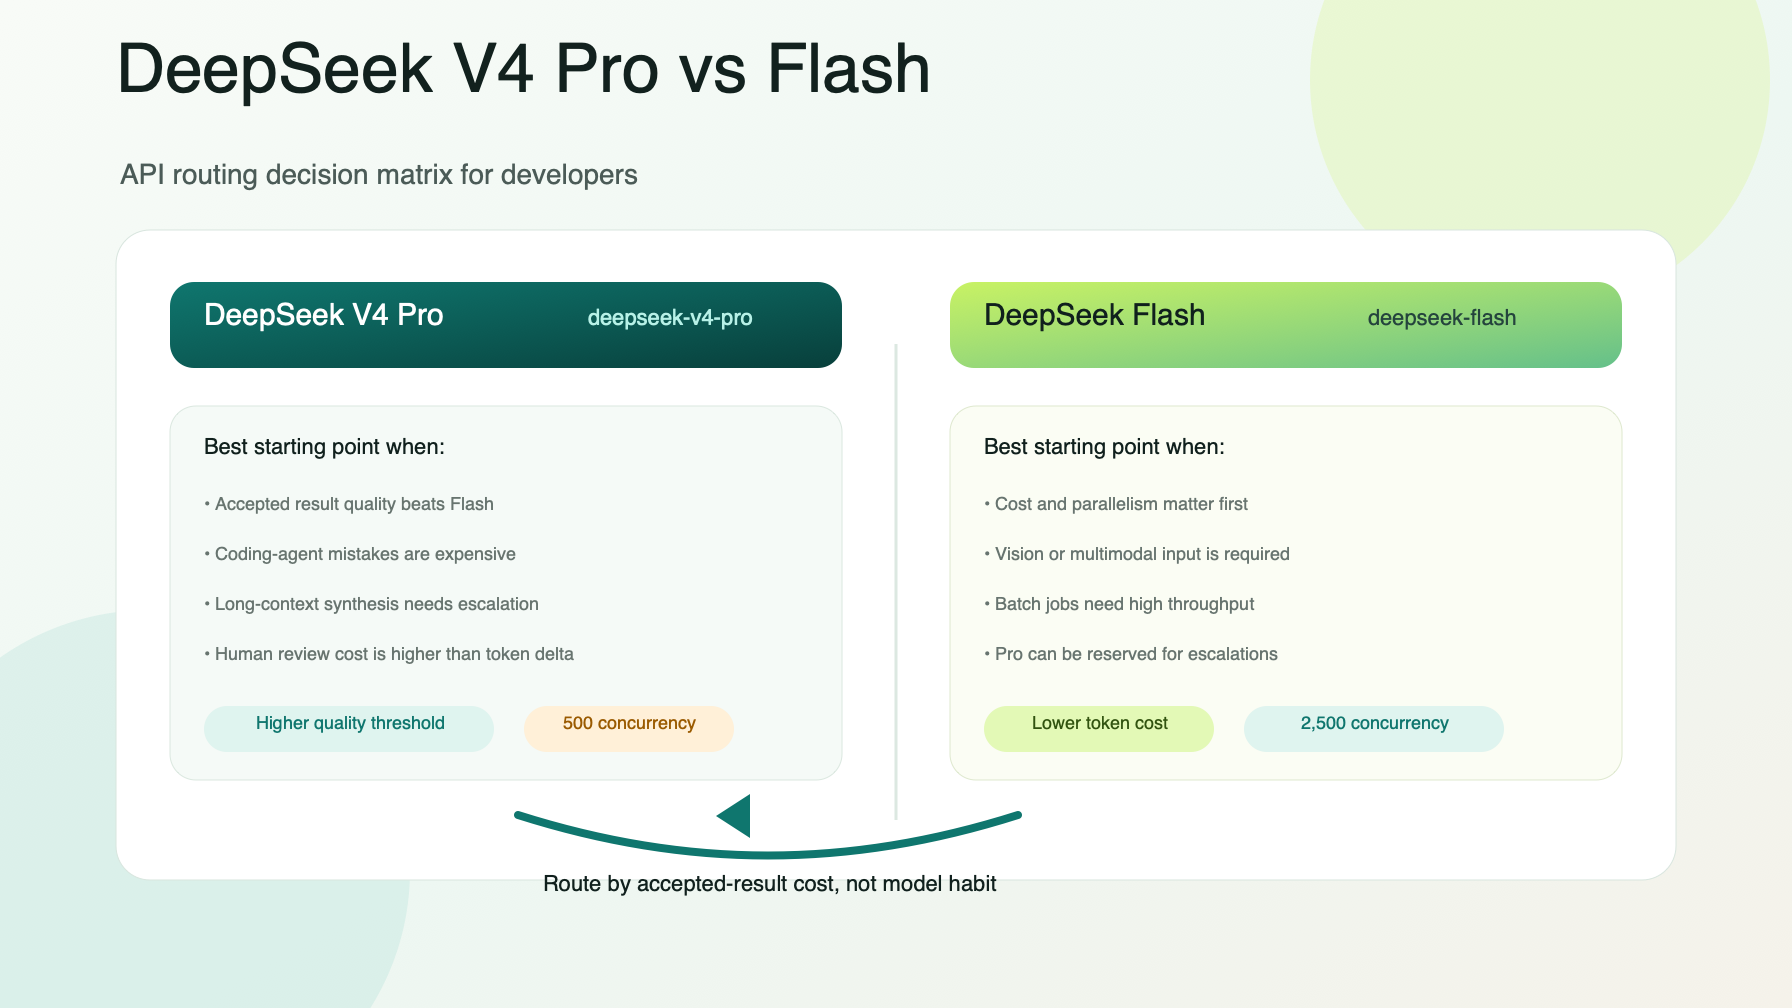
Flash cuesta aproximadamente una cuarta parte que V4 Pro en entrada y alrededor del 30 % en salida. Usa Flash por defecto para chat, extracción, clasificación, resúmenes, respuestas RAG y subtareas de agentes. Además admite entrada de imágenes y tiene un límite de concurrencia mucho mayor (2.500 frente a 500). Pasa una tarea a V4 Pro solo cuando tus propias evaluaciones muestren que Flash falla en ella, normalmente en razonamientos complejos de varios pasos o en cambios grandes de código. Nuestra comparación entre DeepSeek V4 Pro y Flash y la guía de precios de la API de DeepSeek V4 Pro profundizan en ello.
¿Es gratis DeepSeek V4 Flash?
En la API, no. Esto es lo que es gratis y lo que no a 25 de octubre de 2026:
| Opción | Coste | Qué obtienes |
|---|---|---|
| App de chat de DeepSeek (web y móvil) | Gratis | Chatear con los modelos actuales de DeepSeek; no es una API |
| API de DeepSeek, saldo concedido | Gratis mientras dure | Crédito promocional, si tu cuenta lo tiene; se usa antes que tu saldo de pago |
| API de DeepSeek, saldo de pago | Pago por uso | Los precios de la tabla anterior; sin suscripción |
| Checkpoints de pesos abiertos | Descarga gratuita | Alojamiento propio en tus GPU; consulta en la organización de DeepSeek en Hugging Face qué modelos y licencias están publicados |
La página de precios de DeepSeek indica que las tarifas se descuentan de tu saldo recargado o de tu saldo concedido, usando primero el concedido cuando tienes ambos. No promete una cuota gratuita permanente para cuentas nuevas, así que trata cualquier oferta de "clave de API de DeepSeek gratis" como una promoción de terceros y lee sus condiciones. Para una lista más amplia de opciones realmente gratuitas, consulta nuestra guía de APIs de LLM gratuitas.
La vía de pago más barata suele bastar para pruebas: a precios de hora valle, mil prompts de prueba de 1.000 tokens con respuestas de 300 tokens cuestan unos 0,33 $ en Flash.
Llamar a DeepSeek Flash desde código
La API de DeepSeek es compatible con OpenAI en https://api.deepseek.com, y también tiene un endpoint con formato Anthropic en https://api.deepseek.com/anthropic (consulta la guía de la API de Anthropic).
curl https://api.deepseek.com/chat/completions \
  -H "Authorization: Bearer $DEEPSEEK_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-flash",
    "messages": [
      {"role": "system", "content": "You are a concise support assistant."},
      {"role": "user", "content": "Summarize our refund policy in two sentences."}
    ],
    "max_tokens": 300
  }'
from openai import OpenAI

client = OpenAI(api_key="YOUR_DEEPSEEK_KEY", base_url="https://api.deepseek.com")
r = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{"role": "user", "content": "Give me three test cases for a date parser."}],
    max_tokens=300,
)
print(r.choices[0].message.content)
print(r.usage)  # check prompt_cache_hit_tokens / prompt_cache_miss_tokens
Usar DeepSeek Flash a través de Flatkey
Si también usas modelos Claude, Gemini, Qwen o GPT, puedes acceder a DeepSeek a través de Flatkey con una sola clave de API y un único saldo. A 25 de octubre de 2026, la página del modelo DeepSeek V4.1 Flash en Flatkey indica precios desde 0,09 $ por millón de tokens de entrada, 0,0018 $ por millón de tokens en caché y 0,36 $ por millón de tokens de salida, y la ruta heredada deepseek-v4-flash figura desde 0,132 $ de entrada y 0,396 $ de salida. Los precios "desde" corresponden al nivel más bajo publicado, así que revisa en la página del modelo el nivel que se aplica a tu tráfico.
from openai import OpenAI

client = OpenAI(api_key="YOUR_FLATKEY_KEY", base_url="https://router.flatkey.ai/v1")
r = client.chat.completions.create(
    model="deepseek-v4-1-flash",
    messages=[{"role": "user", "content": "Classify this ticket: 'card charged twice'"}],
)
print(r.choices[0].message.content)
El inicio rápido del router muestra cómo configurarlo en pocos minutos, y nuestro resumen de precios de la API de DeepSeek compara DeepSeek con otros modelos de bajo coste.
FAQ
¿Cuánto cuesta DeepSeek V4 Flash?
A 25 de octubre de 2026, DeepSeek Flash cuesta en hora punta 0,30 $ por millón de tokens de entrada con fallo de caché, 0,006 $ por millón de tokens de entrada con acierto de caché y 1,20 $ por millón de tokens de salida, y la mitad en hora valle: 0,15 $, 0,003 $ y 0,60 $.
¿Cuáles son las horas punta de DeepSeek?
Las horas punta son de 01:00 a 04:00 y de 06:00 a 10:00 UTC, de lunes a viernes, excepto los festivos oficiales de China. Eso equivale a 09:00–12:00 y 14:00–18:00 hora de Pekín. Todo lo demás, incluidos los fines de semana, es hora valle a mitad de precio.
¿Es gratis la API de DeepSeek?
No. La app de chat es gratuita, pero la API es de pago por uso. Si tu cuenta tiene saldo concedido, DeepSeek lo usa antes que tu saldo de pago.
¿Sigue disponible deepseek-v4-flash?
El nombre se sigue aceptando, pero el modelo está retirado. Las peticiones a deepseek-v4-flash las atiende DeepSeek-V4.1-Flash-1017 y se facturan al precio de Flash. Usa deepseek-flash en el código nuevo.
¿Cuál es la ventana de contexto de DeepSeek Flash?
1M de tokens, con hasta 384K tokens de salida, según la página de precios de DeepSeek.
¿Es DeepSeek Flash más barato que V4 Pro?
Sí. En hora punta, la entrada de Flash cuesta 0,30 $ frente a 1,32 $ por millón de tokens, y la salida 1,20 $ frente a 3,96 $. Flash también tiene un límite de concurrencia mayor y admite entrada de imágenes.
Fuentes
- Modelos y precios de DeepSeek (consultado el 25 de octubre de 2026)
- Inicio rápido de la API de DeepSeek (octubre de 2026)
- Guía de caché de contexto de DeepSeek (octubre de 2026)
- Guía de la API de Anthropic de DeepSeek (octubre de 2026)
- Límites de uso de DeepSeek (octubre de 2026)
- Registro de cambios de la API de DeepSeek (octubre de 2026)
- Página del modelo DeepSeek V4.1 Flash en Flatkey (octubre de 2026)