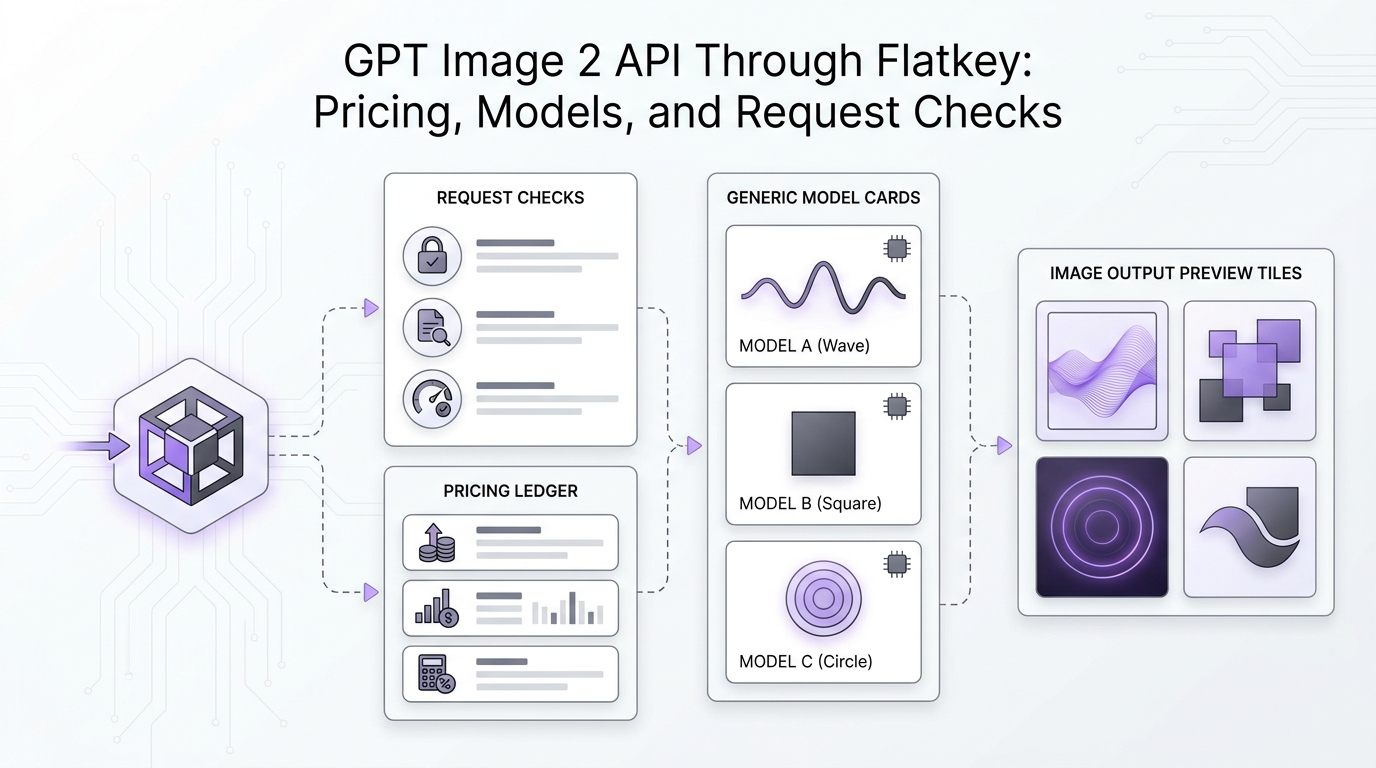
Si vous évaluez le GPT Image 2 API via Flatkey : tarification, modèles et vérifications des requêtes, commencez par les preuves de routage et de facturation avant de copier un extrait de génération en production. GPT Image 2 est un choix de modèle, mais un workflow d’images en production dépend aussi de la prise en charge des points de terminaison, des paramètres de sortie, du comportement de réessai, du stockage, de la politique de modération et de la capacité de votre équipe à expliquer le coût final par image acceptée.
Ce guide offre aux équipes médias et aux équipes produit IA une méthode pratique pour examiner l’accès à GPT Image 2 API via Flatkey. Il s’appuie sur une vérification actuelle des tarifs OpenAI, un instantané en direct du flux tarifaire Flatkey du 15 septembre 2026, ainsi que sur les pages de modèle et de tarification Flatkey existantes comme points de vérification. Considérez les blocs de code comme des modèles : exécutez votre propre test de validation avec votre clé Flatkey, votre ligne de modèle exacte et vos exigences réelles en matière d’assets avant de faire passer le trafic de production.
Réponse rapide : tarification et vérifications de GPT Image 2 API via Flatkey
Utilisez le workflow GPT Image 2 API via Flatkey : tarification, modèles et vérifications des requêtes dans cet ordre :
- Confirmez la ligne de modèle exacte que vous prévoyez d’appeler :
gpt-image-2,gpt-image-2.5-flare,gpt-image-2.5-sunburst, ou une ligne avec espace de noms affichée dans votre compte. - Confirmez les types de points de terminaison pris en charge pour cette ligne dans Flatkey. Une ligne de modèle et un chemin de route sont deux éléments distincts.
- Comparez le tableau tarifaire actuel d’OpenAI pour la génération d’images avec la page de tarification actuelle de Flatkey et les journaux d’utilisation.
- Exécutez une petite requête via la route Flatkey confirmée avant de connecter un pipeline créatif par lots.
- Enregistrez l’invite, le nombre d’images d’entrée, la taille, la qualité, le format, le nombre de réessais, la latence, le statut et le coût pour chaque asset accepté.
- Conservez le point de référence direct du fournisseur jusqu’à ce que le comportement de la route Flatkey, la facturation et la gestion du stockage correspondent à vos exigences de production.
Cette séquence est importante, car le coût de génération d’images ne se limite pas au tarif affiché du modèle. Il s’agit du coût de sortie acceptée après prise en compte des invites invalides, des requêtes échouées, des réessais, des refus humains et des opérations de stockage/export.
Ce qui a changé depuis les anciennes notes sur GPT Image 2
La documentation actuelle d’OpenAI sur la génération d’images met désormais en avant gpt-image-2.5-sunburst dans ses exemples, tandis que la page de tarification d’OpenAI inclut toujours gpt-image-2 et des lignes GPT image plus récentes. Cela signifie que la question pratique n’est plus « GPT Image 2 existe-t-il ? » La question pratique est de savoir quelle ligne GPT image votre équipe doit acheminer, comment elle est tarifée aujourd’hui, et quels paramètres de requête votre application est autorisée à modifier.
Le flux tarifaire en direct de Flatkey au 15 septembre 2026 indiquait ces lignes de la famille GPT image :
| Ligne du flux de tarification Flatkey | Champ d’état | Types d’endpoint affichés | Champs de tarification exposés dans le flux | Comment utiliser cette preuve |
|---|---|---|---|---|
gpt-image-2 |
available |
image-generation, openai |
aucun objet display_pricing dans le flux public |
Le considérer comme une ligne disponible, puis confirmer les détails de facturation dans l’interface de tarification Flatkey et les journaux d’utilisation. |
gpt-image-2.5-flare |
champ d’état vide | image-generation, openai |
model_ratio: 2.5, completion_ratio: 6, étiqueté New release |
Le considérer comme une ligne candidate actuelle, puis vérifier l’accès au compte et la tarification visible actuelle avant le trafic de production. |
gpt-image-2.5-sunburst |
champ d’état vide | image-generation, openai |
model_ratio: 2.5, completion_ratio: 6, étiqueté New release |
Le considérer comme une ligne candidate actuelle, surtout parce que la documentation OpenAI utilise cette famille dans les exemples ; exécuter tout de même les vérifications de route Flatkey. |
La bonne conclusion est volontairement étroite : Flatkey expose actuellement des lignes GPT image dans la surface modèle/tarification, mais votre décision de production doit se baser sur la ligne exacte, le chemin d’endpoint et l’étiquette de facturation actuelle visible pour votre compte.
Vérifications de tarification avant d’acheminer le trafic de l’API GPT Image 2
Pour le sujet GPT Image 2 API via Flatkey : tarification, modèles et vérifications des requêtes, utilisez la tarification comme un flux de vérification, et non comme un tableur statique copié une seule fois.
La page de tarification d’OpenAI listait la tarification GPT image dans des lignes distinctes pour l’image et le texte lorsque cet article a été actualisé. La page séparait la tarification de l’entrée, de l’entrée mise en cache et de la sortie, et elle exposait aussi une vue de tarification par lot pour les lignes prises en charge. Cette structure compte parce que les invites d’image peuvent inclure du texte, des images de référence, des modifications et des sorties générées, et que ces éléments peuvent ne pas se mapper à une simple hypothèse de « prix par image ».
Avant le lancement, remplissez ce tableau avec vos valeurs actuelles :
| Question de tarification | Quoi enregistrer | Où vérifier |
|---|---|---|
| Quelle ligne de modèle l’application appellera-t-elle ? | ID exact du modèle et tout espace de noms affiché dans Flatkey | Répertoire des modèles Flatkey et page de tarification |
| Quel chemin d’endpoint est utilisé ? | /v1/images/generations, /v1/responses ou un autre chemin confirmé |
Prise en charge des endpoints Flatkey plus la documentation du fournisseur |
| Quels composants de prix s’appliquent ? | entrée image, entrée texte, entrée mise en cache, sortie image, remise batch, frais de requête si affichés | tarification OpenAI, tarification Flatkey, journaux d’utilisation Flatkey |
| Quelle est la valeur d’une image acceptée ? | dépense totale divisée par les actifs approuvés, pas seulement les actifs renvoyés | données de QA créative ou d’acceptation en production |
| Qu’est-ce qui crée un coût caché ? | réessais, sorties rejetées, finales trop volumineuses, images de référence évitables, relances de lot | télémétrie de l’application et tableau de bord d’utilisation |
L’unité budgétaire la plus sûre est le coût par image acceptée :
cost_per_accepted_image =
  (all generation spend + retry spend + review correction spend)
  / accepted_images
Cela permet de garder l’examen tarifaire de l’API GPT Image 2 lié à l’asset que votre équipe livre réellement.
Sélection du modèle : GPT Image 2, GPT Image 2.5 Flare ou GPT Image 2.5 Sunburst
Ne sélectionnez pas un modèle uniquement parce que son nom est plus récent. Utilisez un test de charge de travail.
| Charge de travail | Première question à se poser sur le modèle | Paramètre de requête à verrouiller | Condition de réussite |
|---|---|---|---|
| Visuels de blog et de réseaux sociaux | Le modèle respecte-t-il la mise en page, le sujet et les contraintes de sécurité de la marque ? | size, quality, output_format |
Un évaluateur accepte l’asset sans régénération complète. |
| Images de concept produit | Le modèle préserve-t-il la structure de l’objet et réduit-il les détails d’interface utilisateur halluciné ? | modèle de prompt, politique d’images de référence | L’image communique le concept sans revendications trompeuses sur l’interface. |
| Variantes créatives e-commerce | Le modèle crée-t-il des variantes utiles sans s’éloigner du produit ? | nombre d’images d’entrée, arrière-plan, format | Le taux de variantes acceptées est suffisamment élevé pour surpasser le coût de production manuel. |
| Schémas éditoriaux | Le résultat reste-t-il abstrait et lisible sans faux logos ni fausses données ? | règles de prompt sans logo, contraintes de composition | Le visuel soutient l’article sans formuler de revendications non étayées. |
| Rafraîchissements par lot | Le flux reste-t-il stable sur de nombreux petits travaux ? | taille de lot, politique de relance, délai d’attente | Les taux d’échec et de relance restent dans votre seuil de lancement. |
Pour de nombreuses équipes, gpt-image-2 reste la ligne stable à évaluer parce qu’elle est explicite et disponible dans le flux de tarification Flatkey. gpt-image-2.5-flare et gpt-image-2.5-sunburst méritent d’être testés lorsque votre compte les affiche et que vous avez besoin d’une qualité de génération actuelle. Utilisez le même ensemble de prompts pour tous les candidats afin que la comparaison porte sur les performances du flux, le résultat accepté et le coût.
Vérifications des requêtes pour l’API GPT Image 2 via Flatkey
Exécutez ces vérifications avant de connecter des utilisateurs de production, des tâches de contenu planifiées ou une génération créative à fort volume.
| Vérification | Condition de réussite | Mode d’échec |
|---|---|---|
| Authentification | La clé Flatkey fonctionne uniquement depuis l’environnement prévu. | Une clé de test locale fuit en production, ou une clé de production est utilisée dans des notebooks. |
| Ligne de modèle | Le modèle de la requête correspond exactement à la ligne Flatkey sélectionnée pour le test. | Une ligne héritée, un alias ou une ligne d’un autre fournisseur est appelée par erreur. |
| Prise en charge de l’endpoint | La ligne expose le chemin appelé par votre code. | Un corps d’API Images est envoyé vers un endpoint texte, ou une requête Responses est envoyée vers une route non prise en charge. |
| Gestion de la sortie | Votre application décode, stocke et sert correctement les images générées. | L’application suppose une URL hébergée durable alors que la réponse renvoie des octets d’image. |
| Modération et politique | Les prompts dangereux ou hors brief échouent de manière gracieuse. | Une génération échouée se transforme en boucle de retry coûteuse ou en état utilisateur cassé. |
| Contrôles de taille et de qualité | Les paramètres de brouillon et de final sont distincts. | Les tâches de prévisualisation s’exécutent par erreur avec les paramètres de rendu final. |
| Politique de retry | Les retries sont bornés et consignés. | Une seule tâche créative échouée déclenche des générations répétées à coût élevé. |
| Journalisation de l’utilisation | Le modèle, le statut, la latence, les paramètres et le coût apparaissent dans les journaux. | La finance voit les dépenses mais ne peut pas les relier aux campagnes, aux utilisateurs ou aux assets acceptés. |
Ces vérifications des requêtes constituent la valeur centrale de l’utilisation d’une passerelle pour le travail sur les images. Une intégration directe au fournisseur peut être plus simple pour une seule route, mais une passerelle devient utile lorsque la génération d’images se trouve aux côtés d’appels texte, vidéo, agent et outil qui nécessitent tous une seule vue opérationnelle.
Modèle : baseline OpenAI directe
Utilisez une baseline directe du fournisseur pour comprendre le comportement attendu de la réponse avant de comparer la route Flatkey.
curl https://api.openai.com/v1/images/generations \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-image-2",
    "prompt": "Create a clean product concept image for a usage dashboard.",
    "size": "1536x1024",
    "quality": "medium",
    "output_format": "png"
  }'
Enregistrez le statut de la réponse, la latence, les octets de sortie, le résultat de modération et tous les champs d’utilisation. Ne jugez pas Flatkey tant que la baseline directe et le test routé n’utilisent pas le même prompt, les mêmes paramètres et les mêmes critères d’acceptation.
Modèle : test de fumée de la route Flatkey
Après que votre compte Flatkey a confirmé la prise en charge de la génération d’images pour la ligne sélectionnée, exécutez un test minimal via le routeur Flatkey.
curl https://router.flatkey.ai/v1/images/generations \
  -H "Authorization: Bearer $FLATKEY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-image-2",
    "prompt": "Create a clean product concept image for a usage dashboard.",
    "size": "1536x1024",
    "quality": "medium",
    "output_format": "png"
  }'
Si la ligne que vous avez sélectionnée n’affiche que la prise en charge de openai ou si la documentation de votre compte indique une autre route, contactez le support ou vérifiez votre tableau de bord avant la mise en production. N’inférez pas la prise en charge de l’endpoint à partir du seul nom du modèle.
Pour le code applicatif, centralisez l’URL de base et l’ID du modèle :
const FLATKEY_BASE_URL = "https://router.flatkey.ai/v1";

async function generateImage({ apiKey, model, prompt }) {
  const response = await fetch(`${FLATKEY_BASE_URL}/images/generations`, {
    method: "POST",
    headers: {
      Authorization: `Bearer ${apiKey}`,
      "Content-Type": "application/json"
    },
    body: JSON.stringify({
      model,
      prompt,
      size: "1536x1024",
      quality: "medium",
      output_format: "png"
    })
  });

  if (!response.ok) {
    throw new Error(`La route d'image a échoué avec ${response.status}`);
  }

  return response.json();
}
Cela rend la route Flatkey réversible. Vous pouvez changer la ligne du modèle, comparer les tests directs et routés, et éviter de disperser les paramètres de génération d’images dans tout le produit.
Scorecard de production pour les équipes média
Utilisez ce tableau de bord après la réussite du premier test de fumée.
| Metric | Target question | Why it matters |
|---|---|---|
| Taux d’images acceptées | Combien d’images retournées passent la revue ? | C’est le lien entre la qualité du modèle et le coût réel. |
| Coût par image acceptée | Combien a coûté chaque asset livré après les nouvelles tentatives et les rejets ? | Cela évite un optimisme budgétaire. |
| Latence P95 | Combien de temps prend la tâche normale la plus lente ? | Les workflows créatifs bloquent souvent sur les boucles de validation. |
| Taux de réessai | À quelle fréquence l’application régénère-t-elle en raison d’erreurs ou de mauvaises sorties ? | Les réessais peuvent masquer le vrai prix d’une route. |
| Taux de réussite des modèles de prompt | Quels prompts fonctionnent sans correction manuelle ? | Des modèles stables passent à l’échelle mieux que des prompts ponctuels. |
| Taux de réussite du stockage | Les octets générés sont-ils stockés, redimensionnés et servis correctement ? | Les API d’images renvoient souvent des assets que votre application doit conserver. |
| Auditabilité | Pouvez-vous relier les dépenses à un utilisateur, une campagne, un espace de travail et un modèle ? | La finance et les opérations ont besoin d’un registre utile. |
Flatkey est un bon choix lorsque ces métriques doivent être suivies à côté d’autres usages de modèles et d’outils. Si votre équipe n’exécute qu’un seul workflow d’image occasionnel et que la facturation directe du fournisseur est déjà maîtrisée, un accès direct à OpenAI peut suffire.
Où Flatkey s’intègre
Le positionnement de Flatkey, c’est une clé, un solde, une facture, un routeur compatible OpenAI, et l’accès à de nombreux modèles et outils officiels. Pour les charges de travail GPT image, cela compte lorsque votre pipeline créatif fait partie d’une pile IA plus large :
- génération d’images pour les visuels de campagne ;
- génération de texte pour les titres, légendes et métadonnées ;
- comparaisons de modèles entre GPT Image, les modèles d’image Gemini, les workflows de style Imagen et les modèles vidéo ;
- revue de l’utilisation par espace de travail, application, campagne ou environnement ;
- gouvernance autour des clés, des allowlists de modèles et de la responsabilité budgétaire.
Pour un contexte plus large, gardez ces références internes ouvertes :
- GPT Image vs Imagen API pour les unités de tarification des images inter-fournisseurs et les vérifications des requêtes.
- GPT Image vs Gemini Image API pour les questions de sélection de modèle et de routage.
- Image Generation API: A Practical Guide for Teams pour les métriques de workflow.
- AI Model Catalog Guide pour l’examen du fournisseur, de l’endpoint et des champs de tarification.
- tarification Flatkey et répertoire des modèles Flatkey pour les vérifications actuelles de la plateforme.
Liste de vérification finale de l’API GPT Image 2
Avant de faire passer du trafic réel dans le workflow GPT Image 2 API via Flatkey : tarification, modèles et vérifications des requêtes, confirmez :
- La ligne Flatkey actuelle existe et est disponible pour votre compte.
- La ligne prend en charge le chemin d’endpoint que votre application appellera.
- La page de tarification actuelle d’OpenAI et la page de tarification actuelle de Flatkey ont toutes deux été examinées.
- Votre budget utilise le coût par image acceptée, et pas seulement le prix de sortie nominal.
- Les paramètres de brouillon et de rendu final sont séparés dans le code.
- Les tentatives de reprise ont un nombre maximum et sont visibles dans les journaux.
- Les sorties générées sont stockées par votre application avec les métadonnées de campagne et de modèle.
- Une base de référence directe du fournisseur reste disponible jusqu’à ce que le comportement routé soit prouvé.
La décision GPT Image 2 API via Flatkey : tarification, modèles et vérifications des requêtes doit aboutir à un déploiement restreint et mesurable, pas à une préférence théorique de modèle. Choisissez la ligne, vérifiez la route, testez le corps de la requête et comparez l’économie par image acceptée avant de passer à l’échelle.
Foire aux questions
GPT Image 2 vaut-il encore la peine d’être testé si des lignes GPT Image 2.5 existent ?
Oui. GPT Image 2 reste utile à tester lorsqu’il s’agit de la ligne que votre compte expose clairement et que votre workflow privilégie un routage prévisible. GPT Image 2.5 Flare ou Sunburst peuvent être de meilleurs candidats pour des tests de qualité plus récents, mais ils nécessitent toujours les mêmes vérifications Flatkey de route, de tarification et de journaux d’utilisation.
Puis-je utiliser le SDK OpenAI avec Flatkey pour la génération d’images ?
Utilisez la compatibilité SDK uniquement après avoir confirmé la ligne Flatkey sélectionnée et le chemin d’endpoint. Pour de nombreux workflows, le paramètre important est l’URL de base du routeur, mais les endpoints de génération d’images et la gestion des réponses nécessitent toujours un test rapide.
Que doit comparer la finance en premier ?
La finance devrait comparer le coût par image acceptée. Le prix du modèle n’est qu’un composant. Les sorties rejetées, les reprises, le temps de revue et le travail de stockage/export déterminent le coût pratique d’un pipeline créatif.
Toute requête de l’API GPT Image 2 doit-elle utiliser la qualité finale ?
Non. Séparez les paramètres de brouillon, d’aperçu et de rendu final. La plupart des équipes gaspillent du budget lorsque chaque invite exploratoire utilise la même taille et les mêmes paramètres de qualité que le livrable final.
Quand dois-je choisir Flatkey plutôt qu’un accès direct à OpenAI ?
Choisissez Flatkey lorsque le travail avec les images GPT s’inscrit dans un système multi-modèle ou multi-outil qui nécessite une seule clé, une facturation partagée, des journaux d’utilisation et des vérifications de route. L’accès direct peut être plus simple lorsque vous utilisez un fournisseur, un modèle et une seule surface de facturation.