Tarifs de l'API Qwen (2026) : tous les modèles, régions et remises
Sur Alibaba Cloud Model Studio (Singapour, international), l'API Qwen démarre à 0,03 $ par million de tokens d'entrée avec qwen3.7-flash sur des prompts courts. Le modèle phare qwen3.8-max coûte 2,00 $ en entrée et 6,00 $ en sortie par million de tokens, et qwen3.7-plus est affiché à 0,40 $ / 1,60 $ (actuellement à -20 %). Les tarifs varient selon la région, la taille de la requête et le mode : le même qwen3.8-max est affiché à 1,65 $ / 4,951 $ en déploiement Global. Les appels batch coûtent 50 % du prix temps réel sur les modèles compatibles. Chiffres issus de la page officielle des tarifs de Model Studio (mise à jour le 19 octobre 2026), vérifiés le 20 octobre 2026.
Ce guide couvre les prix actuels des modèles Max, Plus, Flash, Coder, open-weight (QwenLM sur GitHub) et VL, le fonctionnement des paliers et du cache, un exemple de coût détaillé, une comparaison avec d'autres fournisseurs et du code compatible OpenAI pour appeler Qwen directement ou via une seule clé Flatkey.
Tarifs de l'API Qwen en un coup d'œil (par million de tokens)
Région Singapour, déploiement International, tarifs standard en temps réel, 20 octobre 2026 (source) :
| Modèle | Taille du prompt par requête | Entrée | Sortie | Remarques |
|---|---|---|---|---|
qwen3.8-max |
jusqu'à 1M | 2,00 $ | 6,00 $ | Phare ; avec et sans raisonnement |
qwen3.7-max |
jusqu'à 1M | 2,50 $ | 7,50 $ | Ancien phare |
qwen-max |
tarif unique | 1,60 $ | 6,40 $ | Historique ; -50 % en batch |
qwen3.7-plus |
jusqu'à 256K | 0,40 $ | 1,60 $ | Prix catalogue ; -20 % temporaire |
qwen3.7-plus |
256K–1M | 1,20 $ | 4,80 $ | Prix catalogue ; -20 % temporaire |
qwen3.6-plus |
jusqu'à 256K | 0,50 $ | 3,00 $ | |
qwen3.5-plus |
jusqu'à 256K | 0,40 $ | 2,40 $ | |
qwen3.8-flash |
jusqu'à 1M | 0,15 $ | 0,47 $ | Flash le plus récent |
qwen3.7-flash |
jusqu'à 32K | 0,03 $ | 0,13 $ | Option la moins chère pour les prompts courts |
qwen3.7-flash |
32K–256K | 0,10 $ | 0,40 $ | |
qwen3.7-flash |
256K–1M | 0,20 $ | 0,80 $ | |
qwen3.5-flash |
jusqu'à 1M | 0,10 $ | 0,40 $ | |
qwen3-coder-flash |
jusqu'à 32K | 0,30 $ | 1,50 $ | Passe à 1,60 $ / 9,60 $ au-delà de 256K |
qwen3.8-27b (open-weight) |
jusqu'à 1M | 0,50 $ | 3,00 $ | |
qwen3-vl-plus |
jusqu'à 32K | 0,20 $ | 1,60 $ | Vision-langage |
Les nouveaux comptes à Singapour reçoivent 1 million de tokens gratuits par modèle, valables 90 jours à compter de l'activation ou de la sortie du modèle, selon la date la plus tardive. Alibaba Cloud précise que ce quota gratuit n'existe qu'à Singapour.
Déploiement Global, International ou États-Unis : pourquoi un même modèle a deux prix
Model Studio vend le même modèle sous différents périmètres de déploiement, et le prix dépend de l'endroit où s'exécute l'inférence :
| Modèle | Singapour (International) | Périmètre Global (régions US, UE, JP, HK) | Périmètre US (Virginie) |
|---|---|---|---|
qwen3.8-max |
2,00 $ / 6,00 $ | 1,65 $ / 4,951 $ | 2,00 $ / 6,00 $ |
qwen3.7-plus (≤256K, catalogue) |
0,40 $ / 1,60 $ | 0,276 $ / 1,101 $ | 0,40 $ / 1,60 $ |
qwen3.8-flash |
0,15 $ / 0,47 $ | 0,113 $ / 0,382 $ | 0,15 $ / 0,47 $ |
qwen3.7-flash (≤32K) |
0,030 $ / 0,130 $ | 0,028 $ / 0,110 $ | 0,030 $ / 0,130 $ |
Source : tarifs de Model Studio, 20 octobre 2026. Prix entrée / sortie par million de tokens.
Les prix du périmètre Global sont inférieurs d'environ 7 à 31 % à ceux des périmètres International ou US selon le modèle (7 % pour qwen3.7-flash, 17,5 % pour qwen3.8-max, 31 % pour l'entrée de qwen3.7-plus). La contrepartie concerne la résidence des données : le périmètre Global peut exécuter l'inférence hors de la région choisie. Si vous avez besoin d'un traitement uniquement aux États-Unis, utilisez le périmètre US et son tarif plus élevé. En périmètre Global, qwen3.7-plus bénéficie aussi, dans les régions de Hong Kong, Francfort, Virginie et Tokyo, d'une remise de nuit de 60 % à durée limitée (22:00–08:00 UTC+8) et de 20 % en journée.
Tarification par paliers : un long prompt change le prix de toute la requête
La règle de Model Studio : « Tous les tokens de la requête sont facturés au prix unitaire du palier correspondant. » Une requête qwen3.7-flash de 33K tokens d'entrée est entièrement facturée au palier 32K–256K (0,10 $), et non à 0,03 $ pour les 32K premiers tokens. Comme le second palier coûte 3,3 fois le premier, ramener un prompt de 33K à 31K tokens réduit le coût d'entrée d'environ 70 %.
Remises cache et batch
| Remise | Règle (Model Studio, oct. 2026) |
|---|---|
| Succès du cache de contexte | Facturé à 10 % du prix d'entrée standard (documentation du cache de contexte) |
| Création explicite du cache | Facturée à 125 % du prix d'entrée standard |
| Inférence batch | 50 % des prix temps réel en entrée et en sortie, sur les modèles éligibles (documentation de l'API batch) |
| Cumul | Les remises cache et batch ne se cumulent pas sur une même requête |
Le cache explicite est rentable dès le premier succès : vous payez 125 % une fois pour le créer, puis 10 % à chaque lecture au lieu de 100 %. Pour un prompt système de 20K tokens répété sur qwen3.8-max, le premier appel coûte 0,05 $ en entrée, puis chaque succès de cache coûte 0,004 $ au lieu de 0,04 $.
Exemple de coût
Un assistant RAG sur qwen3.8-max (Singapour) : 200 000 requêtes par mois, chacune avec 12K tokens d'entrée (dont un préfixe de 8K en cache) et 600 tokens de sortie.
| Poste | Calcul | Coût |
|---|---|---|
| Entrée non mise en cache | 800M tokens × 2,00 $ | 1 600 $ |
| Entrée en cache (10 %) | 1 600M tokens × 0,20 $ | 320 $ |
| Sortie | 120M tokens × 6,00 $ | 720 $ |
| Total | 2 640 $ |
Le même trafic sur qwen3.8-max en périmètre Global revient à environ 2 178 $. Sur qwen3.8-flash (Singapour), il revient à environ 200 $ (120 $ + 24 $ + 56,40 $), soit environ 13 fois moins cher, si Flash atteint votre niveau de qualité.
QWEN = {  # Singapore International list prices per 1M tokens, Oct 20, 2026
    "qwen3.8-max":   (2.00, 6.00),
    "qwen3.7-plus":  (0.40, 1.60),   # <=256K tier
    "qwen3.8-flash": (0.15, 0.47),
}

def qwen_cost(model, uncached, cached, output, batch=False):
    inp, out = QWEN[model]
    if batch:  # batch and cache discounts don't stack
        return (uncached + cached) / 1e6 * inp * 0.5 + output / 1e6 * out * 0.5
    return uncached / 1e6 * inp + cached / 1e6 * inp * 0.10 + output / 1e6 * out

print(qwen_cost("qwen3.8-max", 800e6, 1600e6, 120e6))   # 2640.0
Qwen face aux autres API de modèles
Prix catalogue par million de tokens, 20 octobre 2026. Les tarifs Qwen proviennent de Model Studio (Singapour) ; les autres, des pages modèles Flatkey en lien.
| Modèle | Entrée | Sortie |
|---|---|---|
qwen3.8-max |
2,00 $ | 6,00 $ |
gpt-6-sol |
2,00 $ | 10,00 $ |
claude-sonnet-5-5 |
2,00 $ | 10,00 $ |
kimi-k3 |
3,00 $ | 15,00 $ |
glm-5.3 |
1,40 $ | 4,40 $ |
qwen3.8-flash |
0,15 $ | 0,47 $ |
gpt-6-luna |
0,10 $ | 0,50 $ |
claude-haiku-5-5 |
0,10 $ | 0,50 $ |
qwen3.8-max égale GPT-6 Sol et Claude Sonnet 5.5 en entrée, mais facture la sortie 40 % moins cher. Pour une vue plus large, consultez le guide des coûts DeepSeek vs Qwen et la comparaison des prix des API d'IA.
Qwen via Flatkey : prix et accès avec une seule clé
Le catalogue Flatkey propose plusieurs modèles Qwen derrière le même endpoint compatible OpenAI que GPT, Claude, Gemini, DeepSeek et Kimi. Prix affichés sur les pages modèles Flatkey au 20 octobre 2026 :
| Modèle | Entrée Flatkey | Cache Flatkey | Sortie Flatkey | Prix catalogue affiché |
|---|---|---|---|---|
qwen3.8-max |
1,60 $ | 0,20 $ | 4,80 $ | 2 $ / 0,25 $ / 6 $ (−20 %) |
qwen3.7-plus |
0,32 $ | 0,064 $ | 1,28 $ | 0,40 $ / 0,08 $ / 1,60 $ (−20 %) |
qwen3.8-flash |
0,12 $ | 0,0128 $ | 0,376 $ | 0,15 $ / 0,016 $ / 0,47 $ (−20 %) |
qwen3.5-flash |
0,08 $ | n/d | 0,32 $ | 0,10 $ / 0,40 $ (−20 %) |
La page de qwen3.8-max indique aussi une disponibilité moyenne des fournisseurs de 98,9 % et une latence moyenne de 1,78 s sur les 30 derniers jours. Les prix et promotions Flatkey évoluent : consultez la page des tarifs avant de fixer un budget.
Comment appeler l'API Qwen (compatible OpenAI)
Option A : Model Studio en direct
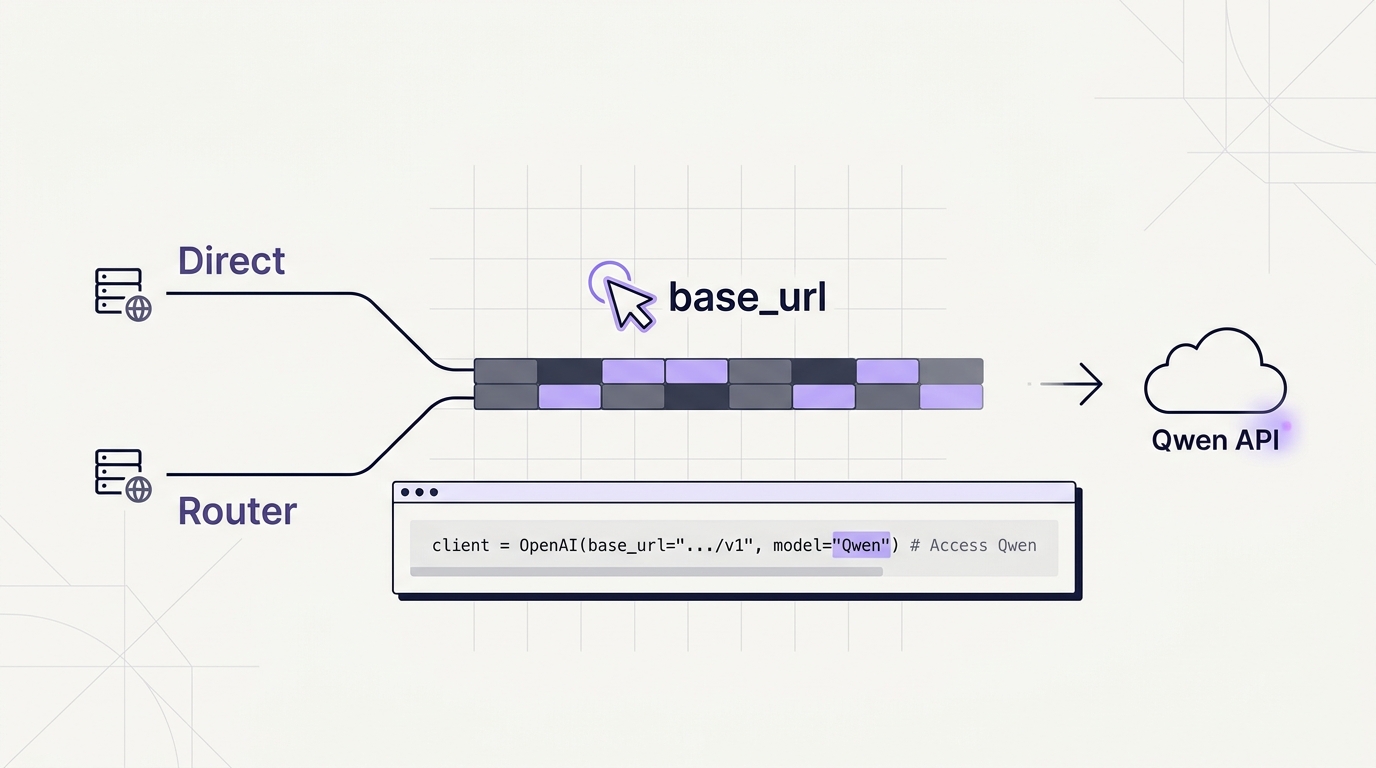
Créez une clé API dans la console Model Studio dans la même région que l'endpoint appelé. Une clé d'une autre région est refusée, et l'erreur ressemble à un simple échec d'authentification. L'URL de base dépend de la région et de l'espace de travail (documentation des URL de base). Par exemple, l'endpoint US (Virginie) est https://dashscope-us.aliyuncs.com/compatible-mode/v1.
curl https://dashscope-us.aliyuncs.com/compatible-mode/v1/chat/completions \
  -H "Authorization: Bearer $DASHSCOPE_API_KEY" -H "Content-Type: application/json" \
  -d '{"model": "qwen3.8-flash", "messages": [{"role": "user", "content": "Hello"}]}'
Option B : Flatkey (une clé pour Qwen et tous les autres modèles)
curl https://router.flatkey.ai/v1/chat/completions \
  -H "Authorization: Bearer $FLATKEY_API_KEY" -H "Content-Type: application/json" \
  -d '{"model": "qwen3.8-max", "messages": [{"role": "user", "content": "Write a haiku about caching."}]}'
import os
from openai import OpenAI

client = OpenAI(api_key=os.environ["FLATKEY_API_KEY"], base_url="https://router.flatkey.ai/v1")

# Same client, same key: switch Qwen tiers or providers by changing one string.
for model in ["qwen3.8-flash", "qwen3.8-max", "claude-sonnet-5-5"]:
    r = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "Classify: 'refund not received' -> billing|tech|other"}],
    )
    print(model, r.usage.prompt_tokens, r.usage.completion_tokens, r.choices[0].message.content)
import OpenAI from "openai";

const client = new OpenAI({ apiKey: process.env.FLATKEY_API_KEY, baseURL: "https://router.flatkey.ai/v1" });

async function withFallback(prompt) {
  for (const model of ["qwen3.8-max", "gpt-6-sol"]) {
    try {
      const r = await client.chat.completions.create({ model, messages: [{ role: "user", content: prompt }] });
      return `${model}: ${r.choices[0].message.content}`;
    } catch (err) {
      console.warn(model, "failed:", err.status);
    }
  }
  throw new Error("all routes failed");
}
console.log(await withFallback("Name three Qwen model tiers."));
Consultez le guide de démarrage Flatkey pour créer une clé, et le guide de l'URL de base de l'API OpenAI pour configurer le SDK.
Model Studio en direct ou un routeur ?
| Question | Model Studio en direct | Routeur Flatkey |
|---|---|---|
| Prix Qwen le plus bas possible | Périmètre Global plus remises de nuit | Tarif remisé fixe, sans choix de région |
| Contrôle de la résidence des données | Choix de la région et du périmètre | Renseignez-vous sur la région de routage |
| Nombre de clés | Une par région | Une pour tous les modèles pris en charge |
| Autres fournisseurs | Comptes séparés | Même clé et même solde |
| Fallback | À construire soi-même | Changer la chaîne model |
FAQ
Combien coûte l'API Qwen ?
Au 20 octobre 2026 (Singapour, International), qwen3.8-max coûte 2,00 $ en entrée et 6,00 $ en sortie par million de tokens, qwen3.7-plus est affiché à 0,40 $ / 1,60 $, qwen3.8-flash coûte 0,15 $ / 0,47 $ et qwen3.7-flash démarre à 0,03 $ / 0,13 $ pour les prompts jusqu'à 32K tokens.
Existe-t-il une offre gratuite pour l'API Qwen ?
Oui, uniquement dans la région de Singapour : 1 million de tokens gratuits par modèle, valables 90 jours. Les autres régions n'ont pas de quota gratuit.
Pourquoi un même modèle Qwen a-t-il plusieurs prix ?
Les prix dépendent de la région et du périmètre de déploiement. Le périmètre Global est moins cher, mais peut traiter les requêtes hors de la région choisie. Les périmètres International et US coûtent plus cher et gardent le traitement dans leur zone géographique.
Qwen propose-t-il un tarif batch ?
Oui. Les modèles éligibles coûtent 50 % du prix temps réel, en entrée comme en sortie. La remise batch ne se cumule pas avec les remises de cache.
L'API Qwen est-elle compatible OpenAI ?
Oui. Model Studio expose des endpoints compatible-mode/v1 (documentation de compatibilité OpenAI) : vous pouvez utiliser le SDK OpenAI en changeant l'URL de base, la clé et le nom du modèle. Vous pouvez aussi appeler les modèles Qwen via https://router.flatkey.ai/v1 de Flatkey.
Quel est le modèle Qwen le moins cher ?
qwen3.7-flash, à 0,03 $ en entrée et 0,13 $ en sortie par million de tokens (Singapour) pour les prompts jusqu'à 32K tokens. En périmètre Global, il coûte 0,028 $ / 0,110 $.
En résumé
Prévoyez 2 $ / 6 $ par million de tokens pour qwen3.8-max et 0,15 $ / 0,47 $ pour qwen3.8-flash aux prix catalogue de Singapour. Le périmètre Global est 7 à 31 % moins cher si la résidence des données le permet, et le batch divise le prix par deux. Revérifiez la page officielle des tarifs avant de vous engager. Pour utiliser Qwen aux côtés de GPT, Claude et Gemini avec une seule clé, passez par les routes Qwen de Flatkey.
Dernière mise à jour : 20 octobre 2026 · Flatkey Team. Prix en USD, cités d'après les sources officielles liées dans le texte.