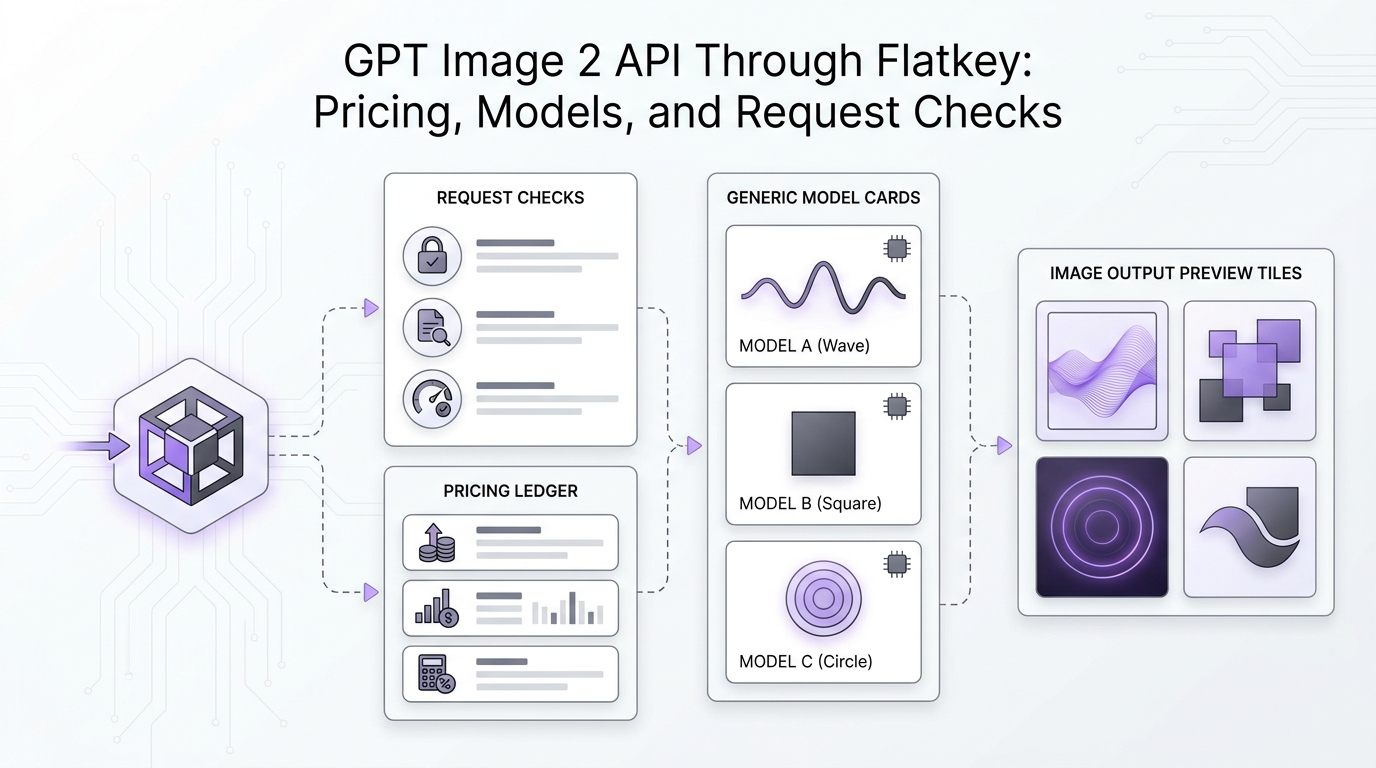
Se você estiver avaliando a API GPT Image 2 via Flatkey: preços, modelos e verificações de requisição, comece pela rota e pelas evidências de cobrança antes de copiar um snippet de geração para produção. GPT Image 2 é uma escolha de modelo, mas um fluxo de trabalho de imagem em produção também depende de suporte ao endpoint, configurações de saída, comportamento de retry, armazenamento, política de moderação e de saber se sua equipe consegue explicar o custo final por imagem aceita.
Este guia oferece às equipes de mídia e de produtos de IA uma forma prática de revisar o acesso à GPT Image 2 API via Flatkey. Ele usa uma verificação atual de preços da OpenAI, um snapshot ao vivo do feed de preços da Flatkey de 15 de setembro de 2026 e as páginas existentes de modelo e preços da Flatkey como pontos de verificação. Trate os blocos de código como modelos: execute seu próprio teste rápido com sua chave da Flatkey, sua linha exata de modelo e os requisitos reais de ativos antes de mover tráfego de produção.
Resposta Rápida: Preços e Verificações da GPT Image 2 API via Flatkey
Use o fluxo de trabalho API GPT Image 2 via Flatkey: preços, modelos e verificações de requisição nesta ordem:
- Confirme a linha exata de modelo que você planeja chamar:
gpt-image-2,gpt-image-2.5-flare,gpt-image-2.5-sunburst, ou uma linha com namespace exibida na sua conta. - Confirme os tipos de endpoint suportados da linha na Flatkey. Uma linha de modelo e um caminho de rota são fatos separados.
- Compare a tabela atual de preços de geração de imagens da OpenAI com a página de preços atual da Flatkey e os logs de uso.
- Execute uma requisição pequena pela rota confirmada da Flatkey antes de conectar um pipeline criativo em lote.
- Registre prompt, contagem de imagens de entrada, tamanho, qualidade, formato, contagem de retries, latência, status e custo para cada ativo aceito.
- Mantenha disponível a referência direta do provedor até que o comportamento da rota da Flatkey, a cobrança e o tratamento de armazenamento correspondam aos seus requisitos de produção.
Essa sequência importa porque o custo de geração de imagens não é apenas uma taxa de modelo destacada. Ele é o custo do resultado aceito depois que prompts inválidos, requisições falhadas, retries, rejeições humanas e trabalho de armazenamento/exportação são incluídos.
O que Mudou Desde as Notas Mais Antigas sobre GPT Image 2
A documentação atual de geração de imagens da OpenAI agora destaca gpt-image-2.5-sunburst em seus exemplos, enquanto a página de preços da OpenAI ainda inclui gpt-image-2 e linhas mais novas de GPT image. Isso significa que a questão prática já não é "o GPT Image 2 existe?" A questão prática é qual linha GPT image sua equipe deve direcionar, como ela é precificada hoje e quais configurações de requisição seu app tem permissão para alterar.
O feed de preços ao vivo da Flatkey em 15 de setembro de 2026 mostrou estas linhas da família GPT image:
| linha de pricing-feed da Flatkey | campo de status | tipos de endpoint exibidos | campos de preço expostos no feed | como usar esta evidência |
|---|---|---|---|---|
gpt-image-2 |
available |
image-generation, openai |
nenhum objeto display_pricing no feed público |
Trate como uma linha disponível e, em seguida, confirme os detalhes de cobrança na interface de pricing da Flatkey e nos logs de uso. |
gpt-image-2.5-flare |
campo de status em branco | image-generation, openai |
model_ratio: 2.5, completion_ratio: 6, marcado como New release |
Trate como uma linha candidata atual e, em seguida, verifique o acesso da conta e o preço visível atual antes do tráfego de produção. |
gpt-image-2.5-sunburst |
campo de status em branco | image-generation, openai |
model_ratio: 2.5, completion_ratio: 6, marcado como New release |
Trate como uma linha candidata atual, especialmente porque a documentação da OpenAI usa esta família em exemplos; ainda assim, execute as verificações de rota da Flatkey. |
A conclusão correta é deliberadamente restrita: a Flatkey atualmente expõe linhas de GPT image na superfície de modelo/pricing, mas sua decisão de produção deve ser baseada na linha exata, no caminho do endpoint e no rótulo de cobrança atual visível para a sua conta.
Verificações de Preço Antes de Roteiar o Tráfego da API GPT Image 2
Para o tema API GPT Image 2 via Flatkey: Pricing, Models, and Request Checks, use o preço como um fluxo de verificação, não como uma planilha estática copiada uma vez.
A página de preços da OpenAI listava o preço do GPT image em linhas separadas de imagem e texto quando este artigo foi atualizado. A página separava preços de entrada, entrada em cache e saída, e também expunha uma visualização de preço em lote para as linhas compatíveis. Essa estrutura importa porque prompts de imagem podem incluir texto, imagens de referência, edições e saída gerada, e essas partes podem não se encaixar em uma única suposição simples de "preço por imagem".
Antes do lançamento, preencha esta tabela com seus valores atuais:
| pergunta de preço | o que registrar | onde verificar |
|---|---|---|
| Qual linha de modelo o app vai chamar? | ID exato do modelo e qualquer namespace mostrado na Flatkey | diretório de modelos e página de pricing da Flatkey |
| Qual caminho de endpoint é usado? | /v1/images/generations, /v1/responses ou outro caminho confirmado |
suporte a endpoints da Flatkey mais a documentação do provedor |
| Quais componentes de preço se aplicam? | entrada de imagem, entrada de texto, entrada em cache, saída de imagem, desconto em lote, taxa de requisição se exibida | pricing da OpenAI, pricing da Flatkey, logs de uso da Flatkey |
| Qual é o valor de uma imagem aceita? | gasto total dividido pelos ativos aprovados, não apenas pelos ativos retornados | QA criativa ou dados de aceitação em produção |
| O que cria custo oculto? | retries, saídas rejeitadas, finais grandes demais, imagens de referência evitáveis, reexecuções em lote | telemetria da aplicação e painel de uso |
A unidade de orçamento mais segura é custo por imagem aceita:
cost_per_accepted_image =
  (all generation spend + retry spend + review correction spend)
  / accepted_images
Isso mantém a revisão de preços da API GPT Image 2 vinculada ao ativo que sua equipe realmente entrega.
Seleção de Modelo: GPT Image 2, GPT Image 2.5 Flare ou GPT Image 2.5 Sunburst
Não selecione um modelo apenas porque o nome é mais recente. Use um teste de carga de trabalho.
| Carga de trabalho | Primeira pergunta sobre o modelo | Configuração da requisição a fixar | Condição de aprovação |
|---|---|---|---|
| Visuais para blog e redes sociais | O modelo segue as restrições de layout, assunto e segurança da marca? | size, quality, output_format |
Um revisor aprova o ativo sem uma regeneração completa. |
| Imagens conceituais de produto | O modelo preserva a estrutura do objeto e reduz detalhes de interface inventados? | modelo de prompt, política de imagem de referência | A imagem comunica o conceito sem alegações enganosas de interface. |
| Variantes criativas para e-commerce | O modelo cria variantes úteis sem se afastar do produto? | contagem de imagens de entrada, fundo, formato | A taxa de variantes aprovadas é alta o suficiente para superar o custo de produção manual. |
| Diagramas editoriais | A saída permanece abstrata e legível sem logotipos falsos ou dados falsos? | regras de prompt sem logotipo, restrições de composição | O visual dá suporte ao artigo sem fazer alegações não sustentadas. |
| Atualizações em lote | A rota se mantém estável em muitos trabalhos pequenos? | tamanho do lote, política de retry, timeout | As taxas de falha e retry permanecem dentro do seu limite de lançamento. |
Para muitas equipes, gpt-image-2 continua sendo a linha estável a avaliar porque é explícito e está disponível no feed de preços da Flatkey. gpt-image-2.5-flare e gpt-image-2.5-sunburst valem o teste quando sua conta os mostrar e você precisar de qualidade da geração atual. Use o mesmo conjunto de prompts entre os candidatos para que a comparação seja sobre desempenho da rota, saída aprovada e custo.
Verificações de Requisição para a API GPT Image 2 Através da Flatkey
Execute estas verificações antes de conectar usuários de produção, tarefas agendadas de conteúdo ou geração criativa de alto volume.
| Verificação | Condição de aprovação | Modo de falha |
|---|---|---|
| Autenticação | A chave Flatkey funciona apenas a partir do ambiente pretendido. | Uma chave de teste local vaza para produção, ou uma chave de produção é usada em notebooks. |
| Linha do modelo | O modelo da requisição corresponde exatamente à linha do Flatkey selecionada para o teste. | Uma linha legada, alias ou uma linha de outro provedor é chamada por engano. |
| Suporte ao endpoint | A linha expõe o caminho que seu código está chamando. | Um corpo da API de Images é enviado para um endpoint de texto, ou uma requisição de Responses é enviada para uma rota não suportada. |
| Tratamento da saída | Sua aplicação decodifica, armazena e disponibiliza corretamente as imagens geradas. | A aplicação assume uma URL hospedada de longa duração quando a resposta retorna bytes de imagem. |
| Moderação e política | Prompts inseguros ou fora do briefing falham de forma adequada. | Uma geração com falha se transforma em um ciclo de retry caro ou em um estado de usuário corrompido. |
| Controles de tamanho e qualidade | As configurações de rascunho e final são separadas. | Jobs de pré-visualização são executados por engano com as configurações de renderização final. |
| Política de retry | As tentativas de repetição são limitadas e registradas. | Um job criativo com falha dispara gerações repetidas de alto custo. |
| Registro de uso | Modelo, status, latência, configurações e custo aparecem nos logs. | O financeiro vê o gasto, mas não consegue associá-lo a campanhas, usuários ou ativos aceitos. |
Essas verificações de requisição são o valor central de usar um gateway para trabalho com imagens. Uma integração direta com o provedor pode ser mais simples para uma rota, mas um gateway se torna útil quando a geração de imagens fica ao lado de chamadas de texto, vídeo, agentes e ferramentas que precisam de uma única visão operacional.
Modelo: base direta da OpenAI
Use uma base direta do provedor para entender o comportamento esperado da resposta antes de comparar a rota do Flatkey.
curl https://api.openai.com/v1/images/generations \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-image-2",
    "prompt": "Create a clean product concept image for a usage dashboard.",
    "size": "1536x1024",
    "quality": "medium",
    "output_format": "png"
  }'
Registre o status da resposta, a latência, os bytes de saída, o resultado da moderação e quaisquer campos de uso. Não julgue o Flatkey até que a base direta e o teste roteado usem o mesmo prompt, as mesmas configurações e os mesmos critérios de aceitação.
Modelo: teste rápido da rota Flatkey
Depois que sua conta Flatkey confirmar suporte à geração de imagens para a linha selecionada, execute um teste mínimo por meio do roteador Flatkey.
curl https://router.flatkey.ai/v1/images/generations \
  -H "Authorization: Bearer $FLATKEY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-image-2",
    "prompt": "Create a clean product concept image for a usage dashboard.",
    "size": "1536x1024",
    "quality": "medium",
    "output_format": "png"
  }'
Se a linha selecionada mostrar apenas suporte openai ou a documentação da sua conta apontar para outra rota, consulte o suporte ou verifique seu painel antes de colocar em produção. Não infira suporte ao endpoint apenas com base no nome do modelo.
Para o código da aplicação, centralize a URL base e o ID do modelo:
const FLATKEY_BASE_URL = "https://router.flatkey.ai/v1";

async function generateImage({ apiKey, model, prompt }) {
  const response = await fetch(`${FLATKEY_BASE_URL}/images/generations`, {
    method: "POST",
    headers: {
      Authorization: `Bearer ${apiKey}`,
      "Content-Type": "application/json"
    },
    body: JSON.stringify({
      model,
      prompt,
      size: "1536x1024",
      quality: "medium",
      output_format: "png"
    })
  });

  if (!response.ok) {
    throw new Error(`Image route failed with ${response.status}`);
  }

  return response.json();
}
Isso mantém a rota da Flatkey reversível. Você pode alternar a linha do modelo, comparar testes diretos e roteados e evitar espalhar configurações de geração de imagens pelo produto.
Scorecard de produção para equipes de mídia
Use esta scorecard após o primeiro smoke test passar.
| Métrica | Pergunta-alvo | Por que isso importa |
|---|---|---|
| Taxa de imagens aceitas | Quantas imagens retornadas sobrevivem à revisão? | Este é o elo entre a qualidade do modelo e o custo real. |
| Custo por imagem aceita | Quanto custou cada ativo entregue após retries e rejeições? | Evita otimismo no orçamento. |
| Latência P95 | Quanto tempo leva a tarefa normal mais lenta? | Fluxos criativos frequentemente travam em ciclos de revisão. |
| Taxa de retry | Com que frequência o app gera novamente por causa de erros ou saídas ruins? | Retries podem esconder o preço real de uma rota. |
| Taxa de aprovação de template de prompt | Quais prompts funcionam sem reparo manual? | Templates estáveis escalam melhor do que prompts pontuais. |
| Taxa de sucesso de armazenamento | Os bytes gerados são armazenados, redimensionados e servidos corretamente? | APIs de imagem frequentemente retornam ativos que seu app precisa persistir. |
| Auditabilidade | Você consegue mapear o gasto por usuário, campanha, workspace e modelo? | Finanças e operações precisam de um livro-razão útil. |
A Flatkey é uma boa opção quando essas métricas precisam viver ao lado de outros usos de modelo e ferramenta. Se sua equipe executa apenas um fluxo ocasional de imagens e já tem a cobrança direta do provedor sob controle, o acesso direto da OpenAI pode ser suficiente.
Onde a Flatkey se encaixa
O posicionamento da Flatkey é uma chave, um saldo, uma fatura, um roteador compatível com OpenAI e acesso a muitos modelos e ferramentas oficiais. Para cargas de trabalho com GPT image, isso importa quando seu pipeline criativo faz parte de uma pilha de IA mais ampla:
- geração de imagens para visuais de campanha;
- geração de texto para títulos, legendas e metadados;
- comparações de modelos entre GPT Image, modelos de imagem Gemini, fluxos de trabalho no estilo Imagen e modelos de vídeo;
- análise de uso por workspace, app, campanha ou ambiente;
- governança em torno de chaves, allowlists de modelos e responsabilidade orçamentária.
Para contexto mais amplo, mantenha estas referências internas abertas:
- GPT Image vs Imagen API para unidades de preços de imagem entre provedores e verificações de requisição.
- GPT Image vs Gemini Image API para questões de seleção de modelo e roteamento.
- Image Generation API: A Practical Guide for Teams para métricas de fluxo de trabalho.
- AI Model Catalog Guide para revisão de provedor, endpoint e campos de preço.
- preços da Flatkey e diretório de modelos da Flatkey para verificações atuais da plataforma.
Lista final de verificação da API GPT Image 2
Antes de mover tráfego real pelo fluxo de trabalho API GPT Image 2 via Flatkey: Pricing, Models, and Request Checks, confirme:
- A linha atual da Flatkey existe e está disponível para sua conta.
- A linha oferece suporte ao caminho do endpoint que sua aplicação chamará.
- A página de preços atual da OpenAI e a página de preços atual da Flatkey foram ambas revisadas.
- Seu orçamento usa custo por imagem aceita, não apenas o preço nominal de saída.
- As configurações de rascunho e de renderização final estão separadas no código.
- As tentativas de повторar têm um número máximo e ficam visíveis nos logs.
- As saídas geradas são armazenadas pela sua aplicação com metadados de campanha e modelo.
- Uma linha de base direta do provedor permanece disponível até que o comportamento roteado seja comprovado.
A decisão API GPT Image 2 via Flatkey: Pricing, Models, and Request Checks deve terminar com uma implantação pequena e mensurável, e não com uma preferência teórica de modelo. Escolha a linha, verifique a rota, teste o corpo da requisição e compare a economia por imagem aceita antes de escalar.
Perguntas Frequentes
O GPT Image 2 ainda vale a pena testar se existirem linhas do GPT Image 2.5?
Sim. O GPT Image 2 ainda é útil para testar quando é a linha que sua conta expõe de forma clara e seu fluxo de trabalho valoriza roteamento previsível. O GPT Image 2.5 Flare ou Sunburst podem ser candidatos melhores para testes de qualidade mais recentes, mas ainda precisam das mesmas verificações de rota, preços e logs de uso da Flatkey.
Posso usar o SDK da OpenAI com a Flatkey para geração de imagens?
Use a compatibilidade do SDK somente depois de confirmar a linha selecionada da Flatkey e o caminho do endpoint. Para muitos fluxos de trabalho, a configuração importante é a URL base do roteador, mas os endpoints de geração de imagem e o tratamento de resposta ainda precisam de um teste rápido.
O que o financeiro deve comparar primeiro?
O financeiro deve comparar o custo por imagem aceita. O preço do modelo é apenas um componente. Saídas rejeitadas, novas tentativas, tempo de revisão e trabalho de armazenamento/exportação determinam o custo prático de um pipeline criativo.
Toda requisição da GPT Image 2 API deve usar qualidade final?
Não. Separe as configurações de rascunho, pré-visualização e renderização final. A maioria das equipes desperdiça orçamento quando cada prompt exploratório usa o mesmo tamanho e as mesmas configurações de qualidade do entregável final.
Quando devo escolher a Flatkey em vez do acesso direto à OpenAI?
Escolha a Flatkey quando o trabalho com imagens GPT estiver dentro de um sistema multi-modelo ou multi-ferramenta que precise de uma única chave, faturamento compartilhado, logs de uso e verificações de rota. O acesso direto pode ser mais simples quando você usa um provedor, um modelo e uma única superfície de faturamento.