Cómo usar una API de IA unificada en 2026
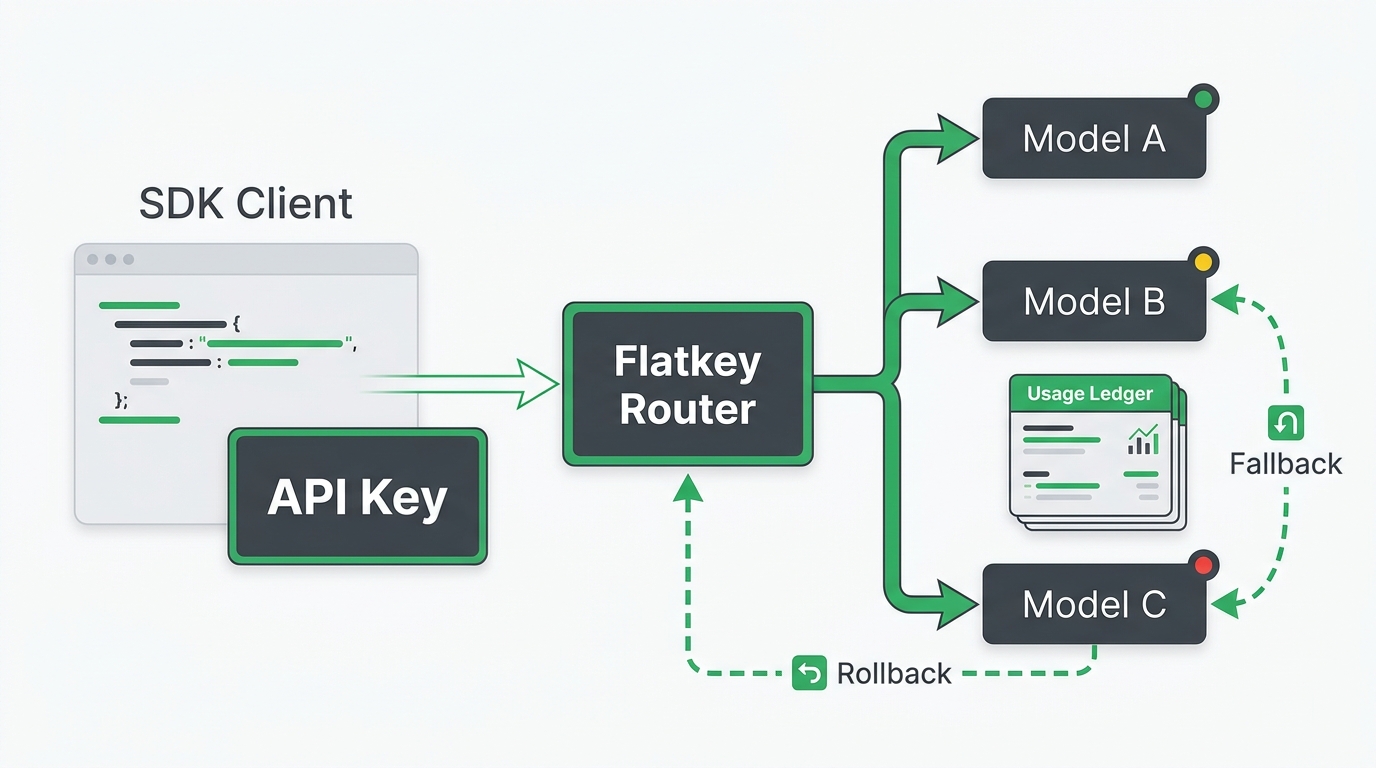
Una API de IA unificada permite que tu aplicación llame a varios proveedores de modelos de IA a través de una sola capa de acceso, en lugar de integrar cada proveedor por separado. En 2026, eso normalmente significa una sola clave API, una única URL base compatible con OpenAI, un catálogo de modelos y un solo lugar para revisar el uso, el coste y los fallos.
Eso suena simple, pero los detalles de implementación importan. Una API de IA unificada solo es útil si mantiene intacto tu flujo de trabajo actual con el SDK, hace más seguro el cambio de modelo y ofrece a ingeniería y finanzas la misma vista de lo que ocurrió después de cada solicitud.
Esta guía muestra un camino práctico de implementación: configura la clave, apunta un cliente compatible con OpenAI a un endpoint unificado, elige un modelo, ejecuta una primera solicitud, verifica el registro de uso y luego decide qué debería pasar a la capa unificada y qué debería seguir directamente con un proveedor.
Respuesta rápida: el flujo de trabajo de la API de IA unificada
Usa una API de IA unificada cuando tu equipo necesite probar o ejecutar varios modelos sin crear una nueva integración, un historial de facturación y un proceso de gestión de claves para cada proveedor.
El flujo de trabajo básico es:
- Crea una sola clave API para el gateway unificado.
- Guárdala como una variable de entorno.
- Configura la URL base de tu cliente en el endpoint del gateway.
- Envía una solicitud normal de chat, respuestas, embeddings, imagen o vídeo.
- Elige el modelo con el parámetro
model. - Revisa los registros de uso para ver tokens, modelo, coste, estado y latencia.
- Añade reglas de fallback, cuota y enrutamiento solo después de que la primera ruta sea observable.
Para Flatkey, la URL base REST compatible con OpenAI es:
https://router.flatkey.ai/v1El punto importante no es que todos los modelos se comporten de forma idéntica. El punto importante es que tu aplicación obtenga una sola superficie de integración que pueda revisarse, mientras sigue eligiendo el modelo adecuado para cada carga de trabajo.
Cuándo tiene sentido una API de IA unificada
Una API de IA unificada es especialmente útil cuando tu equipo ya siente la sobrecarga de la dispersión de proveedores.
Úsala cuando:
| Situación | Por qué ayuda una API de IA unificada |
|---|---|
| Pruebas GPT, Claude, Gemini, DeepSeek, Qwen o modelos de imagen/vídeo en el mismo producto | Los cambios de modelo pueden ocurrir detrás de una sola capa de integración. |
| Ya usas la estructura del SDK de OpenAI | La migración puede empezar con un cambio de URL base y de clave en lugar de una reescritura completa. |
| Finanzas pide una sola vista de uso y facturación | Las solicitudes pueden revisarse desde un solo panel en lugar de varias consolas de proveedores. |
| La plataforma necesita claves y cuotas por entorno | La propiedad de las claves, los límites de gasto y las reglas de rutas pueden centralizarse. |
| La fiabilidad importa entre proveedores | El fallback y las comprobaciones de salud pueden gestionarse como una política operativa en lugar de código ad hoc. |
Mantén cuentas directas con proveedores cuando un flujo de trabajo dependa de una función nativa del proveedor que el gateway unificado no exponga, cuando compras requiera un contrato directo o cuando tu producto realmente use solo un proveedor.
Paso 1: Elige la carga de trabajo antes de elegir el proveedor
No empieces preguntando: "¿Cuál es el mejor modelo?" Empieza anotando la carga de trabajo.
Usa una tabla pequeña como esta:
| Carga de trabajo | Riesgo para el usuario final | Candidatos de modelo | Debe verificar |
|---|---|---|---|
| Respuesta de atención al cliente | Explicación incorrecta de la política | Modelo de chat rápido, modelo de razonamiento | Precisión, latencia, costo por ticket resuelto |
| Asistente de revisión de código | Error no detectado o comentarios ruidosos | Modelo de codificación, modelo de razonamiento | Tasa de detección de errores, calidad de las ediciones, comportamiento de fallback |
| Generación de imágenes de producto | Salida creativa deficiente | Modelo de generación de imágenes | Costo por imagen aceptada, controles de prompt, ruta de moderación |
| Agente de investigación | Respuesta lenta o incompleta | Modelo de razonamiento más herramientas | Acceso a herramientas, trazabilidad, manejo de timeouts |
Este paso evita el error más común de una API de IA unificada: tratar el gateway como un selector aleatorio de modelos. Una implementación sólida sigue mapeando las cargas de trabajo a responsables, controles de calidad y reglas de fallback.
Paso 2: Crea y almacena la clave API
Cree la clave en la consola del gateway y guárdela fuera del control de código fuente.
Para Flatkey, cree una clave en la consola y guárdela como FLATKEY_API_KEY:
export FLATKEY_API_KEY="sk-fk-your-key"Use claves separadas para desarrollo, staging y producción. Eso le proporciona registros más limpios y una revocación más segura si una clave se filtra.
Nomenclatura recomendada para las claves:
| Entorno | Ejemplo de nombre de clave | Propósito |
|---|---|---|
| Desarrollo | dev-local-ai-tests | Pruebas locales con límites de gasto bajos |
| Staging | staging-model-routing | Validación previa a producción |
| Producción | prod-customer-chat | Tráfico real de usuarios |
| Flujo de trabajo del agente | prod-research-agent | Llamadas autónomas o programadas del agente |
Una API de IA unificada debería reducir la dispersión de credenciales, no ocultarla. Mantenga explícita la propiedad de las claves.
Paso 3: Haz la primera solicitud con cURL
Empiece con cURL antes de cambiar su aplicación. Demuestra que la clave, el endpoint, el ID del modelo y la forma de la solicitud funcionan de manera independiente de su framework.
curl https://router.flatkey.ai/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $FLATKEY_API_KEY" \
  -d '{
    "model": "gpt-4o-mini",
    "messages": [
      {
        "role": "user",
        "content": "Write one sentence explaining what a unified AI API does."
      }
    ],
    "max_tokens": 120
  }'
Antes de usar un modelo en producción, confirme el ID exacto del modelo en el directorio de modelos actual o en la lista de modelos de la API. La disponibilidad de modelos, los alias, los precios y los endpoints compatibles pueden cambiar rápidamente en el mercado de IA.
Paso 4: Cambia la URL base del SDK de OpenAI
Muchos equipos pueden probar una API de IA unificada con el SDK de OpenAI para Python o Node.js que ya usan. La migración principal es la clave API más la URL base.
Python:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["FLATKEY_API_KEY"],
    base_url="https://router.flatkey.ai/v1",
)

response = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[
        {"role": "user", "content": "Resume este feedback de producto en tres viñetas."}
    ],
    max_tokens=300,
)

print(response.choices[0].message.content)
Node.js:
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.FLATKEY_API_KEY,
  baseURL: "https://router.flatkey.ai/v1",
});

const response = await client.chat.completions.create({
  model: "gpt-4o-mini",
  messages: [
    { role: "user", content: "Resume este feedback de producto en tres viñetas." },
  ],
  max_tokens: 300,
});

console.log(response.choices[0].message.content);
El objetivo no es eliminar todas las diferencias entre proveedores. El objetivo es mantener estable el wrapper de la aplicación mientras la elección del modelo pasa a ser un parámetro controlado.
Paso 5: Elige modelos con una política, no con una suposición
Una API de IA unificada facilita el cambio de modelo. Eso puede ayudar o perjudicar según si defines reglas de selección.
Usa una tabla de políticas sencilla:
| Ruta | Modelo principal | Modelo de respaldo | Regla de aprobación |
|---|---|---|---|
support_summary | Modelo de chat rápido y de bajo costo | Modelo de razonamiento más grande | El propietario del producto puede cambiarlo después de que pase una muestra de QA |
code_review | Modelo enfocado en código | Modelo de razonamiento general | Se requiere aprobación del líder de ingeniería |
image_creative | Modelo de imagen | Sin respaldo automático | El líder creativo aprueba la calidad de salida |
research_agent | Modelo de razonamiento | Modelo de menor latencia | Se requiere aprobación de operaciones si el respaldo cambia la profundidad de la respuesta |
El nombre del modelo nunca debería ser una cadena mágica dispersa por toda la base de código. Ponlo en la configuración, asócialo con una carga de trabajo y registra tanto el modelo solicitado como el modelo final utilizado.
Paso 6: Verifica los registros de uso después de la primera llamada
No des por terminada la migración cuando la API devuelva 200. Revisa el rastro de uso y costes.
Para Flatkey, el panel de Usage muestra campos a nivel de solicitud como la marca de tiempo, el modelo, los tokens de entrada, los tokens de salida, el coste deducido, la clave de API y el estado. Después de tu primera solicitud, verifica:
| Verificación | Lo que deberías ver |
|---|---|
| Modelo | El ID del modelo que solicitaste o el modelo final enroutado |
| Tokens | Los recuentos de tokens de entrada y salida |
| Coste | El importe deducido del saldo por esa solicitud |
| Clave | La clave de entorno utilizada por la solicitud |
| Estado | Estado de éxito, error o límite de velocidad |
| Latencia | Si la primera prueba está dentro del rango esperado |
Aquí es donde una API de IA unificada se vuelve útil operativamente. Producto, ingeniería y finanzas pueden inspeccionar el mismo rastro de solicitudes en lugar de reconciliar capturas de pantalla de varios paneles de proveedores.
Paso 7: Añade un respaldo solo después de poder medirlo
El fallback no es automáticamente bueno. Es bueno cuando recupera solicitudes sin reducir la calidad de la respuesta, romper políticas o ocultar costos.
Antes de habilitar el fallback, defina:
| Pregunta | Por qué importa |
|---|---|
| ¿Qué errores activan el fallback? | El límite de tasa, el tiempo de espera, la caída del proveedor y los fallos de política de contenido son eventos distintos. |
| ¿Qué modelo está permitido como respaldo? | Un modelo de fallback puede cambiar la calidad, la latencia, el costo o la postura de cumplimiento. |
| ¿Quién aprueba la ruta? | La política de fallback es un comportamiento de producción, no solo una comodidad para desarrolladores. |
| ¿Qué se registra? | Necesita el modelo solicitado, el modelo final, el recuento de reintentos, el estado final, los tokens, el costo y la latencia. |
| ¿Cuál es el plan de reversión? | Si el fallback provoca respuestas deficientes, necesita una forma rápida de desactivarlo. |
La documentación de routers de código abierto y comerciales a menudo enfatiza el enrutamiento, el orden de los proveedores, el balanceo de carga y el comportamiento de fallback. Esas funciones importan, pero su despliegue debería medir la tasa de salida aceptada, el costo por salida aceptada, la latencia p95 y la tasa de discrepancia de fallback.
Paso 8: Conserva las excepciones directas del proveedor
La mejor implementación de una API de IA unificada sigue permitiendo excepciones.
Use acceso directo al proveedor cuando:
- una función específica del modelo no está expuesta por la capa unificada
- el proveedor requiere un formato de solicitud nativo para una función crítica para el lanzamiento
- las políticas de compras, cumplimiento o residencia de datos requieren una ruta directa
- un equipo necesita registros o controles nativos del proveedor para un flujo de trabajo regulado
- la ruta unificada no supera su prueba de aceptación de calidad, latencia o costo
Esto hace que la arquitectura sea creíble. La capa unificada se convierte en el valor predeterminado para el trabajo repetible con múltiples modelos, no en una abstracción forzada para cada posible solicitud.
Lista de verificación de implementación
Use esta lista de verificación antes de mover una carga de trabajo detrás de una API de IA unificada:
- El propietario de la carga de trabajo está identificado.
- El modelo principal y el modelo de respaldo están documentados.
- La clave de API se almacena en un gestor de secretos o en una variable de entorno.
- Las claves de desarrollo, staging y producción están separadas.
- La URL base está configurada en un solo envoltorio de cliente.
- El ID del modelo está impulsado por configuración, no codificado de forma fija en todos los archivos.
- La primera solicitud cURL se completa correctamente.
- La solicitud del SDK se completa correctamente en staging.
- Los registros de uso muestran modelo, tokens, costo, clave, estado y latencia.
- El costo por salida aceptada se mide frente a la ruta directa del proveedor.
- El comportamiento de fallback se prueba con un caso de fallo no productivo.
- El plan de reversión está documentado.
Qué medir en los primeros 30 días
El primer mes debería responder si la API de IA unificada mejora las operaciones, no solo si las solicitudes se ejecutan.
Realice un seguimiento de:
| Métrica | Por qué importa |
|---|---|
| Tasa de salida aceptada | Mide las respuestas utilizables, no solo las llamadas HTTP exitosas |
| Costo por salida aceptada | Normaliza el precio en función de la calidad y los reintentos |
| Latencia p95 por carga de trabajo | Evita que una ruta oculte una experiencia de usuario lenta |
| Tasa de recuperación de fallback | Indica si el fallback realmente salva solicitudes |
| Tasa de discrepancia del fallback | Detecta respuestas de respaldo que pasan técnicamente pero fallan en calidad |
| Gasto por clave por entorno | Separa los experimentos de desarrollo del uso en producción |
| Tiempo para añadir un nuevo modelo | Mide si la capa unificada reduce la fricción operativa |
Si esas métricas mejoran, amplía la capa unificada a otra carga de trabajo. Si no lo hacen, mantén la ruta directa del proveedor para ese flujo de trabajo y usa el resultado como una restricción para la siguiente prueba.
Encaje de Flatkey: una clave, una URL base, una superficie de revisión
Flatkey está diseñado para equipos que quieren usar una sola clave y una sola URL base compatible con OpenAI en muchos flujos de trabajo de modelos y herramientas. La documentación actual de Flatkey describe acceso a la API REST en https://router.flatkey.ai/v1, autenticación Bearer, compatibilidad con el SDK de OpenAI, selección de modelo mediante el parámetro model y registros de uso para revisar modelo, token, latencia, costo, clave y estado.
Eso convierte a Flatkey en una opción práctica cuando tu equipo quiere el flujo de trabajo de la API de IA unificada sin reescribir cada envoltorio de solicitud. Empieza con una sola carga de trabajo en staging, valida el modelo exacto en el directorio de modelos actual, revisa el registro de uso y luego decide si el enrutamiento, el fallback, las cuotas o los controles de equipo deberían venir después.
Para detalles de implementación relacionados, lee la guía rápida de la API de Flatkey, la lista de verificación de migración de una puerta de enlace de API compatible con OpenAI y el marco de evaluación de herramientas de la API de enrutamiento de IA.
Preguntas frecuentes
¿Qué es una API de IA unificada?
Una API de IA unificada es una capa de acceso para llamar a múltiples modelos o herramientas de IA compatibles mediante autenticación compartida, configuración de endpoint, selección de modelo y revisión de uso.
¿Una API de IA unificada es lo mismo que un gateway de API de IA?
Se solapan. Una puerta de enlace de API de IA suele poner énfasis en el enrutamiento, los controles, el fallback y la observabilidad. Una API de IA unificada enfatiza una sola superficie de integración entre múltiples modelos o proveedores. Muchos productos combinan ambas cosas.
¿Puedo usar una API de IA unificada con el SDK de OpenAI?
Sí, cuando la puerta de enlace expone una API compatible con OpenAI. En ese caso, normalmente configuras la clave de API, cambias la URL base del SDK y eliges el modelo de destino con el parámetro model.
¿Una API de IA unificada elimina las diferencias específicas de cada proveedor?
No. El comportamiento del modelo, los límites de contexto, los parámetros compatibles, la latencia, los precios y el comportamiento de las políticas aún pueden diferir. Una API de IA unificada reduce la integración y la sobrecarga operativa, pero aun así necesitas control de calidad específico para cada carga de trabajo.
¿Cuándo no debería usar una API de IA unificada?
Evite mover un flujo de trabajo detrás de una capa unificada cuando dependa de funciones nativas del proveedor, una contratación directa y estricta con el proveedor, controles de cumplimiento especializados u optimizaciones de un solo proveedor que la puerta de enlace no pueda exponer.
Conclusión
Una API de IA unificada es útil en 2026 cuando ofrece a su equipo una forma más limpia de ejecutar múltiples modelos de IA, controlar claves, inspeccionar el uso y cambiar rutas sin reescribir el código de la aplicación. La implementación más segura es limitada: elija una carga de trabajo, cambie la URL base en el entorno de pruebas, verifique el seguimiento de la solicitud, mida la calidad y el costo, y luego amplíe solo donde la capa unificada reduzca claramente el trabajo operativo.
Si está evaluando Flatkey para este flujo de trabajo, comience con el directorio de modelos, la página de precios y el inicio rápido de la API, luego ejecute una solicitud de prueba a través de https://router.flatkey.ai/v1 antes de cambiar el tráfico de producción.