Como Usar uma API de IA Unificada em 2026
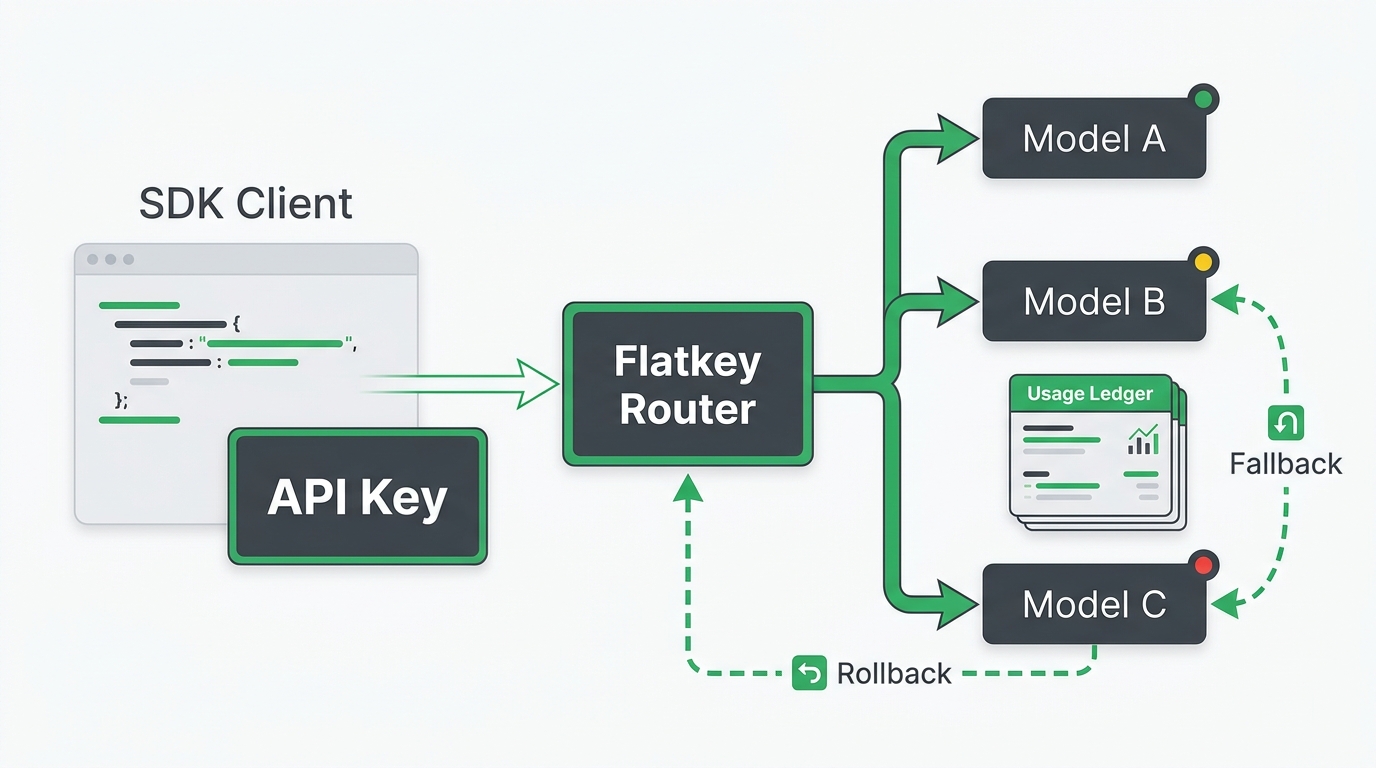
Uma API de IA unificada permite que sua aplicação chame vários provedores de modelos de IA por meio de uma única camada de acesso, em vez de integrar cada provedor separadamente. Em 2026, isso geralmente significa uma chave de API, uma URL base compatível com OpenAI, um catálogo de modelos e um único lugar para revisar uso, custo e falhas.
Parece simples, mas os detalhes de implementação importam. Uma API de IA unificada só é útil se mantiver intacto o seu fluxo de trabalho atual com SDK, tornar a troca de modelos mais segura e oferecer às equipes de engenharia e finanças a mesma visão do que aconteceu após cada solicitação.
Este guia mostra um caminho prático de implementação: configurar a chave, apontar um cliente compatível com OpenAI para um endpoint unificado, escolher um modelo, executar a primeira solicitação, verificar o log de uso e então decidir o que deve ficar atrás da camada unificada e o que deve continuar direto com um provedor.
Resposta Rápida: O Fluxo de Trabalho da API de IA Unificada
Use uma API de IA unificada quando sua equipe precisar testar ou executar vários modelos sem criar uma nova integração, trilha de cobrança e processo de gerenciamento de chaves para cada provedor.
O fluxo de trabalho básico é:
- Crie uma chave de API para o gateway unificado.
- Armazene-a como uma variável de ambiente.
- Defina a URL base do seu cliente para o endpoint do gateway.
- Envie uma solicitação normal de chat, respostas, embeddings, imagem ou vídeo.
- Escolha o modelo com o parâmetro
model. - Verifique os logs de uso quanto a tokens, modelo, custo, status e latência.
- Adicione regras de fallback, cota e roteamento somente depois que o primeiro caminho estiver observável.
Para a Flatkey, a URL base REST compatível com OpenAI é:
https://router.flatkey.ai/v1O ponto importante não é que todo modelo se comporte de forma idêntica. O ponto importante é que sua aplicação tenha uma única superfície de integração passível de revisão, ao mesmo tempo em que continua escolhendo o modelo certo para cada carga de trabalho.
Quando uma API de IA Unificada Faz Sentido
Uma API de IA unificada é mais forte quando sua equipe já sente o peso da proliferação de provedores.
Use uma quando:
| Situação | Por que uma API de IA unificada ajuda |
|---|---|
| Você testa GPT, Claude, Gemini, DeepSeek, Qwen ou modelos de imagem/vídeo no mesmo produto | As mudanças de modelo podem acontecer por trás de uma única camada de integração. |
| Você já usa a estrutura do SDK da OpenAI | A migração pode começar com uma alteração de URL base e chave, em vez de uma reescrita completa. |
| O financeiro pede uma única visão de uso e cobrança | As solicitações podem ser revisadas em um único painel em vez de vários consoles de provedores. |
| A plataforma precisa de chaves e cotas por ambiente | A propriedade das chaves, os limites de gasto e as regras de roteamento podem ser centralizados. |
| A confiabilidade importa entre provedores | Fallback e verificações de integridade podem ser tratados como uma política operacional em vez de código ad hoc. |
Mantenha contas diretas de provedores quando um fluxo de trabalho depender de um recurso nativo do provedor que o gateway unificado não expõe, quando a área de compras exigir um contrato direto ou quando seu produto realmente usar apenas um provedor.
Etapa 1: Escolha a Carga de Trabalho Antes de Escolher o Provedor
Não comece perguntando: "Qual modelo é o melhor?" Comece anotando a carga de trabalho.
Use uma pequena tabela como esta:
| Carga de trabalho | Risco para o usuário final | Candidatos de modelo | Deve verificar |
|---|---|---|---|
| Resposta de suporte ao cliente | Explicação incorreta da política | Modelo de chat rápido, modelo de raciocínio | Precisão, latência, custo por ticket resolvido |
| Assistente de revisão de código | Bug não detectado ou feedback ruidoso | Modelo de codificação, modelo de raciocínio | Taxa de detecção de bugs, qualidade da edição, comportamento de fallback |
| Geração de imagem de produto | Resultado criativo ruim | Modelo de geração de imagens | Custo por imagem aceita, controles de prompt, caminho de moderação |
| Agente de pesquisa | Resposta lenta ou incompleta | Modelo de raciocínio mais ferramentas | Acesso às ferramentas, rastreabilidade, tratamento de timeout |
Esta etapa evita o erro mais comum de uma API de IA unificada: tratar o gateway como um seletor aleatório de modelos. Uma implementação boa ainda mapeia cargas de trabalho para responsáveis, verificações de qualidade e regras de fallback.
Etapa 2: Criar e Armazenar a Chave da API
Crie a chave no console do gateway e armazene-a fora do controle de versão.
Para o Flatkey, crie uma chave no console e armazene-a como FLATKEY_API_KEY:
export FLATKEY_API_KEY="sk-fk-your-key"Use chaves separadas para desenvolvimento, homologação e produção. Isso gera logs mais limpos e uma revogação mais segura se uma chave vazar.
Nomeação recomendada para chaves:
| Ambiente | Nome de chave de exemplo | Finalidade |
|---|---|---|
| Desenvolvimento | dev-local-ai-tests | Testes locais com limites de gasto baixos |
| Homologação | staging-model-routing | Validação pré-produção |
| Produção | prod-customer-chat | Tráfego de usuários em tempo real |
| Fluxo de trabalho do agente | prod-research-agent | Chamadas de agente autônomas ou agendadas |
Uma API de IA unificada deve reduzir a proliferação de credenciais, não escondê-la. Mantenha a propriedade das chaves explícita.
Etapa 3: Fazer a Primeira Solicitação com cURL
Comece com cURL antes de alterar sua aplicação. Isso comprova que a chave, o endpoint, o ID do modelo e a forma da solicitação funcionam independentemente do seu framework.
curl https://router.flatkey.ai/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $FLATKEY_API_KEY" \
  -d '{
    "model": "gpt-4o-mini",
    "messages": [
      {
        "role": "user",
        "content": "Escreva uma frase explicando o que uma API de IA unificada faz."
      }
    ],
    "max_tokens": 120
  }'
Antes de usar um modelo em produção, confirme o ID exato do modelo no diretório de modelos atual ou na lista de modelos da API. A disponibilidade de modelos, aliases, preços e endpoints suportados pode mudar rapidamente no mercado de IA.
Etapa 4: Alterar a URL Base do SDK da OpenAI
Muitas equipes podem testar uma API de IA unificada com o SDK Python ou Node.js da OpenAI que já utilizam. A migração principal é a chave da API mais a URL base.
Python:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["FLATKEY_API_KEY"],
    base_url="https://router.flatkey.ai/v1",
)

response = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[
        {"role": "user", "content": "Resuma este feedback de produto em três tópicos."}
    ],
    max_tokens=300,
)

print(response.choices[0].message.content)
Node.js:
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.FLATKEY_API_KEY,
  baseURL: "https://router.flatkey.ai/v1",
});

const response = await client.chat.completions.create({
  model: "gpt-4o-mini",
  messages: [
    { role: "user", content: "Resuma este feedback de produto em três tópicos." },
  ],
  max_tokens: 300,
});

console.log(response.choices[0].message.content);
O objetivo não é remover todas as diferenças entre provedores. O objetivo é manter o wrapper da aplicação estável enquanto a escolha do modelo passa para um parâmetro controlado.
Passo 5: Escolha Modelos com uma Política, Não por Adivinhação
Uma API de IA unificada torna a troca de modelos mais fácil. Isso pode ajudar ou prejudicar, dependendo de você definir regras de seleção.
Use uma tabela simples de política:
| Rota | Modelo primário | Modelo de backup | Regra de aprovação |
|---|---|---|---|
support_summary | Modelo de chat rápido e de baixo custo | Modelo de raciocínio maior | O responsável pelo produto pode alterar após a passagem da amostra de QA |
code_review | Modelo focado em código | Modelo de raciocínio geral | É necessária aprovação do líder de engenharia |
image_creative | Modelo de imagem | Sem fallback automático | Líder criativo aprova a qualidade da saída |
research_agent | Modelo de raciocínio | Modelo de menor latência | É necessária aprovação de Ops se o fallback alterar a profundidade da resposta |
O nome do modelo nunca deve ser uma string mágica espalhada pelo código. Coloque-o na configuração, associe-o a uma carga de trabalho e registre tanto o modelo solicitado quanto o modelo final usado.
Passo 6: Verifique os Logs de Uso Após a Primeira Chamada
Não considere a migração concluída quando a API retornar 200. Verifique o rastro de uso e custo.
Para a Flatkey, o painel de Usage mostra campos em nível de solicitação como timestamp, modelo, tokens de entrada, tokens de saída, custo descontado, chave de API e status. Após sua primeira solicitação, verifique:
| Verificação | O que você deve ver |
|---|---|
| Modelo | O ID do modelo que você solicitou ou o modelo final roteado |
| Tokens | As contagens de tokens de entrada e saída |
| Custo | O valor descontado do saldo para essa solicitação |
| Chave | A chave de ambiente usada pela solicitação |
| Status | Estado de sucesso, erro ou limite de taxa |
| Latência | Se o primeiro teste está dentro da faixa esperada |
É aqui que uma API de IA unificada se torna operacionalmente útil. Produto, engenharia e finanças podem inspecionar o mesmo rastro de solicitação em vez de reconciliar capturas de tela de vários painéis de provedores.
Passo 7: Adicione Fallback Somente Depois Que Você Puder Medir Isso
Fallback não é automaticamente bom. Ele é bom quando recupera solicitações sem reduzir a qualidade da resposta, violar políticas ou ocultar custos.
Antes de ativar o fallback, defina:
| Pergunta | Por que isso importa |
|---|---|
| Quais erros acionam o fallback? | Limite de taxa, timeout, indisponibilidade do provedor e falhas de política de conteúdo são घटन diferentes. |
| Qual modelo é permitido como backup? | Um modelo de fallback pode alterar qualidade, latência, custo ou postura de conformidade. |
| Quem aprova a rota? | A política de fallback é um comportamento de produção, não apenas uma conveniência para desenvolvedores. |
| O que é registrado? | Você precisa do modelo solicitado, modelo final, contagem de tentativas, status final, tokens, custo e latência. |
| Qual é o plano de reversão? | Se o fallback causar respostas ruins, você precisa de uma forma rápida de desativá-lo. |
A documentação de roteadores open-source e comerciais frequentemente enfatiza roteamento, ordem de provedores, balanceamento de carga e comportamento de fallback. Esses recursos importam, mas sua implantação deve medir taxa de saída aceita, custo por saída aceita, latência p95 e taxa de incompatibilidade do fallback.
Etapa 8: Mantenha Exceções Diretas ao Provedor
A melhor implementação de uma API de IA unificada ainda permite exceções.
Use acesso direto ao provedor quando:
- um recurso específico do modelo não é exposto pela camada unificada
- o provedor exige um formato nativo de solicitação para um recurso crítico para o lançamento
- compras, conformidade ou política de residência de dados exigem um caminho direto
- uma equipe precisa de logs ou controles nativos do provedor para um fluxo de trabalho regulamentado
- o caminho unificado falha no seu teste de aceitação de qualidade, latência ou custo
Isso torna a arquitetura mais credível. A camada unificada se torna o padrão para trabalho repetível com múltiplos modelos, não uma abstração forçada para toda e qualquer solicitação possível.
Checklist de Implementação
Use esta checklist antes de mover uma carga de trabalho para trás de uma API de IA unificada:
- O responsável pela carga de trabalho está identificado.
- O modelo principal e o modelo de backup estão documentados.
- A chave de API está armazenada em um gerenciador de segredos ou variável de ambiente.
- As chaves de desenvolvimento, staging e produção estão separadas.
- A URL base está configurada em um único wrapper de cliente.
- O ID do modelo é orientado por configuração, não hardcoded entre arquivos.
- A primeira solicitação cURL é bem-sucedida.
- A solicitação via SDK é bem-sucedida em staging.
- Os logs de uso mostram modelo, tokens, custo, chave, status e latência.
- O custo por saída aceita é medido em comparação com o caminho direto do provedor.
- O comportamento de fallback é testado com um caso de falha não produtivo.
- O plano de reversão está documentado.
O Que Medir nos Primeiros 30 Dias
O primeiro mês deve responder se a API de IA unificada melhora as operações, e não apenas se as solicitações são executadas.
Acompanhe:
| Métrica | Por que isso importa |
|---|---|
| Taxa de saída aceita | Mede respostas utilizáveis, não apenas chamadas HTTP bem-sucedidas |
| Custo por saída aceita | Normaliza o preço em relação à qualidade e às tentativas повторadas |
| Latência p95 por workload | Evita que uma rota esconda uma experiência de usuário lenta |
| Taxa de recuperação do fallback | Mostra se o fallback realmente salva solicitações |
| Taxa de incompatibilidade do fallback | Identifica respostas de backup que passam tecnicamente, mas falham em qualidade |
| Gasto por chave por ambiente | Separa experimentos de desenvolvimento do uso em produção |
| Tempo para adicionar um novo modelo | Mede se a camada unificada reduz o atrito operacional |
Se essas métricas melhorarem, expanda a camada unificada para outro workload. Se não melhorarem, mantenha o caminho direto do provedor para esse fluxo de trabalho e use o resultado como uma restrição para o próximo teste.
Adequação do Flatkey: Uma Chave, Uma URL Base, Uma Superfície de Revisão
A Flatkey foi criada para equipes que querem usar uma chave e uma URL base compatível com OpenAI em muitos fluxos de trabalho de modelos e ferramentas. A documentação atual da Flatkey descreve acesso à API REST em https://router.flatkey.ai/v1, autenticação Bearer, compatibilidade com o SDK da OpenAI, seleção de modelo por meio do parâmetro model e registros de uso para revisão de modelo, token, latência, custo, chave e status.
Isso torna a Flatkey uma opção prática quando sua equipe quer o fluxo de trabalho de API de IA unificada sem reescrever todos os wrappers de solicitação. Comece com um workload de staging, valide o modelo exato no diretório atual de modelos, verifique o registro de uso e, então, decida se roteamento, fallback, cotas ou controles de equipe devem vir em seguida.
Para detalhes de implementação adjacentes, leia o guia de início rápido da API Flatkey, a lista de verificação de migração para gateway de API compatível com OpenAI e a estrutura de avaliação de ferramentas de API de roteamento de IA.
Perguntas frequentes
O que é uma API de IA unificada?
Uma API de IA unificada é uma camada única de acesso para chamar vários modelos ou ferramentas de IA compatíveis por meio de autenticação compartilhada, configuração de endpoint, seleção de modelo e revisão de uso.
Uma API de IA unificada é o mesmo que um gateway de API de IA?
Elas se sobrepõem. Um gateway de API de IA normalmente enfatiza roteamento, controles, fallback e observabilidade. Uma API de IA unificada enfatiza uma superfície única de integração entre vários modelos ou provedores. Muitos produtos combinam ambos.
Posso usar uma API de IA unificada com o SDK da OpenAI?
Sim, quando o gateway expõe uma API compatível com OpenAI. Nesse caso, você normalmente define a chave da API, altera a URL base do SDK e escolhe o modelo de destino com o parâmetro model.
Uma API de IA unificada elimina as diferenças específicas de cada provedor?
Não. O comportamento do modelo, os limites de contexto, os parâmetros suportados, a latência, os preços e o comportamento das políticas ainda podem diferir. Uma API de IA unificada reduz a sobrecarga de integração e operações, mas você ainda precisa de QA específica por workload.
Quando não devo usar uma API de IA unificada?
Evite mover um fluxo de trabalho para trás de uma camada unificada quando ele depender de recursos nativos do provedor, aquisição direta e rigorosa com o provedor, controles de conformidade especializados ou otimizações de um único provedor que o gateway não consegue expor.
Conclusão
Uma API de IA unificada é útil em 2026 quando oferece à sua equipe uma forma mais limpa de executar vários modelos de IA, controlar chaves, inspecionar o uso e alterar rotas sem reescrever o código da aplicação. A implantação mais segura é restrita: escolha uma carga de trabalho, troque a URL base em staging, verifique o histórico da requisição, meça qualidade e custo e, então, expanda apenas onde a camada unificada reduza claramente o trabalho operacional.
Se você estiver avaliando a Flatkey para este fluxo de trabalho, comece com o diretório de modelos, a página de preços e o quickstart da API, e então execute uma requisição de staging por meio de https://router.flatkey.ai/v1 antes de alterar o tráfego de produção.