
Затраты, оплата и эксплуатация
Последние статьи в категории Затраты, оплата и эксплуатация.

Аренда GPU-сервера: архитектура, производительность и руководство по развёртыванию в облаке
Узнайте, как арендовать GPU-сервер с правильным распределением ресурсов, проверкой топологии, этапами развёртывания и приёмочными тестами перед резервированием мощностей.

Стоечный GPU-сервер: архитектура, производительность и руководство по облачному развертыванию
Практическое руководство по планированию, проверке и развертыванию стоечных GPU-мощностей для ИИ-нагрузок.

Инференс и обучение ИИ: производительность, стоимость и компромиссы при развертывании
Инференс и обучение ИИ: сравнение метрик производительности, факторов стоимости, требований к развертыванию и случаев, когда стоит дообучать модель или запускать её в продакшене.

Развертывание vLLM Expert Parallel для DeepSeek и других моделей MoE
Разверните vLLM expert parallel для DeepSeek и других моделей MoE с правильными флагами, топологией, проверками бэкенда и тестами запуска.

vLLM Docker: архитектура, производительность и руководство по облачному развёртыванию
Руководство по развёртыванию vLLM Docker на облачных GPU: архитектура, OpenAI-совместимая настройка, оптимизация производительности, масштабирование на несколько GPU и проверка готовности к продакшену.
Дезагрегация prefill и decode в SGLang: архитектура и руководство по развертыванию
Разверните дезагрегацию prefill и decode в SGLang: отдельные пулы GPU, передача KV-кэша, метрики валидации, выбор топологии и проверки запуска.

Стоимость self-hosted LLM на миллион токенов: воспроизводимая модель затрат на GPU
Воспроизводимая модель расчёта стоимости обслуживания self-hosted LLM на основе полной стоимости GPU-мощностей, принятой пропускной способности, загрузки и качества.

Стоимость OpenAI API в 2026 году: таблица цен и калькулятор
Актуальное руководство по стоимости OpenAI API с таблицами цен GPT-6, копируемым калькулятором, примерами расчётов, скрытыми комиссиями и проверками оптимизации.
Бесплатный API-ключ OpenAI? Лимиты, стоимость и компромиссы в продакшене
API-ключ OpenAI — это учётные данные, а не гарантированный бесплатный бюджет для продакшена. Перед запуском проверьте условия доступа, кредиты, лимиты, стоимость и контроль расходов.

GPU Nvidia H200: архитектура, производительность и руководство по развертыванию в облаке
Практическое руководство по подбору, развертыванию, валидации и эксплуатации мощностей GPU Nvidia H200 для задач ИИ и HPC в облаке.
Ollama Cloud GPU: запуск защищённого удалённого API-сервера
Безопасный процесс с Docker и HTTPS-прокси для запуска Ollama на облачном GPU и предоставления удалённой конечной точки /api или совместимой с OpenAI /v1.

GPU NVIDIA H100: архитектура, производительность и развёртывание в облаке
Практическое руководство по архитектуре NVIDIA H100, топологии облачной инфраструктуры, развёртыванию в Kubernetes, проверке производительности и стоимости выполненной работы.

Что такое инференс ИИ: архитектура, производительность и руководство по облачному развёртыванию
Что такое инференс ИИ: как обученная модель превращает новые входные данные в готовый ответ, а также ключевые метрики и этапы развёртывания на облачных GPU.
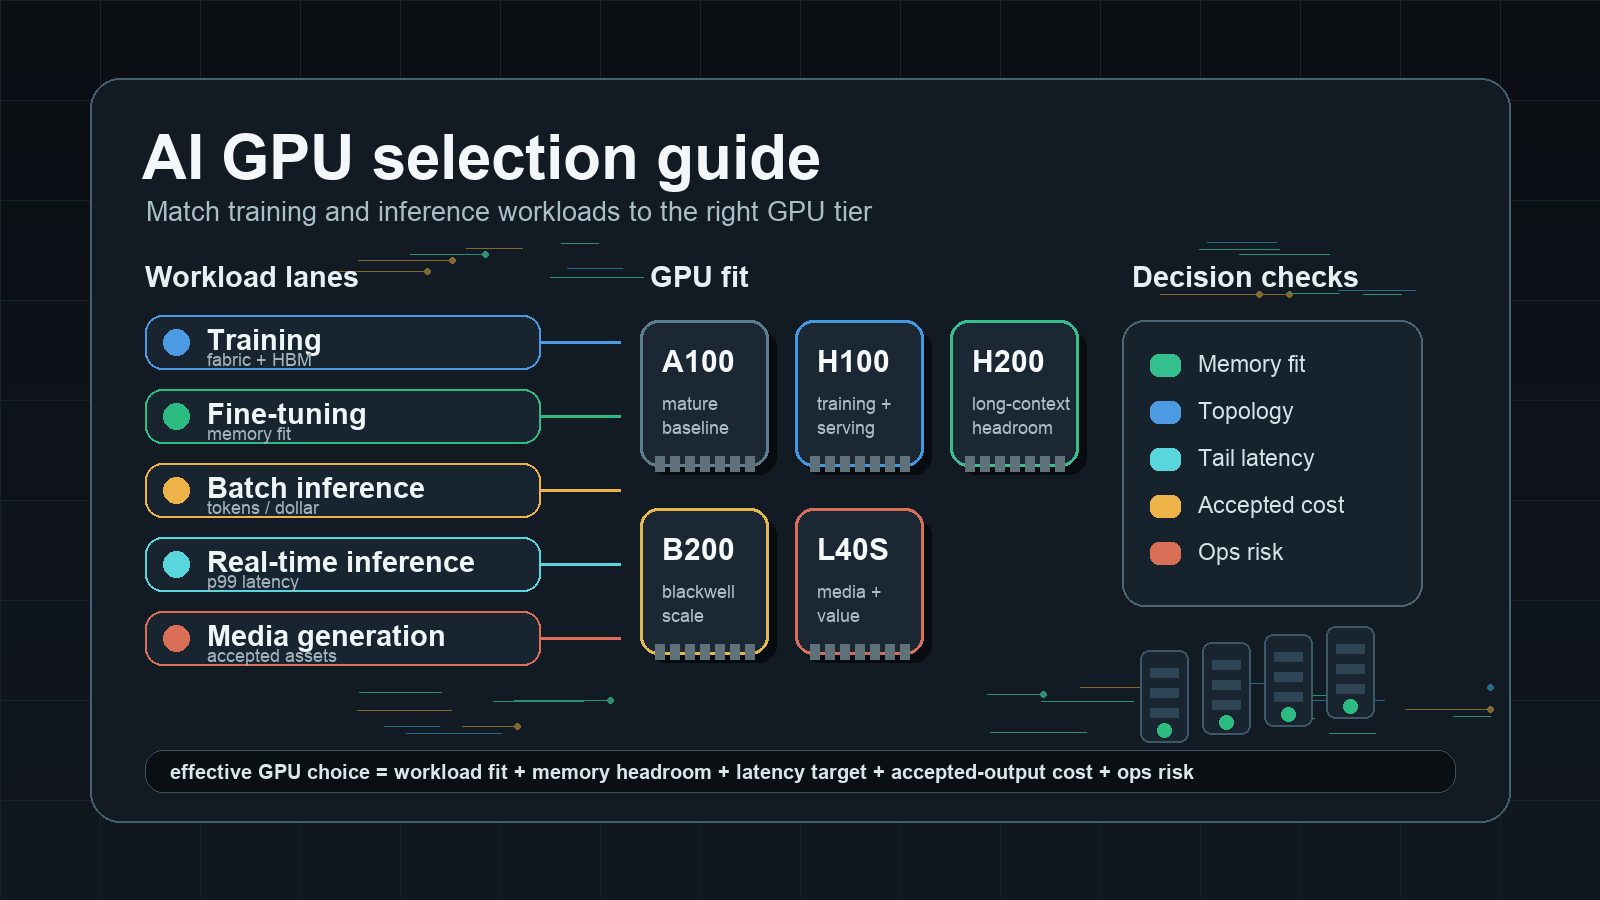
Руководство по выбору AI GPU: подберите подходящий GPU для обучения и инференса
Практическое руководство по выбору AI GPU для команд, которые сопоставляют задачи обучения, тонкой настройки, инференса LLM, генерации медиа и оценки с подходящим GPU и моделью мощности.

Можно ли запустить Kimi K3 локально? Железо, GGUF и vLLM (2026)
Kimi K3 можно запустить локально, но самому маленькому 1-битному GGUF нужно около 610 ГБ RAM и VRAM. Точные требования к железу, команды llama.cpp и vLLM, условия лицензии и сравнение стоимости с арендой GPU и API.
Выгрузка и многоуровневое хранение KV-кэша для обслуживания LLM с длинным контекстом
Руководство по выгрузке и многоуровневому хранению KV-кэша для обслуживания LLM с длинным контекстом с vLLM и TensorRT-LLM.
Создание Kubernetes-кластера с GPU для обучения и инференса ИИ
Практическое руководство по Kubernetes-кластеру с GPU для обучения и инференса ИИ: пулы GPU-узлов, плагины устройств, GPU Operator, очереди, хранилище, наблюдаемость, безопасность, контроль затрат и проверка поставщиков.
Цена GPU H200: стоимость, факторы ценообразования и руководство по покупке
Сравните стоимость карты H200 NVL, серверов и аренды в облаке — а также ключевые параметры TCO, которые важно учесть перед покупкой или резервированием мощностей.
Запускайте быстрее с единым AI-шлюзом.
Используйте flatkey.ai, чтобы управлять моделями, ключами, биллингом и наблюдаемостью на одной API-платформе.
Начать