
Chi phí, thanh toán và vận hành
Bài viết mới nhất trong Chi phí, thanh toán và vận hành.

Thuê máy chủ GPU: Kiến trúc, hiệu năng và hướng dẫn triển khai đám mây
Tìm hiểu cách thuê máy chủ GPU với phân bổ phù hợp, kiểm tra topology, các giai đoạn triển khai và kiểm thử nghiệm thu trước khi cam kết dung lượng.

Rack máy chủ GPU: Kiến trúc, hiệu năng và hướng dẫn triển khai đám mây
Hướng dẫn thực tiễn về lập sơ đồ, xác thực và triển khai năng lực GPU quy mô rack cho khối lượng công việc AI.

Suy luận AI và huấn luyện: Đánh đổi về hiệu năng, chi phí và triển khai
Giải thích suy luận AI và huấn luyện: so sánh chỉ số hiệu năng, yếu tố chi phí, yêu cầu triển khai và khi nào nên tinh chỉnh hoặc phục vụ mô hình.

Triển khai song song chuyên gia vLLM cho DeepSeek và các mô hình MoE khác
Triển khai song song chuyên gia vLLM cho DeepSeek và các mô hình MoE khác với cờ phù hợp, cấu trúc liên kết, kiểm tra backend và thử nghiệm triển khai.

vLLM Docker: Kiến trúc, Hiệu năng và Hướng dẫn Triển khai Đám mây
Hướng dẫn triển khai vLLM Docker trên GPU đám mây: kiến trúc, thiết lập tương thích OpenAI, tối ưu hiệu năng, mở rộng đa GPU và kiểm tra vận hành.
SGLang Prefill Decode Disaggregation: Hướng dẫn kiến trúc và triển khai
Triển khai phân tách prefill decode SGLang với các cụm GPU riêng biệt, truyền KV-cache, chỉ số xác thực, lựa chọn cấu trúc liên kết và kiểm tra rollout.

Chi phí LLM tự lưu trữ trên mỗi triệu token: Mô hình chi phí GPU có thể tái lập
Mô hình có thể tái lập để tính chi phí phục vụ LLM tự lưu trữ dựa trên công suất GPU toàn phần, thông lượng được chấp nhận, mức sử dụng và chất lượng.

Chi phí OpenAI API năm 2026: Bảng giá và công cụ tính
Hướng dẫn cập nhật về chi phí OpenAI API với bảng giá GPT-6, công cụ tính có thể sao chép, ví dụ minh họa, phí ẩn và các kiểm tra tối ưu hóa.
Khóa API OpenAI có miễn phí không? Giới hạn, chi phí và đánh đổi khi vận hành
Khóa API OpenAI là thông tin xác thực—not phải ngân sách vận hành miễn phí được đảm bảo. Tìm hiểu những điều cần xác minh về điều kiện đủ tiêu chuẩn, tín dụng, giới hạn, chi phí và kiểm soát chi tiêu trước khi ra mắt.

GPU Nvidia H200: Kiến trúc, hiệu năng và hướng dẫn triển khai trên đám mây
Hướng dẫn thực tế về cách xác định quy mô, triển khai, xác thực và vận hành năng lực GPU Nvidia H200 cho khối lượng công việc AI và HPC trên đám mây.
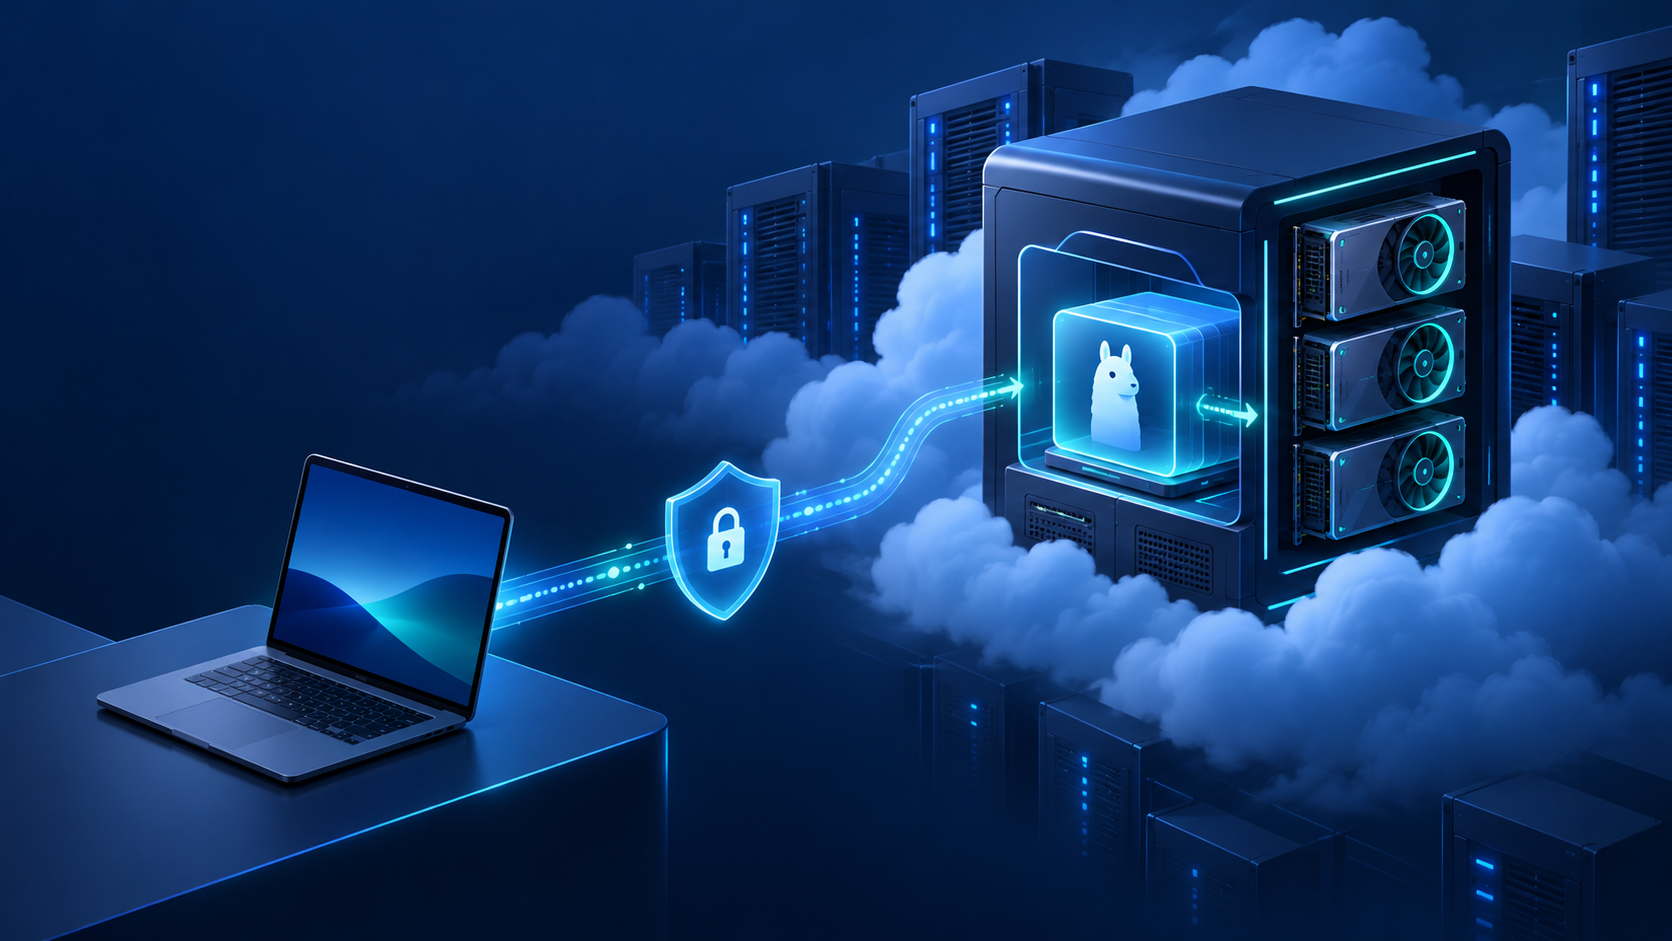
Ollama Cloud GPU: Chạy máy chủ API từ xa an toàn
Quy trình Docker và HTTPS proxy an toàn để chạy Ollama trên GPU đám mây và cung cấp endpoint /api từ xa hoặc /v1 tương thích OpenAI.

GPU NVIDIA H100: Kiến trúc, Hiệu năng và Hướng dẫn Triển khai Đám mây
Hướng dẫn thực hành về kiến trúc NVIDIA H100, cấu trúc liên kết đám mây, triển khai Kubernetes, xác thực hiệu năng và chi phí cho công việc hoàn thành.

Ý nghĩa suy luận AI: Kiến trúc, hiệu năng và hướng dẫn triển khai đám mây
Ý nghĩa của suy luận AI: cách mô hình đã huấn luyện biến dữ liệu đầu vào mới thành phản hồi sẵn sàng cho sản xuất, cùng các chỉ số và bước triển khai GPU đám mây quan trọng.

Có chạy Kimi K3 cục bộ được không? Hướng dẫn phần cứng, GGUF và vLLM (2026)
Kimi K3 có thể chạy cục bộ, nhưng bản GGUF 1-bit nhỏ nhất cần khoảng 610 GB RAM cộng VRAM. Xem yêu cầu phần cứng chính xác, lệnh llama.cpp và vLLM, điều khoản giấy phép và so sánh chi phí với thuê GPU và API.
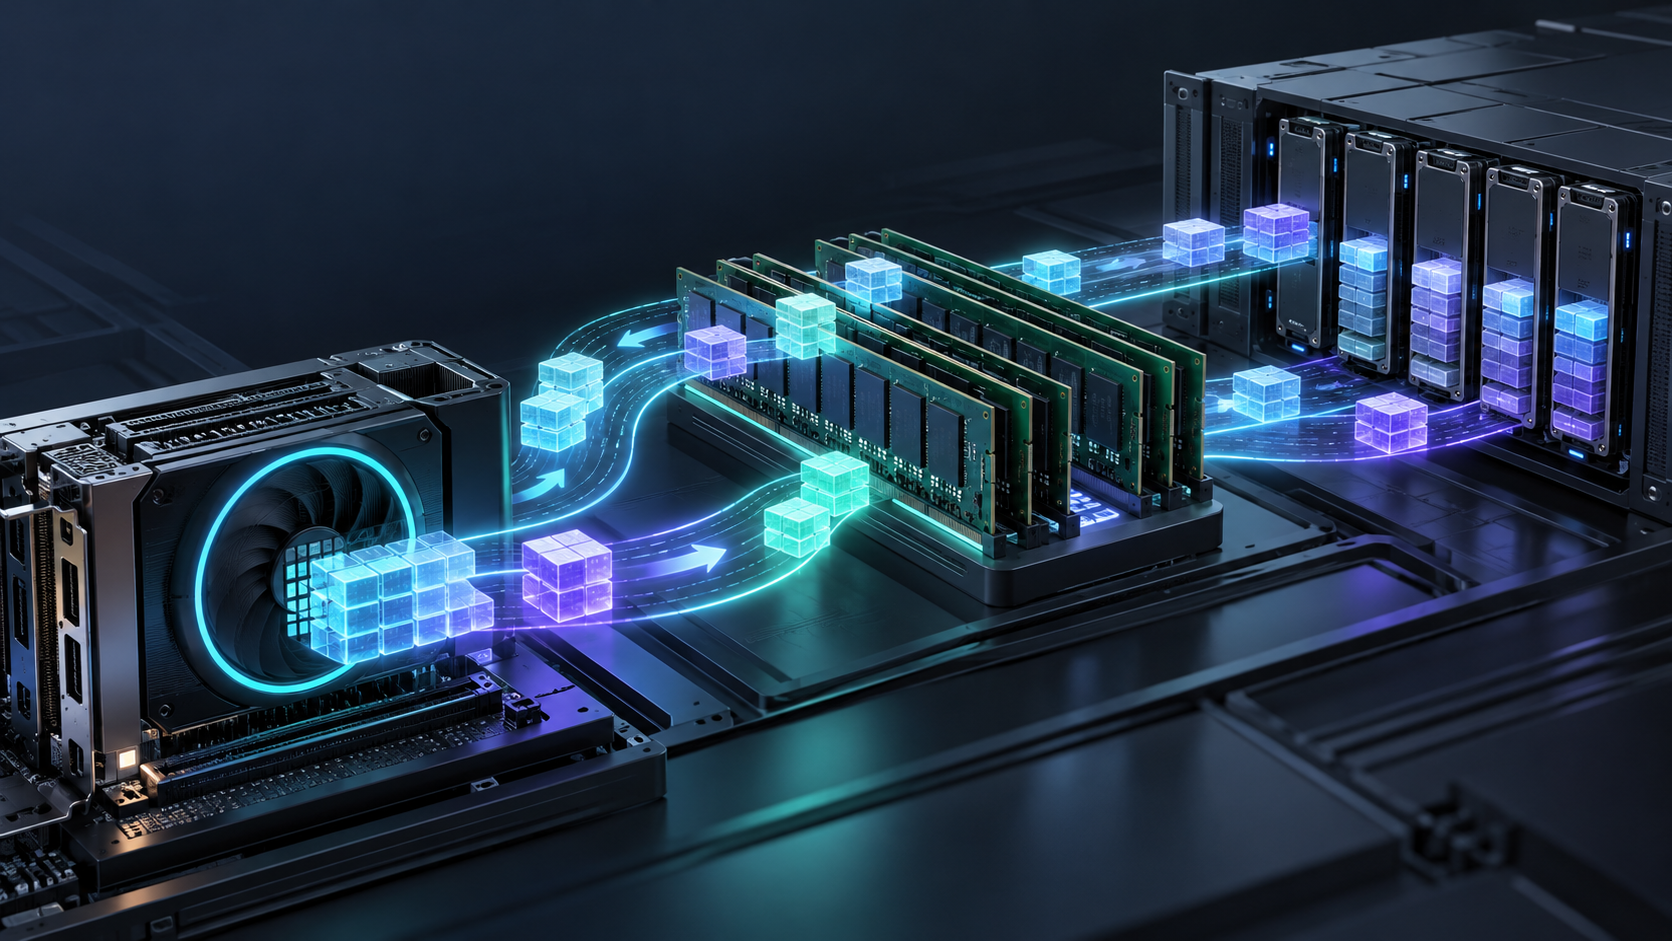
Offload và phân tầng KV Cache cho phục vụ LLM ngữ cảnh dài
Hướng dẫn offload và phân tầng KV cache cho phục vụ LLM ngữ cảnh dài với vLLM và TensorRT-LLM.
Xây dựng cụm GPU Kubernetes cho huấn luyện và suy luận AI
Hướng dẫn thực tiễn về cụm GPU Kubernetes cho huấn luyện và suy luận AI, bao gồm nhóm nút GPU, plugin thiết bị, GPU Operator, hàng đợi, lưu trữ, khả năng quan sát, bảo mật, kiểm soát chi phí và thẩm định nhà cung cấp.
Giá GPU H200: Mức giá, yếu tố chi phí và hướng dẫn mua
So sánh chi phí card H200 NVL, máy chủ và thuê đám mây—cùng các yếu tố TCO quan trọng cần cân nhắc trước khi mua hoặc đặt trước năng lực.

GPU H200: Kiến trúc, Hiệu năng và Hướng dẫn Triển khai Đám mây
Hướng dẫn thực tế về H200 giúp chọn kiểu dáng, tính toán bộ nhớ và fabric, triển khai trên hạ tầng đám mây, đồng thời xác thực độ trễ, thông lượng, tình trạng hoạt động và chi phí công việc hoàn thành.
Xây dựng nhanh hơn với một cổng AI.
Dùng flatkey.ai để quản lý mô hình, khóa, tính phí và quan sát vận hành trong một nền tảng API.
Bắt đầu