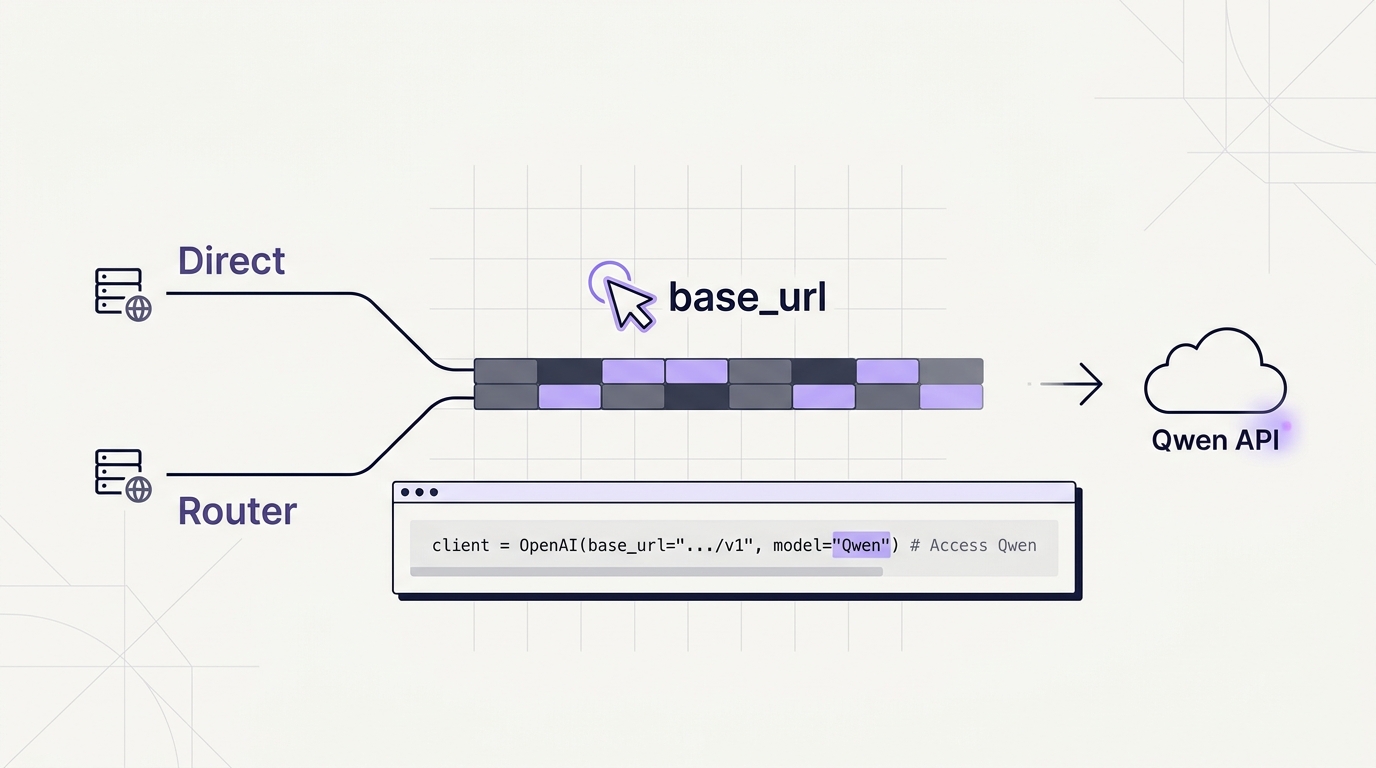
O acesso à API Qwen é mais fácil de operar quando você separa duas decisões: qual conta do provedor é a proprietária da requisição e para qual Base URL seu código de aplicação aponta.
Se você só precisa do Qwen dentro do Alibaba Cloud Model Studio, o caminho direto funciona: crie uma chave de API do Model Studio na região correta, escolha a Base URL compatível com OpenAI da região e chame um nome de modelo Qwen por meio do seu SDK OpenAI. Se o seu app já compara Qwen com GPT, Claude, Gemini, DeepSeek ou outros modelos, um caminho via roteador costuma ser mais fácil de manter: mantenha uma única Base URL compatível com OpenAI, uma chave e um fluxo de revisão de uso.
Este guia mostra como configurar o acesso à API Qwen com uma única Base URL compatível com OpenAI por meio da Flatkey, ao mesmo tempo em que mantém o caminho direto do Alibaba Cloud Model Studio claro o suficiente para depurar erros de região, modelo e chave.
Resposta rápida: Acesso à API Qwen com uma única Base URL compatível com OpenAI
Para uma aplicação no estilo OpenAI, o acesso à API Qwen tem dois caminhos práticos.
| Decisão | Qwen direto no Alibaba Cloud Model Studio | Qwen por meio da Flatkey |
|---|---|---|
| Chave de API | Chave do Model Studio / DashScope | Chave de API da Flatkey |
| Base URL | URL de modo compatível do Model Studio específica da região | https://router.flatkey.ai/v1 |
| Alteração no código | Alterar a chave de API, a Base URL e o nome do modelo | Alterar a chave de API, a Base URL e o nome do modelo |
| Origem do modelo | Lista de modelos do Alibaba Cloud Model Studio para sua região/conta | Diretório de modelos da Flatkey e resposta acessível da conta em /v1/models |
| Verificação operacional | Faturamento do Model Studio, chave regional, suporte a recursos | Registro de uso da Flatkey, id do modelo, página de preços, cota, caminho de rollback |
| Melhor opção | Um produto somente Qwen já comprometido com a Alibaba Cloud | Um app multmodelo que quer Qwen por trás do mesmo cliente que os outros modelos |
Use o caminho direto do Model Studio quando o controle no nível do provedor importar mais do que a consolidação. Use a Flatkey quando você quiser acesso à API Qwen por trás do mesmo roteador compatível com OpenAI que o restante da sua pilha de modelos.
O que a Alibaba Cloud confirma sobre a compatibilidade OpenAI do Qwen
A documentação atual do Model Studio da Alibaba Cloud diz que os modelos Qwen oferecem suporte a interfaces compatíveis com OpenAI, e que uma base de código OpenAI existente pode migrar alterando a chave de API, a Base URL e o nome do modelo.
O detalhe operacional importante é a Base URL. O Model Studio não fornece a mesma endpoint genérica para todas as regiões. A documentação compatível com OpenAI lista URLs regionais como:
| Região | Padrão de exemplo de Base URL compatível com OpenAI |
|---|---|
| Singapura | https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1 |
| Virgínia, EUA | https://dashscope-us.aliyuncs.com/compatible-mode/v1 |
| Hong Kong, China | https://{WorkspaceId}.cn-hongkong.maas.aliyuncs.com/compatible-mode/v1 |
| Japão, Tóquio | https://{WorkspaceId}.ap-northeast-1.maas.aliyuncs.com/compatible-mode/v1 |
O Model Studio também documenta domínios específicos por workspace para várias regiões e avisa que a API key deve ser criada na mesma região do endpoint que está sendo chamado. Uma incompatibilidade de região pode parecer uma falha normal de autenticação, mesmo quando a chave em si existe.
Isso significa que uma integração direta com Qwen deve sempre registrar quatro campos juntos:
direct_qwen_route:
  provider: alibaba_cloud_model_studio
  region: ap-southeast-1
  workspace_id: your_workspace_id
  base_url: https://your_workspace_id.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1
  api_key_source: DASHSCOPE_API_KEY
  model: qwen3.8-max
Se um desses campos for copiado de outro ambiente, o acesso à API Qwen pode falhar antes mesmo de o seu prompt chegar ao modelo.
O que o Flatkey muda
O Flatkey não remove a necessidade de escolher um id de modelo válido. Ele muda onde a rota é configurada e onde você revisa o resultado.
A documentação da API REST do Flatkey expõe uma única base URL compatível com OpenAI:
https://router.flatkey.ai/v1
O guia do SDK OpenAI do Flatkey mostra o mesmo padrão de configuração usado por provedores compatíveis diretamente com OpenAI: instanciar o cliente OpenAI, definir a base URL e passar um id de modelo na requisição. O endpoint de lista de modelos do Flatkey retorna ids de modelos acessíveis pela conta em uma resposta no estilo OpenAI de /v1/models, enquanto o diretório público de modelos e a página de preços continuam sendo o lugar para revisar disponibilidade, saúde e unidades de custo dos modelos antes que o tráfego de produção seja movido.
Para acesso à API Qwen, a versão da rota no Flatkey é menor:
flatkey_qwen_route:
  provider_access_layer: flatkey
  base_url: https://router.flatkey.ai/v1
  api_key_source: FLATKEY_API_KEY
  candidate_models:
    - qwen3.8-max
    - qwen3.7-max
    - qwen3.7-plus
    - qwen3.5-flash
  verify_before_launch:
    - account_accessible_v1_models
    - current_model_directory_page
    - pricing_page_units
    - usage_log_readback
    - fallback_or_rollback_policy
A vantagem não é que o Qwen se torne magicamente idêntico a todos os outros provedores. A vantagem é que o cliente, os logs, a revisão de cotas e o fluxo de faturamento podem ser consistentes entre famílias de modelos.
Etapa 1: Escolha Qwen direto ou um roteador
Antes de alterar o código, responda a estas perguntas.
| Pergunta | Qwen direto normalmente é suficiente quando... | Um roteador normalmente é melhor quando... |
|---|---|---|
| Você usa apenas Qwen? | Sim, Qwen é a única família de modelos em escopo. | Não, Qwen é um candidato ao lado de GPT, Claude, Gemini, DeepSeek ou modelos de mídia. |
| Você precisa de controle da região Alibaba? | Sim, o produto está vinculado a uma região ou workspace específico da Alibaba Cloud. | Não, a aplicação quer uma camada compartilhada de acesso a modelos. |
| Os usuários escolherão modelos dinamicamente? | Não, o app usa um único modelo Qwen fixo. | Sim, usuários ou políticas podem alternar ids de modelo conforme a carga de trabalho. |
| Quem revisa o custo? | Um desenvolvedor verifica o faturamento do Model Studio. | Produto, engenharia e finanças precisam de um livro-razão de uso compartilhado. |
| O que acontece se a rota falhar? | Você pode tentar novamente ou pausar o recurso Qwen. | Você precisa de um caminho de fallback ou rollback definido. |
Para a maioria dos indie hackers, a primeira versão pode ser simples: provedor direto para um protótipo de modelo único, roteador para um produto com vários modelos ou um fluxo de trabalho de agente de código que já precisa de uma troca limpa de base URL.
Etapa 2: Configure o Cliente OpenAI da Flatkey
Instale o SDK OpenAI se o seu projeto ainda não o utiliza:
pip install -U openai
Depois crie um cliente que aponte para a Flatkey:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["FLATKEY_API_KEY"],
    base_url="https://router.flatkey.ai/v1",
)
Para Node.js:
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.FLATKEY_API_KEY,
  baseURL: "https://router.flatkey.ai/v1",
});
A regra principal é simples e importante: mantenha as chaves dos provedores fora do código da sua aplicação. Use variáveis de ambiente para FLATKEY_API_KEY no caminho do roteador e DASHSCOPE_API_KEY no caminho direto do Model Studio.
Etapa 3: Verifique o ID do Modelo Qwen Antes de Chamá-lo
Não fixe em código um nome antigo de modelo Qwen vindo de um post de blog, captura de tela ou chat da equipe. Verifique o id do modelo no dia em que você fizer o deploy.
Use uma ou ambas destas verificações:
curl https://router.flatkey.ai/v1/models \
  -H "Authorization: Bearer $FLATKEY_API_KEY"
Depois confirme o mesmo candidato no diretório de modelos da Flatkey e na página de preços. No momento em que esta atualização foi preparada, o diretório público de modelos da Flatkey mostrava entradas da família Qwen incluindo qwen3.8-max, qwen3.7-max, qwen3.7-plus, qwen3.6-plus e qwen3.5-flash. Trate essas opções como exemplos a verificar, não como promessas permanentes.
Use um manifesto de rotas para que seu app possa alterar ids de modelo sem um deploy:
models:
  qwen_default:
    id: qwen3.7-plus
    use_for:
      - coding_assistant
      - long_context_summary
      - structured_extraction
    owner: product-engineering
    rollback: deepseek_or_gemini_candidate
Esse pequeno manifesto transforma o acesso à API Qwen de uma string oculta no código em uma decisão revisável.
Etapa 4: Faça uma Primeira Conclusão de Chat
Comece com uma solicitação curta e determinística. Isto não é um benchmark. É um teste de rota.
response = client.chat.completions.create(
    model="qwen3.7-plus",
    messages=[
        {"role": "system", "content": "Retorne conselhos concisos de implementação."},
        {"role": "user", "content": "Escreva uma frase explicando por que a configuração de base_url é importante."},
    ],
    temperature=0.2,
    max_tokens=120,
)

print(response.choices[0].message.content)
Se a rota falhar, evite adivinhar. Verifique estes campos nesta ordem:
| Verificação | O que ela detecta |
|---|---|
base_url |
Caminho incorreto do provedor, /v1 ausente, confusão entre acesso direto e via roteador |
| Variável da chave de API | Variável de ambiente vazia, tipo de chave incorreto, configuração de staging vazada |
| ID do modelo | Alias antigo do Qwen, a conta não tem acesso, erro de digitação |
| Forma do endpoint | Incompatibilidade entre Chat Completions, Responses e embeddings |
| Região/espaço de trabalho | Rota direta do Model Studio usando uma chave de outra região |
| Log de uso | A solicitação nunca chegou ao roteador, falha do provedor, incompatibilidade de custo ou status |
Esta ordem economiza tempo porque muitas falhas de acesso à API Qwen são falhas de configuração, não falhas do modelo.
Etapa 5: Teste Streaming, Tools e JSON Separadamente
Compatível com OpenAI não significa que todo provedor implemente todos os recursos da mesma forma. Antes da implementação em produção, teste os recursos que sua aplicação realmente usa.
| Recurso | Teste rápido | Condição de aprovação |
|---|---|---|
| Chat sem streaming | Um prompt pequeno | A resposta retorna uma mensagem utilizável e dados de uso |
| Streaming | O mesmo prompt com stream=True |
Os chunks chegam na ordem e sua UI trata a conclusão |
| Chamadas de ferramenta | Um schema simples de função | O modelo retorna campos válidos de tool-call para o seu parser |
| Saída JSON | Uma pequena tarefa de extração | A saída é validada contra seu schema ou caminho de reparo |
| Contexto longo | Um documento representativo | A latência e a qualidade permanecem aceitáveis para a carga de trabalho |
| Tratamento de erros | ID de modelo inválido em staging | Sua aplicação registra o erro de rota sem expor chaves |
Para acesso à API Qwen via Flatkey, verifique também o painel de uso da Flatkey após cada teste rápido. A solicitação deve mostrar o ID do modelo, contagem de tokens, status da solicitação, carimbo de data e hora e custo deduzido do saldo. Esse retorno é o que permite depurar uma rota de produção depois.
Etapa 6: Normalizar o Preço pelo Resultado Aceito
Não compare Qwen, DeepSeek, Gemini, Claude e GPT apenas pelo preço de token destacado. Compare-os pelo resultado aceito para a sua carga de trabalho.
Use esta planilha:
| Métrica | Por que isso importa |
|---|---|
| Tokens de entrada | Prompts de contexto longo podem dominar o custo mesmo quando a saída é curta. |
| Tokens de saída | Tarefas de código, extração e agentes podem gerar comprimentos de saída muito diferentes. |
| Comportamento de cache | Alguns caminhos de provedor/conta podem precificar a entrada em cache de forma diferente. |
| Taxa de retry | Uma rota mais barata pode ficar cara quando precisa de mais tentativas. |
| Taxa de rejeição | JSON com falha, tool calls fracas ou respostas de baixa qualidade devem contar contra a rota. |
| Tempo de correção humana | A limpeza manual faz parte do custo real de um produto indie. |
| Uso de fallback | O tráfego de fallback deve ser visível, não tratado como uma diferença de arredondamento. |
A fórmula prática:
accepted_output_cost =
  (successful_request_cost + retry_cost + fallback_cost + human_repair_cost)
  / accepted_outputs
Use as páginas de preços atuais do provedor e da Flatkey para as unidades brutas. Use seus próprios logs para retries, outputs rejeitados e tempo de reparo.
Etapa 7: Adicione uma Política de Reversão
Seu primeiro route do Qwen deve ter um plano de reversão antes de ter usuários.
qwen_rollout:
  environment: production
  default_model: qwen3.7-plus
  start_percentage: 10
  increase_when:
    - accepted_output_rate >= 0.95
    - p95_latency_ms <= 4500
    - error_rate <= 0.02
    - accepted_output_cost_within_budget: true
  rollback_when:
    - error_rate > 0.05
    - schema_failures_above_threshold: true
    - usage_log_missing: true
    - cost_spike_without_product_change: true
  rollback_action:
    set_model: previous_production_model
    notify: engineering_owner
Isso não exige uma grande equipe de plataforma. Exige um responsável por um route, um manifesto de modelo, um hábito de revisão de uso e um pequeno teste em staging antes de aumentar o tráfego.
Onde Isso se Encaixa na Flatkey
A Flatkey é uma boa opção quando o acesso à API Qwen faz parte de um fluxo de trabalho mais amplo de roteamento de modelos:
- Você já usa SDKs compatíveis com OpenAI e quer uma única Base URL para várias famílias de modelos.
- Você quer que Qwen, DeepSeek, Gemini, Claude, GPT e outros modelos sejam revisados em um único diretório de modelos e fluxo de trabalho de uso.
- Você precisa de chaves de API ou cotas separadas para desenvolvimento, staging, produção ou agentes de codificação.
- Você quer que os engenheiros validem o model id, o custo e o status a partir de logs, em vez de reconciliar vários painéis de provedores.
Comece com o guia de início rápido da API Flatkey, use o guia de migração para API compatível com OpenAI quando estiver substituindo chamadas diretas ao provedor, e combine esta checklist com as verificações de roteamento DeepSeek vs Qwen API se sua carga de trabalho for sensível a custos.
Para a decisão final de rota, verifique o diretório de modelos da Flatkey ao vivo, a página de preços e a página de saúde dos modelos. Essas páginas devem superar qualquer artigo estático sempre que a disponibilidade ou os preços dos modelos mudarem.
Checklist Final para Acesso à API Qwen com uma única Base URL compatível com OpenAI
Antes de disponibilizar o acesso à API Qwen para usuários, confirme:
- A fonte da verdade para o model id está atualizada.
- Os testes diretos do Model Studio usam uma API key e uma Base URL correspondentes à região.
- Os testes da Flatkey usam
https://router.flatkey.ai/v1e uma Flatkey API key. - Chat, streaming, chamadas de ferramentas, saída em JSON e comportamento de contexto longo são testados separadamente quando seu app precisar deles.
- Os logs de uso mostram o model id esperado, status, contagens de tokens, timestamp e custo.
- O preço é normalizado por output aceito, e não apenas pela taxa nominal de tokens.
- Rollback é uma mudança de configuração, não uma reescrita emergencial de código.
- As chaves do provedor são armazenadas em variáveis de ambiente ou em armazenamento secreto, nunca no código.
Acesso à API Qwen com uma única Base URL compatível com OpenAI é um padrão de integração simples quando a rota é explícita. Escolha o caminho direto do provedor quando você só precisar do Alibaba Cloud Qwen. Escolha a Flatkey quando o Qwen fizer parte de um produto multi-modelo que precise de um cliente, uma base URL e um único loop operacional.
Perguntas Frequentes
O Qwen suporta a API OpenAI?
O Alibaba Cloud Model Studio documenta uma interface compatível com OpenAI para modelos Qwen. O código existente do SDK da OpenAI pode ser migrado alterando a API key, a base URL e o nome do modelo, mas ainda é necessário usar a configuração correta de região e workspace.
Qual é a base URL da Flatkey para acesso à API do Qwen?
Use https://router.flatkey.ai/v1 para a API compatível com OpenAI da Flatkey. Em seguida, escolha um id de modelo Qwen atual da sua lista de modelos acessível na conta e do diretório de modelos ao vivo da Flatkey.
Posso usar o mesmo SDK da OpenAI para o Qwen via Flatkey?
Sim. A documentação da Flatkey mostra os SDKs OpenAI para Python e Node.js configurados com uma API key da Flatkey e https://router.flatkey.ai/v1 como base URL. O código da requisição pode manter o formato familiar de Chat Completions para modelos compatíveis.
Por que chamadas diretas ao Qwen falham com uma API key aparentemente válida?
Uma causa comum é uma incompatibilidade de região. O Alibaba Cloud informa que uma API key do Model Studio fica vinculada à região em que foi criada, então uma chave de uma região pode ser rejeitada quando usada com a base URL de outra região.
Devo publicar preços exatos do Qwen na documentação do meu app?
Normalmente, não. Link para as páginas atuais de preços do provedor e da Flatkey e, em seguida, acompanhe o seu próprio custo de saída aceita a partir dos logs. O texto estático de preços fica desatualizado rapidamente quando modelos, descontos ou unidades de cobrança mudam.