
Blog da flatkey.ai
Insights, notas de produto e guias de implementação para equipes que criam com APIs de IA.
Arquitetura de gateways de IA
Artigos mais recentes em Arquitetura de gateways de IA.
Ler maisMigração de URL base e SDK
Artigos mais recentes em Migração de URL base e SDK.
Ler maisCustos, cobrança e operações
Artigos mais recentes em Custos, cobrança e operações.
Ler maisControles empresariais e confiança
Artigos mais recentes em Controles empresariais e confiança.
Ler maisComparações de gateways
Artigos mais recentes em Comparações de gateways.
Ler maisGuias de modelos e modalidades
Artigos mais recentes em Guias de modelos e modalidades.
Ler maisConfiabilidade e roteamento
Artigos mais recentes em Confiabilidade e roteamento.
Ler maisIntegrações de ferramentas
Artigos mais recentes em Integrações de ferramentas.
Ler mais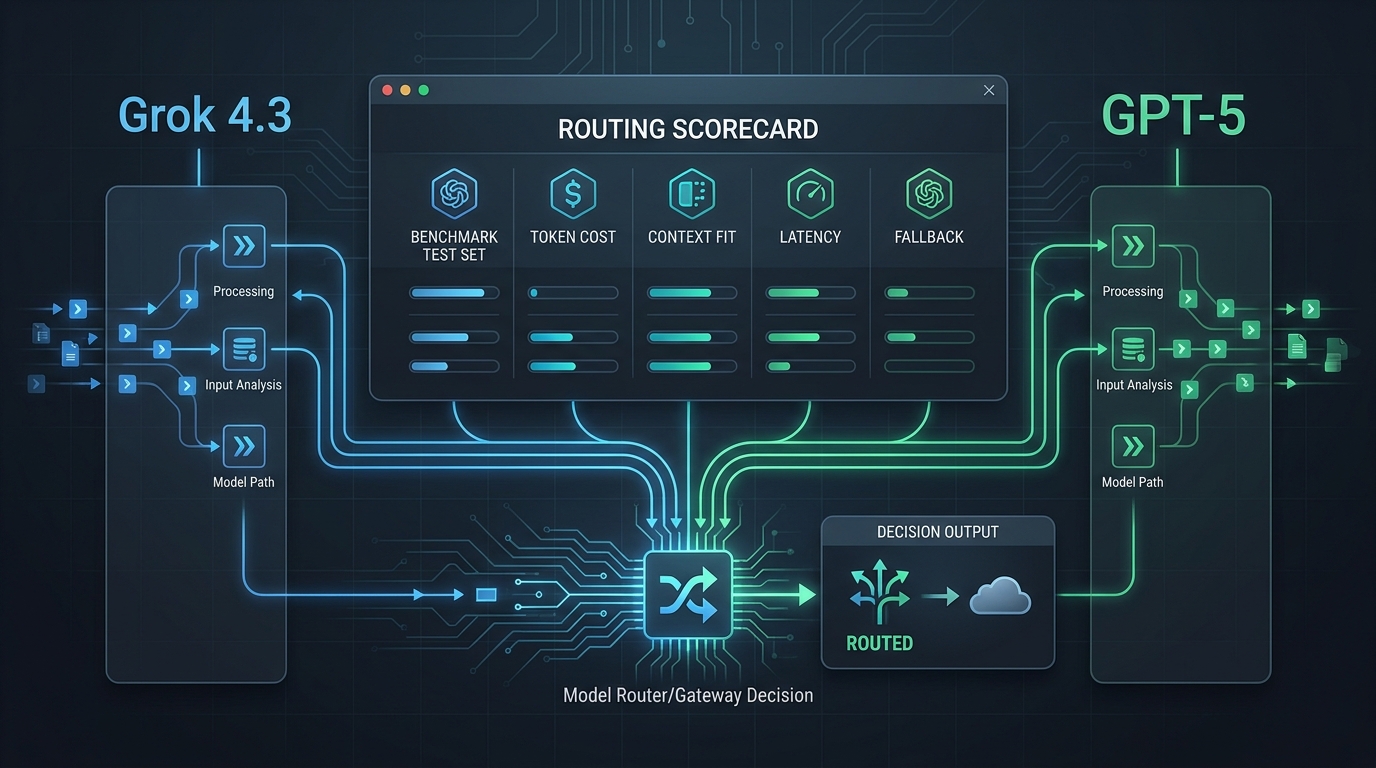
Grok 4.3 vs GPT-5: Benchmarks, Preços e Quando Encaminhar Cada Um
Um guia de encaminhamento baseado em fontes para equipes que comparam Grok 4.3 e GPT-5 em preços, contexto, design de benchmarks, momento de migração e quando usar um gateway.

Alugue um Servidor GPU: Guia de Arquitetura, Desempenho e Implantação na Nuvem
Saiba como alugar um servidor GPU com a alocação adequada, verificações de topologia, etapas de implantação e testes de aceitação antes de comprometer capacidade.

Rack de Servidores GPU: Arquitetura, Desempenho e Guia de Implementação na Nuvem
Um guia prático para mapear, validar e implementar capacidade de GPU em escala de rack para cargas de trabalho de IA.

Guia de APIs de remoção de PII (2026): comparação entre AWS, Google Cloud, Azure e Presidio para aplicações com LLMs
Uma API de remoção de PII identifica e mascara dados pessoais em texto. Compare Amazon Comprehend, Google Sensitive Data Protection, Azure Language PII e Presidio, com código, unidades de cobrança, resultados reais de detecção e um pipeline de remoção de PII para LLMs.

Inferência vs. Treinamento de IA: Desempenho, Custo e Trade-offs de Implantação
Entenda a inferência vs. o treinamento de IA: compare métricas de desempenho, fatores de custo, requisitos de implantação e quando ajustar ou servir um modelo.

O que é roteamento de LLM? Regras, pesos e políticas sensíveis a custos explicados
O que é roteamento de LLM? Saiba como regras, pontuações ponderadas, filtros de capacidade, fallbacks e avaliação tornam APIs multimodelo mais confiáveis.

Implantação Paralela por Especialistas do vLLM para DeepSeek e Outros Modelos MoE
Implante o paralelismo por especialistas do vLLM para DeepSeek e outros modelos MoE com as flags, a topologia, as verificações de backend e os testes de rollout adequados.

vLLM Docker: Arquitetura, Desempenho e Guia de Implementação na Nuvem
Guia de implementação do vLLM Docker para GPUs na nuvem: arquitetura, configuração compatível com OpenAI, ajuste de desempenho, escalabilidade multi-GPU e verificações de produção.

API unificada para modelos de IA: uma chave, endpoint e faturação
Um guia prático sobre APIs unificadas para consolidar o acesso a modelos, chaves, endpoints, utilização, faturação, encaminhamento e fallback sem perder opções nativas dos fornecedores.
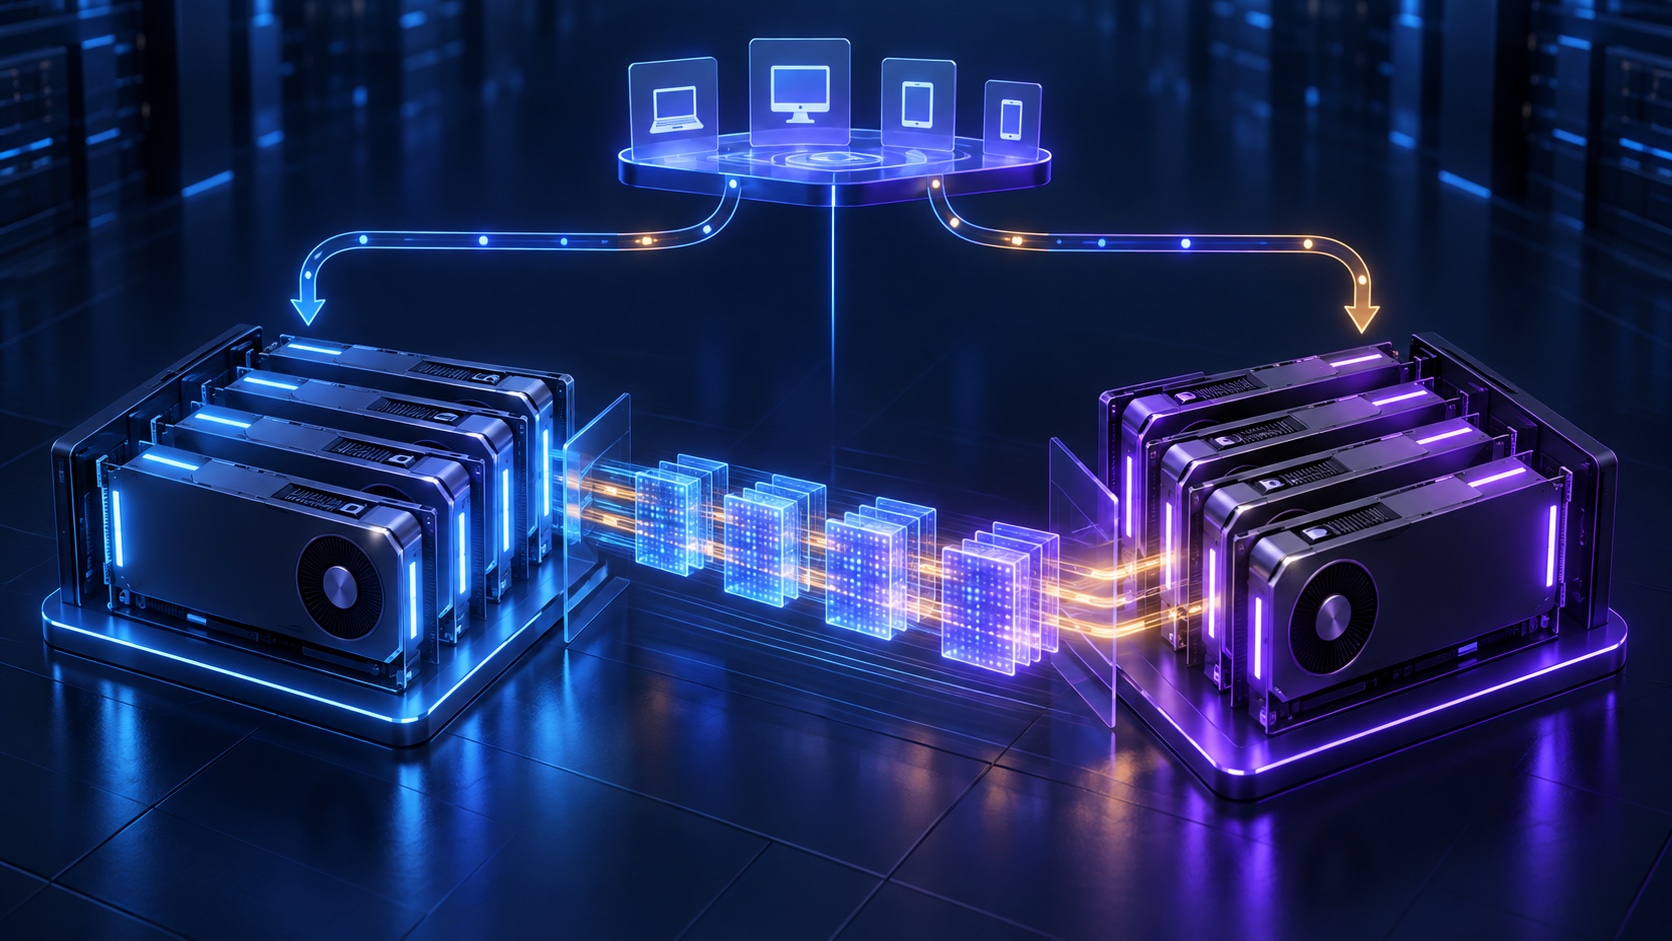
Desagregação de Prefill e Decode do SGLang: Guia de Arquitetura e Implantação
Implante a desagregação de prefill e decode do SGLang com pools de GPU separados, transferência de cache KV, métricas de validação, opções de topologia e verificações de rollout.

Notas sobre arquitetura

Custo de LLM Auto-Hospedado por Milhão de Tokens: Um Modelo Reproduzível de Custos de GPU
Um modelo reproduzível para calcular o custo de servir LLMs auto-hospedados com base na capacidade total da GPU, no throughput aceito, na utilização e na qualidade.

API da Perplexity AI: Acesso, Preços, Integração e Guia de Produção
Um guia baseado em fontes para escolher a interface certa da API da Perplexity, integrá-la corretamente, estimar custos e operá-la com segurança em produção.

URL Base da API OpenAI (2026): Endpoints Diretos e Compatíveis
A URL base oficial da API OpenAI, caminhos de endpoints comuns, configuração compatível com Flatkey, exemplos de código e correções para erros de /v1 duplicado ou 404.

Custo da API da OpenAI em 2026: Tabela de Preços e Calculadora
Um guia atualizado sobre o custo da API da OpenAI, com tabelas de preços do GPT-6, uma calculadora copiável, exemplos práticos, taxas ocultas e verificações de otimização.

Como obter uma chave de API da OpenAI e corrigir um erro 401 “Chave de API inválida”
Diagnostique com segurança erros 401 de chave de API inválida da OpenAI, incluindo endpoints incorretos, segredos desatualizados, chaves revogadas, controles de projeto e lista de permissões de IP.
Chave da API OpenAI gratuita? Limites, custos e trade-offs de produção
Uma chave da API OpenAI é uma credencial — não um orçamento de produção gratuito garantido. Saiba o que verificar sobre elegibilidade, créditos, limites, custos e controles de gastos antes do lançamento.

GPU Nvidia H200: Arquitetura, Desempenho e Guia de Implementação na Nuvem
Um guia prático para dimensionar, implementar, validar e operar capacidade de GPU Nvidia H200 para cargas de trabalho de IA e HPC na nuvem.
Crie mais rápido com um único gateway de IA.
Use a flatkey.ai para gerenciar modelos, chaves, cobrança e observabilidade em uma plataforma de API.
Começar