
Confiabilidade e roteamento
Artigos mais recentes em Confiabilidade e roteamento.

O que é roteamento de LLM? Regras, pesos e políticas sensíveis a custos explicados
O que é roteamento de LLM? Saiba como regras, pontuações ponderadas, filtros de capacidade, fallbacks e avaliação tornam APIs multimodelo mais confiáveis.
API de Proxy CLI: Acesso, Preços, Integração e Guia de Produção
Saiba o que faz uma API de proxy CLI, como funcionam o acesso e os custos do CLIProxyAPI, como testá-la com segurança e quando um gateway gerenciado é adequado para produção.
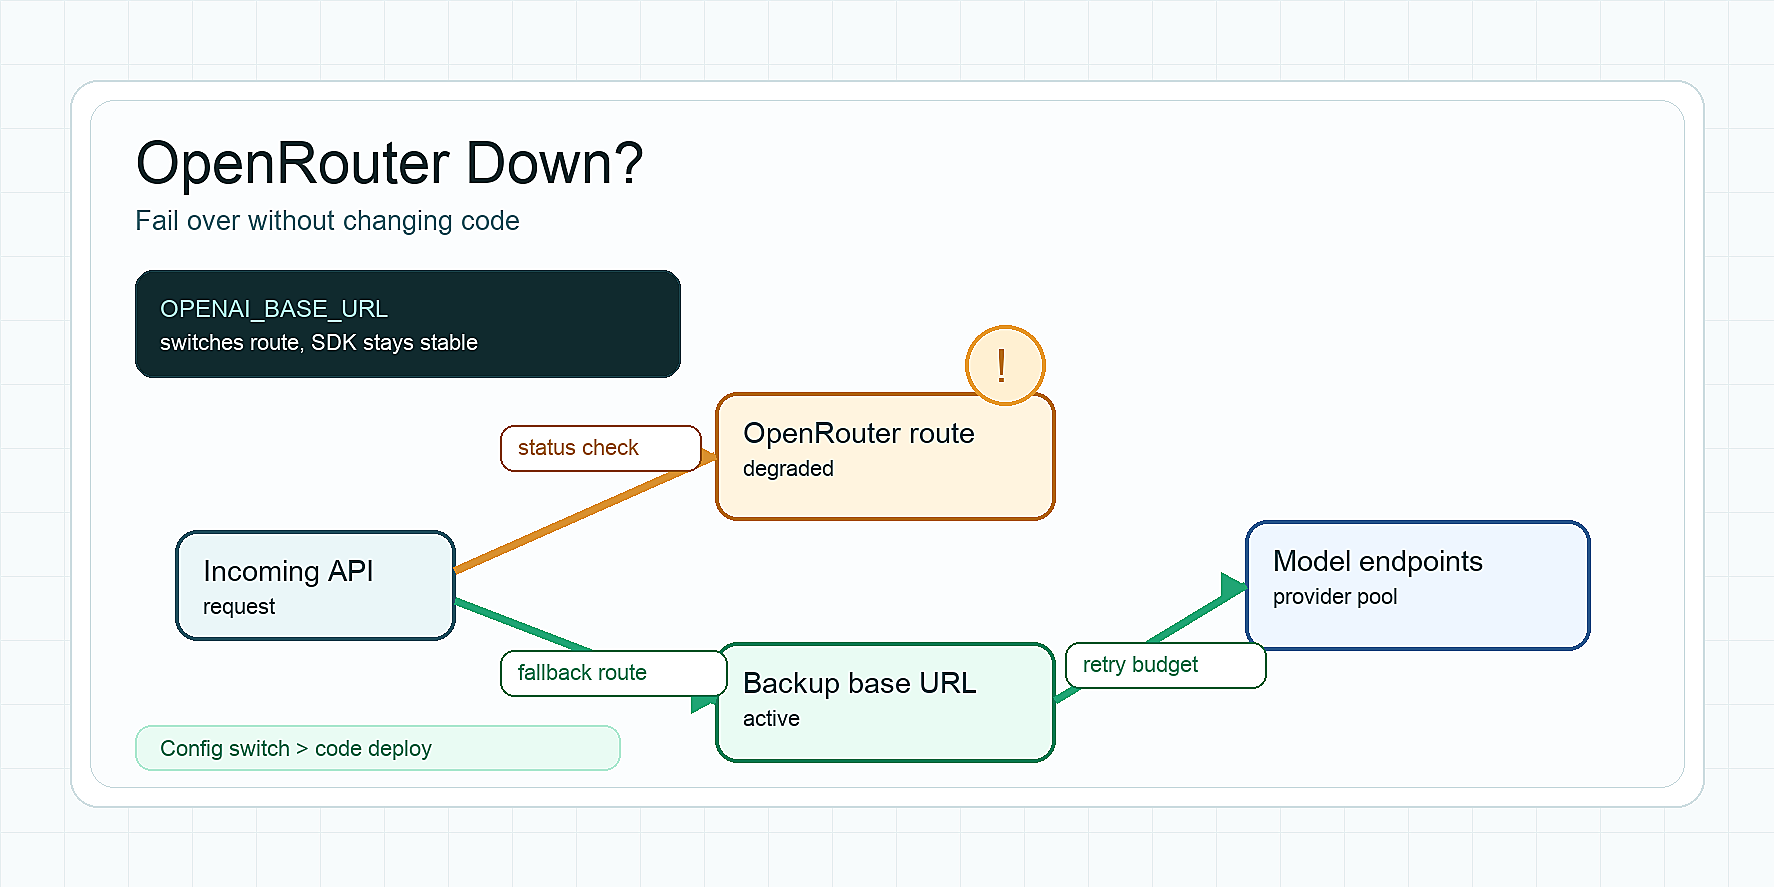
OpenRouter está fora do ar? Como fazer failover sem mudar o código
Verifique se o OpenRouter está fora do ar, diferencie erros do provedor de incidentes da plataforma e faça failover com base_url, retries, fallback de provedor e fallback de modelo.
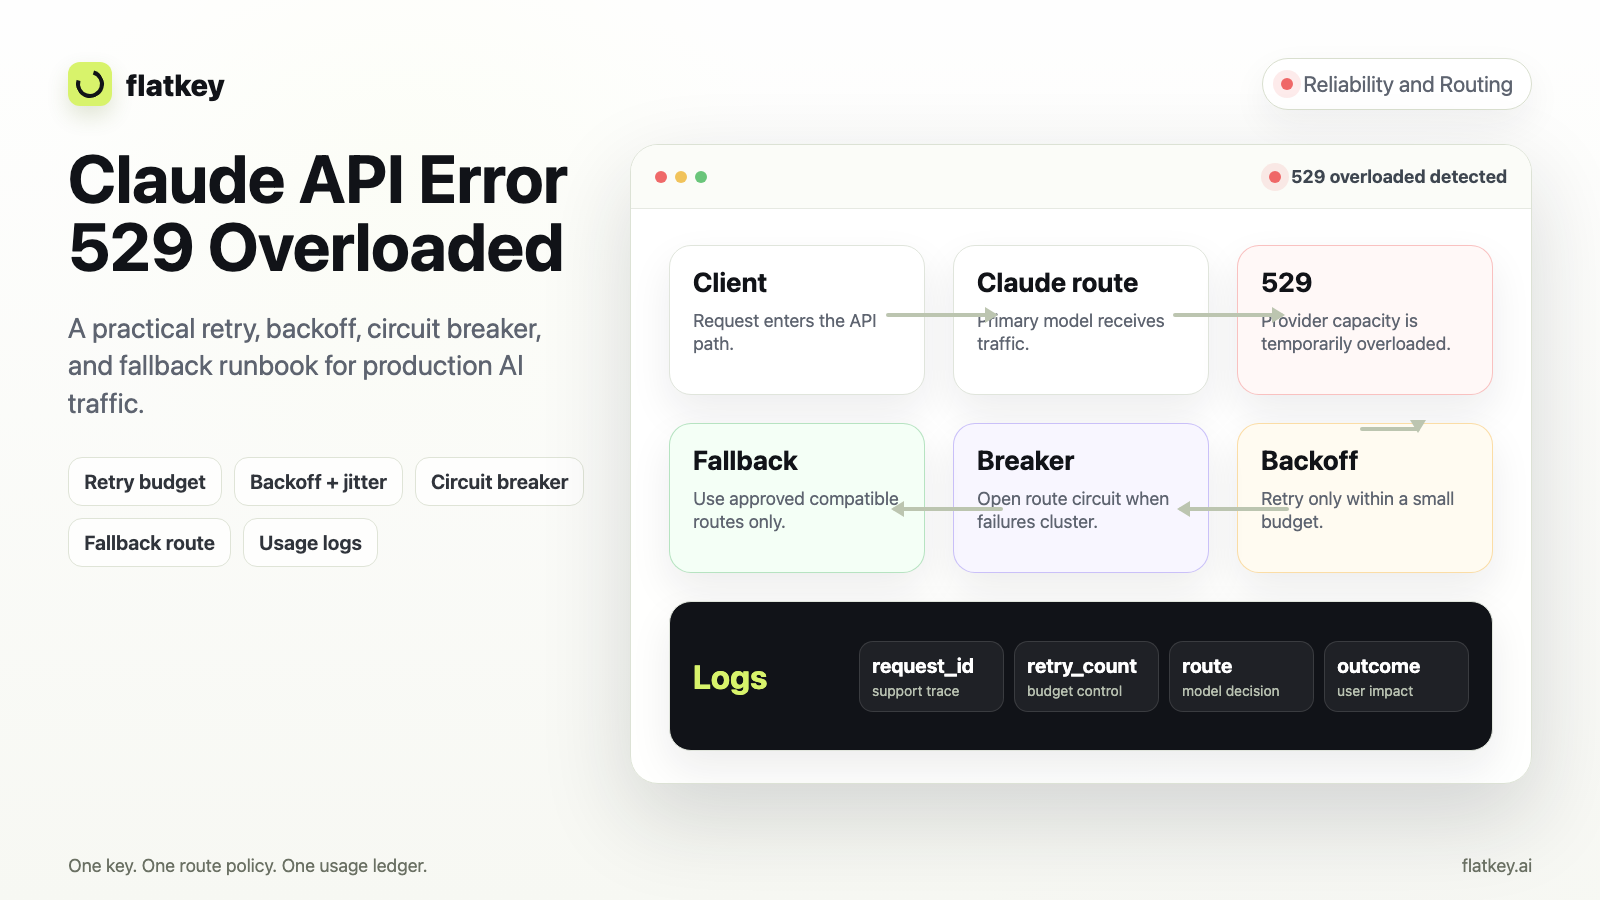
Erro 529 da Claude API por Sobrecarga: Runbook de Retry, Backoff e Fallback
Um runbook de produção para erros 529 de sobrecarga da Claude API: classifique a falha, defina orçamentos de retry, adicione backoff e jitter, proteja efeitos colaterais, aplique circuit breaker contra sobrecargas repetidas e escolha rotas de fallback seguras.
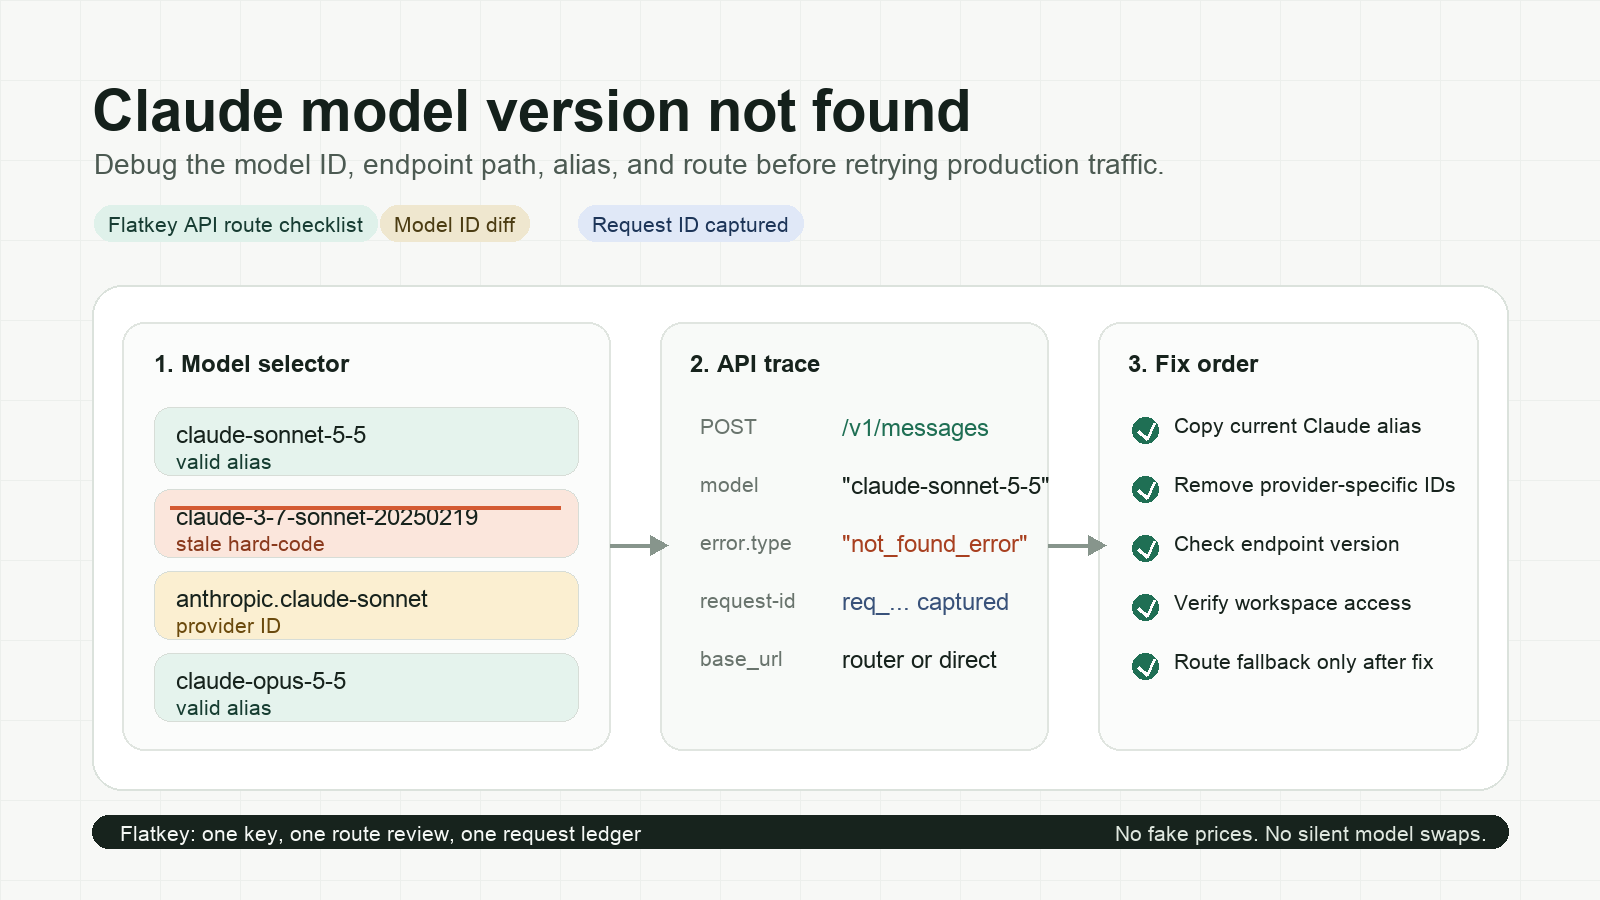
Versão do Modelo Claude Não Encontrada: Corrija IDs de Modelo, Aliases e Rotas da API
Um guia prático de depuração para erros de versão do modelo Claude não encontrada em APIs nativas da Anthropic, routers, IDs de provedores de nuvem, configurações de agentes e fallbacks de produção.
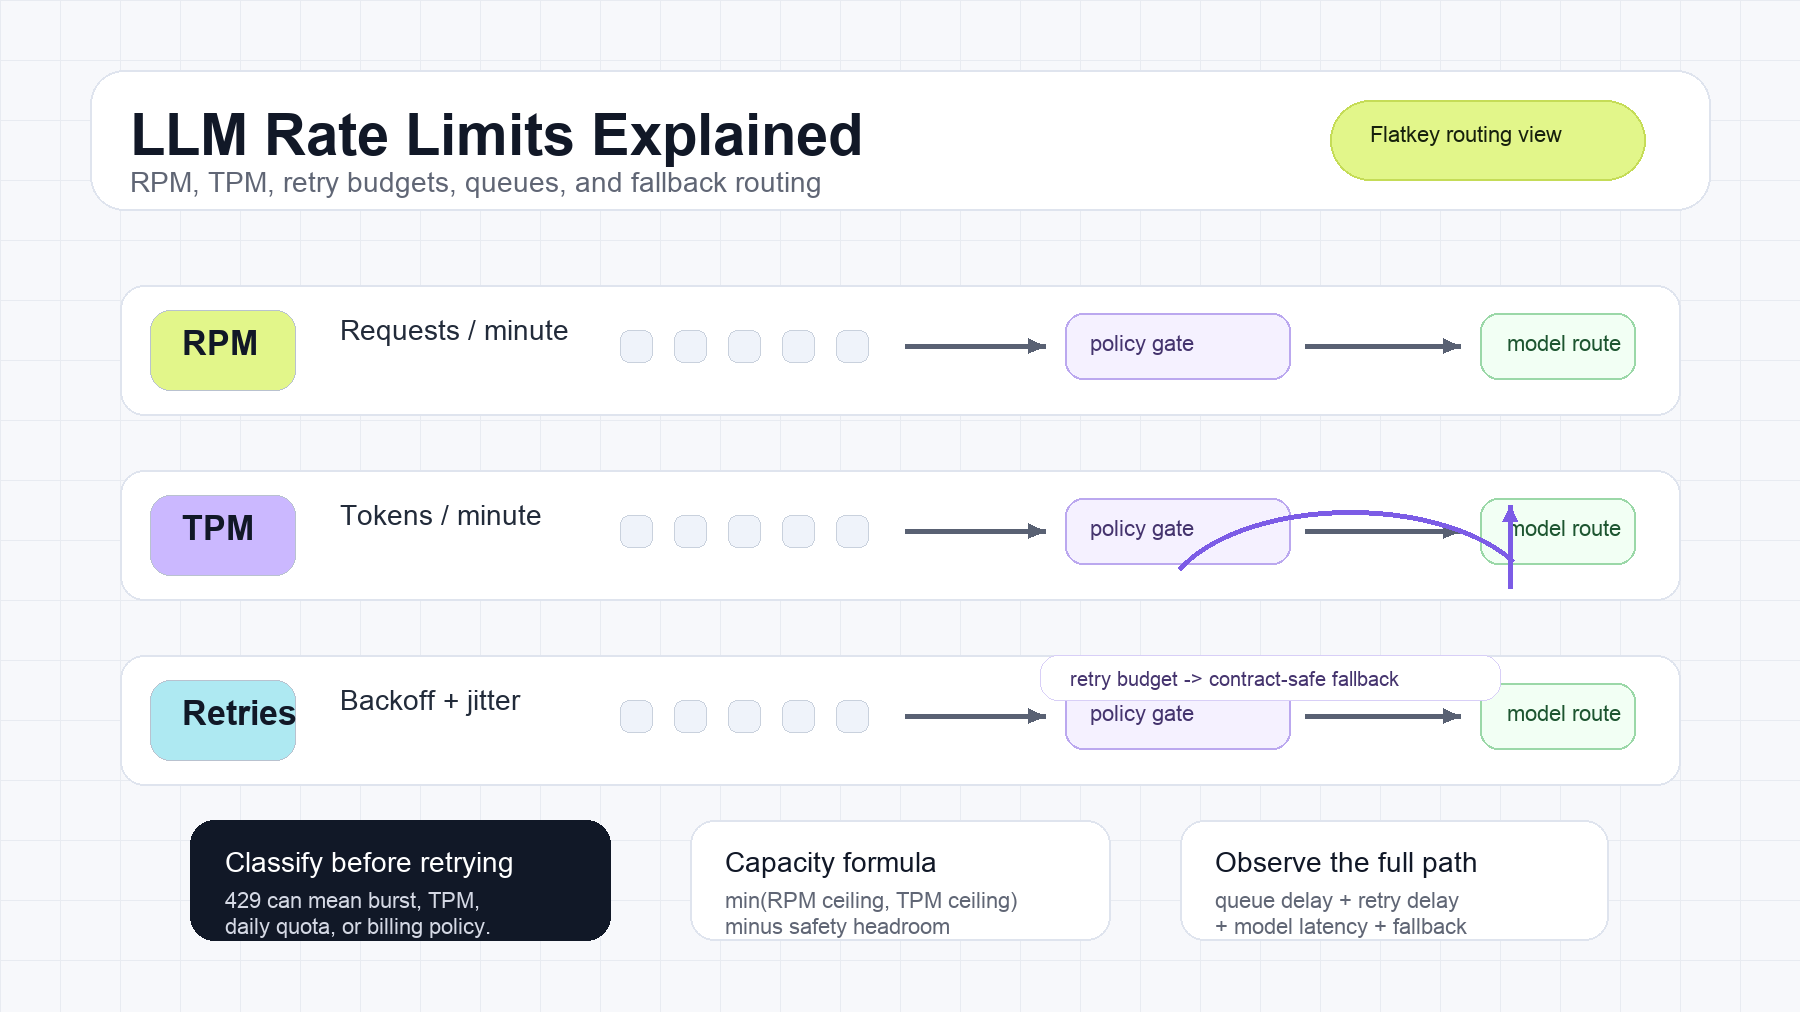
Limites de Taxa de LLM Explicados: RPM, TPM e Tentativas
Entenda os limites de taxa de LLM, RPM, TPM, erros 429, Retry-After, backoff exponencial, orçamentos de tentativas, filas e roteamento de fallback.
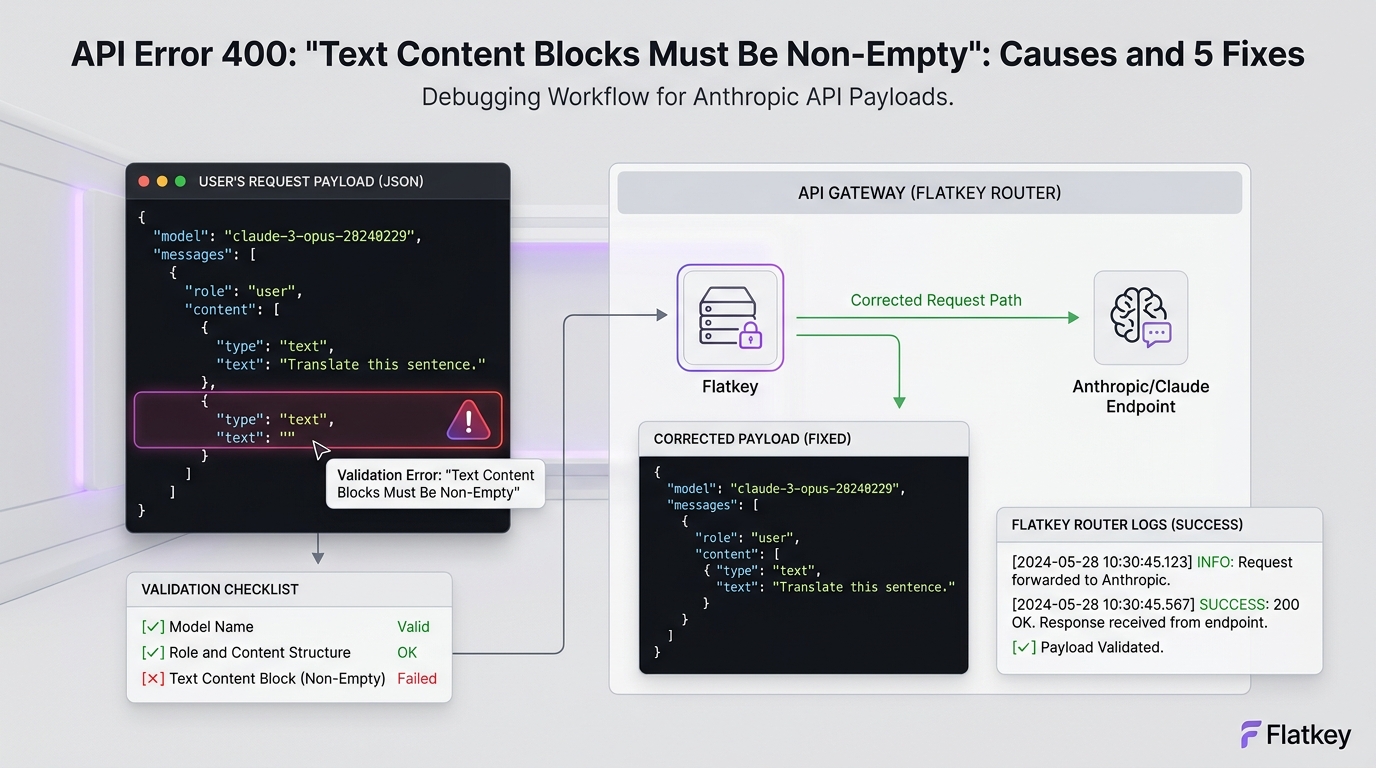
Erro de API 400 "Text Content Blocks Must Be Non-Empty": Causas e 5 Correções
Corrija o Erro de API 400 "Text Content Blocks Must Be Non-Empty" em solicitações Anthropic com verificações de payload, código de sanitização, exemplos de SDK e etapas de QA.
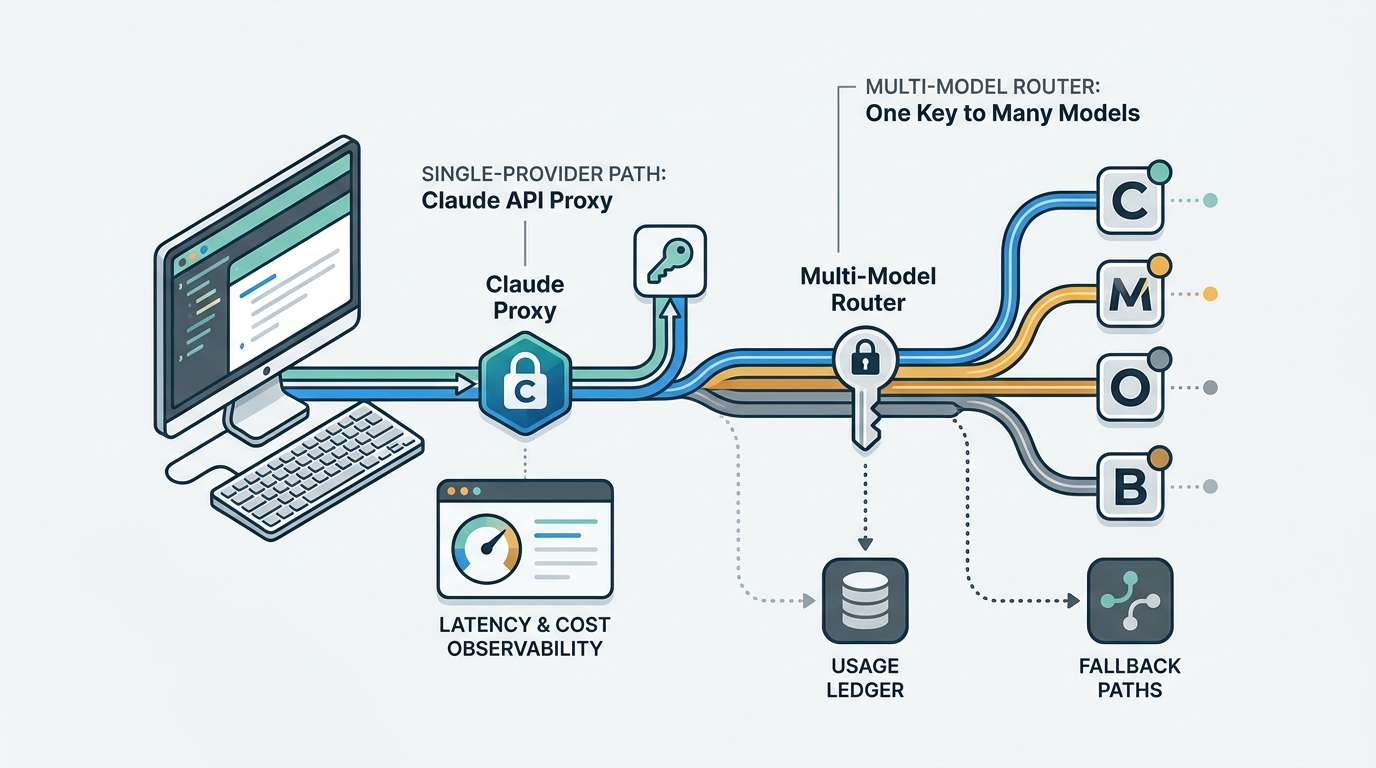
Proxy de API Claude vs Roteador Multimodelo: Quando Uma Chave Vence
Compare um proxy de API Claude com um roteador multimodelo. Use o scorecard, a checklist de migração e o teste de fumaça da Flatkey para decidir quando uma única chave vence.
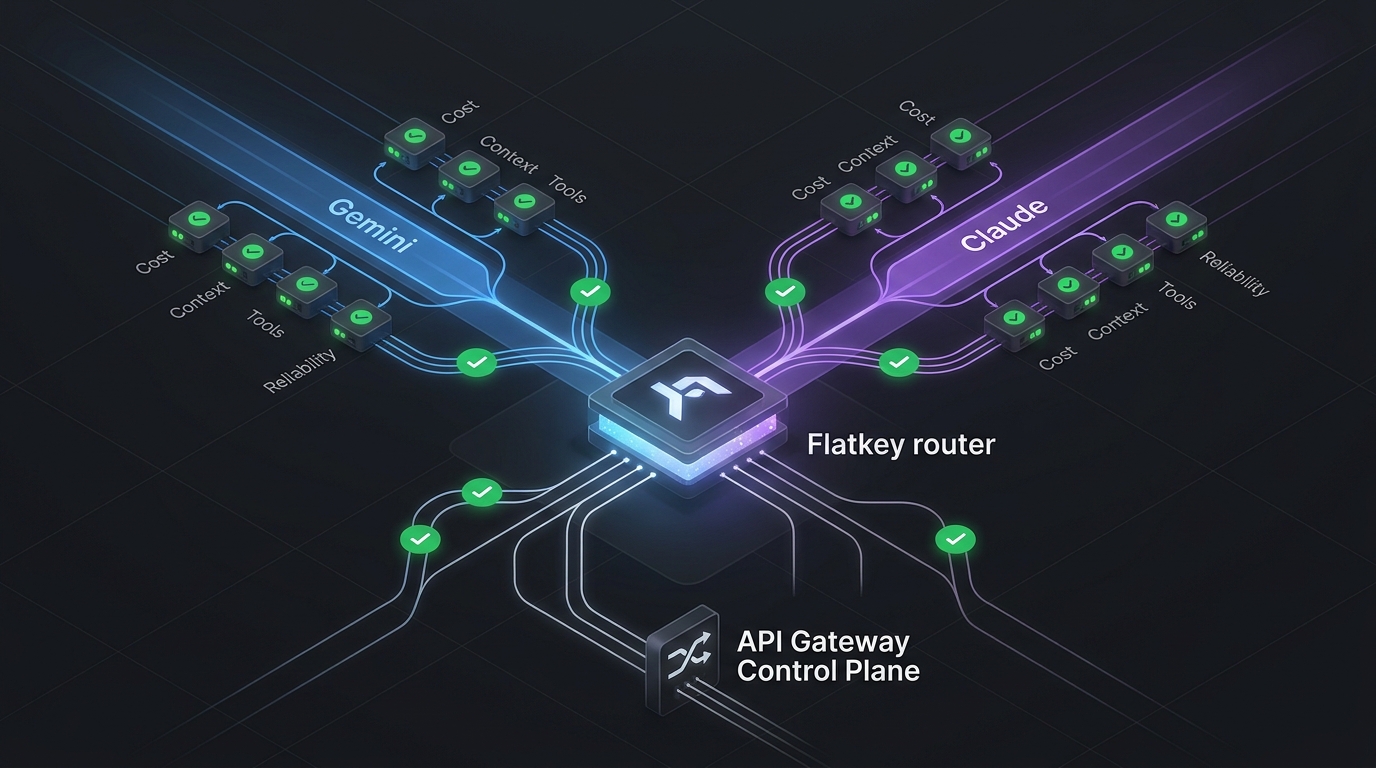
Gemini vs Claude (2026): qual IA você deve usar?
O Claude vence em escrita e programação com agentes; o Gemini vence em Google Workspace, pesquisa e mídia. Compare planos, modelos e preços oficiais da API (outubro de 2026) e teste os dois com uma única chave.
Métricas de API de LLM que realmente importam
Uma scorecard prática para medir a confiabilidade, a latência, o custo, as tentativas, os fallbacks, a eficiência de contexto e a auditabilidade da API de LLM.
Métricas de API de Roteamento de IA que Realmente Importam
Um scorecard prático para operadores medirem se uma API de roteamento de IA melhora confiabilidade, qualidade de fallback, latência, custo e observabilidade.
Métricas de API de Geração de Imagens que Realmente Importam
Use métricas práticas de API de geração de imagens como custo por imagem aceita, aderência ao prompt, sucesso na edição, latência, taxa de retry e impacto no negócio.
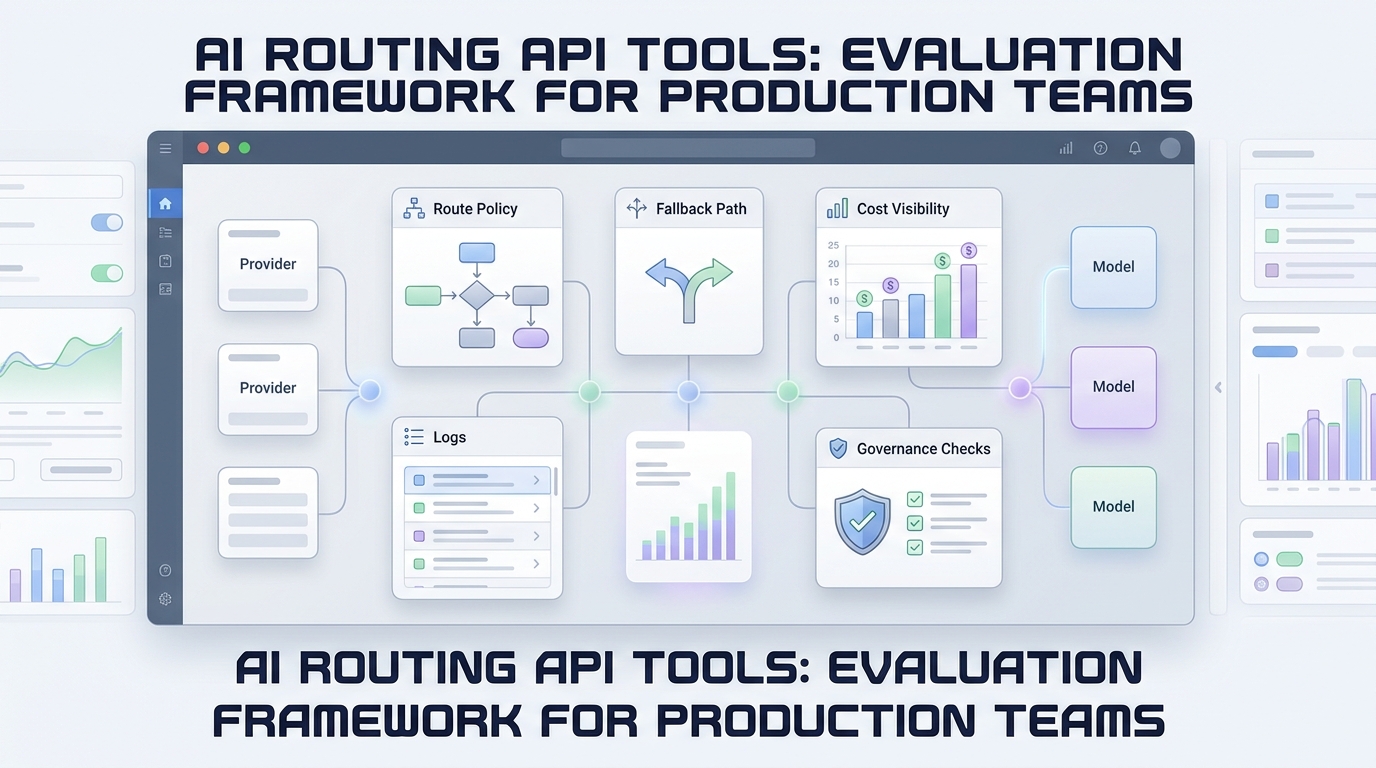
Ferramentas de API de Roteamento de IA: Estrutura de Avaliação para Equipes de Produção
Uma estrutura prática de avaliação para escolher ferramentas de API de roteamento de IA que realmente possam suportar tráfego em produção, controle de gastos e governança de rotas.
Estratégia de Fallback de Modelo: Um Playbook de 3 Fluxos de Trabalho
Um playbook de fallback de modelo em produção com policy as code, simulações de falha, um game day de 60 minutos, gates de release, gatilhos de rollback e regras seguras de recuperação.
Checklist de Implementação de Observabilidade de IA: 20 Etapas para Produção
Um checklist de implementação de observabilidade de IA em produção com 20 etapas de lançamento, um contrato de telemetria, padrão de código, runbook de alertas, testes de aceitação e transferência de responsabilidade.
Observabilidade de API LLM: métricas, traces, logs e custo
Um guia de produção para monitorar APIs LLM com métricas de sucesso validadas, traces distribuídos, logs estruturados seguros, SLOs, alertas e custo por tarefa aceita.
Roteamento de fallback para API de LLM: um playbook de failover em produção
Um playbook de produção para decidir quando as solicitações a LLM devem tentar novamente, fazer failover, trocar de modelo ou parar — sem quebrar streams, ferramentas, schemas ou orçamentos de latência.
Checklist de Prontidão para Produção da Gemini API para Equipes de Backend
Uma checklist de prontidão para produção para equipes de backend que integram a Gemini API, cobrindo credenciais, contratos de resposta, retries, observabilidade, custos, rollout e incidentes.
Crie mais rápido com um único gateway de IA.
Use a flatkey.ai para gerenciar modelos, chaves, cobrança e observabilidade em uma plataforma de API.
Começar