Grok 4.3 vs GPT-5: Benchmarks, Preços e Quando Encaminhar Cada Um
Grok 4.3 vs GPT-5: Benchmarks, Preços e Quando Encaminhar Cada Um é uma questão de roteamento de modelos legados em outubro de 2026. A OpenAI programou a remoção do ID de modelo gpt-5 e do snapshot gpt-5-2025-08-07 em 11 de dezembro de 2026. Sua tabela de migração aponta para gpt-5.6-sol, enquanto a orientação atual sobre modelos recomenda o GPT-6 Astra para uma nova carga de trabalho complexa de raciocínio ou programação. As notas de lançamento da xAI agora listam o Grok 4.7 como a rota Grok de fronteira atual. Ainda assim, muitas equipes precisam comparar o Grok 4.3 e o GPT-5 porque agentes, painéis, benchmarks e notas de compras mais antigos foram criados em torno desses nomes.
A resposta curta: use primeiro o Grok 4.3 quando uma carga de trabalho se beneficiar de seu menor preço de saída listado, maior janela de contexto documentada e controles de raciocínio compatíveis com xAI. Use primeiro o GPT-5 quando seu aplicativo depender do comportamento nativo da Responses API da OpenAI, de ferramentas hospedadas, cache de prompts, compatibilidade com Chat Completions ou de uma base de avaliação OpenAI existente. Use um roteador quando o problema real não for apenas a qualidade do modelo, mas alternar modelos sem espalhar chaves, faturas, logs e código de fallback por todos os serviços.
Não tome essa decisão apenas com base em rótulos de benchmarks públicos. Compare os modelos na sua carga de trabalho e, em seguida, encaminhe por custo por saída aceita.
Comparação rápida: Grok 4.3 vs GPT-5
| Área de decisão | Grok 4.3 | GPT-5 | Nota de roteamento |
|---|---|---|---|
| Status de atualidade | Rota Grok mais antiga; as notas de lançamento da xAI agora destacam o Grok 4.7 como atual. | Descontinuado; a OpenAI programou a remoção de gpt-5 e gpt-5-2025-08-07 em 11 de dezembro de 2026. |
Trate ambos como rotas legadas; planeje a migração do GPT-5 antes da data de remoção. |
| ID do modelo | grok-4.3, alias grok-4.3-latest. |
gpt-5, snapshot padrão gpt-5-2025-08-07. |
Fixe o ID exato do modelo ou o snapshot para testes reproduzíveis. |
| Entrada e saída | Entrada de texto e imagem; saída de texto. | Entrada de texto e imagem; saída de texto. | Ambos podem atender a fluxos de trabalho de texto assistidos por visão; nenhum é uma rota de vídeo. |
| Contexto | A xAI lista uma janela de contexto de 1M, com preços de contexto longo acima de 200 mil tokens de prompt. | A OpenAI lista uma janela de contexto de 400 mil, máximo de 272 mil tokens de entrada e máximo de 128 mil tokens de saída. | Teste o contexto utilizável, não apenas o número de contexto em destaque. |
| Preço de texto listado | US$ 1,25 / US$ 0,20 em cache / US$ 2,50 de saída por 1M de tokens abaixo de 200 mil tokens de prompt; US$ 2,50 / US$ 0,40 / US$ 5,00 com mais de 200 mil tokens de prompt. | US$ 1,25 / US$ 0,125 em cache / US$ 10 de saída por 1M de tokens. | O Grok 4.3 é mais barato no preço de saída listado; o GPT-5 tem entrada em cache mais barata. |
| Lote | A xAI marca o Grok 4.3 como habilitado para lote, com desconto de 20% para lote. | A OpenAI indica suporte a GPT-5 Batch. | O processamento em lote só ajuda quando uma resposta atrasada é aceitável. |
| Ferramentas | A documentação da xAI lista chamada de funções, saídas estruturadas, raciocínio e opções de esforço de raciocínio. | A documentação da OpenAI lista streaming, saídas estruturadas, chamada de funções, busca de arquivos, entrada de imagem, busca na web, cache de prompts e ferramentas compatíveis da Responses API. | O GPT-5 costuma ser mais forte quando ferramentas hospedadas pela OpenAI fazem parte do requisito. |
Esse é o ponto de partida prático de benchmark para Grok 4.3 vs GPT-5: Benchmarks, Preços e Quando Encaminhar Cada Um. As especificações públicas sugerem diferentes perfis de custo e contexto, mas o vencedor em produção é a rota que passa no seu validador com o menor custo por saída aceita.
Faça benchmark da rota, não do nome do modelo
Classificações públicas de modelos são úteis para descoberta, mas raramente respondem à pergunta de produção. Uma pontuação de benchmark não informa se uma rota preserva seu esquema exato, se recupera de limites de taxa, se registra o uso no lugar certo ou se permanece dentro do orçamento após tentativas.
Crie um pequeno conjunto de benchmarks antes de mover o tráfego:
| Trilha de benchmark | O que testar | Por que isso altera a rota |
|---|---|---|
| Raciocínio e programação | 50 a 200 prompts reais de fluxos de trabalho de agentes, programação, análise ou suporte. | Uma vitória em benchmark geral pode não se transferir para o formato dos seus prompts. |
| Saída estruturada | Esquema JSON obrigatório, campos de enumeração, objetos aninhados e casos de entrada inválida. | O modelo que escreve uma prosa melhor ainda pode falhar no seu analisador. |
| Chamadas de ferramentas | Casos de ferramenta obrigatória, sem ferramenta, ferramenta errada e erro de ferramenta. | Uma ação incorreta pode custar mais do que um preço de token mais alto. |
| Contexto longo | Pacotes de recuperação p50, p90 e de pior caso. | Uma janela de contexto grande não é o mesmo que recuperação confiável. |
| Custo | Tokens de entrada, tokens em cache, tokens de saída, modo em lote, tentativas e saídas rejeitadas. | O preço de token listado é incompleto sem a taxa de aceitação. |
| Latência | Tempo até o primeiro token, latência da resposta completa, taxa de timeout e comportamento de enfileiramento. | Agentes voltados ao usuário podem precisar de uma rota mais rápida, mesmo que custe mais. |
| Fallback | Erros do provedor, 429, modelo não encontrado, falha de esquema, timeout e saída degradada. |
Uma rota sem regra de reversão não está pronta para produção. |
A métrica da rota deve ser:
cost_per_accepted_output =
  (input_cost + cached_input_cost + output_cost + tool_cost + retry_cost + fallback_cost)
  / accepted_outputs
Use o Grok 4.3 quando ele vencer essa fórmula para uma carga de trabalho com margem suficiente de qualidade e latência. Use o GPT-5 quando o comportamento nativo da OpenAI reduzir o risco de implementação, as falhas de validação ou o custo de integração o suficiente para compensar o preço de saída listado.
Preços: onde o Grok 4.3 é mais barato e onde o GPT-5 ainda pode vencer
Para solicitações de texto com contexto curto, a xAI lista o Grok 4.3 a US$ 1,25 para entrada, US$ 0,20 para entrada em cache e US$ 2,50 para saída por 1 milhão de tokens. Com 200 mil ou mais tokens de prompt, a xAI lista preços mais altos para contexto longo: US$ 2,50 para entrada, US$ 0,40 para entrada em cache e US$ 5,00 para saída por 1 milhão de tokens. A xAI também indica que o Grok 4.3 é compatível com processamento em lote, com desconto de 20% para lote.
A OpenAI lista o GPT-5 a US$ 1,25 para entrada, US$ 0,125 para entrada em cache e US$ 10 para saída por 1 milhão de tokens. Isso torna o GPT-5 mais caro em tokens de saída listados, mas mais barato em entrada em cache do que a faixa de entrada em cache para contexto curto do Grok 4.3.
A decisão de preço muda conforme o formato da carga de trabalho:
| Formato da carga de trabalho | Pressão de preço | Primeiro teste provável |
|---|---|---|
| Prompt curto, resposta gerada longa | O preço de saída domina. | Teste primeiro o Grok 4.3 e depois compare a taxa de aceitação das saídas. |
| Prompt de sistema grande ou pacote de políticas repetido | A entrada em cache importa. | Teste ambos; a entrada em cache do GPT-5 pode importar se a taxa de acerto do cache for alta. |
| Pacote de recuperação longo com mais de 200 mil tokens de prompt | Aplicam-se os preços de contexto longo. | Teste o Grok 4.3 incluindo o preço de contexto longo e a latência. |
| Ferramentas hospedadas pela OpenAI ou fluxo de trabalho da Responses API | O comportamento das ferramentas e da integração importa. | Teste primeiro o GPT-5, pois o suporte direto a recursos pode reduzir a complexidade do aplicativo. |
| Avaliações offline ou preenchimentos retroativos | A economia de lote importa. | Teste ambos os caminhos em lote se a conclusão com atraso for aceitável. |
Se você comparar apenas o preço de entrada listado, Grok 4.3 vs GPT-5: Benchmarks, Preços e Quando Encaminhar Cada Um se torna um exercício enganoso de planilha. O comprimento da saída, a taxa de tentativas, falhas de ferramentas e a revisão humana podem eliminar a economia aparente.
Quando encaminhar para o Grok 4.3
Comece com o Grok 4.3 quando a carga de trabalho for sensível a custos, intensiva em saída e não estiver vinculada a ferramentas nativas da OpenAI.
Bons candidatos incluem:
- Tarefas internas de análise em que a saída de texto é longa e a validação é simples.
- Resumização de contexto longo em que a janela de contexto documentada de 1 milhão é útil e o preço de contexto longo ainda supera as alternativas.
- Trabalhos de avaliação em que o processamento em lote é aceitável e se aplica um desconto de 20% para lote.
- Fluxos de trabalho que usam chamada de função ou saídas estruturadas, mas não exigem ferramentas hospedadas pela OpenAI.
- Experimentos com modelos em que você deseja uma rota da família Grok para comparação com GPT, Claude, Gemini, DeepSeek ou Qwen.
Antes do lançamento, verifique a rota exata do Grok no console do provedor ou no catálogo do gateway. A xAI tem rotas Grok mais recentes, e o conhecimento local atual da Flatkey confirma grok-4.2, e não grok-4.3; portanto, não presuma que o Grok 4.3 esteja disponível por meio de um gateway até que o catálogo ativo confirme isso.
Quando encaminhar para o GPT-5
Comece com o GPT-5 quando a carga de trabalho depender da superfície de API da OpenAI ou quando seu histórico de avaliações já usar o GPT-5 como referência.
Bons candidatos incluem:
- Aplicativos existentes da OpenAI Chat Completions ou Responses API que não devem ser reescritos para um experimento de modelo.
- Cargas de trabalho que usam ferramentas hospedadas pela OpenAI, como pesquisa na web, pesquisa de arquivos, geração de imagens, interpretador de código ou MCP pela Responses API.
- Produtos que dependem do cache de prompts da OpenAI, de saídas estruturadas, de streaming ou de controles de projeto específicos da OpenAI.
- Testes de regressão em que snapshots anteriores do GPT-5 fazem parte da base de aceitação.
- Auditorias de migração em que o GPT-5 é a rota de referência estável antes de migrar para um modelo mais novo.
Observação com prazo definido: a OpenAI programou a remoção de gpt-5 e gpt-5-2025-08-07 em 11 de dezembro de 2026. Use esta comparação para validação de migração, não como padrão para uma nova implantação. O destino de migração documentado é gpt-5.6-sol; a orientação atual de modelos da OpenAI recomenda o GPT-6 Astra para uma nova carga de trabalho complexa de raciocínio ou programação.
A OpenAI documenta o GPT-5 como um modelo anterior. Se você estiver iniciando um novo projeto, compare também o modelo atualmente recomendado pela OpenAI. O GPT-5 ainda pode ser útil quando a questão é uma rota legada fixada, mas não deve ser tratado como a resposta padrão para um novo desenvolvimento sem uma revisão atual dos modelos.
Quando um roteador é a melhor resposta
As equipes frequentemente perguntam se o Grok 4.3 ou o GPT-5 é melhor, mas o verdadeiro gargalo é a proliferação operacional:
- Chaves de provedores separadas.
- Painéis e faturas separados.
- Políticas de limite de taxa separadas.
- Verificações de status separadas.
- Exportações de uso separadas.
- Diferentes IDs de modelo codificados diretamente em agentes e serviços.
- Nenhuma regra de fallback compartilhada quando um provedor apresenta degradação.
O posicionamento da Flatkey é construído para essa camada: uma chave, um saldo, uma fatura, acesso oficial aos modelos, registros de uso e um roteador compatível com a OpenAI. Isso não significa que todos os recursos nativos de cada provedor funcionem automaticamente por todas as rotas. Significa que a equipe obtém uma única superfície operacional para comparar modelos compatíveis e revisar evidências de uso.
Combine este artigo com o guia do catálogo de modelos de IA, a estrutura de métricas de API de roteamento de IA e o guia de início rápido da API Flatkey antes de alterar o tráfego de produção.
Um scorecard prático de roteamento
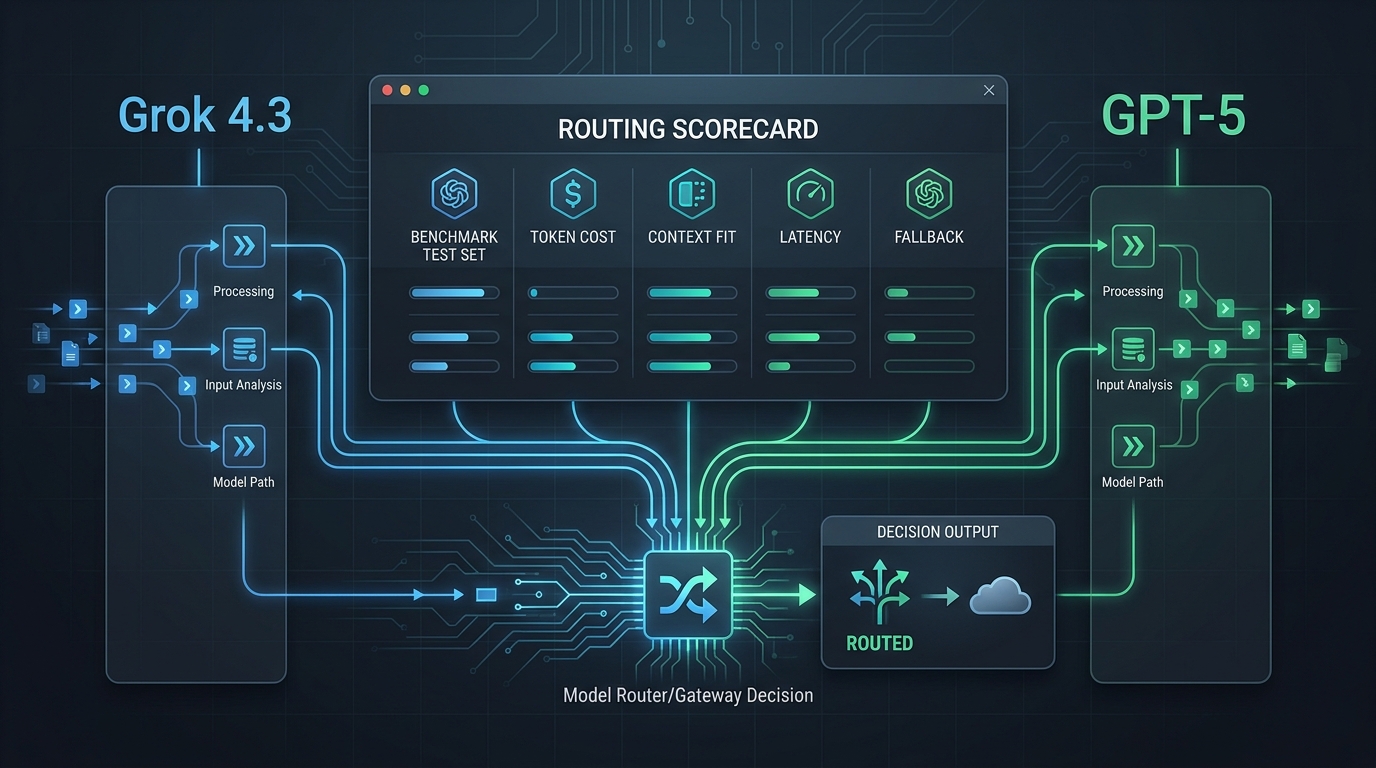
Use este scorecard para Grok 4.3 vs GPT-5: Benchmarks, Preços e Quando Encaminhar Cada Um. Avalie cada rota de 1 a 5 para a mesma carga de trabalho.
| Critério | Peso | Grok 4.3 | GPT-5 | Observações |
|---|---|---|---|---|
| Taxa de saídas aceitas | 25% | A resposta passa no seu validador ou na sua rubrica de revisão? | ||
| Custo por saída aceita | 20% | Inclua tamanho do prompt, comprimento da saída, cache, lote, ferramentas, tentativas e saídas rejeitadas. | ||
| Confiabilidade de ferramentas e esquema | 15% | Conte JSON inválido, chamadas de ferramenta incorretas, campos ausentes e parâmetros não compatíveis. | ||
| Confiabilidade de contexto | 15% | Teste pacotes de recuperação p50, p90 e de pior caso. | ||
| Latência e timeouts | 10% | Meça TTFT, tempo de conclusão total e taxa de timeout. | ||
| Observabilidade | 10% | A engenharia e as finanças conseguem inspecionar provedor, modelo, tokens, custo, latência e erros? | ||
| Prontidão de fallback | 5% | O rollback foi testado e documentado? |
Em seguida, escreva um registro de rota:
route_review:
  workload: support_case_summarization
  candidates:
    - grok-4.3
    - gpt-5
  required_features:
    - structured_output
    - streaming
    - usage_readback
  launch_rule:
    minimum_score: 4
    accepted_output_rate: ">= target set by owner"
    rollback_path_required: true
  stop_conditions:
    - schema_failure_rate_above_threshold
    - timeout_rate_above_threshold
    - cost_per_accepted_output_above_budget
Essa política é mais útil do que uma captura de tela de um ranking, pois informa à sua aplicação o que fazer quando um modelo está indisponível, é lento demais, caro demais ou inadequado para a tarefa.
Checklist de pré-voo antes de mover o tráfego
Execute estas verificações antes de direcionar usuários reais para qualquer um dos modelos:
- Confirme a disponibilidade do modelo. Verifique o console do provedor direto e qualquer catálogo de gateway no mesmo dia do lançamento.
- Fixe os IDs de modelo. Use
grok-4.3intencionalmente. Para o tráfego GPT-5 existente, fixegpt-5-2025-08-07apenas enquanto conclui uma migração validada; tanto ele quantogpt-5estão programados para remoção em 11 de dezembro de 2026. - Verifique a família de endpoints. Confirme se a carga de trabalho usa rotas compatíveis com xAI, OpenAI Chat Completions, OpenAI Responses, batch ou endpoints de gateway.
- Teste os recursos necessários. Ferramentas, saídas estruturadas, entrada de imagem, streaming, cache e batch devem ser testados somente se a sua carga de trabalho realmente precisar deles.
- Meça o contexto utilizável. Verifique a recuperação e a disciplina de citações em tamanhos de contexto realistas.
- Calcule o custo por saída aceita. Inclua tentativas, saídas rejeitadas e revisão humana.
- Registre cada rota. Registre provedor, modelo, ID da solicitação, tokens de entrada, tokens de saída, tokens de cache, latência, status e custo.
- Defina o fallback. Decida quando tentar novamente, trocar de rota, enfileirar, degradar a saída ou falhar de forma fechada.
- Atribua responsabilidade. Dê a alguém a responsabilidade por chaves, orçamento, cota, saúde da rota e rollback.
- Execute novamente após alterações no modelo. Novos lançamentos de Grok ou GPT podem tornar esta comparação desatualizada rapidamente.
FAQ: variantes GPT-5.4 e GPT-5.5
O que muda quando a comparação é Grok 4.3 vs GPT-5.4 ou GPT-5.5?
Não substitua gpt-5.4 ou gpt-5.5 na coluna do GPT-5 e presuma os mesmos resultados. Cada versão do modelo tem sua própria disponibilidade, preço, limites de contexto e status de migração. Se estiver migrando uma carga de trabalho GPT-5 existente, use esta comparação para elaborar a avaliação e, em seguida, compare o Grok 4.3 com a substituição exata compatível da OpenAI em seus próprios prompts. Para uma nova implementação, comece pelas orientações atuais de modelos da OpenAI, em vez do ID de modelo GPT-5 descontinuado.
Verificações de fontes a manter abertas
Use a documentação ativa ao finalizar uma rota:
- Documentação do modelo GPT-5 da OpenAI para status, snapshot, contexto, endpoints, recursos e resumo de preços do GPT-5.
- Preços da API OpenAI para linhas atuais de preços de tokens de texto e ressalvas sobre modos regionais/rápidos.
- Modelos e preços da xAI para contexto, preços, batch, modalidades e controles de raciocínio do Grok 4.3.
- Notas de lançamento da xAI para informações atualizadas sobre os modelos Grok.
- Ranking de modelos da Artificial Analysis para métricas de descoberta de modelos de terceiros, não como substituto para seus próprios benchmarks de rota.
Em resumo
Para Grok 4.3 vs GPT-5: Benchmarks, Preços e Quando Encaminhar Cada Um, o Grok 4.3 costuma ser o primeiro teste de preço quando os tokens de saída predominam e as ferramentas nativas da OpenAI não são necessárias. O GPT-5 costuma ser o primeiro teste de integração quando sua aplicação depende da Responses API da OpenAI, de ferramentas hospedadas, de cache de prompts ou de uma base existente do GPT-5.
Para produção, mantenha as duas decisões separadas: primeiro escolha o modelo que atende à sua carga de trabalho e, depois, escolha a rota que oferece logs, controle de custos, fallback e um caminho de reversão claro. É aí que um roteador unificado mostra seu valor.
Se o Gemini também estiver na sua lista, leia Grok vs Gemini (outubro de 2026) para comparar preços de assinaturas e APIs.