title: "Inferência vs. Treinamento de IA: Desempenho, Custo e Trade-offs de Implantação" slug: ai-inference-vs-training canonical_url: https://flatkey.ai/blog/ai-inference-vs-training meta_title: "Inferência vs. Treinamento de IA: Custo, Desempenho e Implantação" meta_description: "Entenda inferência vs. treinamento de IA: compare métricas de desempenho, fatores de custo, requisitos de implantação e quando fazer fine-tuning ou disponibilizar um modelo." category: "Custos, Cobrança e Operações"
Inferência vs. Treinamento de IA: Desempenho, Custo e Trade-offs de Implantação
A escolha entre inferência e treinamento de IA não é uma escolha entre duas tarefas intercambiáveis de GPU. O treinamento altera um modelo; a inferência usa um modelo treinado para produzir um resultado. Essa distinção muda o que você mede, pelo que paga e como opera a carga de trabalho.
Para a maioria das equipes de produto, a primeira pergunta útil não é “Qual GPU é mais rápida?”. É: Precisamos criar ou adaptar o comportamento de um modelo, ou disponibilizar um modelo capaz aos usuários de forma confiável? O primeiro caso é um problema de treinamento ou fine-tuning. O segundo é um problema de inferência e disponibilização do modelo.
O Google Cloud descreve o treinamento como o processo de otimização de um modelo a partir de dados, enquanto a inferência aplica um modelo treinado a novas entradas. Ele também faz uma distinção útil entre inferência — a computação — e serving — o sistema que disponibiliza e opera essa computação para atender a requisições. Leia a visão geral sobre inferência de IA.
Inferência vs. treinamento de IA em resumo
| Dimensão | Treinamento | Inferência |
|---|---|---|
| Objetivo principal | Aprender ou adaptar parâmetros do modelo | Produzir previsões, classificações ou conteúdo gerado a partir de parâmetros fixos |
| Ciclo principal | Passagem direta, cálculo da perda, retropropagação, atualização pelo otimizador | Processamento da entrada, passagem direta e, durante a geração, decodificação token a token |
| Dados de entrada | Conjuntos de dados históricos, rótulos ou recompensas, conjuntos de avaliação | Requisições em tempo real, tarefas em lote ou eventos da aplicação |
| Estados relevantes | Pesos do modelo, gradientes, estado do otimizador, ativações, checkpoints | Pesos do modelo, estado das requisições, cache KV em muitas cargas de trabalho de LLM, estado do roteamento e das filas |
| Principal questão de desempenho | Com que rapidez e confiabilidade o modelo pode atingir a qualidade exigida? | Os usuários podem obter a qualidade exigida dentro das metas de latência e disponibilidade? |
| Principal risco de custo | Tempo de cluster subutilizado, execuções malsucedidas, preparação de dados, baixa eficiência de escalabilidade | Capacidade ociosa, agrupamento ineficiente em lotes, prompts longos, pressão sobre o cache, latência de cauda e picos de tráfego |
| Foco das operações | Reprodutibilidade, linhagem de dados, criação de checkpoints, comunicação distribuída | Admissão de requisições, disponibilização do modelo, escalabilidade automática, observabilidade, novas tentativas e degradação gradual |
É por isso que uma decisão entre inferência e treinamento de IA deve começar pelo resultado de negócio e pelo perfil da carga de trabalho, não por um SKU de hardware.
O que realmente muda no fluxo de computação?
O treinamento e a inferência podem executar a mesma arquitetura no mesmo tipo de acelerador, mas envolvem tarefas e estados diferentes.
O treinamento atualiza o modelo
Uma etapa convencional de treinamento se parece com isto:
training batch → forward pass → loss → backward pass → gradient sync → optimizer update → checkpoint
A passagem direta estima uma saída. A retropropagação calcula como os parâmetros devem mudar. O otimizador atualiza os pesos. Em uma tarefa distribuída, os nós de processamento também precisam coordenar os gradientes ou outros estados do modelo. A documentação do DistributedDataParallel do PyTorch, por exemplo, explica que as réplicas sincronizam os gradientes entre processos durante o treinamento. Consulte a referência do PyTorch DDP.
É por isso que a memória para treinamento não se resume a “o modelo cabe”. A tarefa também precisa de espaço para ativações, gradientes, estado do otimizador, buffers de comunicação e checkpoints de recuperação. A composição exata depende do modelo, da precisão, do método de paralelismo, do tamanho do lote e do framework.
A inferência usa o modelo
A inferência normalmente se parece com isto:
request → tokenize / preprocess → prefill → decode or predict → response
Os pesos permanecem fixos durante a requisição. Para um LLM generativo, o servidor processa o prompt em uma fase de prefill e depois gera a saída de forma incremental. Isso torna o comprimento da requisição, as sequências simultâneas, a memória reservada para o cache KV e o comportamento das filas aspectos centrais da comparação entre inferência e treinamento de IA.
Uma ressalva importante: uma requisição de inferência costuma ser menos custosa do que uma etapa completa de treinamento, mas um endpoint de produção pode executar milhões de requisições. Portanto, um sistema de inferência continuamente ocupado pode ter um custo operacional total maior ao longo de sua vida útil do que uma execução de treinamento curta e programada.
Trade-offs de desempenho: otimize para métricas diferentes
Não use um único número de “tokens por segundo” para comparar essas cargas de trabalho. Essa métrica responde a perguntas diferentes em cada caso.
Desempenho do treinamento: tempo até obter um modelo confiável
No treinamento, acompanhe as métricas que determinam se a equipe atinge uma meta de qualidade dentro do prazo:
| Métrica | Por que importa | Falha comum |
|---|---|---|
| Tempo por etapa e amostras ou tokens processados por segundo | Revela a velocidade de avanço do experimento | Uma maior taxa bruta de processamento oculta um resultado inferior em termos de dados ou qualidade |
| Tempo até atingir a qualidade desejada | Conecta a computação ao objetivo real | Otimizar a velocidade enquanto a métrica de avaliação fica estagnada |
| Eficiência de escalabilidade | Mostra se mais GPUs reduzem o tempo decorrido o suficiente para justificar seu uso | Comunicação, carregamento de dados ou nós lentos consomem o ganho esperado |
| Tempo de criação de checkpoints e recuperação | Limita o custo de interrupções | Uma execução longa que falha é reiniciada a partir de um checkpoint antigo |
| Reprodutibilidade e variabilidade da avaliação | Permite comparar resultados entre execuções | Um “ganho” não pode ser reproduzido nem atribuído a uma mudança |
O treinamento distribuído introduz um problema de rede e coordenação além do problema computacional. A sincronização de gradientes faz parte do fluxo de treinamento, portanto a topologia, a sobreposição de comunicação, a fragmentação de dados e a recuperação de falhas podem ser tão importantes quanto a taxa de processamento anunciada do acelerador.
Desempenho da inferência: respostas úteis sob carga
A inferência precisa atender a um usuário ou sistema consumidor enquanto muitas requisições disputam a mesma capacidade. Para LLMs com streaming, um painel prático inclui:
| Métrica | O que ela informa |
|---|---|
| Tempo até o primeiro token (TTFT) | Quanto tempo o usuário espera até começar a ver a resposta |
| Latência entre tokens (ITL) ou tempo por token de saída (TPOT) | Com que fluidez a saída gerada chega após o primeiro token |
| Latência de ponta a ponta | Quanto tempo leva a requisição completa |
| Taxa de processamento dentro de um SLO | O volume total de trabalho útil entregue enquanto o TTFT e a latência por token permanecem aceitáveis |
| Tamanho da fila e taxa de rejeição | Se a capacidade está saturada antes de o modelo começar a processar |
| Taxa de erros e taxa de aceitação da qualidade das saídas | Se respostas rápidas também são úteis |
A documentação atual de benchmarks do vLLM define TTFT como o tempo entre o envio de uma requisição e o recebimento da primeira saída em streaming, e distingue ITL de TPOT. Seus exemplos também alertam que a reutilização de cache pode fazer a taxa de processamento parecer melhor do que em uma carga de trabalho sem cache. Consulte a documentação da CLI de benchmark do vLLM.
Esse alerta é útil de modo geral: avalie a combinação de requisições que você realmente espera receber. Comprimento dos prompts, limites de saída, possibilidade de uso de cache, concorrência, comportamento de streaming e tratamento de erros podem alterar o resultado da inferência mais do que apenas um tamanho de lote sintético.
O MLCommons destaca o mesmo ponto sob a perspectiva de projeto de benchmarks: os sistemas de inferência são avaliados tanto em relação a metas de qualidade quanto a restrições de latência ou taxa de processamento específicas de cada cenário. Consulte as definições dos benchmarks do MLPerf Inference.
Trade-offs de custo: treinamento é um projeto; inferência é um serviço
A forma mais clara de comparar o custo de inferência e treinamento de IA é atribuir cada carga de trabalho à unidade que gera valor.
Modelo de custo do treinamento
Para um projeto de treinamento ou fine-tuning, use um modelo por execução:
cost per validated model version =
(accelerator time + storage + network + data preparation + experiment operations)
÷ validated model versions
Esse modelo evidencia custos que as comparações de GPU-hora deixam de considerar:
- Trabalho com dados: coleta, análise de direitos, limpeza, rotulagem, deduplicação e versionamento.
- Desperdício em experimentos: execuções que falham, convergem de forma insatisfatória ou não podem ser reproduzidas.
- Tempo ocioso e de recuperação: capacidade reservada aguardando dados, um nó de processamento com falha ou a restauração de um checkpoint.
- Ineficiência de escala: mais aceleradores podem encurtar uma execução, mas não de forma linear quando a comunicação ou os pipelines de entrada se tornam gargalos.
- Trabalho de avaliação e segurança: um modelo não está pronto apenas porque a última etapa de treinamento foi concluída.
Se uma equipe precisa apenas de um formato de saída melhor, de uma chamada confiável a uma ferramenta ou de contexto de domínio fornecido no momento da requisição, o treinamento do zero geralmente é a primeira opção errada em termos de custo. Em vez disso, comece com engenharia de prompts, recuperação de informações, desenho do fluxo de trabalho ou um experimento de fine-tuning com escopo limitado.
Modelo de custo da inferência
Para a disponibilização online, use um modelo baseado em resultados bem-sucedidos:
cost per accepted response =
(serving capacity + storage + network + observability + support operations)
÷ accepted responses
Para uma tarefa em lote, substitua respostas por registros, imagens ou documentos aceitos. O objetivo continua o mesmo: dividir pela saída útil, não pelo número bruto de requisições ou pelas horas de acelerador anunciadas.
Os principais fatores de custo da inferência geralmente são:
- Perfil do tráfego: uma demanda com picos ou constante determina quanta capacidade fica ociosa.
- Comprimento da entrada e da saída: prompts e saídas geradas mais longos consomem mais computação e memória por requisição.
- Concorrência e agrupamento em lotes: lotes maiores podem melhorar a utilização, mas também podem aumentar a espera de cada usuário.
- Comportamento do cache KV: para LLMs, a capacidade e a reutilização do cache influenciam tanto a latência quanto a margem efetiva de memória disponível.
- Projeto de disponibilidade: réplicas, distribuição regional, novas tentativas e failover protegem a experiência do usuário, mas aumentam o custo operacional.
- Escolha do modelo e da precisão: mudar o modelo ou o formato de execução pode alterar simultaneamente a qualidade, a demanda de memória e a velocidade.
Para equipes que estão decidindo se devem operar sua própria capacidade de disponibilização, compare uma carga de trabalho auto-hospedada com uma API de modelos gerenciada usando a mesma definição de saída aceita. Isso evita considerar um preço baixo por GPU-hora como uma vantagem quando engenharia, capacidade ociosa e trabalho de confiabilidade representam custos maiores. Para a próxima etapa dessa decisão, consulte nuvem de GPU vs. API de modelos.
Trade-offs de implantação: clusters versus endpoints
Treinamento e inferência não devem compartilhar um modelo operacional por padrão.
Uma implantação de treinamento precisa de uma plataforma de experimentos reproduzíveis
Um ambiente de treinamento adequado para produção normalmente precisa de:
- Dados e conjuntos de avaliação versionados para que o resultado possa ser rastreado até suas entradas.
- Um ambiente reproduzível com versões fixadas de código e dependências, configuração do modelo e política de sementes aleatórias.
- Topologia de aceleradores e rede apropriada à estratégia de paralelismo escolhida.
- Armazenamento de checkpoints e política de reinício dimensionados para interrupções, preempção e investigação.
- Rastreamento de experimentos que vincule hiperparâmetros, métricas, artefatos e decisões de aprovação.
- Um ponto de aprovação para promoção que valide qualidade, segurança, custo e reversão antes da implantação.
O Kubernetes pode agendar recursos de GPU usando plugins de dispositivos e rótulos dos fornecedores, mas isso não elimina a necessidade de planejar drivers, capacidades dos nós, armazenamento, comunicação distribuída e orquestração das cargas de trabalho. O Kubernetes documenta o modelo de agendamento de GPUs aqui.
Uma implantação de inferência precisa de um serviço em operação
Uma implantação de inferência tem uma lista de verificação diferente:
- Um servidor de modelos versionado com tokenizador, ambiente de execução e contrato de requisições testados.
- Controle de admissão e limites de capacidade para que uma sobrecarga resulte em enfileiramento controlado ou descarte de requisições, e não em colapso.
- Uma política de escalabilidade sensível às requisições que considere concorrência, comprimento dos prompts e tempo de fila, e não apenas a utilização da CPU.
- Controles de cache e agrupamento em lotes testados em relação tanto à taxa de processamento quanto à latência de cauda.
- Observabilidade para TTFT, TPOT ou ITL, latência de ponta a ponta, tamanho da fila, erros, saturação e aceitação das saídas.
- Comportamento de reversão, roteamento e alternativa de contingência para regressões do modelo ou falhas do provedor.
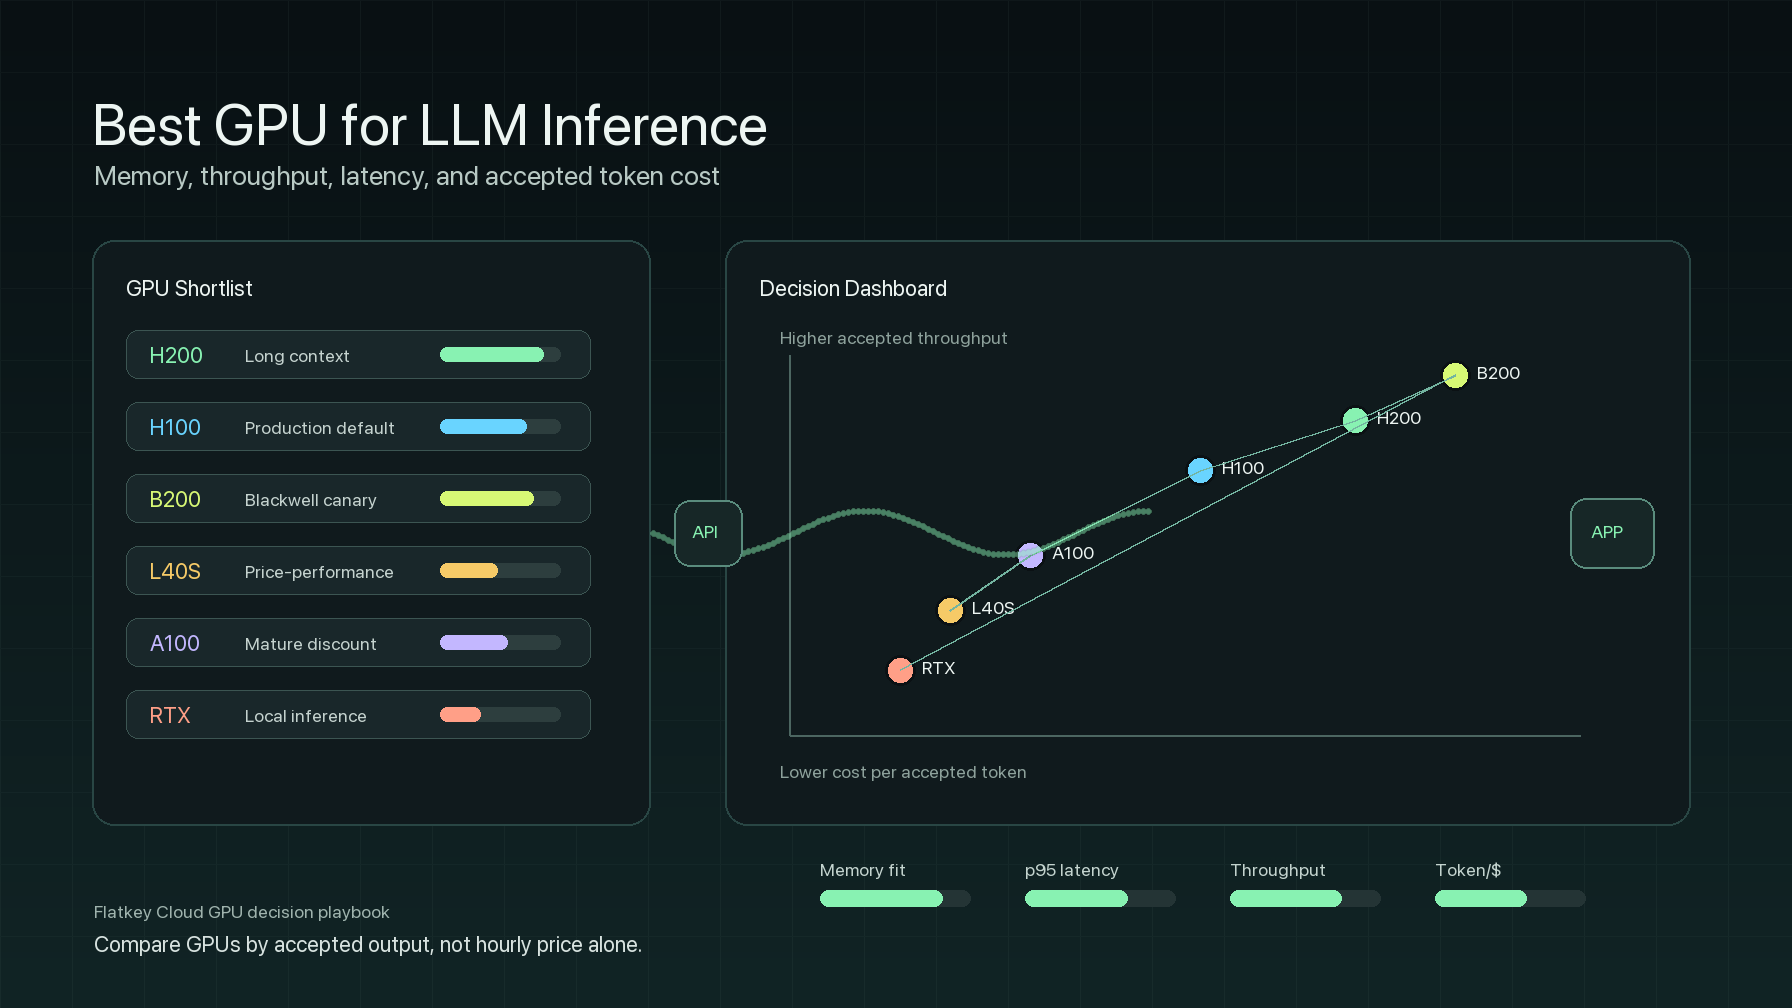
Se você optou pela disponibilização auto-hospedada, a melhor GPU para inferência de LLM depende de o modelo caber na memória, do perfil das requisições, da meta de latência e do custo por saída aceita — não existe uma vencedora universal. Se você precisa primeiro escolher um modelo operacional, compare a capacidade de GPU serverless e GPU dedicada.
O fine-tuning é o caminho intermediário
A questão de inferência vs. treinamento de IA muitas vezes oculta uma terceira opção: o fine-tuning.
O fine-tuning ainda é treinamento porque atualiza parâmetros. Mas ele começa com um modelo pré-treinado e usa um conjunto de dados específico da tarefa muito menor do que o necessário para treinar do zero. Isso pode torná-lo apropriado quando prompts e recuperação de informações não conseguem atender a um requisito mensurável — como um comportamento rigoroso de saída estruturada, uma transformação especializada recorrente ou uma tarefa de domínio com exemplos rotulados estáveis.
Trate o fine-tuning como uma hipótese, não como padrão. Defina o modelo de referência, um conjunto de avaliação separado, um limite de aceitação, um plano de reversão e o impacto esperado na inferência antes de reservar capacidade. Um fine-tuning que melhora uma pontuação offline, mas gera latência, custo ou esforço de manutenção inaceitáveis, não representa uma melhoria para produção.
Uma árvore de decisão prática
Use esta sequência para transformar uma conversa abstrata sobre infraestrutura em uma decisão:
- Um modelo pré-treinado consegue atender ao requisito com prompts, uso de ferramentas, recuperação de informações ou mudanças no fluxo de trabalho? Se sim, comece com inferência.
- Você tem uma falha persistente e mensurável em entradas representativas e um conjunto de dados de alta qualidade específico da tarefa? Se sim, avalie um experimento de fine-tuning com escopo limitado.
- Você precisa de uma nova capacidade fundamental, possui um ativo de dados que justifique o investimento e pode financiar dados, treinamento, avaliação e disponibilização contínua? Só então avalie o treinamento do zero.
- Para inferência, você precisa de controle em nível de hardware, um ambiente de execução personalizado, controle sobre a localização dos dados ou utilização previsível que justifique operar capacidade própria? Se sim, avalie a auto-hospedagem. Caso contrário, use uma API de modelos gerenciada como referência.
- O que acontece quando a demanda dobra ou uma versão do modelo apresenta regressão? Documente o comportamento de escalabilidade, contingência e reversão antes que o lançamento transforme isso em um incidente.
Essa árvore de decisão é deliberadamente conservadora. Geralmente é mais barato comprovar uma necessidade do produto com inferência antes de arcar com a estrutura necessária para treinar e operar um modelo personalizado.
Resumo de carga de trabalho para copiar: decida antes de reservar GPUs
Use este resumo de uma página para cada nova carga de trabalho. Ele oferece às equipes de produto, ML e infraestrutura uma definição compartilhada do que significa estar “pronto”.
| Campo | Resumo de treinamento ou fine-tuning | Resumo de inferência |
|---|---|---|
| Resultado para o usuário | Que capacidade deve ser aprimorada ou lacuna de qualidade deve ser corrigida? | Que resposta ou automação o usuário deve receber? |
| Métrica de sucesso | Métrica de qualidade em conjunto separado, verificações de segurança, custo por versão validada | TTFT, latência por token ou de ponta a ponta, taxa de processamento dentro do SLO, taxa de saídas aceitas |
| Contrato de dados | Origem do conjunto de dados, direitos, versão, rótulos ou recompensas, partição de avaliação | Esquema das requisições, distribuições de prompts e saídas, limites de privacidade, possibilidade de uso de cache |
| Premissa de capacidade | Quantidade de GPUs, adequação à memória, paralelismo, frequência de checkpoints, meta de recuperação | Tamanho do modelo, concorrência, limites de prompts e saídas, agrupamento em lotes, orçamento de cache, política de réplicas |
| Limite de custo | Custo máximo por versão validada do modelo | Custo máximo por resposta aceita ou registro em lote |
| Plano de falhas | Dados inadequados, execução malsucedida, perda de um nó de processamento, regressão de qualidade | Aumento súbito da fila, saturação, lançamento de uma versão problemática do modelo, falha em sistema upstream, saída insegura |
| Critério de encerramento | Promover, revisar ou interromper com base no ponto de aprovação da avaliação | Escalar, rotear, reverter ou trocar o modelo com base no SLO do serviço |
O valor desse resumo não está no modelo em si. Ele obriga a equipe a dizer se está adquirindo capacidade do modelo, confiabilidade na disponibilização ou ambas. Esse é o verdadeiro trade-off entre inferência e treinamento de IA.
Onde uma API unificada de modelos se encaixa
Se sua resposta é “inferência, mas sem operar o hardware”, comece usando uma API de modelos como referência na comparação. A Flatkey oferece uma única chave de API e um único saldo para acesso a mais de 300 modelos oficiais e mais de 1.000 ferramentas com pagamento por chamada, permitindo que a equipe mantenha a seleção de modelos e a contabilização do uso separadas da decisão de disponibilizar modelos em GPUs. Explore os modelos da Flatkey.
Isso não substitui uma implantação auto-hospedada quando você precisa do controle proporcionado pela operação do ambiente de execução. Mas oferece uma alternativa prática para comparação antes de assumir compromissos com capacidade, uma stack de disponibilização e responsabilidades de plantão.
Conclusão: escolha o problema operacional que você realmente tem
A escolha entre inferência e treinamento de IA fica mais simples quando você identifica o problema operacional:
- Escolha treinamento quando precisar criar ou adaptar substancialmente a capacidade de um modelo e puder dar suporte a dados, avaliação, experimentação e computação distribuída.
- Escolha inferência quando um modelo treinado já puder realizar a tarefa e o desafio for entregar resultados úteis com latência, confiabilidade e custo por unidade aceitáveis.
- Escolha fine-tuning somente quando uma lacuna mensurada e um conjunto de dados representativo justificarem a atualização de um modelo pré-treinado.
Antes de selecionar GPUs, documente o resumo da carga de trabalho, avalie o perfil real das requisições ou dos dados e defina os limites de qualidade e custo que justificam a operação.
Perguntas frequentes
Qual é a principal diferença entre inferência e treinamento de IA?
O treinamento usa dados e otimização para atualizar os parâmetros do modelo. A inferência usa parâmetros fixos para transformar uma nova entrada em uma previsão ou saída gerada. Em produção, a disponibilização envolve o trabalho adicional de expor e operar a inferência como um sistema confiável.
A inferência é sempre mais barata que o treinamento?
Não. Uma única requisição de inferência geralmente é mais leve do que uma etapa de treinamento, mas um endpoint de alto volume ou sempre ativo pode custar mais ao longo de sua vida útil do que um projeto de treinamento com escopo limitado. Compare os custos por versão validada do modelo para treinamento e por saída aceita para inferência.
Fine-tuning é treinamento ou inferência?
Fine-tuning é treinamento porque atualiza parâmetros. Geralmente é uma alternativa mais restrita e de menor custo ao treinamento de um modelo do zero. O modelo resultante ainda precisa de uma implantação de inferência para atender às requisições.
Quais métricas são mais importantes para inferência e treinamento de IA?
Para treinamento, concentre-se em qualidade, tempo até atingir a qualidade desejada, taxa de processamento, eficiência de escalabilidade e recuperação. Para inferência online de LLMs, acompanhe TTFT, TPOT ou ITL, latência de ponta a ponta, taxa de processamento dentro do SLO escolhido, filas, erros e taxa de saídas aceitas.
A mesma frota de GPUs pode executar treinamento e inferência?
Sim, mas a capacidade compartilhada costuma criar prioridades conflitantes: o treinamento favorece tarefas longas e eficientes, enquanto a inferência voltada ao usuário exige latência previsível e margem para picos. Isole as cargas de trabalho ou defina regras explícitas de agendamento e preempção antes de compartilhar uma frota.