
Blog da flatkey.ai
Insights, notas de produto e guias de implementação para equipes que criam com APIs de IA.
Arquitetura de gateways de IA
Artigos mais recentes em Arquitetura de gateways de IA.
Ler maisMigração de URL base e SDK
Artigos mais recentes em Migração de URL base e SDK.
Ler maisCustos, cobrança e operações
Artigos mais recentes em Custos, cobrança e operações.
Ler maisControles empresariais e confiança
Artigos mais recentes em Controles empresariais e confiança.
Ler maisComparações de gateways
Artigos mais recentes em Comparações de gateways.
Ler maisGuias de modelos e modalidades
Artigos mais recentes em Guias de modelos e modalidades.
Ler maisConfiabilidade e roteamento
Artigos mais recentes em Confiabilidade e roteamento.
Ler maisIntegrações de ferramentas
Artigos mais recentes em Integrações de ferramentas.
Ler mais
API de geração de vídeos com IA: acesso, preços, integração e guia de produção
Um guia prático para escolher, precificar, integrar e operar uma API de geração de vídeos com IA, com tarefas assíncronas e controles de custos mensuráveis.

Significado de inferência de IA: arquitetura, desempenho e guia de implantação na nuvem
O que significa inferência de IA: como um modelo treinado transforma novas entradas em respostas de produção, com as métricas e etapas de implantação de GPU na nuvem que importam.

Auditoria de segurança de IA: plano de testes prático, checklist de evidências e modelo de relatório para aplicações com LLMs
Uma auditoria de segurança de IA testa o que sua aplicação com LLM realmente faz, não o que o fornecedor afirma. Este guia traz um modelo de escopo, 12 testes mapeados ao OWASP com entrada, controle esperado, evidências e correção, uma estrutura segura para executar testes, critérios de gravidade e um modelo de relatório.
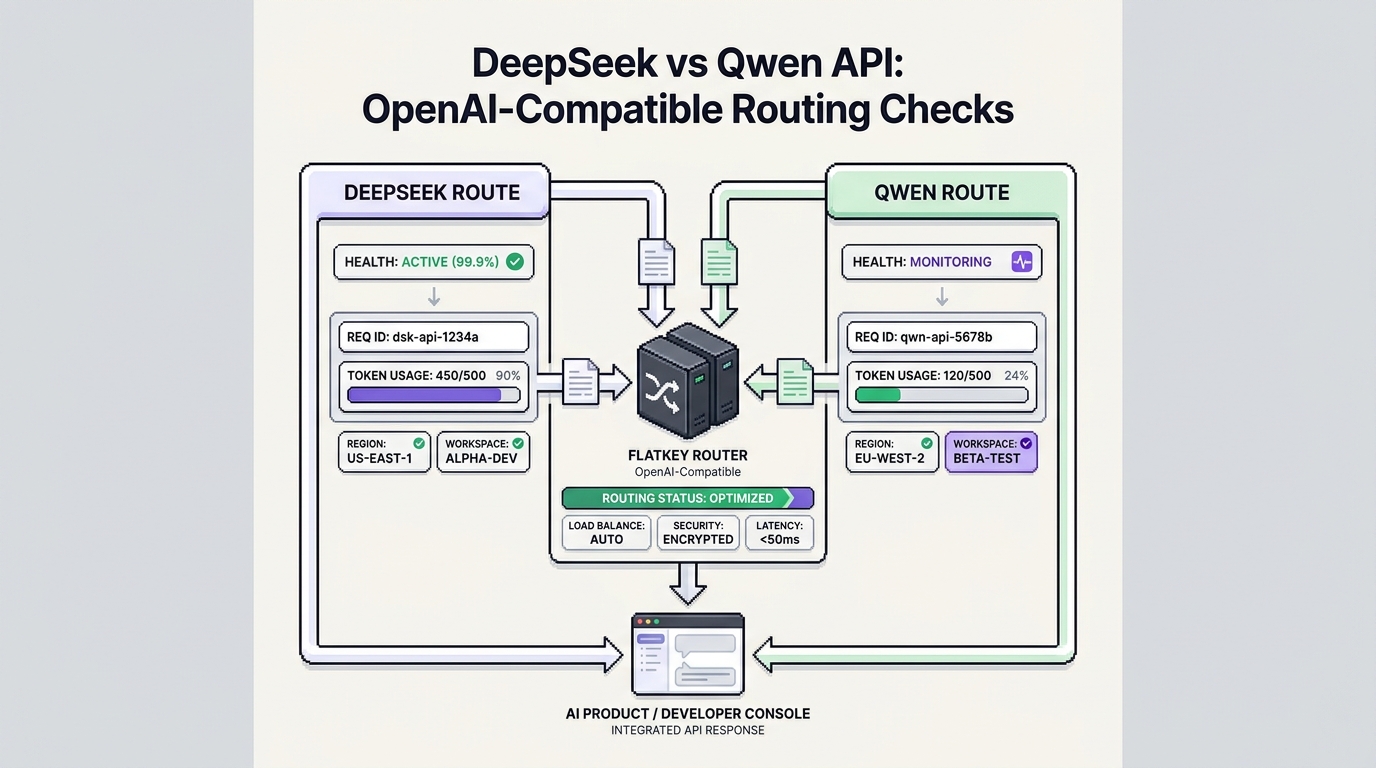
Grok vs Gemini (outubro de 2026): qual IA você deve usar?
Escolha o Gemini se quiser o plano com melhor custo-benefício, integração com o Google, ferramentas de vídeo e uma API com contexto de 1M de tokens; escolha o Grok se você vive no X, quer posts do X em tempo real ou já pagaria o X Premium. Comparamos planos, tarefas e APIs com preços de 25 de outubro de 2026.

Dá para rodar o Kimi K3 localmente? Guia de hardware, GGUF e vLLM (2026)
O Kimi K3 pode rodar localmente, mas o menor GGUF de 1 bit precisa de cerca de 610 GB de RAM mais VRAM. Veja os requisitos exatos de hardware, comandos de llama.cpp e vLLM, termos de licença e uma comparação de custos com GPUs alugadas e APIs.

Começando a usar a API Flatkey esta semana
Notas de onboarding da Northline Analytics
Erros Comuns do LiteLLM: Timeouts, Alertas de Orçamento e Falhas de Provedor
Um guia prático de solução de problemas do LiteLLM para timeouts, controles de orçamento, alertas, configuração de modelos, falhas de provedor, tentativas e fallbacks.
Descarregamento e Estratificação de Cache KV para Servir LLMs de Contexto Longo
Guia de descarregamento e estratificação de cache KV para servir LLMs de contexto longo com vLLM e TensorRT-LLM.
Crie um cluster Kubernetes com GPUs para treinamento e inferência de IA
Um guia prático para clusters Kubernetes com GPUs voltados ao treinamento e à inferência de IA, abordando pools de nós com GPU, plugins de dispositivo, GPU Operator, enfileiramento, armazenamento, observabilidade, segurança, controles de custos e avaliação de provedores.
Kimi K3 vs GPT 5.6 Sol: preços, contexto e qual API testar
Uma comparação verificada por fontes entre Kimi K3, GPT-5.6 Sol e GPT-5.6 Terra para desenvolvedores que escolhem uma API para produção.
Preço da GPU H200: preços, fatores de custo e guia de compra
Compare os custos da placa H200 NVL, de servidores e de aluguel na nuvem — e os fatores de TCO que importam antes de comprar ou reservar capacidade.

GPU H200: arquitetura, desempenho e guia de implantação na nuvem
Um guia prático sobre a H200 para escolher o formato, dimensionar a memória e a malha de interconexão, implantar na infraestrutura de nuvem e validar latência, throughput, integridade e custo por trabalho concluído.
Preço da GPU H100: preços, fatores de custo e guia de compra
Guia de preços da GPU H100 para comparar uma oferta PCIe de US$ 32.200, referências de aluguel na nuvem, formatos e o TCO por trás de uma cotação on-premises.

Servidor GPU: arquitetura, desempenho e guia de implantação na nuvem
Escolha e implante um servidor GPU na nuvem com uma estrutura orientada à carga de trabalho para arquitetura, testes de desempenho e preparação para produção.
Genspark AI Agent Builder API Custom: Acesso, Preços, Integração e Guia de Produção
Um guia prático sobre acesso ao Genspark Custom Agent, preços, conectores e a arquitetura de produção adequada quando a sua aplicação precisa de uma API documentada.
API de LLM gratuita: limites, custos e compromissos em produção
Um guia prático sobre níveis gratuitos de APIs de LLM, créditos, limites de taxa, custos operacionais ocultos e os controles de produção a adicionar antes que os usuários dependam de uma rota.

Flatkey vs Contas Diretas de Provedores para Produtos Multimodelo
Se o seu produto já depende de mais de uma família de modelos, a verdadeira decisão não é “gateway ou sem gateway” em abstrato. A verdadeira decisão é se as contas diretas dos provedores ainda são suficientemente simples ou se
ComfyUI numa GPU na nuvem: guia de configuração, armazenamento e custos
Um guia prático para implementar o ComfyUI numa GPU na nuvem com armazenamento persistente, acesso privado, seleção de GPU conforme a carga de trabalho e controlo de custos.
Crie mais rápido com um único gateway de IA.
Use a flatkey.ai para gerenciar modelos, chaves, cobrança e observabilidade em uma plataforma de API.
Começar