Kimi K3 vs GPT 5.6 Sol: preços, contexto e qual API testar
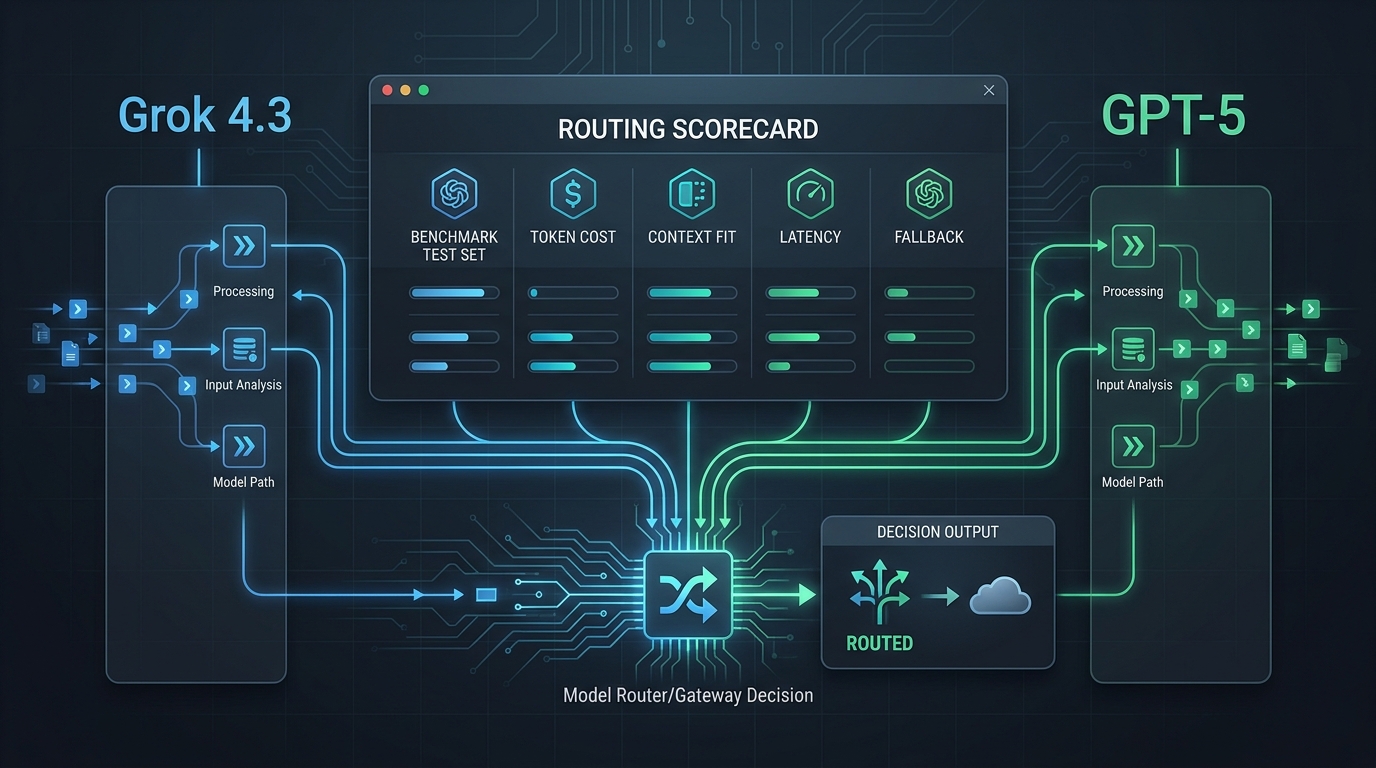
Se você está comparando Kimi K3 vs GPT 5.6 Sol, não comece com uma captura de tela de um leaderboard. Comece escolhendo os IDs exatos dos modelos, normalizando o esforço de raciocínio e medindo o custo por resultado aceito nas suas próprias tarefas.
Ambos os modelos foram criados para trabalho agêntico com contexto longo. A documentação atual da API da Kimi posiciona kimi-k3 como seu carro-chefe para programação de longo horizonte, trabalho de conhecimento, compreensão visual nativa e raciocínio profundo. A OpenAI posiciona gpt-5.6-sol como o nível carro-chefe da família GPT-5.6 para trabalho profissional complexo. A diferença prática não é simplesmente “qual modelo é mais inteligente?”. É qual rota oferece ao seu produto a qualidade, o comportamento de ferramentas, a latência e o custo certos para uma carga de trabalho específica.
Este guia compara Kimi K3 vs GPT 5.6 Sol usando a documentação atual dos provedores e, em seguida, apresenta um plano reproduzível de avaliação de API. Ele também inclui o GPT-5.6 Terra, a opção GPT-5.6 de menor custo, porque frequentemente é a referência mais útil para uma decisão de roteamento em produção.
Resposta curta: Teste o Kimi K3 quando programação com contexto longo, raciocínio sempre ativo e o fluxo de trabalho de visão nativa da Kimi forem adequados ao seu produto. Teste o GPT-5.6 Sol quando precisar da superfície de ferramentas da OpenAI e de um nível carro-chefe de raciocínio configurável. Mantenha o GPT-5.6 Terra no conjunto de testes quando o custo unitário for importante. Não declare um vencedor antes de executar os mesmos fixtures em cada rota.
O que “GPT-5” significa nesta comparação
“GPT-5” é um termo de busca ambíguo em outubro de 2026. A página do modelo GPT-5 da OpenAI descreve o GPT-5 como um modelo anterior e descontinuado, enquanto sua orientação atual de descontinuação direciona vários snapshots mais antigos do GPT-5 para a família GPT-5.6. Neste artigo, Kimi K3 vs GPT 5.6 Sol significa os IDs públicos atuais dos modelos kimi-k3 e gpt-5.6-sol, não um alias legado e não especificado do GPT-5.
Se sua aplicação está fixada em um snapshot gpt-5-* mais antigo, trate isso primeiro como um projeto de migração. Fixe a substituição exata, atualize seus testes e confirme a data de desativação do provedor antes de comparar a qualidade dos modelos.
Kimi K3 vs GPT 5.6 Sol em resumo
| Fator de decisão | Kimi K3 | GPT-5.6 Sol | GPT-5.6 Terra |
|---|---|---|---|
| ID do modelo de API | kimi-k3 |
gpt-5.6-sol |
gpt-5.6-terra |
| Posicionamento do provedor | Carro-chefe para programação de longo horizonte, trabalho de conhecimento, raciocínio e compreensão visual nativa | Nível carro-chefe GPT-5.6 para trabalho profissional complexo | Nível GPT-5.6 projetado para equilibrar inteligência e custo |
| Janela de contexto | Até 1M de tokens | 1,05M de tokens | 1,05M de tokens |
| Controles de raciocínio | Sempre ativado; low, high ou max; padrão max |
none, low, medium, high, xhigh ou max; padrão medium |
Mesmas opções documentadas de esforço de raciocínio que o Sol |
| Preço direto de tabela para entrada | US$ 3,00 / 1M de tokens não armazenados em cache | US$ 4,00 / 1M de tokens | US$ 2,00 / 1M de tokens |
| Preço direto de tabela para entrada em cache | US$ 0,30 / 1M de tokens | US$ 0,40 / 1M de tokens | US$ 0,20 / 1M de tokens |
| Preço direto de tabela para saída | US$ 15,00 / 1M de tokens | US$ 20,00 / 1M de tokens | US$ 12,00 / 1M de tokens |
| Pergunta sobre ferramentas a testar | Comportamento específico da Kimi para solicitações, pensamento, visão e chamadas de ferramentas no endpoint escolhido | Recursos do OpenAI Responses e ferramentas hospedadas necessárias para seu produto | Mesma superfície de integração, com um candidato GPT-5.6 de menor preço |
Os números da Kimi vêm das páginas atuais de plataforma e faturamento da Moonshot. Os números do GPT vêm das páginas individuais dos modelos da OpenAI. São preços de referência do provedor direto, verificados em 22 de outubro de 2026 — não uma cotação para todos os gateways, regiões, promoções, chamadas de ferramentas, tratamentos tributários ou acordos empresariais.
Para Kimi K3 vs GPT 5.6 Sol, os números principais de contexto são suficientemente próximos para que “um milhão de tokens” não decida o resultado por si só. As perguntas relevantes são se seus fixtures de contexto longo retêm os fatos importantes, se a saída continua utilizável e quanto custa a solicitação completa após o cache e os tokens de saída.
Comparação de preços: use uma carga de trabalho, não um preço de etiqueta
Os preços por token são entradas para um modelo de custo, não o resultado da seleção do modelo. Uma estimativa simples é:
custo estimado da solicitação =
  (tokens de entrada não armazenados em cache × taxa de entrada não armazenada em cache) +
  (tokens de entrada em cache × taxa de entrada em cache) +
  (tokens de saída × taxa de saída)
Aqui está o cálculo de preço direto para duas cargas de trabalho deliberadamente simples. Ele exclui impostos, preços de gateways, cobranças por chamadas de ferramentas e qualquer adicional por contexto longo.
| Exemplo de carga de trabalho | Kimi K3 | GPT-5.6 Sol | GPT-5.6 Terra |
|---|---|---|---|
| 1M de entrada não armazenada em cache + 250K de saída | US$ 6,75 | US$ 9,00 | US$ 5,00 |
| 1M de entrada em cache + 250K de saída | US$ 4,05 | US$ 5,40 | US$ 3,20 |
Esses cálculos mostram por que Kimi K3 vs GPT 5.6 Sol não é uma comparação de custos unidimensional. O preço de tabela publicado da Kimi é menor que o da Sol neste exemplo, enquanto o da Terra é ainda menor. Mas uma chamada mais barata que precisa de novas tentativas, gera mais trabalho de revisão manual ou não cumpre um contrato de ferramenta não é automaticamente mais barata por tarefa aceita.
Há outra particularidade de contexto longo. A OpenAI documenta um multiplicador de preço para prompts do GPT-5.6 Sol e Terra acima de 272 mil tokens de entrada: 2× para entrada e 1,5× para saída em toda a solicitação. O guia de cobrança do K3 da Kimi afirma que o preço do K3 não é escalonado por faixa de comprimento de contexto. Inclua um caso real de documento longo no seu conjunto de testes e registre o uso visível na fatura; não extrapole a partir de um prompt curto.
Para uma metodologia mais ampla, use nosso guia sobre como comparar preços de modelos de IA antes de trocar de provedor.
As configurações de raciocínio não são intercambiáveis
O Kimi K3 sempre opera no modo de raciocínio. Os valores documentados de reasoning_effort são low, high e max, sendo max o padrão. O GPT-5.6 Sol e o GPT-5.6 Terra documentam uma escala mais ampla que inclui none, low, medium, high, xhigh e max, sendo medium o padrão.
Isso torna enganosos os testes de padrão versus padrão. Um experimento justo de Kimi K3 vs GPT 5.6 Sol deve definir um nível compartilhado compatível, como high, quando a rota o suportar, e depois executar uma comparação separada orientada ao orçamento usando os padrões documentados dos provedores. Mantenha esses resultados em linhas separadas — caso contrário, você estará misturando a escolha do modelo com a escolha do orçamento de raciocínio.
Também mantenha parâmetros específicos de cada provedor fora da primeira linha de base entre modelos. A documentação da Kimi destaca o comportamento próprio do K3; a API Responses da OpenAI expõe uma superfície mais ampla de ferramentas hospedadas. Comece com uma tarefa estruturada simples e adicione casos de ferramenta, visão e multimodalidade somente depois que o contrato básico de solicitação/resposta for aprovado.
Ferramentas, APIs e adequação à migração
Ambos os provedores oferecem interfaces conhecidas para desenvolvedores, mas “compatível com OpenAI” deve ser tratado como um ponto de partida, não como uma promessa de que todos os campos e eventos transmitidos sejam idênticos.
A OpenAI documenta acesso via Chat Completions e Responses para o GPT-5.6 Sol, além de chamadas de função, saídas estruturadas e diversas ferramentas da API Responses, como busca na web, busca de arquivos, geração de imagens, interpretador de código, shell hospedado, uso de computador, MCP e busca de ferramentas. Isso pode simplificar um fluxo de trabalho que já depende desses recursos hospedados pela OpenAI.
A Kimi documenta kimi-k3 para programação de longo horizonte e trabalho com conhecimento, e seu material oficial descreve integrações compatíveis com OpenAI e orientadas a Responses. O raciocínio sempre ativo do K3, seus níveis de raciocínio permitidos e seus detalhes de visão ou chamadas de ferramentas merecem testes rápidos específicos da rota antes de migrar um agente com um histórico complexo de mensagens.
Se você já está avaliando o K3, leia o guia de acesso à API do Kimi K3 para ver observações sobre ID do modelo, parâmetros e configuração com o provedor direto. Se precisar manter um cliente enquanto alterna candidatos, use uma URL base compatível com OpenAI para testes de prompts em múltiplos modelos e preserve o ID exato de cada modelo candidato nos seus registros.
Um plano de avaliação de 48 horas para Kimi K3 vs GPT 5.6 Sol
Não execute um único prompt engenhoso e considere o resultado um benchmark. Use um conjunto pequeno, mas representativo, de casos de teste.
- Fixe os candidatos. Comece com
kimi-k3,gpt-5.6-solegpt-5.6-terra. Registre a data, o endpoint, a versão do SDK, o ID do modelo e a configuração de raciocínio para cada solicitação. - Escolha de 20 a 50 tarefas reais. Inclua as alterações de código, documentos, esquemas, chamadas de ferramentas, imagens e casos de falha que seus usuários realmente geram. Oculte dados sensíveis antes de enviá-los a qualquer lugar.
- Defina a aceitação antes da execução. Exemplos: os testes passam, o JSON é validado, os campos citados estão presentes, um revisor humano aceita o resultado ou um agente conclui a tarefa sem uma nova tentativa insegura.
- Capture o registro operacional completo. Armazene as contagens de tokens de entrada, entrada em cache, saída e novas tentativas; a latência; erros de HTTP ou de ferramenta; o resultado de aceitação; e o tempo do revisor. Adicione o comportamento de limite de taxa para tráfego sustentado usando uma lista de verificação para planejamento de limites de taxa de LLM.
- Calcule o custo por resultado aceito. Divida o gasto total de cada candidato pelas tarefas aceitas, não pelas chamadas brutas. Mantenha os custos de falhas e novas tentativas no numerador.
- Implemente gradualmente com uma alternativa. Direcione uma pequena porcentagem do trabalho elegível para o candidato escolhido, mantenha uma alternativa testada e configure alertas para regressões de qualidade, latência e custo.
Use um cartão de pontuação compacto para que uma equipe possa revisar a decisão quando um modelo ou preço mudar:
| Métrica | Por que é importante | Exemplo de regra de aceitação |
|---|---|---|
| Taxa de aprovação em tarefas | Captura a qualidade visível para o usuário | Os testes passam ou o revisor aprova |
| Custo por tarefa aceita | Inclui novas tentativas e volume de saída | Manter-se dentro do orçamento da carga de trabalho |
| Latência P95 | Captura a experiência na cauda | Cumprir o SLA da interação ou do trabalho |
| Validade da saída estruturada | Mostra a confiabilidade do contrato da API | O esquema é validado sem reparo |
| Conclusão de ferramenta ou agente | Testa o comportamento real do fluxo de trabalho | As ferramentas obrigatórias são concluídas com a transferência correta |
| Recuperação por fallback | Protege a disponibilidade em produção | A nova tentativa ou o fallback é concluído com segurança |
Teste a mesma solicitação por meio de uma única camada de roteamento
Usar o mesmo cliente para todos os candidatos elimina uma fonte de viés acidental na comparação. O quickstart público da Flatkey documenta uma chave e uma URL base compatível com OpenAI, https://router.flatkey.ai/v1, enquanto seus metadados públicos de preços listavam kimi-k3, gpt-5.6-sol e gpt-5.6-terra como disponíveis quando este artigo foi verificado. A disponibilidade e o suporte a campos podem mudar, portanto verifique o contrato do modelo antes de uma implantação em produção.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["FLATKEY_API_KEY"],
    base_url="https://router.flatkey.ai/v1",
)

for model in ("kimi-k3", "gpt-5.6-sol", "gpt-5.6-terra"):
    response = client.chat.completions.create(
        model=model,
        reasoning_effort="high",  # a shared supported baseline to test first
        messages=[
            {"role": "user", "content": "Solve the evaluation fixture and return valid JSON."}
        ],
    )
    print(model, response.choices[0].message.content)
Use esse trecho como ponto de partida para a avaliação, não como um contrato de produção. Em particular, confirme quaisquer campos específicos do Kimi, o comportamento de ferramentas, eventos de streaming, configurações de segurança e o esquema de saída no endpoint exato escolhido. Após cada execução, inspecione o uso e os resultados no nível da solicitação, em vez de presumir que um alias, uma promoção ou um cartão do modelo permanecerá inalterado.
Qual modelo você deve testar primeiro?
Comece a comparação Kimi K3 vs GPT 5.6 Sol com o Kimi K3 se sua tarefa crítica for programação ou trabalho de conhecimento de longo horizonte, se você quiser a compreensão visual nativa documentada do K3 e se estiver confortável em validar seu raciocínio e comportamento de solicitação específicos do K3.
Comece com o GPT-5.6 Sol se o fluxo de trabalho depender fortemente das ferramentas atuais da Responses API da OpenAI, ou se os controles mais amplos de reasoning_effort fizerem parte do design do seu produto. Adicione o GPT-5.6 Terra quando a mesma família de API e uma taxa direta por token menor forem mais importantes do que usar a camada principal.
A resposta certa para produção pode ser “os três”: uma rota principal para tarefas difíceis, uma rota de menor custo para trabalho repetível e um fallback testado. Um gateway de API de IA é mais útil quando ajuda você a aplicar essa política sem espalhar chaves de provedores e regras de roteamento específicas de modelos pelo código do produto.
Perguntas frequentes
O Kimi K3 é mais barato que o GPT-5.6 Sol?
Nos preços diretos de tabela verificados para este artigo, o Kimi K3 custa menos para entrada sem cache, entrada em cache e saída do que o GPT-5.6 Sol. Isso não prova que ele tenha o menor custo por tarefa aceita. Compare novas tentativas, comprimento da saída, regras de preço para contexto longo, cobranças de ferramentas, preços do gateway e trabalho de revisão humana nos seus próprios casos de teste.
O GPT-5.6 Terra é uma comparação melhor que o GPT-5.6 Sol?
É uma comparação adicional útil quando a sensibilidade a custos faz parte da decisão. O Terra tem a mesma janela de contexto documentada de 1,05 milhão de tokens e tarifas diretas de tabela menores que o Sol, enquanto o Sol é a camada principal GPT-5.6 da OpenAI. Inclua ambos quando precisar separar uma decisão sobre a família de modelos de uma decisão sobre a faixa de preço.
Posso usar o Kimi K3 e o GPT-5.6 Sol com o mesmo cliente OpenAI?
Você pode usar um cliente no estilo OpenAI com um provedor ou camada de roteamento compatível, mas deve validar o endpoint e os campos exatos. A compatibilidade do modelo não torna idênticos os parâmetros de raciocínio, eventos de ferramentas, entradas de visão, limites de taxa ou o comportamento de saída estruturada.
Uma janela de contexto maior significa que um modelo é melhor para minha base de código?
Não. A capacidade de contexto não garante recuperação, raciocínio, qualidade da saída, latência nem uma fatura administrável. Coloque um caso de teste representativo de repositório ou documento na avaliação e pontue o resultado aceito, não o número de contexto anunciado.
Recomendação final
O resultado útil de uma comparação Kimi K3 vs GPT 5.6 Sol é uma regra de roteamento que você consegue explicar: qual candidato atende qual tarefa, em que nível de raciocínio, dentro de quais limites de latência e custo, e com qual fallback. Use os números publicados de preço e contexto para elaborar o plano de teste; use seus próprios dados de aceitação para escolher o padrão de produção.
Fontes
- Seleção de modelos da API Kimi
- Plataforma da API Kimi e tabela de preços atual do K3
- Orientações de faturamento da API Kimi
- Orientações de integração do Kimi Open Platform Responses
- Documentação do modelo OpenAI GPT-5.6 Sol
- Documentação do modelo OpenAI GPT-5.6 Terra
- Documentação do OpenAI GPT-5 e de descontinuação
- Descontinuações de modelos da OpenAI
- Guia de início rápido do Flatkey