Executar o ComfyUI na nuvem é simples. Mantê-lo repetível, privado e barato é o verdadeiro trabalho.
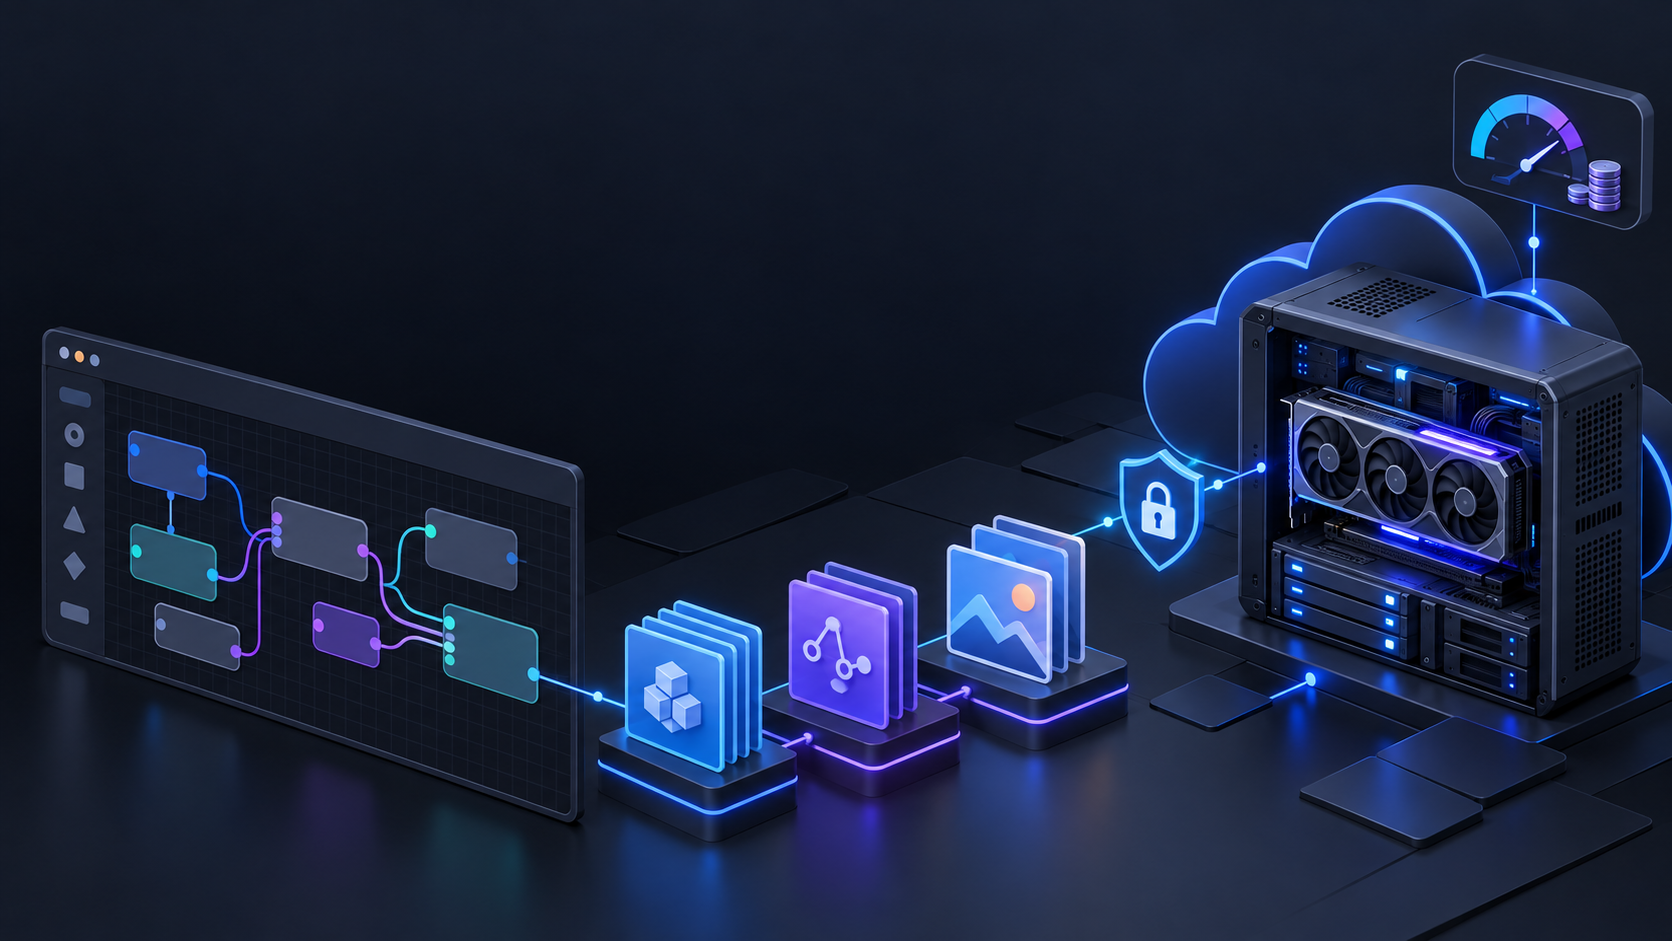
Uma configuração útil de GPU na nuvem para ComfyUI separa quatro aspetos: computação descartável, ficheiros persistentes, acesso privado e uma regra de paragem. Considere a instância de GPU substituível; coloque modelos, fluxos de trabalho, entradas e saídas num armazenamento que sobreviva a ela. Isto dá-lhe uma configuração que pode reiniciar sem voltar a transferir uma pilha de fluxos de trabalho ou sem se perguntar para onde foram as imagens de ontem.
Este guia é independente de fornecedor. Mostra como configurar uma GPU na nuvem para ComfyUI para trabalho interativo, como planear o armazenamento e como calcular custos sem fingir que uma única tarifa horária de GPU conta toda a história.
A versão curta
Para a maioria dos programadores independentes e pequenas equipas de IA, comece com este padrão de implementação:
- Escolha uma VM ou pod de GPU interativo com VRAM suficiente para um fluxo de trabalho real — não para um benchmark teórico.
- Anexe armazenamento persistente antes de transferir modelos ou instalar nós personalizados.
- Mantenha o processo web do ComfyUI privado por predefinição; utilize um ambiente de trabalho autenticado, túnel ou proxy do fornecedor em vez de uma porta pública aberta.
- Guarde cada grafo funcional, revisão de modelo e saída no ponto de montagem persistente.
- Meça uma geração representativa e, em seguida, pare a GPU assim que a sessão de trabalho terminar.
O princípio fundamental é simples: uma GPU na nuvem para ComfyUI deve ser fácil de substituir, enquanto o seu estado de trabalho não deve ser.
1. Escolha o tipo de ambiente na nuvem certo antes de instalar o que quer que seja
Para uma sessão prática de ComfyUI, escolha uma VM de GPU, pod ou ambiente de trabalho remoto que lhe dê um navegador, terminal e um ponto de montagem persistente. Normalmente, é mais fácil de depurar do que um endpoint apenas de pedidos, porque pode inspecionar registos, testar um grafo, adicionar um modelo e iterar na mesma sessão.
Utilize uma implementação orientada a pedidos apenas depois de um fluxo de trabalho estar estável e de saber como irá receber entradas, devolver saídas, autenticar chamadores e recuperar de falhas. Um serviço de GPU na nuvem para ComfyUI interativo é o ponto de partida certo quando o objetivo é desenvolver fluxos de trabalho, e não uma API de produto finalizada.
Antes de implementar, responda a estas perguntas específicas do fornecedor:
| Pergunta | Porque é importante |
|---|---|
| Posso anexar armazenamento que sobreviva a um reinício ou substituição? | É dispendioso recriar ou transferir modelos e saídas. |
| Posso restringir o acesso de rede de entrada? | O ComfyUI não deve tornar-se um painel de controlo público sem autenticação. |
| Posso utilizar um terminal e ver registos? | A maioria dos problemas de instalação e de nós personalizados é mais rápida de diagnosticar a partir da shell. |
| O que continua a ser faturável depois de a GPU parar? | Computação, disco, instantâneos, IPs e tráfego de saída são frequentemente itens de faturação separados. |
| O volume está associado a uma região ou zona de disponibilidade? | Isso pode limitar onde a próxima GPU pode iniciar. |
Não escolha a melhor GPU na nuvem para ComfyUI apenas com base no nome de um modelo. Comece pela necessidade máxima de memória do fluxo de trabalho: checkpoint, codificadores de texto, VAE, modelos de controlo, LoRAs, tamanho do lote, resolução e quaisquer etapas de vídeo ou aumento de resolução competem todos por VRAM. Execute um grafo representativo e registe o seu comportamento no pico antes de se comprometer com uma máquina maior ou em execução durante mais tempo.
Para comparações mais abrangentes entre plataformas, consulte os guias da Flatkey sobre plataformas de aluguer de GPU na nuvem, seleção de GPU e capacidade de GPU sem servidor versus dedicada.
2. Anexe primeiro o armazenamento persistente
O erro mais comum na nuvem é transferir tudo para o sistema de ficheiros temporário da instância. Quando essa máquina é parada, reconstruída ou substituída, a cache de modelos, as saídas, os fluxos de trabalho e as alterações locais podem desaparecer com ela.
Crie e anexe o volume persistente antes da primeira instalação. Nesse volume, mantenha uma estrutura de diretórios pequena e simples:
/workspace/comfy-data/
├── models/
│   ├── checkpoints/
│   ├── vae/
│   ├── loras/
│   ├── controlnet/
│   └── upscale_models/
├── input/
├── output/
├── workflows/
├── custom-node-notes/
└── run-notes/
Não precisa de todas as pastas no primeiro dia. O objetivo é colocar os recursos reutilizáveis e o trabalho final no ponto de montagem durável, deixando os ficheiros temporários e os ambientes reconstruíveis no disco da instância quando for mais conveniente.
O ComfyUI disponibiliza controlos de diretórios úteis através das suas opções de arranque. --base-directory altera a localização base para modelos, nós personalizados, entrada, saída, ficheiros temporários e dados do utilizador; --input-directory, --output-directory e --extra-model-paths-config permitem-lhe ser mais específico. Consulte a atual referência de opções de arranque do ComfyUI antes de incorporar caminhos num modelo.
Como exemplo concreto de armazenamento na nuvem, a RunPod documenta que o seu sistema de ficheiros de contentor é temporário, enquanto os volumes persistem fora do ciclo de vida do contentor. Outros fornecedores utilizam termos diferentes; por isso, confirme o comportamento exato de paragem, reinício e terminação na documentação de armazenamento do próprio fornecedor antes de depender dele. O guia de persistência da RunPod explica de forma útil esta distinção.
3. Instale o ComfyUI com uma base reproduzível
Use o projeto upstream como referência para a instalação. O guia atual de instalação manual do ComfyUI abrange plataformas compatíveis, opções do PyTorch específicas para GPU, instalação de dependências, diretórios de modelos e a opção comfy-cli. Comece pelo README do ComfyUI oficial e, em seguida, registre quaisquer adições específicas da equipa nas suas próprias notas.
Para uma máquina Linux na nuvem, a sequência geral é esta:
git clone https://github.com/Comfy-Org/ComfyUI.git
cd ComfyUI

python -m venv .venv
source .venv/bin/activate

# Install the PyTorch build that matches this GPU/driver environment.
# Follow the current upstream ComfyUI and PyTorch instructions rather than
# copying a CUDA wheel command from an old image.
pip install -r requirements.txt

python main.py \
  --base-directory /workspace/comfy-data \
  --input-directory /workspace/comfy-data/input \
  --output-directory /workspace/comfy-data/output \
  --disable-auto-launch
Isto é intencionalmente uma base, e não um instalador universal para copiar e colar. As imagens na nuvem diferem em controladores, versões do Python, compatibilidade com CUDA, pontos de montagem e permissões. Confirme python main.py --help na máquina em execução e escreva o comando de arranque comprovado em run-notes/ assim que funcionar.
Se partilhar uma biblioteca de modelos com outra interface ou colocar modelos fora dos diretórios predefinidos do ComfyUI, utilize o mecanismo upstream extra_model_paths.yaml em vez de criar links simbólicos para pastas aleatoriamente. Isto mantém a relação explícita e torna uma reconstrução posterior muito menos surpreendente.
4. Configure o acesso remoto seguro antes de usar --listen
Por predefinição, o ComfyUI escuta em 127.0.0.1 e utiliza a porta 8188. As suas opções de arranque também suportam um endereço de associação diferente, porta, ficheiros de certificado/chave TLS e um cabeçalho CORS configurável. Consulte os argumentos da CLI atuais para obter o comportamento exato.
Essa flexibilidade não é um convite para colocar uma consola de geração de imagens sem autenticação na internet pública. Um padrão de ambiente de trabalho seguro do ComfyUI numa GPU na nuvem costuma ser mais seguro para trabalho interativo:
- Abra um navegador numa sessão de ambiente de trabalho remoto autenticada, mantendo o ComfyUI no loopback; ou
- Utilize um túnel SSH autenticado ou um proxy gerido pelo fornecedor; ou
- Coloque um proxy reverso com controlos de identidade e TLS à frente de um serviço ComfyUI exposto deliberadamente.
Associe-se a 0.0.0.0 apenas quando o caminho de rede estiver intencionalmente protegido por uma firewall, uma camada de identidade e TLS, quando apropriado. Não ative CORS permissivo apenas para fazer uma ligação no navegador funcionar. Se um nó personalizado, extensão ou proxy alterar o limite de confiança, registe-o em run-notes/ e teste a partir de uma conta ou dispositivo separado.
Isto é especialmente importante se carregar imagens de referência privadas, utilizar chaves de API dentro dos nós ou permitir que colegas instalem nós personalizados. Trate a instalação de nós personalizados como uma alteração de dependência: reveja a origem, registe a versão e teste-a num ambiente descartável antes de a adicionar a um volume de produção partilhado.
5. Torne reproduzível a primeira geração do ComfyUI numa GPU na nuvem
A sua primeira sessão deve comprovar o padrão de implementação, não perseguir uma imagem perfeita. Utilize um pequeno workflow conhecido e conclua este ciclo:
- Carregue uma imagem ou prompt de teste não sensível.
- Carregue um modelo a partir do diretório persistente de modelos.
- Execute uma única geração na resolução e no tamanho de lote pretendidos.
- Guarde o JSON do workflow em
workflows/com um nome descritivo e data. - Mantenha a imagem final e qualquer resultado de comparação em
output/. - Registe a revisão do modelo, os nós personalizados relevantes, o tempo de execução e qualquer solução alternativa de memória em
run-notes/.
Isto transforma uma geração do ComfyUI numa GPU na nuvem pontual num experimento que outra pessoa pode repetir. Também informa se a máquina tem o dimensionamento adequado antes de descarregar vários modelos grandes e descobrir que o workflow não pode ser executado com as definições pretendidas.
6. Utilize uma regra centrada na carga de trabalho para selecionar a GPU
A melhor GPU na nuvem para ComfyUI é a menor opção disponível que executa o seu grafo real de forma fiável na resolução, no tamanho de lote e com a latência de que necessita. O que é “melhor” muda consoante o grafo.
| Sinal da carga de trabalho | O que priorizar | O que testar antes de se comprometer |
|---|---|---|
| Um workflow de imagem única | VRAM suficiente para cada componente ativo, mais margem | Um prompt representativo na sua resolução habitual |
| Vários modelos de controlo, lotes grandes ou etapas de ampliação | Mais VRAM antes de procurar desempenho de computação bruto | Comportamento no pico de memória e tempo de execução de ponta a ponta |
| Grafos de vídeo, multiestágio ou com muitos modelos | Armazenamento persistente, carregamento rápido e um plano de reinício | Tempo de carregamento do modelo, utilização de disco temporário e gestão da saída |
| Sessões repetidas em equipa | Uma imagem/modelo reutilizável e controlos de acesso claros | Tempo de reconstrução a partir de uma instância limpa usando o mesmo volume |
Não confie no número de VRAM de outro criador como garantia. O checkpoint, a quantização, as versões dos nós, a resolução e as definições de lote dele podem não corresponder às suas. Um teste representativo de 10 minutos é mais útil do que uma recomendação de hardware excessivamente simplificada.
7. Calcule o custo com base no trabalho concluído, não na tarifa horária da GPU
Uma cotação de GPU na nuvem é apenas uma parte do total. Use esta planilha para cada fluxo de trabalho ou projeto:
Session cost
  = (GPU runtime × current provider compute rate)
  + retained storage for the billing period
  + applicable transfer, snapshot, or platform charges

Cost per accepted output
  = session cost / number of outputs you actually keep
O segundo número costuma ser mais útil do que o custo por imagem gerada. Se você executar 200 testes rápidos e mantiver cinco resultados, o custo por resultado aceito informa mais sobre o fluxo de trabalho do que o valor nominal por imagem.
Use estes controles práticos para uma GPU na nuvem com ComfyUI:
- Estabeleça o hábito de desligar. Defina quem para a GPU e quando. Não a deixe em execução apenas porque uma aba do navegador está aberta.
- Separe dados persistentes de dados descartáveis. Mantenha modelos, fluxos de trabalho, entradas e resultados em armazenamento durável; evite pagar para preservar arquivos temporários por acidente.
- Teste em pequena escala antes de ampliar. Valide um grafo com resolução e tamanho de lote modestos antes de se comprometer com uma longa execução de imagens ou vídeo.
- Mantenha um manifesto de modelos. Registre o que está instalado e por quê. Isso evita downloads duplicados e torna a limpeza mais segura.
- Revise a cobrança no estado parado. Armazenamento, snapshots, IPs públicos e regras de transferência de dados variam conforme o provedor; confirme-os na interface de faturamento e na documentação atuais.
- Registre dados de execução. Para um fluxo de trabalho repetido, anote o tempo de execução, as tentativas, os resultados aceitos e os tamanhos de entrada/saída. Isso cria uma base orçamentária real.
Para uma estrutura de decisão mais geral, leia Preços de aluguel de GPU explicados. O artigo aborda a diferença entre uma tarifa horária atraente e o custo do trabalho concluído.
8. Quando uma GPU na nuvem é a abstração errada
O ComfyUI é valioso quando você precisa de controle no nível de nós, arquivos de modelo locais, processamento personalizado, iteração visual ou um grafo específico. Ele não é automaticamente a forma mais simples de lançar um recurso de IA.
Se a necessidade do produto é uma chamada de modelo hospedado, e não controle no nível do fluxo de trabalho, compare separadamente uma abordagem de modelo/API gerenciada. A Flatkey oferece uma interface unificada para chamadas de API de modelos e ferramentas; isso pode reduzir a fragmentação de integração e faturamento, mas não substitui o ComfyUI quando seu requisito é um grafo de nós persistente com ativos locais personalizados. Deixe esse limite explícito antes de otimizar a pilha errada.
Lista de verificação pré-voo
Antes de iniciar uma sessão de GPU na nuvem com ComfyUI, confirme todos os itens a seguir:
- [ ] O armazenamento persistente está anexado e montado onde você espera.
- [ ] Os caminhos de modelos, fluxos de trabalho, entradas e resultados apontam para esse armazenamento.
- [ ] A combinação atual de GPU/PyTorch foi validada com um grafo real.
- [ ] O acesso remoto está autenticado; uma porta pública sem autenticação não está exposta.
- [ ] O JSON do fluxo de trabalho, a revisão do modelo e as alterações em nós personalizados serão registrados.
- [ ] Você sabe o que continua sendo cobrado depois que a GPU para.
- [ ] Um responsável designado interromperá a computação após a sessão.
Perguntas frequentes
Como executo o ComfyUI em uma GPU na nuvem?
Implante uma máquina de GPU interativa com um volume persistente, instale o ComfyUI de acordo com as instruções upstream atuais, direcione os caminhos de modelo/entrada/saída do ComfyUI para o armazenamento montado, mantenha o acesso do navegador privado e teste um fluxo de trabalho representativo antes de ampliar.
O que devo armazenar de forma persistente para o ComfyUI?
Armazene modelos reutilizáveis, fluxos de trabalho, ativos de entrada de que você precisará novamente, resultados finais, anotações sobre nós personalizados e um pequeno registro de execuções. Trate caches temporários e ambientes que podem ser recriados separadamente, a menos que mantê-los justifique o custo de armazenamento.
É necessário ter um desktop seguro de GPU na nuvem para o ComfyUI?
É uma escolha prática quando você quer um navegador e terminal interativos sem publicar o ComfyUI diretamente na internet. Use uma área de trabalho remota, túnel ou proxy autenticado e mantenha o aplicativo privado por padrão.
Qual GPU na nuvem é melhor para o ComfyUI?
Escolha com base na demanda de VRAM, no tempo de execução desejado e nas necessidades de armazenamento/acesso do seu fluxo de trabalho real. Teste primeiro o grafo pretendido; uma GPU que funciona para o checkpoint e a resolução de outra pessoa pode não servir para os seus.
O que um serviço de GPU na nuvem para ComfyUI deve incluir?
No mínimo: um ambiente de GPU compatível, armazenamento persistente, acesso de rede controlado, uma forma de inspecionar logs e informações claras de faturamento para recursos em execução e parados.
Referências oficiais usadas neste guia
- Instalação manual do ComfyUI e orientações sobre diretórios de modelos
- Sinalizadores de inicialização do ComfyUI
- Definições de argumentos de CLI do ComfyUI
- Guia do RunPod para persistir dados de contêineres — usado como exemplo concreto de armazenamento, não como comparação de plataformas
A configuração duradoura não é complicada: mantenha a GPU substituível, mantenha o trabalho persistente, mantenha o acesso privado e faça da interrupção da computação parte do fluxo de trabalho.