H200 GPU 价格:定价、成本驱动因素与购买指南
最后更新:2026 年 10 月 22 日。所有金额均为美元。公开价格变动频繁;在购买或预留容量前,请核实实时来源和确切配置。
如果您正在寻找 H200 GPU 价格,首先需要确定您实际要定价的对象。单张 H200 NVL PCIe 卡、HGX/DGX 风格的 H200 系统、八 GPU 云实例以及无服务器 H200 worker 是不同的产品,具有不同的成本结构。
以下当前公开示例说明,为什么单一的标题数字可能会产生误导:
- 公开的 H200 NVL 卡报价中,订购四至七张卡时每张约为 34,500 美元,而订购一至三张卡时每张为 42,651 美元。
- 一台配置完成的四 H200 服务器标价范围为 185,000–220,000 美元;一台八 H200 服务器标价范围为 305,000–370,000 美元。
- 云端 H200 也可以按 GPU 小时计费:当前一项 H200 Pod 费率为每小时 5.29 美元,而对应的无服务器 worker 费率为每小时 5.93 美元。
这些是有日期的公开报价,并非通用建议零售价,也不是推荐选择某一家供应商。对于“什么是 H200 GPU 价格?”这一问题,有用的答案是能够完成您工作负载的确切外形规格和运营模式的交付成本。
快速回答:使用短期租用来验证您所需的模型、上下文长度、拓扑和利用率。只有在确定 PCIe H200 NVL、八 GPU SXM 节点还是托管模型 API 更合适后,再获取采购报价。然后比较每个已完成工作负载的成本,而非仅比较卡价。
H200 GPU 价格概览:采购、系统和云端示例
该表特意列出一组独立的价格快照,而非市场平均价。卡的报价和八 GPU 云实例并不包含相同的硬件、支持、容量承诺或运营负担。
| 定价对象 | 公开价格快照 | 价格包含的内容 | 比较前需核实的内容 |
|---|---|---|---|
| H200 NVL PCIe 卡,订购 4–7 张 | 每张 34,500 美元 | Gatewell USA 2026 年 10 月 18 日所列的仅加速卡价格 | 零件号、散热、NVLink 桥接器、主机服务器、运费、税费、关税、保修 |
| H200 NVL PCIe 卡,订购 1–3 张 | 每张 42,651 美元 | Lineage Tech 的单件标价,已于 2026 年 10 月 16 日验证;不含增值税和关税 | 目的地、订购数量、运费、支持渠道、服务器兼容性 |
| 配置完成的 4× H200 NVL 服务器 | 185,000–220,000 美元 | 配置完成的风冷服务器报价,而非四张独立卡 | CPU、RAM、NVMe、NIC、桥接拓扑、电源、软件、支持 |
| 配置完成的 8× H200 NVL 服务器 | 305,000–370,000 美元 | 配置完成的风冷服务器报价,而非 HGX SXM 系统 | 同上,另加网络、机架和设施容量 |
| H200 云 Pod | 每 GPU 小时 5.29 美元 | Runpod 对此 H200 Pod 费率列出的配置为 141 GB VRAM、24 个 vCPU 和 276 GB RAM | 云服务层级、区域、可用性、附加存储、计费粒度、网络费用 |
| H200 无服务器 worker | 每 GPU 小时 5.93 美元 | Runpod 公布的无服务器 H200 费率 | 冷启动行为、并发性、请求模式、存储和出站流量 |
| AWS p5e.48xlarge Capacity Block | 每实例小时 54.924 美元,或每张 H200 6.866 美元 | 每个列出的实例配备八个 H200 加速器 | Capacity Block 条款、区域、时长、整实例承诺和相邻服务 |
| AWS p5en.48xlarge Capacity Block | 每实例小时 63.158 美元,或每张 H200 7.895 美元 | 每个列出的实例配备八个 H200 加速器 | Capacity Block 条款、区域、时长、整实例承诺和相邻服务 |
来源:Gatewell USA H200 NVL 列表、Lineage Tech H200 NVL 列表、Runpod 定价以及 AWS EC2 Capacity Blocks 定价。价格于 2026 年 10 月 22 日核查。
前两行中的 H200 GPU 价格是 PCIe H200 NVL 卡的价格。服务器行增加了运行多张卡所需的平台。云端行则将该基础设施转化为服务费率。不要将这些数字平均在一起。
为什么 H200 GPU 价格不是一个单一数字
NVIDIA 发布了两种实质不同的 H200 部署形态。两者均列有 141 GB HBM3e 内存和 4.8 TB/s 内存带宽,但它们并非可互换的采购选项:
| 外形规格 | 典型部署 | NVIDIA 数据表中的最大板卡功耗 | 互连影响 |
|---|---|---|---|
| H200 NVL | 安装在风冷服务器中的双槽 PCIe 卡 | 最高 600 W,可配置 | PCIe Gen5 加上双路或四路 NVLink 桥接器 |
| H200 SXM | 安装在 HGX 合作伙伴系统或 NVIDIA-Certified 系统中的 SXM 模块 | 最高 700 W,可配置 | 适用于大型多 GPU 系统的 NVLink 互连 |
NVIDIA 的H200 数据表和 HGX 参考架构也说明了为何系统报价差异如此之大:H200 SXM 围绕多 GPU 拓扑设计,而 NVL 卡则部署在采用不同互连模型的传统 PCIe 服务器中。
这种区别会从四个方面改变预算:
- 加速器可能不是您购买的唯一产品。PCIe H200 NVL 卡仍需要经过认证的主机、气流、CPU、内存、存储、网络适配器、导轨和支持服务。SXM 报价通常意味着一项多 GPU 系统决策。
- 拓扑可能改变您所需的 GPU 数量。如果工作负载需要一个由八个 GPU 组成的 NVLink 域,那么相关的替代方案是八 GPU 租用或系统,而不是单卡价格。
- 电力和散热是真实的预算项目。600 W 和 700 W 数值是最大板卡功耗规格,并非您的实际计量功耗。不过,它们仍表明您应在报价中要求提供电力、散热和机架要求。
- 数量会改变报价。上面的两条卡产品信息之所以不同,是因为其卖家、地点和订购数量不同。零件编号比通用的“H200”标签更有用。
H200 所支付的价值:内存容量与拓扑
H200 是 Hopper 一代的加速器,但购买决策通常关乎内存,而不是笼统地宣称速度更快。NVIDIA 列出的 H200 规格为 141 GB HBM3e 和 4.8 TB/s 内存带宽。在其 HGX 架构表中,NVIDIA 列出的 H100 SXM 为 80 GB 和 3.35 TB/s,而 H200 SXM 为 141 GB 和 4.8 TB/s。
当您的工作负载受以下因素限制时,这些额外容量可能很重要:
- 无法装入 80 GB 的模型或量化方案;
- KV 缓存占用工作内存的长上下文推理;
- 否则会迫使您增加模型并行度的批处理大小;
- 原始算力并非瓶颈,而 GPU 间流量才是瓶颈的多 GPU 设计。
这并不意味着 H200 对每项推理任务都会自动更便宜。如果模型、批处理和上下文窗口能够舒适地装入更小的加速器,H200 GPU 价格溢价未必会降低每个被接受结果的成本。在将内存容量视为采购结果之前,应对您实际将运行的模型和服务堆栈进行基准测试。
如需了解这些数据背后的架构和部署决策,请阅读 Flatkey 的H200 GPU 指南及其H200 与 H100 对比。
将每小时 H200 GPU 价格转换为月度预算
对于租赁容量,请从已分配的 GPU 小时数开始计算:
monthly compute cost =
  allocated H200 GPU-hours × effective hourly rate
在持续分配的情况下,一个 GPU 在 30 天的月份中约有 730 小时。以下运行成本使用上述已公布的每 GPU 数值,并假设该费率在每个小时均可获得。这些成本不包括存储、数据传输、税费、支持服务以及任何承诺规则。
| 示例所用的公布费率 | 730 个已分配 H200 小时 | 重要注意事项 |
|---|---|---|
| 每小时 $5.29 | 每月 $3,861.70 | 云 Pod 费率并不保证有库存,也不代表完整的工作负载账单 |
| 每小时 $5.93 | 每月 $4,328.90 | 选择 Serverless 通常是出于流量形态考量,而不是为了 24/7 的闲置分配 |
| 每小时 $6.866 | 每月 $5,012.18 | AWS p5e 显示的是 Capacity Block 的每加速器等效价格;请确认所需的完整实例和期限承诺 |
| 每小时 $7.895 | 每月 $5,763.35 | AWS p5en 也是 Capacity Block 的每加速器等效价格;请确认所需的完整实例和期限承诺 |
对于一个八 GPU 节点,在添加其周边服务之前,先将每 GPU 运行成本乘以八。这就是为什么 AWS 表中的 $6.866 H200 等效费率,对应于每小时 $54.924 的 p5e.48xlarge 价格。
每小时公布的H200 GPU 价格应只是您运营预算中的一行。还应加入:
- 用于模型权重、检查点和数据集的附加或持久存储;
- 数据传输和私有网络要求;
- 实例中包含的 CPU、RAM 和本地 NVMe;
- 编排、可观测性、备份和事件响应工作;
- 失败的作业、重新加载、闲置时间和重试放大;
- 预留、Capacity Block 或中断条款。
Flatkey 的GPU 租赁价格指南和云 GPU 隐藏成本指南为这些非加速器预算项目提供了更全面的核对清单。
购买与租赁:使用盈亏平衡计算作为筛选工具
作为初步评估,您可以计算一个仅限硬件的筛选数值:
hardware-only screening hours =
  listed accelerator price ÷ comparable delivered GPU-hour rate
使用两个公开的 H200 NVL 卡示例以及每小时 $5.29 的 Pod 费率:
| 仅作示例 | 计算 | 结果 |
|---|---|---|
| $34,500 显卡报价 ÷ 每小时 $5.29 | 34,500 ÷ 5.29 | 约 6,522 GPU 小时,或按每月 730 小时计算约 8.9 个月 |
| $42,651 显卡报价 ÷ 每小时 $5.29 | 42,651 ÷ 5.29 | 约 8,063 GPU 小时,或按每月 730 小时计算约 11.0 个月 |
这不是真正的回本计算。它有意排除了主机服务器、网络、电力、制冷、税费、关税、支持服务、停机时间、利用率、融资和残值。它还比较了不同供应商的产品。请用它来识别值得建模的问题,而不是用于批准采购订单。
完整的所有权模型应更接近如下形式:
annual ownership cost =
  system acquisition or financing
  + power and cooling
  + rack, colocation, and network
  + support, software, and operations
  + storage and backup
  + expected downtime and unused capacity
  - expected residual value

cost per completed workload =
  annual ownership cost ÷ accepted jobs, requests, tokens, or training runs
同样的原则也适用于云定价:
cloud cost per completed workload =
  (GPU-hours + storage + network + managed services + failed work)
  ÷ accepted jobs, requests, tokens, or training runs
分母是防止看似较低的每小时 H200 GPU 价格掩盖糟糕部署的关键。请选择与业务结果相匹配的单位:一次成功的微调、一个被接受的批次、一段生成的视频、一个已支持的请求,或一个经验证的推理结果。
采购和 ML 基础设施团队的 H200 购买清单
在比较供应商报价之前,请使用此清单。
- 写下准确的 SKU 和零件编号。区分 H200 NVL PCIe 与 H200 SXM。不要将“H200”视为足够的配置信息。
- 询问系统级别包含哪些内容。记录 GPU 数量、CPU、RAM、NVMe、NIC、电源、导轨、NVLink 桥接器、保修和软件授权。
- 先对拓扑建模,再确定数量。测试您的模型需要一块 GPU、四块互连 GPU,还是八 GPU 互连架构。购买错误的拓扑,比在评估期间支付更高的每小时费率更昂贵。
- 索取电力和制冷假设。记录设施条件以及所需的气流或液冷设计。切勿仅根据 TDP 直接制定预算。
- 统一税费、关税、运费和交付周期。例如,$42,651 的 Lineage 价格明确不含增值税和关税;送达报价可能因目的地而存在显著差异。
- 测量利用率,而非假设为 100%。生产性利用率为 45% 的系统,与持续排程的集群,其所有权情况截然不同。
- 将模型存储成本与 GPU 成本分开。权重、检查点、数据集、快照和数据传输都可能改变云端方案的成本。
- 设定退出假设。记录预期使用寿命、残值,以及后继架构是否可能在模型完全摊销前使该容量的吸引力下降。
- 纳入运维。在模型中加入监控、容量调度、安全、补丁、事件响应和待命支持。
- 运行具有代表性的基准测试。在精确的软件栈上记录吞吐量、p50/p95 延迟、失败率、加载时间、质量验收情况以及账单中可见的成本。
何时 H200 是正确选择,以及何时不是
| 情况 | 起始路径 | 原因 |
|---|---|---|
| 您仍在确定合适的模型、上下文窗口或 GPU 数量 | 先租用 H200 容量 | 在工作负载变化期间,避免拥有错误的拓扑 |
| 您具有持续、可预测的多 GPU 利用率和运营能力 | 获取系统报价并建立所有权 TCO 模型 | 稳定的需求可能使服务器级采购方案值得评估 |
| 任务具有突发性或流量不均衡 | 比较 Pods、无服务器和预留容量 | 空闲时间可能主导固定部署的成本 |
| 您需要 CUDA 级控制、自定义服务或特定运行时 | 评估 H200 部署选项 | 工作负载可能需要直接使用基础设施 |
| 您需要模型能力,但不需要 GPU 控制 | 在 GPU 容量之外,同时比较托管模型 API | 运营边界可能比 H200 GPU 价格更重要 |
对于最后一种情况,请避免将选择定义为“云端还是本地部署”。模型 API 和 GPU 租赁都可以是云服务,但它们带来的责任不同。如果您的团队不需要运营模型权重、驱动程序、容量或服务栈,请将 API 路径的请求级成本与 H200 部署的已完成工作负载成本进行比较。有关实用的决策框架,请参阅 GPU 云服务与模型 API。
如何公平地比较两份 H200 报价
请向每个供应商索取相同的工作表,然后根据报价填写,而不是根据搜索结果填写:
| 字段 | 报价 A | 报价 B | 重要性 |
|---|---|---|---|
| 确切的 H200 外形规格和部件号 | 避免 NVL/SXM 混淆 | ||
| GPU 数量和 NVLink/NVSwitch 拓扑 | 决定可用的多 GPU 行为 | ||
| 主机 CPU、RAM、本地 NVMe 和 NIC | 改变系统吞吐量及已包含的内容 | ||
| GPU 小时、系统价格或承诺金额 | 明确计费单位 | ||
| 计费增量和中断策略 | 防止低标价掩盖利用率风险 | ||
| 存储、出站流量和数据迁移 | 通常不包含在加速器价格中 | ||
| 保修、支持和更换 SLA | 影响运营风险和停机时间 | ||
| 电力、冷却、机架和交付 | 与云端费率比较所有权成本时必需 | ||
| 基准测试配置和验收规则 | 将价格转化为每个已完成工作负载的成本 |
这份工作表比泛泛搜索“最佳 H200 GPU 价格”更有用,因为它将价格和能力放在同一行中。
常见问题
H200 GPU 的价格是多少?
对于截至 2026 年 10 月 22 日查到的公开 H200 NVL PCIe 卡示例,一家卖家对购买四至七张卡的订单报价为每张 34,500 美元,另一家则对购买一至三张卡的订单报价为每张 42,651 美元。这些是因供应商和数量而异的报价,并非单一的全球 H200 GPU 价格。服务器、运费、税费、关税、冷却和支持都会改变交付成本。
H200 NVL 的价格与 H200 SXM 相同吗?
不相同。H200 NVL 是专为风冷服务器以及双路或四路 NVLink 桥接而设计的 PCIe 卡。H200 SXM 是面向 HGX 风格系统和更大规模多 GPU 互连架构的模块。请比较完整的系统配置,而不只是 141 GB 内存这一项。
按小时租用 H200 的成本是多少?
本指南中的公开示例包括:Runpod 的 H200 Pod 每小时 5.29 美元、H200 无服务器工作器每小时 5.93 美元,以及 AWS Capacity Block 等效价格中 p5e 每张 H200 6.866 美元、p5en 每张 H200 7.895 美元。这些属于不同的服务类型和承诺期限,因此在将其视为可互换的价格前,请确认实时费率和计费条款。
我应该购买 H200 还是租用一张?
当工作负载、利用率、拓扑或模型路线图尚不确定时,选择租用。只有在您拥有稳定的利用率预测、系统级报价、设施和支持计划,以及涵盖加速器周边所有成本的每已完成工作负载成本模型后,才考虑购买。
对于 LLM 推理,H200 是否优于 H100?
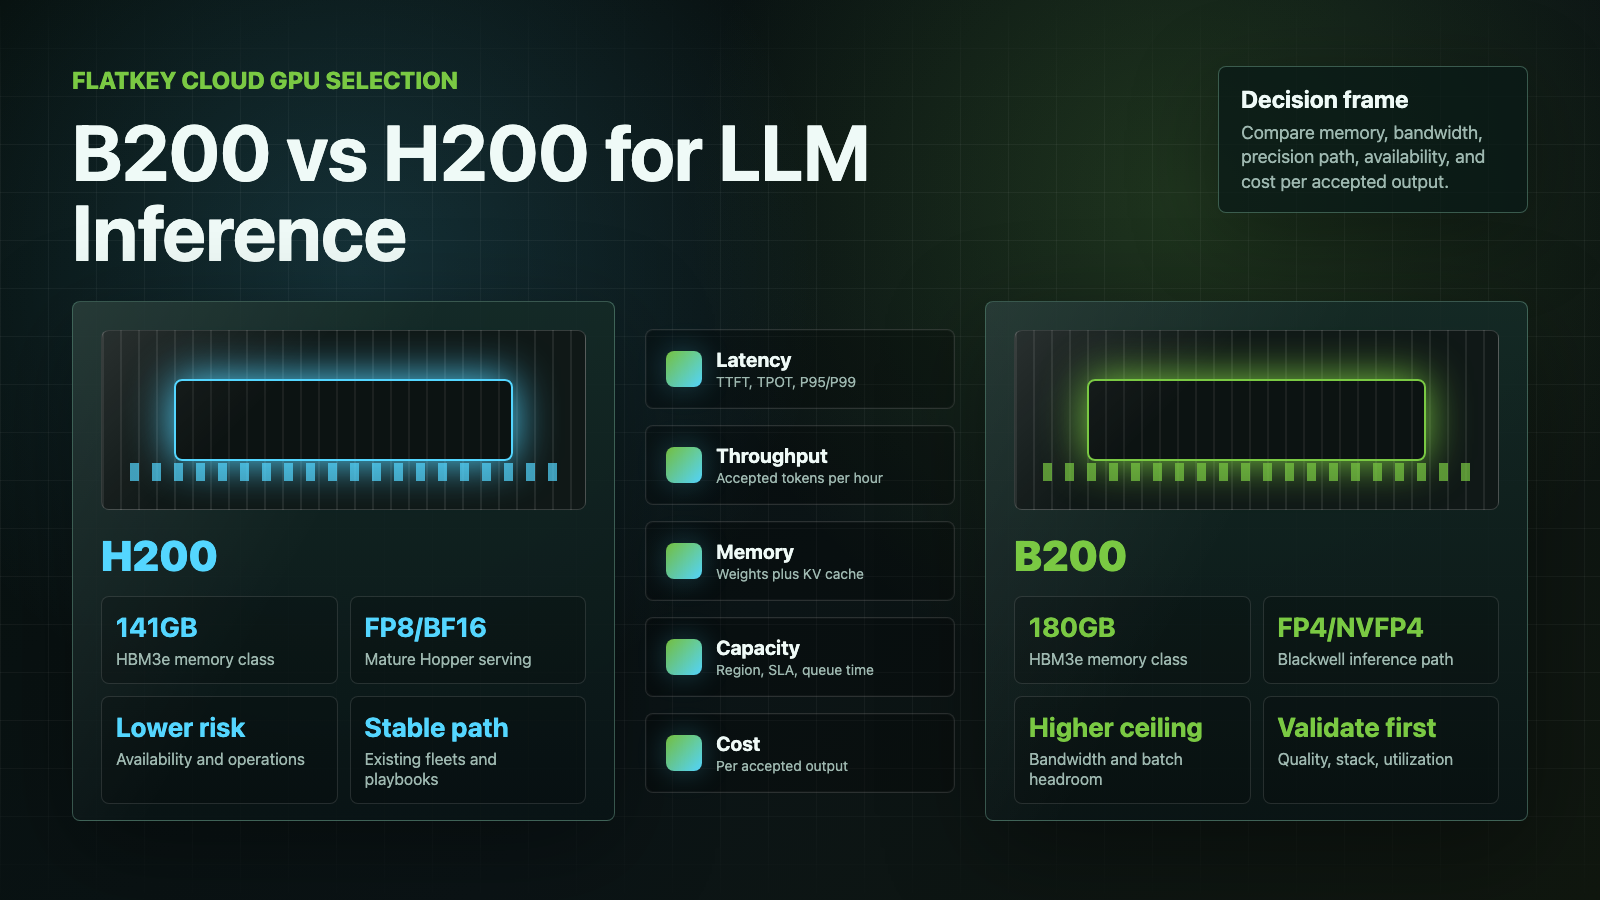
当 141 GB HBM3e、4.8 TB/s 带宽或目标拓扑能够消除实际的内存或批量大小限制时,H200 可能是更好的选择。对于已能在 H100 级部署上轻松运行的工作负载,它不一定自动具有更高性价比。请测试您的模型、上下文长度、批量大小和服务栈。Flatkey 的 H200 与 H100 指南详细介绍了技术对比。
最终建议
合适的 H200 GPU 价格 并不是最低的卡价,也不是最低的小时费率。它是在您实际需要的内存、拓扑、可靠性和运营模式下,完成目标工作负载所需的最低经验证成本。
先从有时间限制的租用基准测试开始。记录确切的 H200 外形规格、分配小时数、存储、网络、故障率和输出验收情况。如果工作负载变得足够稳定而有理由拥有设备,请索取系统级报价并比较完整 TCO——而不只是加速器单项成本。如果您需要的是模型能力而非基础设施控制,也应同时评估托管 API 路线的价格。
Flatkey 可帮助团队比较这种 API 替代方案,而无需分散集成:其产品是一个统一的模型与工具路由层,提供一个密钥、一个余额以及请求级用量可见性。当您准备好在 H200 计划旁测试模型/API 路径时,获取 API 密钥。