
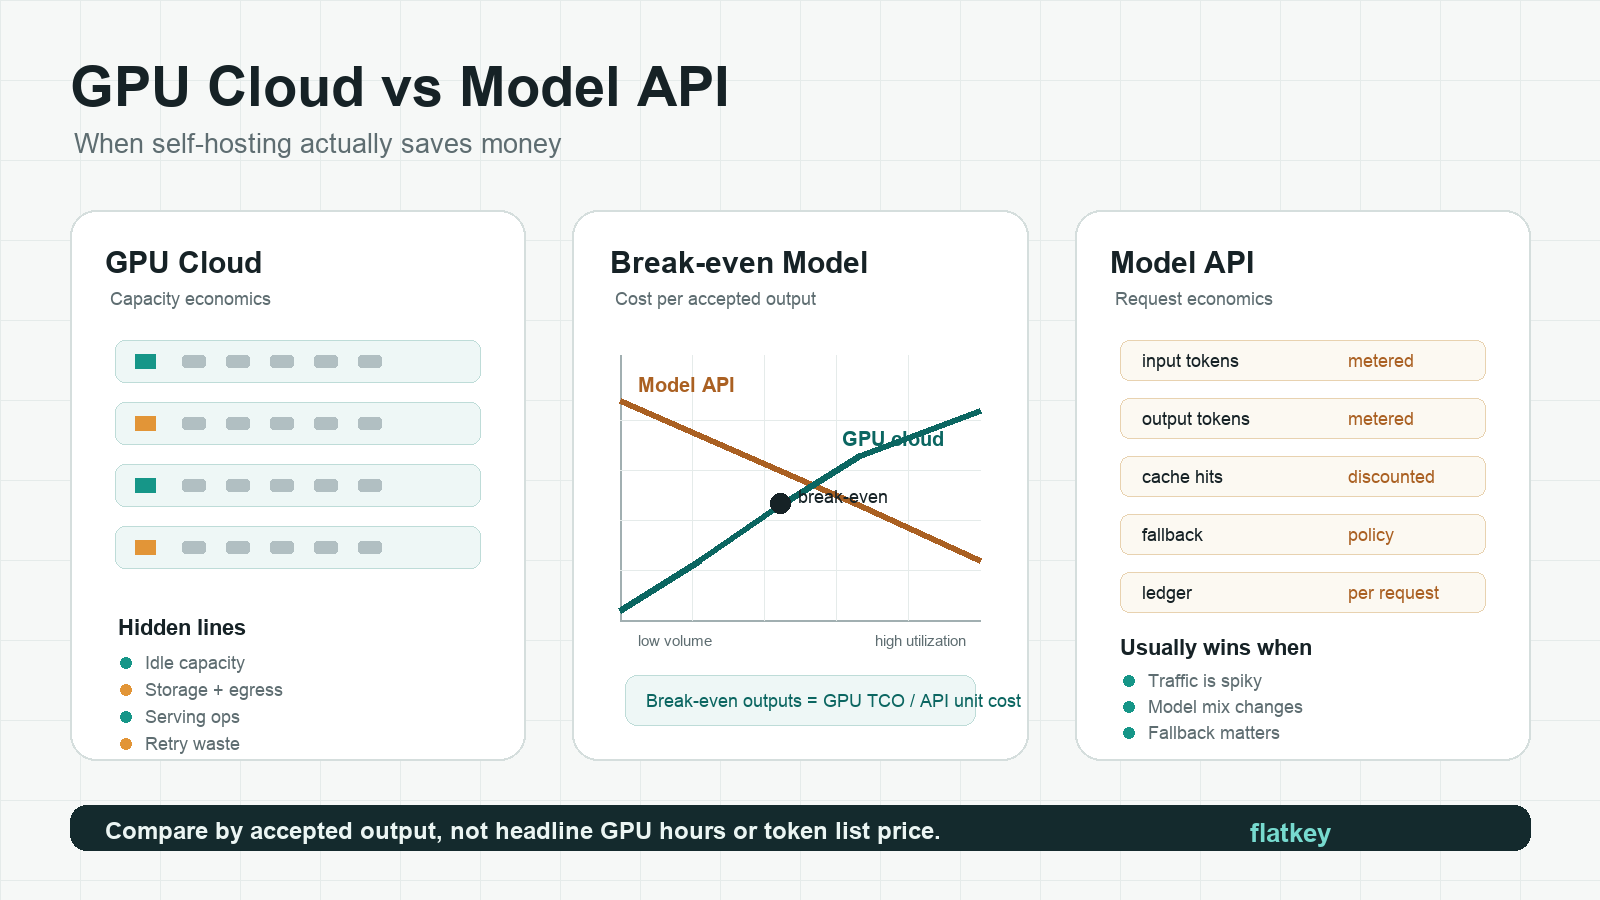
大多数团队太晚才开始问 GPU 云 vs 模型 API 的问题。他们先租 GPU、部署服务栈、调优批处理、雇用平台支持,然后才把账单和托管模型 API 作比较。到那时,比较结果已经偏向了他们已经投入精力的那条路径。
更好的问题更简单:你需要对 GPU 层的控制,还是只需要以最低可接受成本获得可靠的模型输出?
对于企业 AI 团队来说,当你有持续需求、稳定的模型选择、高有效利用率,以及能运行推理的工程团队时,GPU 云通常会开始省钱。当流量呈尖峰状、模型选择经常变化、重试和故障切换比硬件控制更重要,或者你需要无法自托管的前沿模型时,模型 API 通常更便宜。
Flatkey 的实用规则:比较 GPU 云 vs 模型 API 时,应按每个被接受的输出成本来比较,而不是只看 GPU 小时费率或 token 标价。
GPU 云 vs 模型 API 快速答案
在做电子表格之前,先用这张表。
| 场景 | 通常先从 | 原因 |
|---|---|---|
| 早期产品、提示词变化频繁、需求不确定 | 模型 API | 在你了解流量、质量和模型匹配度时,可以避免 GPU 闲置。 |
| 单个稳定开源模型上的大批量批处理推理 | GPU 云 | 持续利用率可以摊薄服务栈成本。 |
| 面向客户的聊天,且突发流量不可预测 | 模型 API 或混合方案 | 自动扩缩容、回退机制和无闲置容量通常比原始单价更重要。 |
| 专有权重、自定义内核、严格的数据本地性 | GPU 云 | 业务需求是控制,而不仅仅是成本。 |
| 多供应商模型路由、前沿模型,或频繁切换模型 | 模型 API | 你无需为每次模型变更重建服务基础设施。 |
| 经验证具有利用率的长期稳定工作负载 | 预留 GPU 云、专用 GPU 集群,或托管共址 GPU | 在需求得到验证后,承诺使用可以降低有效容量成本。 |
本指南其余部分提供了一个可直接复用的模型,用于比较 GPU 云 vs 模型 API,而不会隐藏闲置时间、重试、运维或质量过滤的影响。
真正重要的成本单位
不要比较:
- GPU 小时费率 vs token 价格。
- 云报价 vs 最佳情况基准测试。
- 模型 API 标价 vs 完全利用的自托管集群。
而应比较以下这些分母之一:
| 工作负载 | 最佳分母 |
|---|---|
| LLM 聊天或 Agent | 每个被接受的响应、被接受的任务,或被接受的输出 token 成本 |
| 批量分类或信息抽取 | 每个被接受记录的成本 |
| 代码生成 | 每个被接受补丁或已完成编码任务的成本 |
| 图像生成 | 经过质量过滤后每张被接受图像的成本 |
| 视频生成 | 每个被接受秒数或被接受片段的成本 |
| 微调或训练 | 每次完成运行的成本 |
对于大多数推理团队:
effective_unit_cost =
  all_in_monthly_cost
  / accepted_outputs_after_retries_quality_filters_and_failures
这正是许多 GPU 云 vs 模型 API 的比较发生逆转的地方。一个自托管端点可能在基准吞吐量上表现很好,但如果利用率很低、模型未通过质量检查,或者工程师花太多时间维持栈的健康状态,它仍然会输。
模型 API 成本模型
模型 API 看起来很简单,因为账单通常按请求、token、图像、视频秒数或工具调用计量。但一个公平的模型 API 模型仍然需要考虑的不只是公开的单价。
使用这个模型:
monthly_model_api_cost =
  input_token_cost
  + cached_input_or_context_cost
  + output_token_cost
  + tool_or_media_cost
  + retry_and_fallback_cost
  + gateway_or_router_cost
  + observability_and_finops_cost
然后进行归一化:
model_api_cost_per_accepted_output =
  monthly_model_api_cost
  / accepted_outputs
需要捕获的内容:
| 成本项 | 检查什么 |
|---|---|
| 输入和输出 token | 官方供应商定价页面、模型 ID、上下文窗口、输出上限以及检查日期。 |
| 缓存输入 | 供应商是否支持提示词缓存或缓存命中折扣,以及你的工作负载是否 वास्तव वास्तव पुन用上下文。 |
| 批处理定价 | 批处理或异步处理是否符合你的延迟要求。 |
| 重试 | 限流重试、瞬时错误、质量检查失败,以及回退请求。 |
| 路由器/网关层 | 任何网关费用、使用台账、模型白名单、子密钥预算或发票流程。 |
| 运维 | 集成、监控、供应商状态处理以及财务对账。 |
请使用官方源页面获取当前数字,而不是复制来的费率表。先从 OpenAI API 定价、Anthropic 定价、Google Gemini API 定价,以及你的网关或路由器当前定价页面开始。
对于 Flatkey 来说,模型 API 这一侧就是:一个密钥、一个余额、一个使用台账,覆盖官方模型和工具。当真正的成本问题不是一次模型调用,而是分散的密钥、多张账单、按团队的预算控制,以及跨供应商回退时,这一点就很重要。
GPU 云成本模型
GPU 云不只是 GPU 的每小时价格。一个生产环境中的自托管模型 API 还包括容量成本、推理服务软件、存储、网络、监控、可用性工作以及闲置容量。
使用这个模型:
monthly_gpu_cloud_cost =
  gpu_compute_hours
  + storage_and_snapshot_cost
  + bandwidth_and_egress_cost
  + load_balancing_and_network_cost
  + serving_stack_cost
  + observability_and_logging_cost
  + platform_engineering_cost
  + support_plan_or_managed_service_cost
  + idle_capacity_cost
  + retry_failure_and_redeployment_waste
然后进行归一化:
self_hosted_cost_per_accepted_output =
  monthly_gpu_cloud_cost
  / accepted_outputs
需要捕捉的内容:
| 成本项 | 它为何会改变答案 |
|---|---|
| GPU 型号和显存 | H100、H200、B200、A100、L40S 和 RTX 级别 GPU 在显存、吞吐量、供给和价格曲线上各不相同。 |
| 产品模式 | 按需、竞价实例、预留、市场、无服务器 GPU、专用集群和裸金属的可靠性特征不同。 |
| 利用率 | 如果 GPU 一直闲置,更便宜的自托管端点很快就会失去优势。 |
| 推理服务栈 | vLLM、SGLang、TensorRT-LLM、NIM 或自定义服务器都需要真实的运维支持。 |
| 存储和模型加载 | 大型权重、快照、卷和重复拉取可能会变成显著成本。 |
| 网络 | 出站流量、私有链接、公共 IP 和负载均衡都会改变单位经济性。 |
| 故障 | 显存不足错误、抢占、损坏的容器和冷启动都会提高可接受输出成本。 |
使用当前供应商页面作为核对点:AWS EC2 pricing、AWS P5 instances、Google Cloud GPU pricing、RunPod pricing、Lambda GPU Cloud 和 Vast.ai pricing。
把每个 GPU 价格都视为带时间戳的数据。市场供给、区域可用性和承诺报价的变化速度,可能比你正在阅读的文章还快。
盈亏平衡公式
这就是 GPU 云 vs 模型 API 的决策从观点驱动变成财务级分析的地方。
最简单的盈亏平衡模型是:
break_even_outputs =
  monthly_gpu_cloud_cost
  / model_api_cost_per_accepted_output
如果你的工作负载产生的可接受输出多于 break_even_outputs,自托管可能更省钱。如果更少,模型 API 可能更便宜。
你也可以用利用率来表达同样的想法:
required_utilization =
  monthly_gpu_cloud_cost
  / equivalent_model_api_cost_at_expected_volume
只有当工作负载稳定时,这个公式才有用。如果每个月的流量、模型、上下文长度或质量目标都会变化,那么模型 API 一侧具有利用率公式无法体现的选择价值。
示例:为什么 GPU 每小时价格会误导人
假设某团队正在决定是否自托管一个稳定的开源模型。
| 输入 | 示例值 |
|---|---|
| GPU 云全包成本 | 每月 $24,000 |
| 可接受输出量 | 每月 3,000 万次可接受输出 |
| 自托管每次可接受输出成本 | $0.0008 |
| 模型 API 每次可接受输出成本 | $0.0012 |
| 相同用量下每月模型 API 成本 | $36,000 |
| 表面上的自托管节省 | 每月 $12,000 |
在这个基准情形下,GPU 云看起来确实更省钱。
现在来压力测试这些假设。
| 变化 | 影响 |
|---|---|
| 有效利用率下降 35% | 由于固定 GPU 池完成的可接受工作更少,自托管单位成本会上升。 |
| 重试或质量失败率翻倍 | 两种路径都会更贵,但自托管还要吸收容量浪费。 |
| 产品切换到更大的模型 | 现有 GPU 可能需要切分、更多显存,或需要新的推理服务栈。 |
| 需求变得尖峰化 | 模型 API 可以随需求扩缩;GPU 池必须按峰值配置,或者接受排队。 |
如果不利情形足以抹去节省,那么自托管实际上并不更便宜。它是一场容量押注。
GPU 云真正省钱的时候
当以下大多数条件成立时,GPU 云可以省钱:
- 你有持续需求,而不是偶发性峰值。
- 模型家族会稳定数月,而不是数天。
- 该模型是开源权重,或以其他方式可供自托管。
- 在队列间隙和故障之后,工作负载仍能保持较高的有效利用率。
- 通过你的服务栈可以满足延迟目标。
- 你可以可靠地运行 vLLM、SGLang、TensorRT-LLM、NIM 或其他栈。
- 团队可以监控 GPU 利用率、显存压力、p95/p99 延迟、错误率和重试放大。
- 你已经为模型加载、缓存预热、关停自动化以及发布安全性制定了方案。
- 报价包含存储、出站流量、支持和可用性假设。
- 财务团队能够接受在每个请求到达之前先为容量提供资金。
这在高吞吐批量推理、内部抽取流水线、稳定的支持机器人、领域特定的开源模型,以及自定义权重或数据本地性很重要的工作负载中都很常见。
如需更深入的 GPU 侧规划,请参考 Flatkey 的指南:GPU 租赁价格、用于 LLM 推理的最佳 GPU、GPU 集群租赁以及GPU 集群总拥有成本。
何时模型 API 仍然更便宜
当以下情况成立时,模型 API 通常仍然更便宜:
- 流量具有突发性、季节性,或仍然未知。
- 应用需要多个前沿模型。
- 模型变化速度快于你的基础设施规划。
- 团队更需要故障转移、速率限制处理、发票、使用日志和预算控制,而不是硬件控制。
- 你无法让 GPU 保持足够高的忙碌度来抵消空闲时间。
- 你没有准备好平台团队来运维服务层。
- 工作负载包含闭源模型、多模态生成、专有提供商能力,或快速演进的模型发布。
- 采购希望按请求归属成本,而不是使用池化的基础设施账单。
这也是 GPU 云与模型 API 比较不只是关于价格的时候。模型 API 可以减少集成时间、采购复杂度和事故面。
当团队希望通过一个兼容 OpenAI 的入口使用多个官方模型、一个预充值余额、一张发票、子密钥预算、模型白名单、请求级使用记录,以及在上游渠道之间进行故障切换时,Flatkey 就适合这一侧的决策。参见相关文章:AI 模型定价比较、AI API 定价比较、AI 网关定价以及AI API 支出管理。
混合方案往往才是真正的答案
许多企业 AI 团队不应强行只选一个通用答案。混合模式通常更有说服力:
| 工作负载切片 | 更合适的默认选择 |
|---|---|
| 稳定的高吞吐开源权重推理 | GPU 云 |
| 前沿模型推理或代码生成 | 模型 API |
| 可以排队的批处理作业 | GPU 云、竞价实例或预留容量 |
| 面向客户的突发流量 | 模型 API 或混合溢出 |
| 专有权重 | GPU 云 |
| 模型探索 | 模型 API |
| 带基础设施控制的受监管部署 | 专用 GPU 云、私有 GPU 云、机房托管或本地部署 |
混合模式是这样的:
- 通过模型 API 路由未知且变化大的工作负载。
- 在 GPU 云上对稳定工作负载进行基准测试。
- 只将已证明有规模且模型稳定的工作负载迁移到自托管。
- 保留模型 API 作为溢出、模型升级和提供商多样性的备用方案。
这条路径避免了最昂贵的错误:为后来形态会变化的工作负载购买 GPU 容量。
切换前的基准测试计划
让同一流量至少在一个具有代表性的时间窗口内同时走两条路径。
| 指标 | GPU 云路径 | 模型 API 路径 |
|---|---|---|
| 接受的输出 | ||
| 输入 token 或记录数 | ||
| 输出 token 或结果数 | ||
| p50 / p95 / p99 延迟 | ||
| 首个 token 的时间 | ||
| 错误率 | ||
| 重试率 | ||
| 质量拒绝率 | ||
| 空闲容量 | N/A | |
| 员工工时 | ||
| 存储和出站流量 | ||
| 总成本 | ||
| 每个接受输出的成本 |
然后问:
- 在考虑空闲时间后,GPU 云是否仍然更优?
- 在考虑员工时间后,它是否仍然更优?
- 在考虑重试和质量过滤后,它是否仍然更优?
- 如果模型发生变化,它是否仍然更优?
- 如果流量下降 30%,它是否仍然更优?
- 如果 p95 延迟必须改进,它是否仍然更优?
如果在不利情况下答案仍然是“是”,那么自托管就值得走严肃的采购流程。
采购检查清单
对于 GPU 云:
- 包含哪些确切的 GPU、显存大小、CPU、RAM、磁盘、互连和网络带宽?
- 容量是按需、竞价、市场、受保护云、预留、专用还是裸金属?
- 哪些存储、快照、出站流量、公网 IP、负载均衡器、支持和可观测性成本被排除在外?
- 在主机故障、抢占、维护或容量短缺期间会发生什么?
- 提供商能否在承诺前运行你的实际基准测试?
- 最短期限、爬坡路径和退出成本是多少?
对于模型 API:
- 使用了哪些确切的模型 ID、上下文窗口、输出上限和计价单位?
- 缓存命中、批处理作业、图像/视频单位以及工具调用是否单独计费?
- 速率限制和备用选项是什么?
- 重试、失败的提供商调用和质量拒绝如何计数?
- 财务部门能否按团队、密钥、模型、环境和客户导出用量?
- 适用哪些数据保留、合规和 SLA 条款?
来源清单
将以下官方页面作为当前输入的起点:
| 来源类型 | 需要查看的页面 |
|---|---|
| 模型 API 定价 | OpenAI API 定价、Anthropic 定价、Google Gemini API 定价 |
| GPU 云定价 | AWS EC2 定价、AWS P5 实例、Google Cloud GPU 定价、RunPod 定价、Lambda GPU Cloud、Vast.ai 定价 |
| 服务框架 | vLLM OpenAI 兼容服务器、SGLang 文档 |
| GPU 规格 | NVIDIA H100、NVIDIA H200、NVIDIA DGX B200 |
| FinOps 结构 | FinOps FOCUS |
| Flatkey 成本上下文 | Flatkey 定价、Flatkey Compute、Flatkey Compute 价格索引 |
常见问题
GPU 云总是比模型 API 更便宜吗?
不是。只有当有效利用率足够高,能够抵消闲置容量、存储、出站流量、服务运维、重试浪费和人员时间时,GPU 云才更便宜。对于突发性或变化快的工作负载,即使按 token 计算的价格看起来更高,模型 API 也可能更便宜。
什么时候自托管 LLM 能省钱?
当模型稳定、量大、利用率可预测、团队能够运维服务栈,并且在不利假设下,每个被接受输出的 GPU 云全包成本低于模型 API 成本时,自托管才能省钱。
我应该如何比较 GPU 云与模型 API 定价?
比较每个被接受输出的成本。要包括 token、GPU 小时、存储、带宽、闲置时间、重试、失败率、质量过滤、工程时间、支持和财务运营。不要只比较每小时 GPU 价格和 token 列表价格。
GPU 云推理最大的隐性成本是什么?
最大的隐性成本通常是闲置容量、工程运维、存储和出站流量、失败的部署、内存不足重试,以及测试不足的服务变更。这些成本不会出现在表面的 GPU 每小时费率中。
模型 API 最大的隐性成本是什么?
最大的隐性成本通常是重试、备用调用、超长提示词、未缓存上下文、重输出响应、工具或媒体调用、分散的提供商账号,以及薄弱的用量归因。按请求级别的账本有助于暴露这些成本。
企业 AI 团队应该使用混合架构吗?
通常应该。可使用模型 API 进行探索、前沿模型、突发流量和兜底。只有在基准测试证明接受成本更低后,才将稳定的高量工作负载迁移到 GPU 云。保留 API 路径以用于溢出和模型变更。
结论
GPU 云 vs 模型 API 不是一个哲学问题,而是一个工作负载经济性决策。
当你能够让容量持续忙碌、模型稳定,并且硬件控制能带来真实优势时,选择 GPU 云;当灵活性、多提供商访问、更快的模型变化以及按请求治理比理论上的硬件节省更有价值时,选择模型 API。
最稳妥的路径是分阶段进行:先从模型 API 开始,做工作负载基准测试,只有在不利情形下盈亏平衡计算仍然成立时,才把稳定部分迁移到 GPU 云,并保留 API 路径用于兜底和未来模型变更。
如果您正在为生产级 AI 工作负载比较 GPU 云和模型 API,Flatkey 可以在 API 侧提供帮助:一个密钥、一个余额、官方模型路由、使用账本、预算和发票,而您的团队则可以验证哪些工作负载真正值得使用专用 GPU 容量。


