H100 GPU 价格:定价、成本驱动因素与购买指南
最后核查:2026 年 10 月 22 日。
H100 GPU 价格并不是一个单一数字。一张显卡的挂牌价格、一个八 GPU 云实例以及一台可投入生产的服务器,分别回答三种不同的采购问题。如果报价未明确外形规格、GPU 数量、计费模式、地点和包含的基础设施,则尚不具备可比性。
作为带日期的参考点,核查时,一个 H100 PCIe 80 GB 显卡的市场挂牌起价为32,200 美元。公开云服务示例中,H100 PCIe pod 的挂牌价格为每小时 2.89 美元,H100 SXM pod 为每小时 3.99 美元;AWS 则将单 H100 P5 Capacity Block 的价格列为每加速器小时 5.97 美元。这些仅为示例,并非建议零售价或通用费率:可用性、区域、承诺期限、CPU/RAM 套装、存储、支持服务以及确切的 H100 配置都会改变最终账单。
本指南将说明如何将 H100 报价转化为采购决策,而不是被误导性的标题价格左右。
H100 GPU 价格:快速解答
请使用与实际采购对象相匹配的计价单位:
| 您正在定价的项目 | 带日期的公开参考 | 该数字的含义与不代表的含义 |
|---|---|---|
| 一张 H100 PCIe 80 GB 显卡 | 起价32,200 美元 | 这是显卡的市场起始价格,不是 NVIDIA 建议零售价,也不是完整服务器的价格。 |
| 一个 H100 PCIe 云 pod | 2.89 美元/小时 | 这是公开的 pod 费率示例;结账时请核实云服务层级、区域、存储和 CPU/RAM 套装。 |
| 一个 H100 SXM 云 pod | 3.99 美元/小时 | 这是适用于不同外形规格及捆绑主机配置的公开 pod 费率示例。 |
| AWS P5.4xlarge Capacity Block | 5.97 美元/加速器小时 | 这是一种包含一张 H100 的计划容量产品;它并非可与单卡租赁直接一一比较的产品。 |
| Google Cloud A3 High | 8 张 H100 的价格为88.49 美元/实例小时 | 除以八后约为每 GPU 小时 11.06 美元,但该 SKU 包含的是一台大型八 GPU 机器,而非八张独立显卡。 |
硬件挂牌价格来自 GPU Vendors 的 H100 PCIe 80 GB 市场页面。pod 费率来自 Runpod 的公开定价页面,该页面于 2026 年 10 月 8 日更新。AWS 数字来自 面向 ML 的 EC2 Capacity Blocks 价格表;Google 示例来自 加速器优化型 VM 定价表。在审批或采购前,请重新核查每个来源。
实用结论是:使用H100 GPU 价格筛选候选方案,但应通过工作负载预算作出决策。
首先,确定报价对应的是哪一种 H100
“H100”这一标签掩盖了会实质影响能力和成本的决策因素。
| 配置 | 比较价格前应核实的内容 | 它为何会改变决策 |
|---|---|---|
| H100 PCIe | 80 GB 显存、主机 CPU/RAM、机箱气流、GPU 数量、网络 | 它可能是合理的单 GPU 或较小规模选择,但主机和网络成本仍应计入总成本。 |
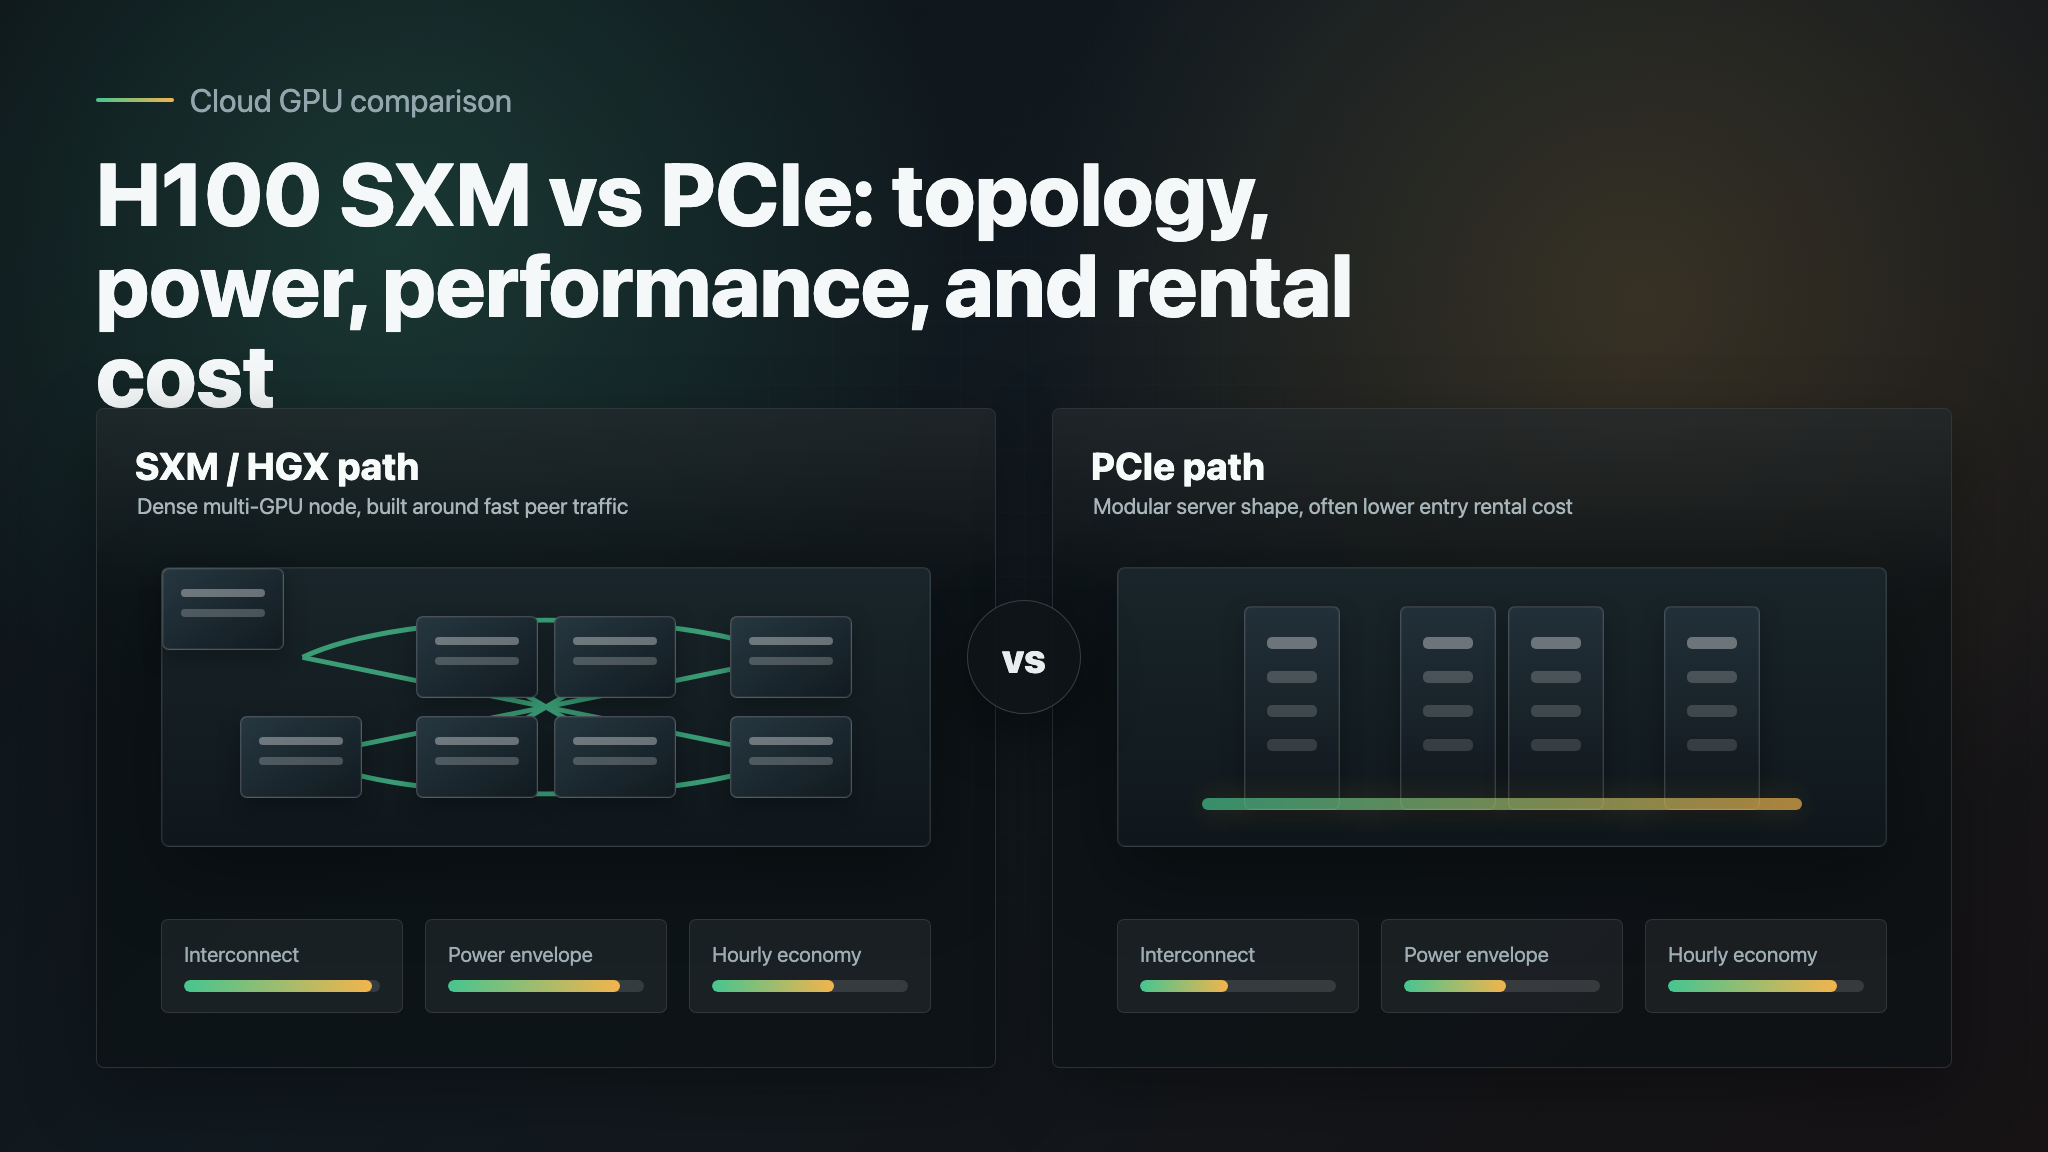
| H100 SXM | 80 GB 显存、HGX/DGX 风格平台、互连拓扑、电力与散热 | SXM 与高密度服务器平台及多 GPU 互连更紧密相关;不要仅将其等效显卡价格与 PCIe 进行比较。 |
| H100 NVL | 确切的板卡/配对/服务器 SKU、可用显存、互连、包含的主机 | 市场标签各不相同。请确认一个可计费“GPU”的构成,以及挂牌的是显卡、配对还是服务器配置。 |
| 4 或 8 GPU 节点 | GPU 数量、NVLink/NVSwitch 拓扑、NIC、本地存储、预留条款 | 对于分布式训练,节点往往才是实际采购单位,而不是单个加速器。 |
NVIDIA 的 H100 数据表显示,SXM 和 PCIe 版本均配备 80 GB 显存,但其内存带宽、功耗范围、互连和服务器选项不同。该数据表规定,SXM 版本的带宽为 3 TB/s、功耗最高可达 700 W,而 PCIe 版本为 2 TB/s 和 350 W;因此,H100 GPU 价格应始终在同一报价行中包含外形规格和平台。请结合报价阅读 NVIDIA H100 数据表,而不要将“80 GB H100”视为完整规格。
如需更深入了解架构和部署流程,请参阅我们的 NVIDIA H100 GPU 指南。如果实际是在不同代际之间进行选择,请先在 H100 与 A100或H200 GPU 价格指南中比较工作负载和合格输出成本,再将较低的小时费率视为优势。
为何相同的 H100 GPU 价格会导致截然不同的月度账单
小时费率只是加速器这一项。可用的月度方案需要涵盖完整的交付路径:
云工作负载成本
= 加速器或实例费率 × 已调度小时数
+ 附加存储
+ 数据传输 / 出站流量
+ 未包含在费率中的 CPU、RAM 和网络
+ 支持、平台和软件费用
+ 空闲时间、重试和失败作业预留
Google Cloud 在其GPU 定价文档中明确区分了 GPU、机器类型、存储和网络方面的考量。这提醒我们,不要简单地将 GPU 费率乘以 730,然后把结果称为生产预算。
例如,按上述两个公开 pod 费率参考计算,730 个预订小时中,$2.89/小时 PCIe 示例的月成本约为 $2,110,而 $3.99/小时 SXM 示例的月成本约为 $2,913,尚未包含所示 pod 配置之外的任何成本。这些数字仅为预算示例,并非报价。
H100 GPU 价格也会随计费模式而变化:
- 按需适合短期开发、评估和利用率不确定的场景。您需要为灵活性付费。
- 竞价或可中断容量可以降低标价费率,但训练作业需要具备检查点和重启逻辑。如果一次中断损失一天的工作,低价格也并不便宜。
- 预留容量或容量块以灵活性换取有时间限制的供给承诺。AWS 的 P5 表就是一个示例:它应被视为计划容量采购来比较,而不只是 GPU 小时。
- 专用或合约云容量可能具有与自助式 pod 不同的支持、可用性或网络配置。应比较合同范围,而不仅仅是 GPU 型号。
我们的GPU 租赁价格指南更详细地说明了按需、竞价和预留之间的区别。对于原型验证通过后往往才会出现的费用项目,请使用GPU 云隐藏成本指南作为审批前检查清单。
购买 H100:计算全包 TCO,而非显卡价格
对于长期、可预测的工作负载,购买可能是合理选择——但显卡挂牌信息只是开始。请使用以下所有权模型:
每月自有容量成本
= (全包购置成本 − 预期残值)÷ 折旧月数
+ 电力和散热
+ 机架或托管
+ 网络和存储
+ 保修、备件和支持
+ 平台运维和待命时间
+ 停机 / 利用率储备
全包购置成本应包含确切的加速器配置、兼容的服务器或 HGX 平台、CPU、内存、NIC、存储、配电、运输、税费、安装和支持。对于 SXM 系统,仅索取显卡报价尤其容易遗漏使该配置能够部署的组件。
以下是正确解读 $32,200 PCIe 参考价格的方式:
- 这是单卡市场起始价格,并非适用于您组织的经验证采购价格。
- 相对于 $2.89/小时的租赁示例,$32,200 约等于 11,142 GPU 小时,即按每月 730 个预订小时计算约为 15.3 个月。
- 这一计算并非购买建议。它不包括服务器、电力、散热、网络、支持、融资和利用率风险。在 50% 利用率下,消耗这 11,142 小时所需的日历时间会翻倍。
这就是为什么看似有利的H100 GPU 价格在实际盈亏平衡评估中往往无法成立。请先计算已完成并被接受工作的成本,而不仅仅是已分配加速器小时的成本。
可复制的 H100 采购工作表
在您索取报价或批准云承诺之前,请使用此表。
| 问题 | 记录内容 | 为何重要 |
|---|---|---|
| 确切的 SKU 是什么? | PCIe、SXM、NVL;内存;GPU 数量;全新/翻新状态 | 防止将显卡/服务器/配对比较伪装成价格比较。 |
| 工作负载需要什么? | 峰值 VRAM、GPU 数量、互连、吞吐量/延迟目标、持久化 | 避免较低的H100 GPU 价格将您引向无法使用的配置。 |
| 它的繁忙程度会如何? | 每月已调度 GPU 小时数和预期利用率 | 决定灵活性还是自有容量是否有机会胜出。 |
| 包含哪些内容? | vCPU、RAM、本地磁盘、持久存储、NIC、出站流量、支持、SLA | 揭示未体现在加速器费率中的费用。 |
| 发生中断时会怎样? | 检查点间隔、恢复时间、重试成本、容量后备方案 | 使竞价定价能够与可靠容量进行比较。 |
| 业务指标是什么? | 已接受的作业、token、图像、训练步骤或已完成的实验 | 让您优化每个有用成果的成本,而非每小时成本。 |
| 后备方案是什么? | 备用 GPU、其他区域、托管 API 或队列策略 | 降低容量短缺和启动失败的成本。 |
报价比较清单
要求每家供应商以书面形式回答以下问题:
- 报价对应的是 PCIe 卡、SXM 模块、NVL 配置、完整服务器,还是集群容量配额?
- 其中包含多少块 H100,以及它们通过何种互连方式连接?
- 包含哪些 CPU、RAM、存储、网络、电源和支持服务项目?
- 该价格是按需、现货、预留、定时、预付,还是容量块?
- 适用哪个区域或设施,并且所请求时间段内是否确实有可用容量?
- 哪些费用不包含在报价中:存储、出站流量、许可证、部署、税费或支持服务?
- 取消、中断、更换和硬件支持政策是什么?
- 您将运行什么工作负载测试来比较每个验收结果的成本?
何时租用、预留、购买或使用 API 是更好的选择
先选择运营模式;随后就更容易评估 H100 GPU 价格。
| 情况 | 通常应先选择 | 原因 |
|---|---|---|
| 原型、微调实验或需求不确定 | 按需租用 | 可快速获取,且无需资本承诺;应监测利用率和闲置时间。 |
| 具备强检查点机制的容错批处理工作 | 现货 / 可中断容量 | 当重新启动成本较低且已为容量损失做好规划时,可能更具经济性。 |
| 有严格截止日期的可预测训练窗口 | 预留容量或容量块 | 您支付的不仅是计算资源,还包括时间和可用性保障。 |
| 持续高利用率,并拥有经验丰富的平台团队 | 在完成全包 TCO 模型后购买或托管 | 只有在设施、支持和利用率均能得到合理保障后,自建所有权模式才可能可行。 |
| 产品使用场景不要求运行自定义权重 | 模型 API 基准方案 | 在采购硬件之前先与 API 路径进行比较;运营边界的重要性可能高于 H100 GPU 价格。 |
如果最终选择是在自托管推理和托管模型接口之间,请使用我们的 GPU 云与模型 API 指南 来构建比较框架。统一 AI API 也可以让您在决定采用硬件采购路径之前,更轻松地跨模型测试托管基准方案。
常见 H100 价格问题
购买一块 H100 GPU 需要多少钱?
没有可作为采购依据的通用公开 H100 建议零售价。H100 GPU 价格取决于外形规格、卖方、支持服务、采购量、地点,以及报价针对的是单卡还是完整系统。在本指南截至 2026 年 10 月 22 日的快照中,一个市场平台将 H100 PCIe 80 GB 卡的起售价列为 32,200 美元。请将其视为带日期的参考信息,然后向供应商索取逐项报价。
每小时租用一块 H100 的成本是多少?
公开费率会因提供商和产品而存在很大差异。Runpod 在其定价页面中将 H100 PCIe 标为 2.89 美元/小时,将 H100 SXM 标为 3.99 美元/小时;AWS 则将其单 H100 P5.4xlarge Capacity Block 标为每加速器小时 5.97 美元。每种方案包含的交付模式不同,因此不要仅凭数字进行排序。
H100 SXM 是否比 H100 PCIe 更贵?
它通常出现在成本更高的平台中,因为硬件、电力、散热和互连网络要求不同。请比较确切的主机配置和已完成工作结果。关键问题在于,SXM 平台是否能充分提升您的工作负载表现,从而降低每个验收任务的成本,而不是其 H100 GPU 价格在电子表格中是否更低。
何时购买优于租用?
只有当您在实际利用率下的全包自有容量成本低于可比云方案时才是如此。应包括服务器、网络、电力、散热、支持服务、停机准备金以及运营平台的成本。仅按单卡计算的盈亏平衡点只是筛选工具,而非决策依据。
让下一份 H100 报价具有可比性
只有当 H100 GPU 价格 与精确的配置和工作负载相关联时才有意义。先确定 GPU 外形规格,统一时间单位,加入每项基础设施成本,并计算每个已完成结果的成本。然后比较灵活性、容量风险和运营负担,而不仅仅是单卡价格或每小时费率。
在做出承诺前,请在两三个可行选项上运行一项具有代表性的工作负载。与日后发现最低 H100 GPU 价格对应了错误的外形规格、不完整的服务器预算,或您的工作负载实际上无法使用的云 SKU 相比,这项小型测试通常成本更低。