
flatkey.ai 博客
面向 AI API 产品团队的洞察、产品更新和实施指南。
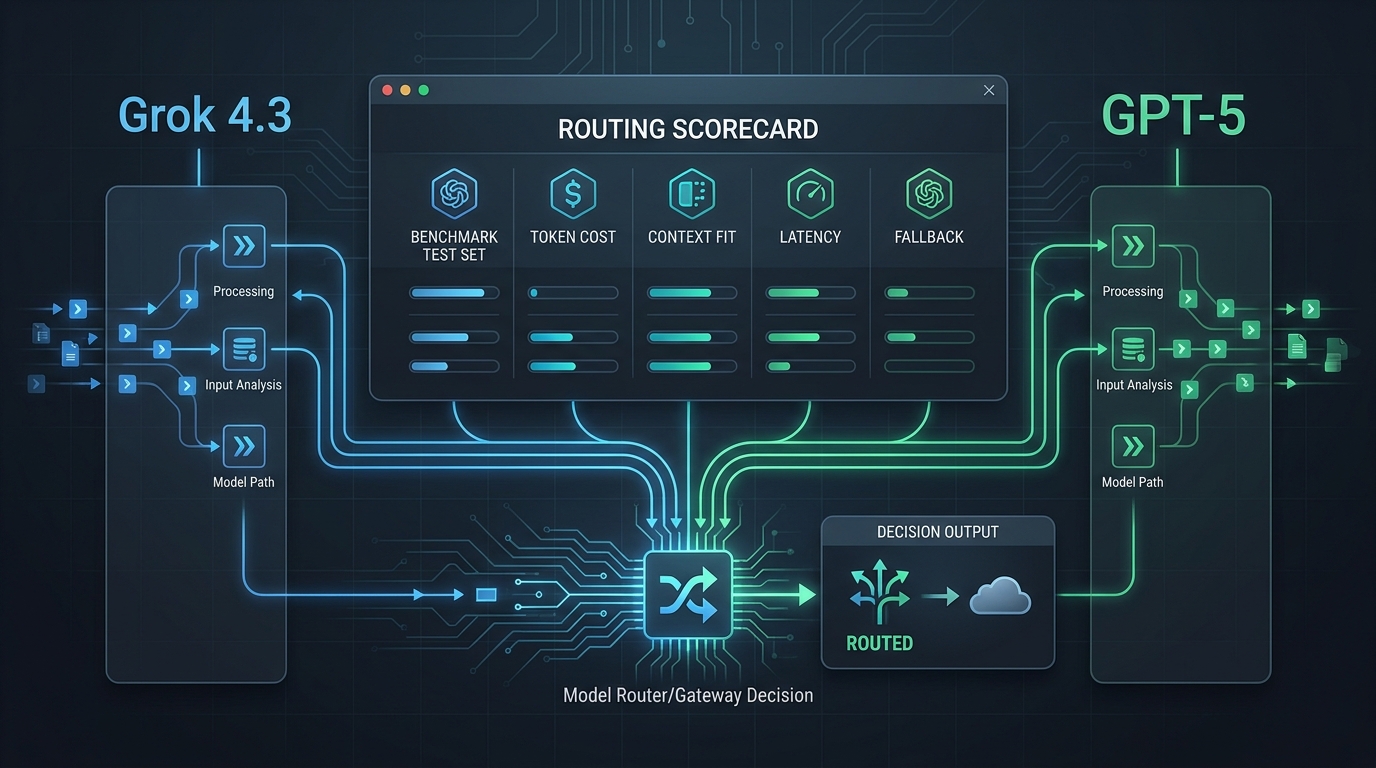
Grok 4.3 与 GPT-5:基准测试、定价及路由选择
为团队提供一份有来源支撑的路由指南,对比 Grok 4.3 和 GPT-5 的定价、上下文、基准测试设计、迁移时机,以及何时应使用网关。

租用 GPU 服务器:架构、性能与云端部署指南
了解如何在承诺容量之前,通过合适的资源分配、拓扑检查、部署阶段与验收测试来租用 GPU 服务器。
GPU 服务器机架:架构、性能与云部署指南
一份实用指南,帮助您为 AI 工作负载规划、验证并部署机架级 GPU 算力。

PII 脱敏 API 指南(2026):面向 LLM 应用的 AWS、Google Cloud、Azure 与 Presidio 对比
PII 脱敏 API 可识别并遮盖文本中的个人数据。本文对比 Amazon Comprehend、Google Sensitive Data Protection、Azure Language PII 和 Presidio,提供代码、计费单位、实际检测结果及 LLM 脱敏处理流程。
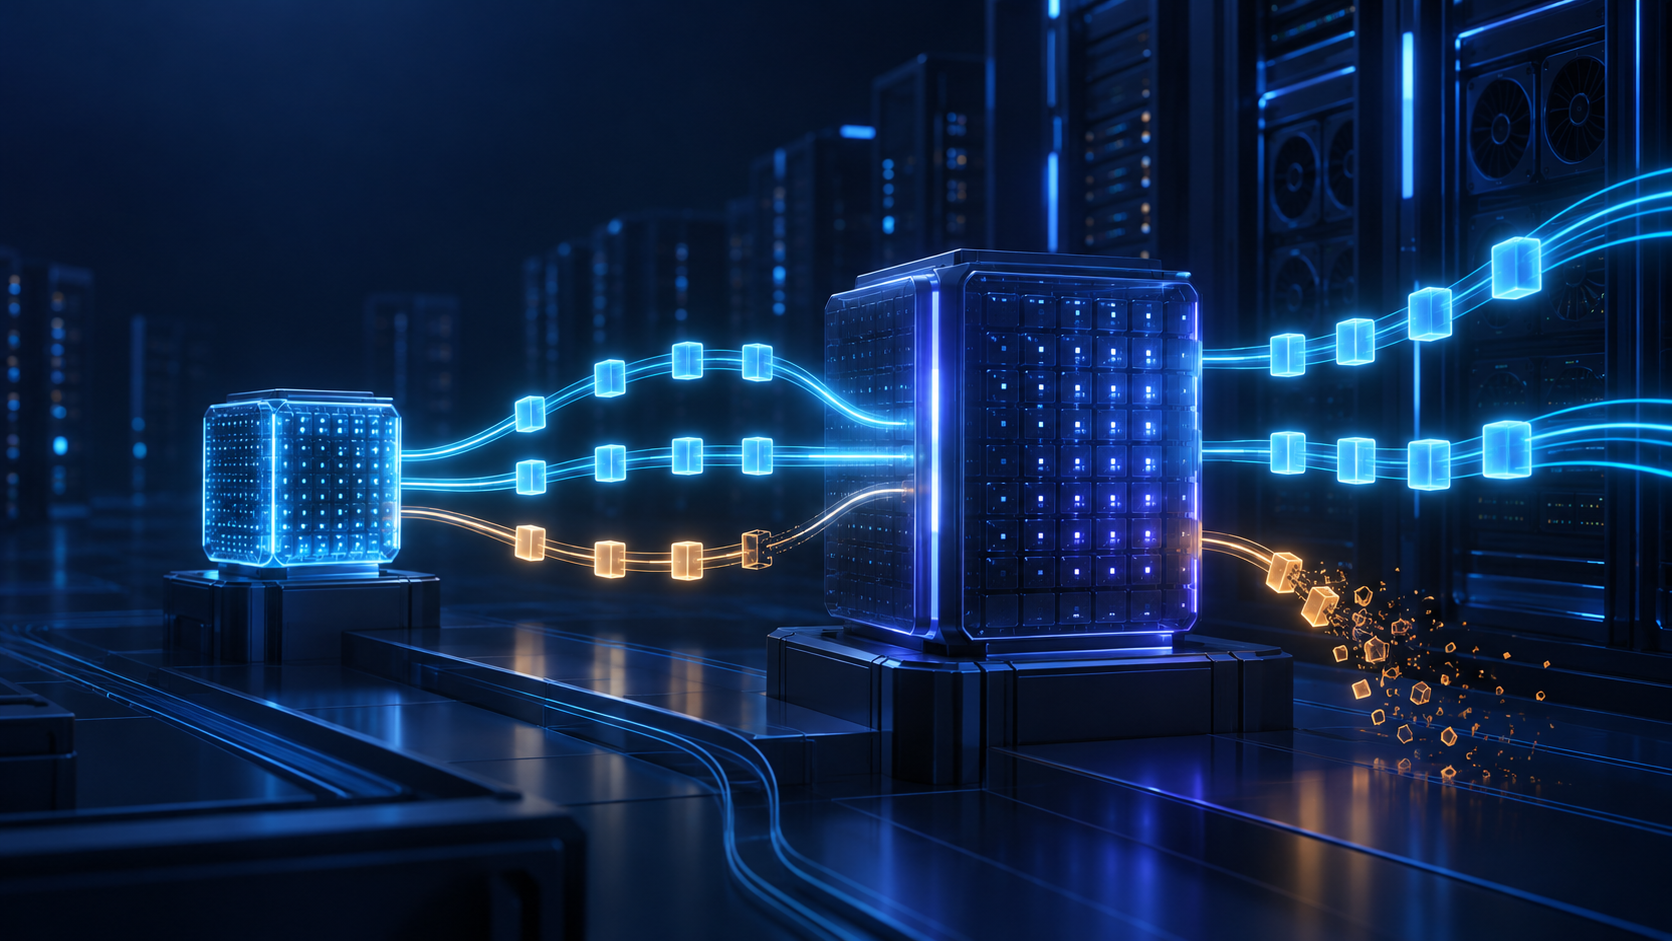
用于 LLM 推理的推测解码:吞吐量提升与权衡
一份关于 LLM 推理中推测解码的实用指南:其工作原理、何时有效、EAGLE 与 Medusa 的差异,以及上线前应进行的基准测试。

AI 推理与训练:性能、成本与部署权衡
解析 AI 推理与训练:比较性能指标、成本驱动因素、部署要求,以及何时微调或提供模型服务。

什么是 LLM 路由?规则、权重与成本感知策略详解
什么是 LLM 路由?了解规则、加权评分、能力筛选、回退机制和评估如何提升多模型 API 的可靠性。

面向 DeepSeek 及其他 MoE 模型的 vLLM 专家并行部署
通过正确的参数、拓扑、后端检查和上线测试,为 DeepSeek 及其他 MoE 模型部署 vLLM 专家并行。

vLLM Docker:架构、性能与云端部署指南
面向云 GPU 的 vLLM Docker 部署指南:涵盖架构、兼容 OpenAI 的配置、性能调优、多 GPU 扩展及生产环境检查。

AI 模型统一 API:一个密钥、端点与计费
实用的统一 API 指南:整合模型访问、密钥、端点、用量、计费、路由和故障切换,同时保留提供商原生选项。
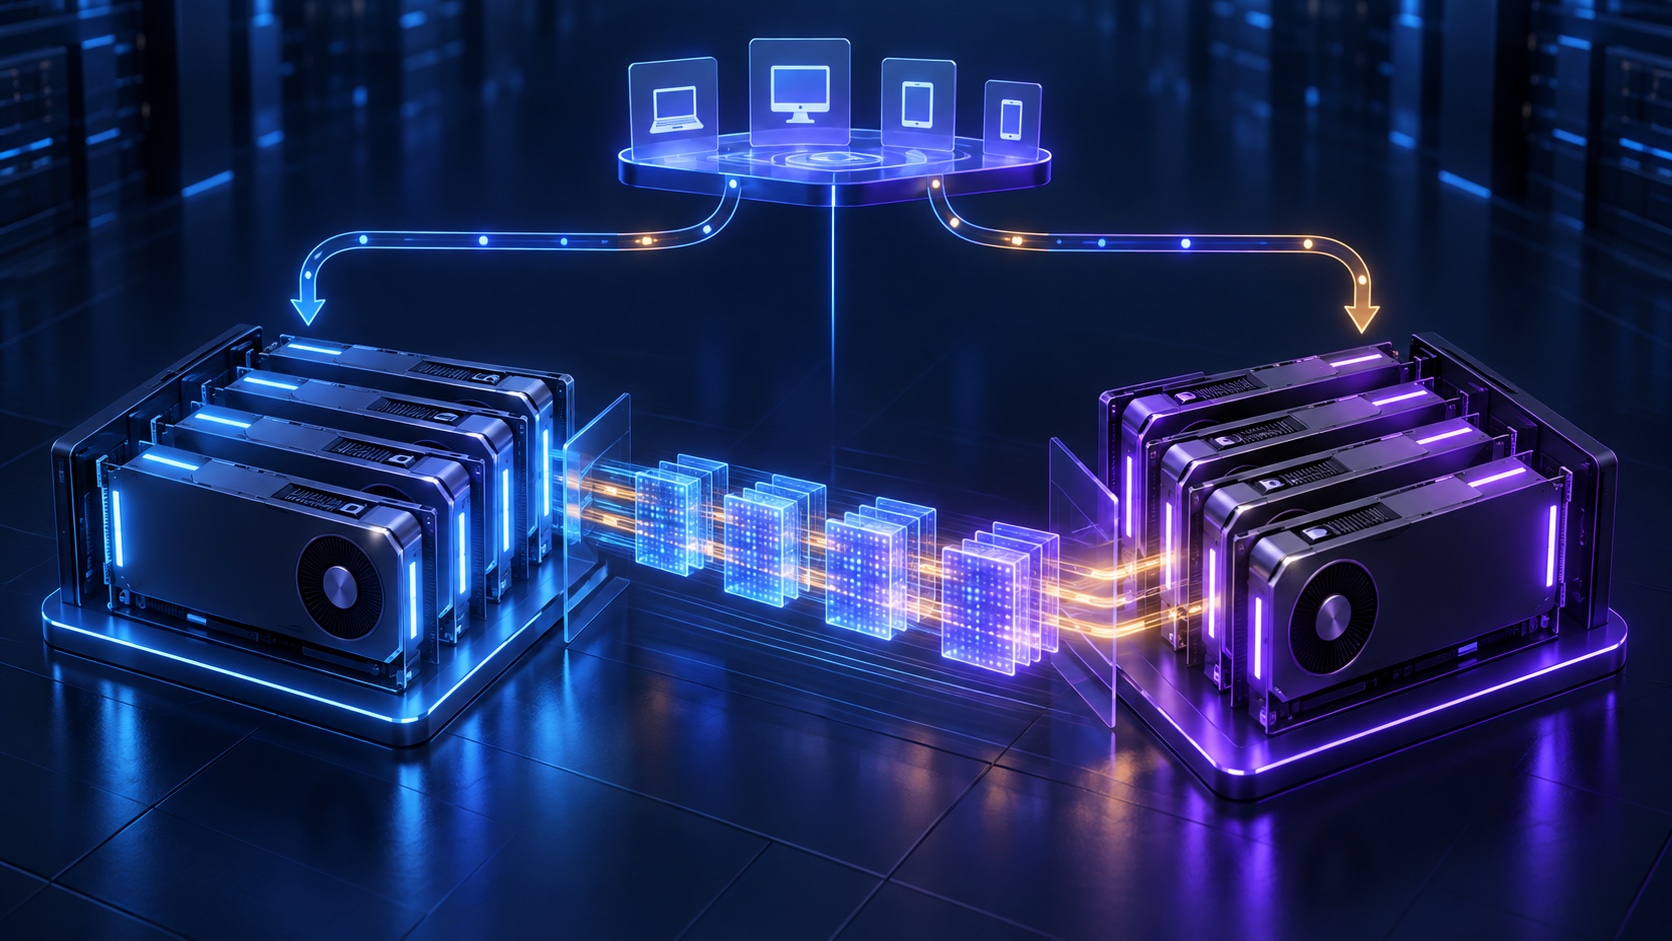
SGLang 预填充与解码分离:架构与部署指南
通过独立 GPU 资源池、KV 缓存传输、验证指标、拓扑选择和上线检查,部署 SGLang 预填充与解码分离。

架构笔记

自托管 LLM 每百万 Token 成本:可复现的 GPU 成本模型
基于完全计入的 GPU 容量、有效吞吐量、利用率和质量,计算自托管 LLM 服务成本的可复现模型。

Perplexity AI API:访问、定价、集成与生产指南
一份基于来源的指南,帮助您选择合适的 Perplexity API 接口、正确集成、预估成本,并在生产环境中安全运行。

OpenAI API 基础 URL(2026):直连与兼容端点
官方 OpenAI API 基础 URL、常见端点路径、兼容 Flatkey 的配置、代码示例,以及重复 /v1 或 404 错误的解决方法。

2026 年 OpenAI API 成本:定价表与计算器
最新 OpenAI API 成本指南,涵盖 GPT-6 定价表、可复制计算器、示例、隐藏费用及优化检查。

如何获取 OpenAI API 密钥并修复 401“无效 API 密钥”错误
安全排查 OpenAI 401 无效 API 密钥错误,包括端点错误、过期密钥、已撤销密钥、项目控制和 IP 允许列表。
OpenAI API 密钥免费吗?限额、成本与生产环境权衡
OpenAI API 密钥是一种凭证,并不等于拥有免费的生产环境预算。上线前,了解如何核实资格、额度、限制、成本和支出控制。
用一个 AI 网关更快上线。
使用 flatkey.ai 在一个 API 平台中管理模型、密钥、计费和可观测性。
开始使用