Grok 4.3 vs GPT-5:基准测试、定价,以及各自何时路由 是 2026 年 9 月的一个旧模型路由问题。OpenAI 的当前文档将 GPT-5 描述为较早的推理模型,并建议在新工作中使用 GPT-6 Astra。xAI 的发行说明现在将 Grok 4.7 列为当前的前沿 Grok 路由。不过,许多团队仍然需要比较 Grok 4.3 和 GPT-5,因为旧版代理、仪表盘、基准测试和采购说明都是围绕这些名称构建的。
简短答案:当工作负载受益于更低的标称输出价格、更大的文档上下文窗口以及 xAI 兼容的推理控制时,优先使用 Grok 4.3。当你的应用依赖 OpenAI 原生 Responses API 行为、托管工具、提示缓存、Chat Completions 兼容性或现有的 OpenAI 评测基线时,优先使用 GPT-5。当真正的问题不仅是模型质量,而是如何在不把密钥、发票、日志和回退代码分散到每个服务中的情况下切换模型时,就使用路由器。
不要仅凭公开的基准标签来做这个决定。先在你的工作负载上比较这些模型,然后按每个可接受输出的成本进行路由。
快速比较:Grok 4.3 vs GPT-5
| 决策领域 | Grok 4.3 | GPT-5 | 路由说明 |
|---|---|---|---|
| 新旧状态 | 较早的 Grok 路由;xAI 发行说明现在突出显示 Grok 4.7 为当前版本。 | OpenAI 文档将 GPT-5 称为较早的模型,并推荐 GPT-6 Astra。 | 除非你的产品明确需要它们,否则应将两者视为固定的旧路由。 |
| 模型 ID | grok-4.3,别名 grok-4.3-latest。 | gpt-5,默认快照 gpt-5-2025-08-07。 | 请固定确切的模型 ID 或快照,以便进行可重复的测试。 |
| 输入和输出 | 文本和图像输入;文本输出。 | 文本和图像输入;文本输出。 | 两者都适合视觉辅助的文本工作流;都不是视频路由。 |
| 上下文 | xAI 列出 100 万上下文窗口,在 20 万以上提示词 token 时适用长上下文定价。 | OpenAI 列出 40 万上下文窗口、27.2 万最大输入 token 和 12.8 万最大输出 token。 | 测试可用上下文,而不只是标题中的上下文数字。 |
| 标称文本价格 | 在 20 万以下提示词 token 时,每 100 万 token 为 $1.25 / $0.20 缓存 / $2.50 输出;在 20 万以上提示词 token 时为 $2.50 / $0.40 / $5.00。 | 每 100 万 token 为 $1.25 / $0.125 缓存 / $10 输出。 | Grok 4.3 的标称输出价格更低;GPT-5 的缓存输入更便宜。 |
| 批处理 | xAI 将 Grok 4.3 标记为支持批处理,并提供 20% 的批处理折扣。 | OpenAI 将 GPT-5 Batch 标记为受支持。 | 只有在可以接受延迟响应时,批处理才有帮助。 |
| 工具支持 | xAI 文档列出函数调用、结构化输出、推理以及推理强度选项。 | OpenAI 文档列出流式传输、结构化输出、函数调用、文件搜索、图像输入、网页搜索、提示缓存以及受支持的 Responses API 工具。 | 当需求包含 OpenAI 托管工具时,GPT-5 通常更强。 |
这就是 Grok 4.3 vs GPT-5:基准测试、定价,以及各自何时路由 的实用基准起点。公开规格表明成本和上下文形态不同,但生产环境中的胜出者,是在最低可接受输出成本下通过你校验器的路由。
基准测试应针对路由,而不是模型名称
公开的模型排行榜有助于发现候选项,但它们很少回答生产环境问题。一个基准分数并不能告诉你,某条路由是否能保持你精确的 schema,是否能从速率限制中恢复,是否能把用量记录到正确位置,或者在重试后是否仍能控制在预算内。
在迁移流量之前,先构建一个小型基准包:
| 基准测试轨道 | 测试内容 | 为何会改变路由 |
|---|---|---|
| 推理与编码 | 来自 agent、编码、分析或支持工作流的 50-200 个真实提示。 | 通用基准的胜利未必能迁移到你的提示形态。 |
| 结构化输出 | 必需的 JSON schema、枚举字段、嵌套对象以及无效输入场景。 | 会写更好文案的模型,仍可能在解析器前失败。 |
| 工具调用 | 必需工具、无工具、错误工具以及工具错误场景。 | 一次错误操作的成本可能高于更高的 token 单价。 |
| 长上下文 | p50、p90 和最坏情况检索包。 | 大的上下文窗口并不等于可靠的记忆回收。 |
| 成本 | 输入 tokens、缓存 tokens、输出 tokens、批处理模式、重试和被拒绝的输出。 | 仅看列出的 token 价格是不完整的,因为还缺少接受率。 |
| 延迟 | 首个 token 时间、完整响应延迟、超时率和排队行为。 | 面向用户的 agent 可能需要更快的路由,即使它更贵。 |
| 回退 | 提供商错误、429、未找到模型、schema 失败、超时和降级输出。 | 没有回滚规则的路由并不适合生产环境。 |
路由指标应为:
cost_per_accepted_output =
  (input_cost + cached_input_cost + output_cost + tool_cost + retry_cost + fallback_cost)
  / accepted_outputs
当 Grok 4.3 在足够的质量和延迟余量下赢得这个公式时,就使用它。若 OpenAI 原生行为足以降低实现风险、验证失败或集成成本,并抵消其列出的输出价格,就使用 GPT-5。
定价:Grok 4.3 哪些地方更便宜,以及 GPT-5 何时仍能胜出
对于短上下文文本请求,xAI 将 Grok 4.3 的价格列为每 100 万 token 输入 $1.25、缓存输入 $0.20、输出 $2.50。对于 20 万及以上的提示 token,xAI 列出更高的长上下文定价:每 100 万 token 输入 $2.50、缓存输入 $0.40、输出 $5.00。xAI 还将 Grok 4.3 标记为支持批处理,并提供 20% 的批量折扣。
OpenAI 将 GPT-5 的价格列为每 100 万 token 输入 $1.25、缓存输入 $0.125、输出 $10。这使得 GPT-5 在列出的输出 token 上更贵,但在缓存输入上比 Grok 4.3 的短上下文缓存输入价格更便宜。
价格决策会随着工作负载形态而变化:
| 工作负载形态 | 价格压力 | 最可能的首测 |
|---|---|---|
| 短提示,长生成回答 | 输出价格占主导。 | 先测试 Grok 4.3,再比较输出接受率。 |
| 重复的大型系统提示或策略包 | 缓存输入很重要。 | 两者都测;如果缓存命中率很高,GPT-5 的缓存输入可能很关键。 |
| 超过 200k 提示词 token 的长检索包 | 适用长上下文定价。 | 测试 Grok 4.3,并将长上下文价格和延迟纳入考虑。 |
| OpenAI 托管工具或 Responses API 工作流 | 工具和集成行为很重要。 | 先测试 GPT-5,因为直接的功能支持可能降低应用复杂度。 |
| 离线评估或回填 | 批处理经济性很重要。 | 如果可以接受延迟完成,则测试两条批处理路径。 |
如果你只比较列出的输入价格,Grok 4.3 vs GPT-5:基准测试、定价,以及各自何时路由 就会变成一场误导性的电子表格练习。输出长度、重试率、工具失败和人工复核都可能抵消表面上的节省。
何时路由到 Grok 4.3
当工作负载对成本敏感、输出量大且不依赖 OpenAI 原生工具时,先从 Grok 4.3 开始。
适合的候选场景包括:
- 内部分析任务,其中文本输出很长且验证很直接。
- 长上下文摘要任务,其中 1M 的已文档化上下文窗口很有用,而且长上下文价格仍优于替代方案。
- 评估作业,其中可接受批处理,并且适用 20% 的批处理折扣。
- 使用函数调用或结构化输出,但不需要 OpenAI 托管工具的工作流。
- 模型实验,你希望使用 Grok 系列路由,与 GPT、Claude、Gemini、DeepSeek 或 Qwen 进行对比。
上线前,请在提供商控制台或网关目录中核实准确的 Grok 路由。xAI 有更新的 Grok 路由,而 Flatkey 当前的本地知识确认的是 grok-4.2 而不是 grok-4.3,因此在实时目录明确显示之前,不要假设通过网关可以使用 Grok 4.3。
何时路由到 GPT-5
当工作负载依赖 OpenAI 的 API 表面,或者你的评估历史已经将 GPT-5 作为基线时,先从 GPT-5 开始。
适合的候选场景包括:
- 现有的 OpenAI Chat Completions 或 Responses API 应用,不应为了模型实验而重写。
- 使用 OpenAI 托管工具的工作负载,例如通过 Responses API 使用网页搜索、文件搜索、图像生成、代码解释器或 MCP。
- 依赖 OpenAI 提示缓存、结构化输出、流式传输或 OpenAI 特定项目控制的产品。
- 回归测试,其中先前的 GPT-5 快照是验收基线的一部分。
- 迁移审计,其中 GPT-5 是迁移到更新模型之前的稳定参考路由。
需要注意的是新鲜度。OpenAI 当前文档将 GPT-5 称为上一代模型。如果你正在启动新项目,也应比较当前 OpenAI 推荐的模型。当问题是一个固定的旧版路由时,GPT-5 仍然值得测试,但在没有当前模型审查的情况下,不应将其视为新项目的默认答案。
何时路由器是更好的答案
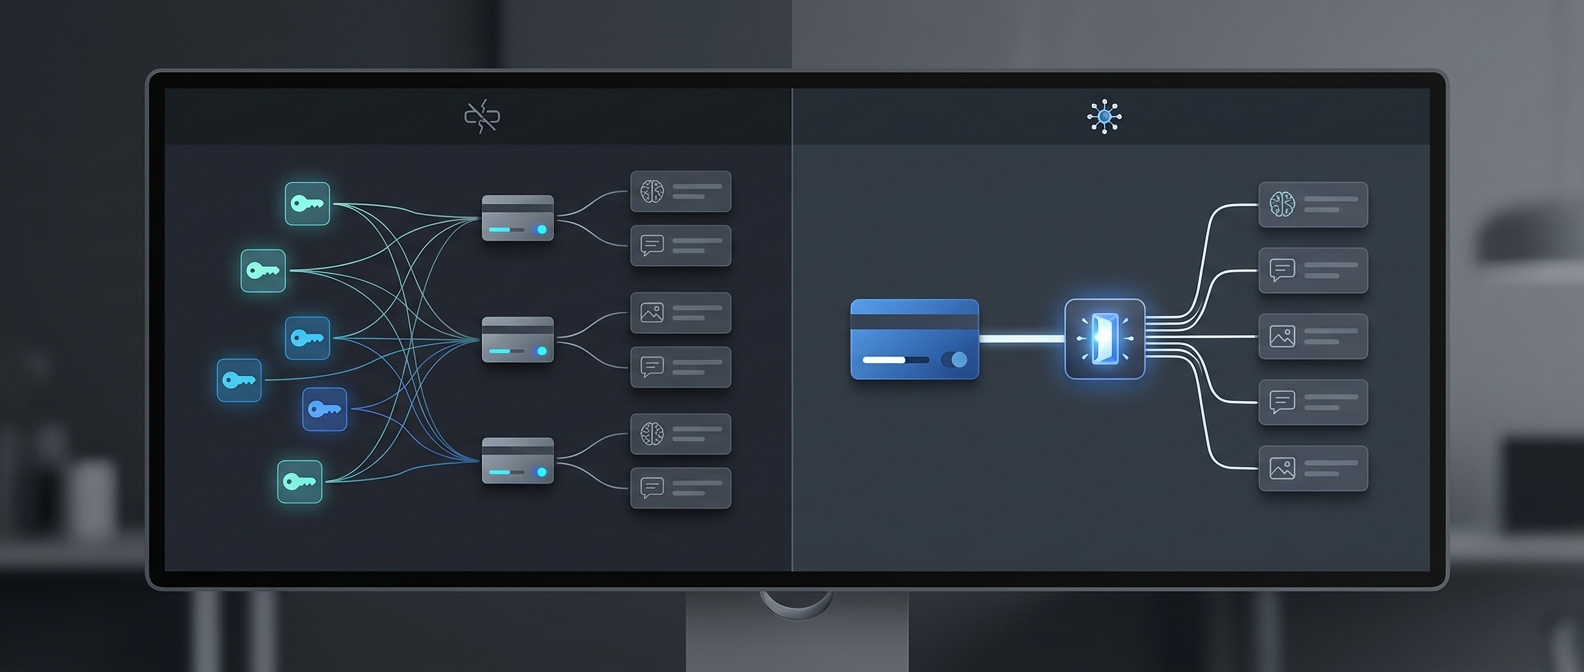
团队常常会问 Grok 4.3 还是 GPT-5 更好,但真正的瓶颈其实是运维层面的蔓延:
- 分开的提供商密钥。
- 分开的仪表盘和发票。
- 分开的限流策略。
- 分开的状态检查。
- 分开的用量导出。
- 在各个 agent 和服务中硬编码了不同的模型 ID。
- 当某个提供商性能下降时,没有共享的回退规则。
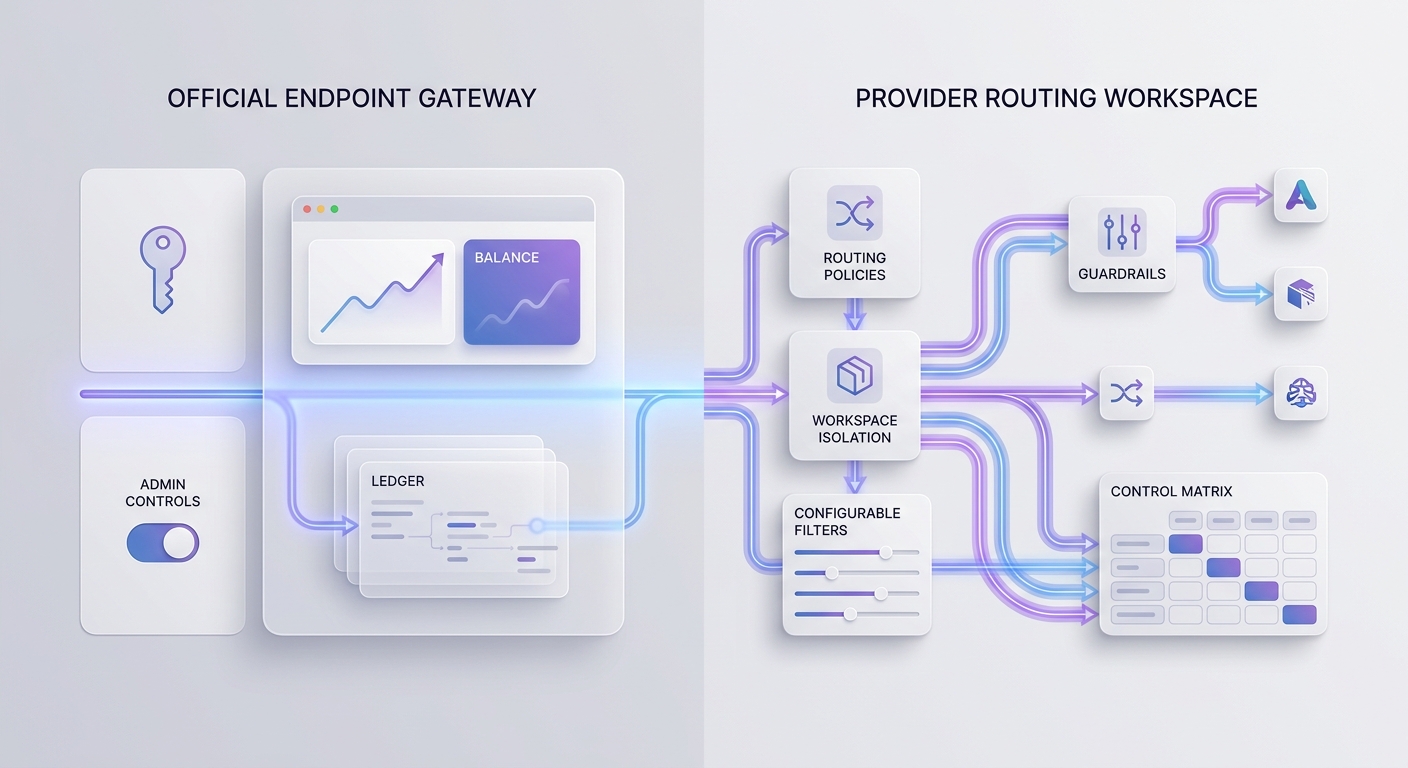
Flatkey 的定位就是为这一层而生:一个 key、一个余额、一个发票、官方模型访问、用量日志,以及一个兼容 OpenAI 的路由器。这并不意味着每个提供商原生功能都能通过每条路径自动生效。它的意思是,团队拥有一个统一的操作平面,可以用来比较受支持的模型并查看用量证据。
在更改生产流量之前,请将本文与 AI 模型目录指南、AI 路由 API 指标框架,以及 Flatkey API 快速开始搭配阅读。
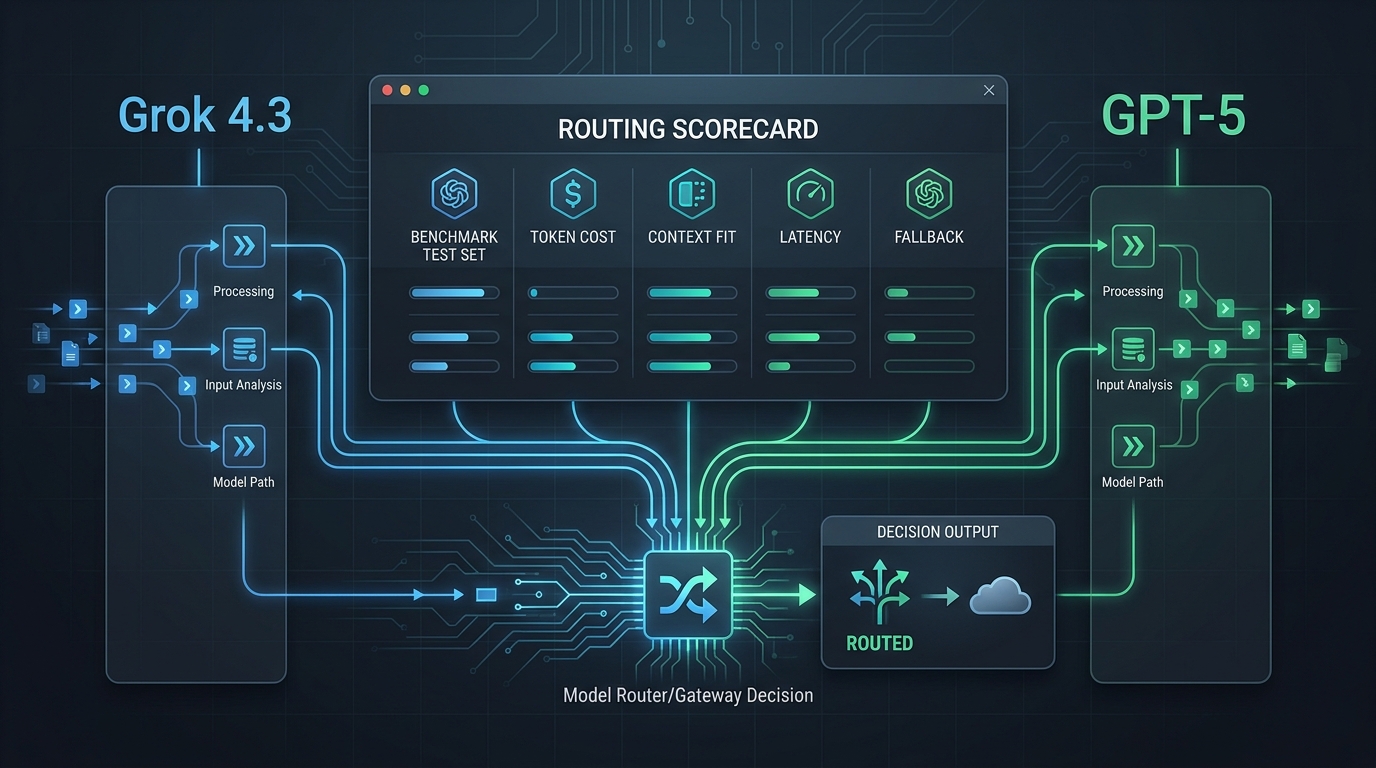
实用的路由评分表
使用这张评分表来评估 Grok 4.3 vs GPT-5:基准测试、定价,以及各自何时路由。针对同一工作负载,为每条路由从 1 到 5 打分。
| 标准 | 权重 | Grok 4.3 | GPT-5 | 备注 |
|---|---|---|---|---|
| 可接受输出率 | 25% | 答案是否通过你的验证器或审核标准? | ||
| 每个可接受输出的成本 | 20% | 包括提示词大小、输出长度、缓存、批处理、工具、重试以及被拒绝的输出。 | ||
| 工具和 schema 可靠性 | 15% | 统计无效 JSON、错误的工具调用、缺失字段和不支持的参数。 | ||
| 上下文可靠性 | 15% | 测试 p50、p90 和最坏情况下的检索包。 | ||
| 延迟和超时 | 10% | 测量 TTFT、完整完成时间和超时率。 | ||
| 可观测性 | 10% | 工程和财务是否可以检查提供商、模型、token、成本、延迟和错误? | ||
| 回退准备度 | 5% | 是否已测试并记录回滚? |
然后写一条路由记录:
route_review:
  workload: support_case_summarization
  candidates:
    - grok-4.3
    - gpt-5
  required_features:
    - structured_output
    - streaming
    - usage_readback
  launch_rule:
    minimum_score: 4
    accepted_output_rate: ">= target set by owner"
    rollback_path_required: true
  stop_conditions:
    - schema_failure_rate_above_threshold
    - timeout_rate_above_threshold
    - cost_per_accepted_output_above_budget
这条策略比排行榜截图更有用,因为它会告诉你的应用在模型不可用、太慢、太贵或不适合该任务时该怎么做。
在迁移流量之前的预检清单
在将真实用户路由到任一模型之前,请执行以下检查:
1. 确认模型可用性。 在你上线的同一天,检查直接提供商控制台以及任何网关目录。
2. 固定模型 ID。 有意使用 grok-4.3 或 gpt-5-2025-08-07;不要在未经审查的情况下依赖旧别名。
3. 验证端点家族。 确认工作负载使用的是 xAI 兼容路由、OpenAI Chat Completions、OpenAI Responses、batch 还是 gateway 端点。
4. 测试所需功能。 只有在你的工作负载确实需要时,才测试工具、结构化输出、图像输入、流式输出、缓存和 batch。
5. 测量可用上下文。 在真实的上下文大小下检查召回和引用纪律。
6. 计算已接受输出成本。 包括重试、被拒绝的输出和人工审核。
7. 记录每一条路由。 记录提供方、模型、请求 ID、输入 token、输出 token、缓存 token、延迟、状态和成本。
8. 定义回退策略。 决定何时重试、切换路由、排队、降级输出或关闭失败。
9. 分配责任。 指定某人负责密钥、预算、配额、路由健康状况和回滚。
10. 在模型变更后重新运行。 新的 Grok 或 GPT 版本可能会很快让这项比较过时。
需要保持开启的来源检查
在最终确定路由时使用实时文档:
- OpenAI GPT-5 模型文档,了解 GPT-5 的状态、快照、上下文、端点、功能和定价摘要。
- OpenAI API 定价,了解当前文本 token 价格表以及区域/快速模式注意事项。
- xAI 模型和定价,了解 Grok 4.3 的上下文、定价、batch、多模态和推理控制。
- xAI 发布说明,了解当前 Grok 模型的新鲜度。
- Artificial Analysis 模型排行榜,用于第三方模型发现指标,而不是替代你自己的路由基准测试。
结论
对于 Grok 4.3 vs GPT-5:基准测试、定价,以及各自何时路由,当输出 token 占主导且不需要 OpenAI 原生工具时,Grok 4.3 通常是第一个定价测试。若你的应用依赖 OpenAI 的 Responses API、托管工具、提示缓存或现有的 GPT-5 基线,那么 GPT-5 通常是第一个集成测试。
在生产环境中,请将这两个决策分开:先选择通过你工作负载测试的模型,再选择能为你提供日志、成本控制、回退和干净回滚路径的路由。这正是统一路由器发挥作用的地方。