
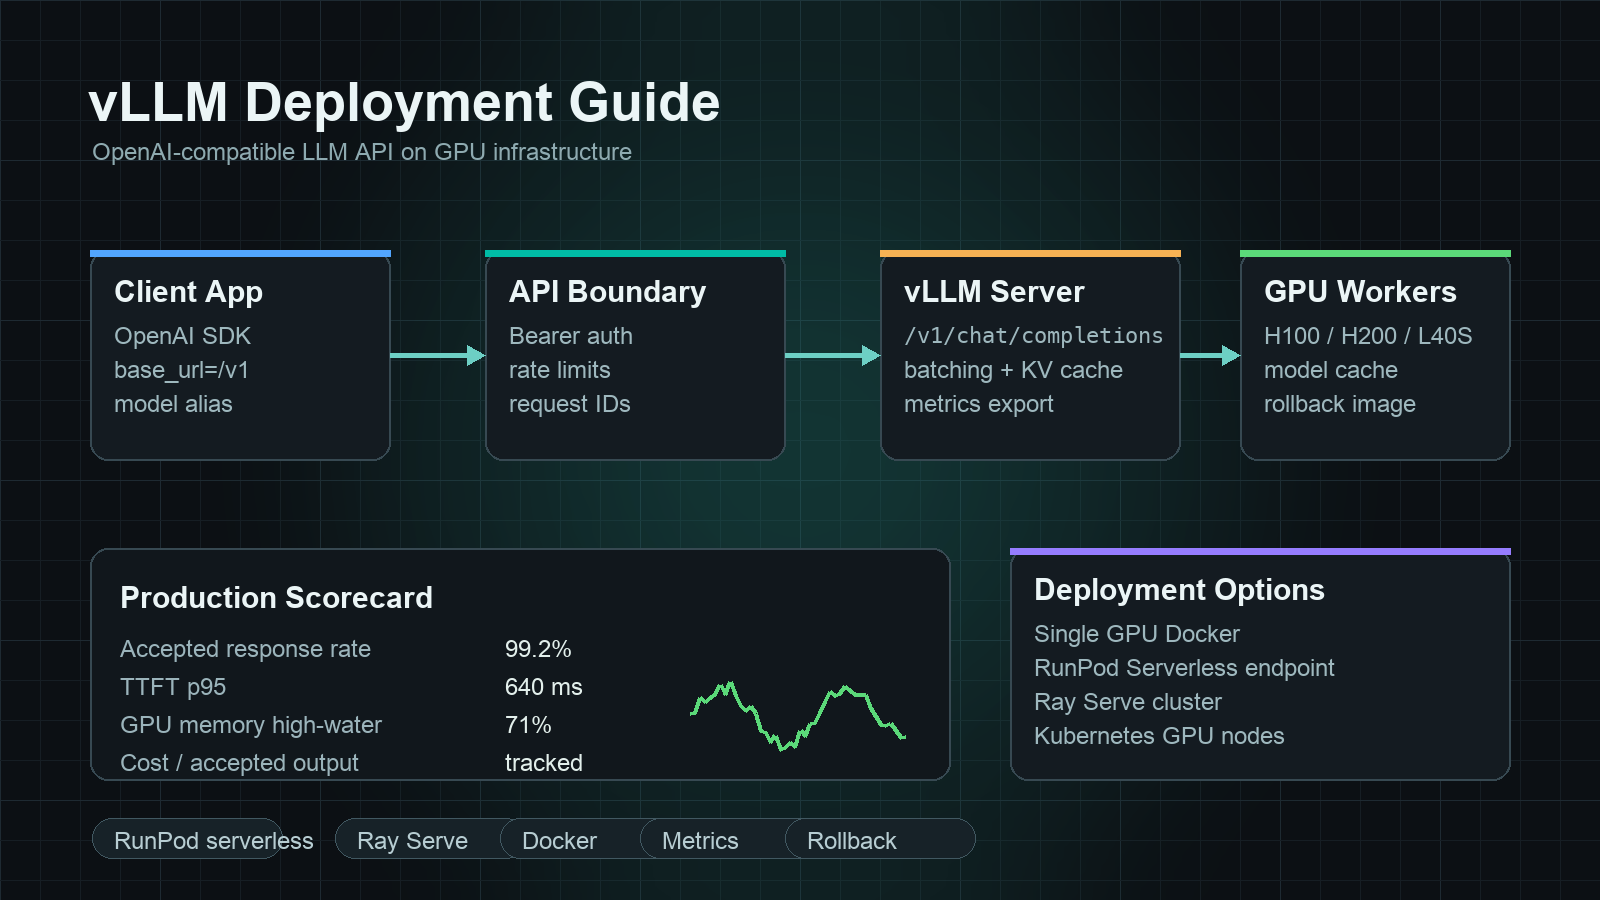
vLLM 部署指南应该回答一个实际问题:你如何把 GPU 容量转化为一个应用团队可以调用、监控、回滚,并与托管模型 API 进行对比的、兼容 OpenAI 的 LLM API?
简短的答案是:从一个模型、一种 GPU 规格、一个兼容 OpenAI 的路由,以及一份测量计划开始。vLLM 可以暴露熟悉的 /v1/models、/v1/chat/completions 以及相关的 OpenAI 风格端点,但生产部署不只是第一条 vllm serve 命令。你还需要容器镜像、模型缓存、认证边界、健康检查、指标、请求限制、负载测试,以及每个已接受输出的成本评分表。
这份vLLM 部署指南为 AI 开发者和平台团队提供了一条从单 GPU 服务器到 RunPod Serverless、Ray Serve 以及 Kubernetes 风格生产模式的部署路径。它还解释了何时像 Flatkey 这样的模型 API 或路由器,比自己管理 GPU 服务层更简单。
vLLM 快速部署指南
在增加编排复杂性之前,请先使用以下顺序。
| 步骤 | 决策 | 实用默认值 |
|---|---|---|
| 1. 选择模型 | 选择一个受支持的模型和精确版本 | 从能验证 API 契约的最小模型开始,然后再扩展 |
| 2. 选择 GPU | 在调优吞吐量之前确认显存是否匹配 | 测试和生产使用同一类 GPU |
| 3. 启动 vLLM | 暴露一个兼容 OpenAI 的 API | 先使用 vllm serve,然后再容器化 |
| 4. 锁定请求限制 | 限制上下文长度、并发数和输出大小 | 保护 GPU 不受无限制提示词影响 |
| 5. 添加认证和网络控制 | 不要直接暴露原始 GPU worker | 在前面放置网关、入口或私有端点 |
| 6. 衡量已接受输出 | 跟踪成功响应、延迟、重试和成本 | 与模型 API 的每个已接受输出成本进行比较 |
| 7. 添加发布机制 | 金丝雀发布、回滚和版本化模型别名 | 在服务变更时保持客户端代码稳定 |
目标不是让每个工作负载都自托管。目标是知道自托管 vLLM 在何种情况下值得承担运营复杂度。
vLLM 为你提供什么
vLLM 是一个用于大语言模型的开源推理和服务引擎。其文档涵盖兼容 OpenAI 的服务、Docker 部署、指标、前缀缓存、量化、投机解码、并行化以及受支持的模型架构。这些能力使得当你希望在熟悉的 API 契约后面服务开源权重模型时,vLLM 成为一个强默认选择。
它在生产中的有用特性是 API 边界。如果你的应用已经在调用兼容 OpenAI 的客户端,vLLM 端点可以减少应用重写工作。服务层可能会变,模型权重可能会变,GPU 主机也可能迁移,而客户端代码仍然只需要向同一个基础 URL 发送聊天补全请求。
这并不会消除平台工作。它只是把难点从应用集成转移到了推理运维:GPU 分配、模型加载、批处理、可观测性、速率限制、故障响应和成本管理。
单 GPU 的 vLLM 部署
在添加无服务器、Ray 或 Kubernetes 之前,先在本地或一台云 GPU 上开始。
pip install vllm

vllm serve meta-llama/Llama-3.1-8B-Instruct \
  --host 0.0.0.0 \
  --port 8000
然后测试兼容 OpenAI 的端点。
curl http://localhost:8000/v1/models
使用一个看起来与应用实际发送的请求相同的聊天请求。
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "meta-llama/Llama-3.1-8B-Instruct",
    "messages": [
      {"role": "user", "content": "Write a three-bullet deployment checklist."}
    ],
    "temperature": 0.2,
    "max_tokens": 300
  }'
第一次部署并不是生产环境。它回答四个问题:
- 模型是否能在所选 GPU 上加载?
- 你的客户端是否理解响应结构?
- 流式输出、工具调用或结构化输出是否适用于你的特定请求?
- 首个 token 的大致时间以及端到端延迟是多少?
让第一次测试尽量简单。不要在基础端点可用之前去调优批处理、量化或并行化。
用于可重复 GPU 服务器的 Docker 部署
对于可重复的服务器,请使用官方的 vLLM Docker 路径,或者在自己的仓库中使用固定版本的容器镜像。生产中的关键控制点不仅是镜像标签,还包括驱动栈、CUDA 兼容性、模型缓存、卷挂载、网络端口和进程标志。
示例形式:
docker run --gpus all \
  -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  --env HUGGING_FACE_HUB_TOKEN=$HUGGING_FACE_HUB_TOKEN \
  vllm/vllm-openai:latest \
  --model meta-llama/Llama-3.1-8B-Instruct \
  --host 0.0.0.0 \
  --port 8000
在生产中使用此模式之前,请固定以下版本:
- vLLM 镜像标签。
- NVIDIA 驱动和容器运行时。
- 如果单独管理,CUDA 栈。
- 模型修订版或提交哈希。
- 分词器和聊天模板行为。
- 如果使用的话,量化模式。
如果一份 vLLM 部署指南 只说“运行 Docker”,那它是不完整的。运行手册还需要说明重启行为、日志记录、模型缓存预热、就绪探针,以及回滚到上一版镜像和模型版本的路径。
使端点兼容 OpenAI,但不要变成未认证的
vLLM 可以提供兼容 OpenAI 的 API,但你原始的 vLLM worker 通常不应直接成为公网边界。应当在前面放置一些东西:
- 用于内部服务的私有 VPC 端点。
- 带有 bearer-token 验证的 API 网关。
- 带有 mTLS 的服务网格或入口控制器。
- 一个轻量的应用层代理,用于强制模型别名、请求 ID 和按团队预算。
- 当你需要回退到托管模型 API 时使用的路由层。
使用按环境区分的基础 URL:
VLLM_BASE_URL_DEV=http://localhost:8000/v1
VLLM_BASE_URL_STAGING=https://staging-inference.example.com/v1
VLLM_BASE_URL_PROD=https://inference.example.com/v1
然后保持应用客户端可回切:
from openai import OpenAI

client = OpenAI(
    api_key="not-used-by-raw-vllm",
    base_url="https://inference.example.com/v1",
)

response = client.chat.completions.create(
    model="llama-3-1-8b-instruct",
    messages=[{"role": "user", "content": "Summarize the deployment plan."}],
)
如果你之后将部分请求路由到 Flatkey 的 OpenAI 兼容模型 API 层,同样的客户端模式仍然很有用:只需更改基础 URL、API 密钥和模型别名,同时保持应用契约稳定。
在流量进入前需要决定的生产设置
部署标志取决于模型、GPU 和工作负载,但每个团队在生产流量到来前都应该决定这些控制项:
| 控制项 | 为什么重要 |
|---|---|
| 最大模型长度 | 防止少量长提示词占用全部 KV 缓存内存 |
| 最大输出 token 数 | 防止失控生成占用解码容量 |
| 并发限制 | 在突发流量下保护 p95 和 p99 延迟 |
| 请求超时 | 阻止卡住的请求掩盖过载 |
| 队列策略 | 决定超额需求是等待、快速失败还是回退 |
| 模型别名 | 让客户端在服务版本变化时仍可使用稳定名称 |
| 认证边界 | 防止昂贵的 GPU 端点变成开放代理 |
| 日志策略 | 在调试、数据保留和隐私要求之间取得平衡 |
| 指标导出 | 使延迟、错误、缓存行为和吞吐量可观测 |
不要照搬别的团队的参数。照搬他们的测量方法。
vLLM 生产部署的指标
在三个层面跟踪指标。
| 层级 | 要跟踪的指标 |
|---|---|
| API 层 | 请求数、成功响应率、4xx/5xx 比率、超时率、重试率 |
| 服务层 | 首 token 时间、token 间延迟、端到端延迟、队列等待时间、每秒 token 数 |
| GPU 层 | GPU 利用率、内存利用率、OOM 事件、模型加载时间、重启次数 |
然后再加入财务指标:
每个已接受输出的成本 =
  (GPU 租用 + 存储 + 带宽 + 重试 + 运维人员时间)
  / 通过质量检查的已接受响应
这使 vLLM 部署指南 与生产经济性保持一致。一个更快的端点并不一定更便宜,如果它失败更频繁、需要更多人工干预,或者一天大部分时间都处于空闲状态。
如需更广泛的成本背景,可将你测得的端点与 GPU 租赁价格、LLM 推理最佳 GPU、GPU 云与模型 API 对比 以及 GPU 集群 TCO 进行比较。
RunPod 无服务器 vLLM 部署指南
RunPod 无服务器 vLLM 部署指南 的运行模式与长期运行的 GPU 虚拟机不同。你需要打包一个 handler 或容器,定义无服务器端点,然后让平台围绕请求扩缩 worker。当流量呈突发型,或者你想要一个托管的 GPU 执行面而不想管理每个 VM 生命周期细节时,这会很有用。
在以下情况下使用 RunPod Serverless:
- 你希望获得端点式 GPU 执行,而无需管理持久化主机。
- 流量足够突发,以至于常开 GPU 容量会长期闲置。
- 冷启动和模型加载行为对该工作负载是可接受的。
- 你的应用可以容忍平台的异步或端点特定请求模式。
- 你可以在上线前测试并发、排队和超时行为。
对于对延迟敏感的聊天场景,无服务器方案要谨慎。大型模型可能会有显著的冷启动和加载时间表现。应在空闲一段时间后测量首 token 延迟,而不仅仅是在温热基准测试期间测量。
对于 RunPod 无服务器端点 vLLM 部署指南,你的验收测试应包括:
| 检查项 | 重要原因 |
|---|---|
| 容器镜像拉取时间 | 大型镜像会主导冷启动时间 |
| 模型权重下载或卷挂载 | 重复下载会抵消 serverless 的节省效果 |
| 最大 worker 数量 | 防止在流量激增时出现意外支出 |
| 队列超时 | 定义用户可见的失败行为 |
| 预热 worker 策略 | 会改变延迟和空闲成本 |
| 请求和响应形状 | 确认兼容 OpenAI 的客户端可以顺利适配 |
如果你的精确搜索词是 runpod serverless endpoints vllm deployment guide,请将“endpoints”视为一个运维主题:构建 endpoint,但也要测试冷启动、worker 扩缩、请求限制和回滚。
Ray Serve vLLM 部署指南
Ray Serve vLLM 部署指南 在部署不再只是单个 worker 上的单个模型时非常有用。Ray Serve 可以帮助团队构建一个服务应用,用于组合多个部署、扩展副本,并在 Ray 集群上运行。当你需要围绕模型的 Python 级服务逻辑、自定义路由、多模型应用,或者已经标准化使用 Ray 的集群时,这一点很有价值。
在以下情况下使用 Ray Serve:
- 你已经在 ML 基础设施中运行 Ray。
- 你需要在一个 serving graph 中部署多个服务。
- 你想围绕一个或多个 vLLM 引擎进行应用级路由。
- 你需要从本地测试过渡到 Ray 集群的路径。
- 你的平台团队可以运维 Ray,而不仅仅是 vLLM。
代价是运维面更大。Ray 提供编排能力,但也增加了 Ray 集群运维、自动扩缩行为、对象存储考量、日志、仪表盘,以及另一条升级路径。对于位于单个 endpoint 后面的单个模型,直接部署 vLLM 可能更简单。
Kubernetes 部署模式
如果你的组织已经在 Kubernetes 中运维 GPU 节点、ingress、secrets、metrics 和发布策略,Kubernetes 是很合适的选择。它并不总是小团队的第一个最佳部署方案。
Kubernetes 检查清单:
| 领域 | 检查项 |
|---|---|
| GPU 调度 | 节点标签、taint、资源请求、device plugin,以及 GPU 隔离 |
| 模型存储 | 持久卷、对象存储同步,或预构建镜像策略 |
| 启动 | 模型缓存预热和真实的 readiness probe |
| 健康检查 | 不会杀死加载缓慢但健康的模型的 liveness probe |
| 发布 | 带有快速回滚的金丝雀或蓝绿部署 |
| 自动扩缩 | 按队列、延迟或 GPU 指标扩缩,而不是只看 CPU |
| 网络 | 默认仅限内部访问;仅通过认证控制开放公共 ingress |
| 可观测性 | 按路由的延迟、错误率、GPU 内存和成本归因 |
如果你的平台还没有成熟的 GPU Kubernetes 能力,先从单个 GPU 主机或托管 endpoint 开始。Kubernetes 应该降低运维风险,而不是把一个简单的 endpoint 变成一个集群项目。
vLLM deployment 的负载测试计划
不要只用一个 prompt 做负载测试。创建一个有代表性的请求集。
至少使用三类 trace:
- 短对话:短 prompt、短输出、高并发。
- 长上下文 RAG:长 prompt、中等输出、重复的 system 和检索模板。
- Agent 或 tool 循环:重复 schema、结构化输出、取消、重试和多轮上下文。
记录:
| 指标 | 目标 |
|---|---|
| 每分钟接受的请求数 | 衡量有效吞吐量 |
| 首 token 时间 p50/p95/p99 | 显示交互延迟 |
| 端到端延迟 p50/p95/p99 | 显示用户可见的任务时间 |
| 错误和超时率 | 显示负载下的可靠性 |
| 重试调整后的延迟 | 显示失败后的真实体验 |
| GPU 内存高水位 | 显示余量 |
| 每个已接受输出的成本 | 显示经济性 |
运行两个基准测试:
- 默认运行:最少调优,这样你就知道上线时间。
- 调优运行:调优后的 batching、cache、量化和请求限制,这样你就知道上限。
如果调优运行更快但不稳定,不要把它作为默认配置部署。部署你的值班团队能够解释的配置。
什么时候不应自己部署 vLLM
当你需要硬件控制、自定义权重、严格的数据本地性,或在稳定工作负载上获得高持续利用率时,自托管很有价值。当流量不确定、模型选择经常变化、需要前沿的专有模型,或者团队缺乏推理运维能力时,它的吸引力就会降低。
在以下情况下,优先选择托管模型 API 或 router:
- 你仍在测试模型质量。
- 你需要频繁切换模型。
- 流量波动大或难以预测。
- 跨供应商的 fallback 比 GPU 控制更重要。
- 在进行 GPU 调优之前,你就需要使用明细账、预算、发票和团队治理。
当 API 侧工作负载需要一个密钥、一个余额、一个账单、用量记录,以及官方模型路由的访问权限时,Flatkey 很适合这一层。如果某个工作负载后来被证明足够稳定,适合专用 GPU 服务,那么请持续将自托管的 vLLM 端点与 AI model pricing comparison、AI API pricing comparison 以及你实测的每个可接受输出的 GPU 成本进行比较。
部署运行手册模板
在上线前先复制这份模板。
服务:
  负责人:
  值班:
  模型别名:
  提供服务的模型版本:
  vLLM 版本:
  容器镜像:
  GPU 类型和数量:
  基础 URL:

请求策略:
  最大模型长度:
  最大输出 token 数:
  最大并发数:
  队列超时:
  请求超时:
  认证方式:

可观测性:
  指标仪表盘:
  日志位置:
  Trace/请求 ID 字段:
  告警阈值:

发布:
  金丝雀比例:
  回滚镜像:
  回滚模型版本:
  备用路由:

成本:
  GPU 成本来源:
  存储/带宽假设:
  可接受输出分母:
  每周成本复盘负责人:
这份模板比完美的第一条命令更重要。无法交给值班人员的 vLLM 部署指南,仍然只是一个原型。
常见问题
如果我使用托管 GPU 端点,这还算是 vLLM 部署指南的内容吗?
算。只要 vLLM 是服务引擎,而你在决定如何暴露、扩展、观测和保护它,它就仍然属于 vLLM 部署指南。裸机虚拟机、RunPod Serverless、Ray Serve 和 Kubernetes 之间的运维细节不同,但验收测试相似:端点契约、延迟、错误、并发、回滚,以及可接受输出成本。
用于 vLLM 时,我应该选择 RunPod Serverless 还是持续运行的 GPU VM?
当突发流量处理和托管端点运维比始终热启动的延迟更重要时,使用 RunPod Serverless。当你需要可预测的热态性能、对主机的直接控制,或者更简单的调试路径时,使用持续运行的 GPU VM。如果延迟和利用率是决策因素,请对两者都做基准测试。
什么时候 Ray Serve 与 vLLM 搭配才合理?
当 vLLM 是更大服务应用的一部分时,Ray Serve 就很合理,尤其是你已经在运行 Ray 的情况下。如果一个模型只对应一个端点,直接使用 vLLM 提供服务可能更容易运维。
vLLM 能替代 OpenAI API 吗?
vLLM 可以为受支持的自托管模型暴露一个兼容 OpenAI 的接口,但这并不会让开源权重模型与专有前沿 API 完全相同。应将其视为端点契约和服务选项,然后针对你的工作负载验证模型质量、延迟和运维成本。
我应该先测量什么?
先测量可接受响应率、首 token 时间、p95 和 p99 延迟、超时率、GPU 内存压力,以及每个可接受输出的成本。原始的每秒 token 数有用,但不足以支撑生产决策。
Flatkey 与 vLLM 的关系是什么?
当你需要掌控 GPU 服务层时,用 vLLM。当你想要一个兼容 OpenAI 的模型 API 层、统一计费、用量记录,以及覆盖官方模型路由和工具的治理时,用 Flatkey。许多团队会同时使用两者:用 vLLM 承载稳定的自托管工作负载,用 Flatkey 承载前沿模型、回退、实验,以及 API 侧治理。
最终检查清单
上线前,你的 vLLM 部署指南 应该产出以下内容:
- 固定的模型版本和容器版本。
- 经过测试的兼容 OpenAI 的基础 URL。
- 认证和网络边界。
- 针对上下文、输出、超时和并发的请求限制。
- 关于延迟、错误、排队、吞吐量和 GPU 内存的指标。
- 回滚路径和之前已知可用的镜像。
- 每个可接受输出的成本工作表。
- 一份决策记录,说明为什么对于该工作负载,自托管 vLLM 优于托管模型 API。
如果这些内容都已存在,你就不只是运行 vLLM,而是在 GPU 上运营一个 LLM API。


