
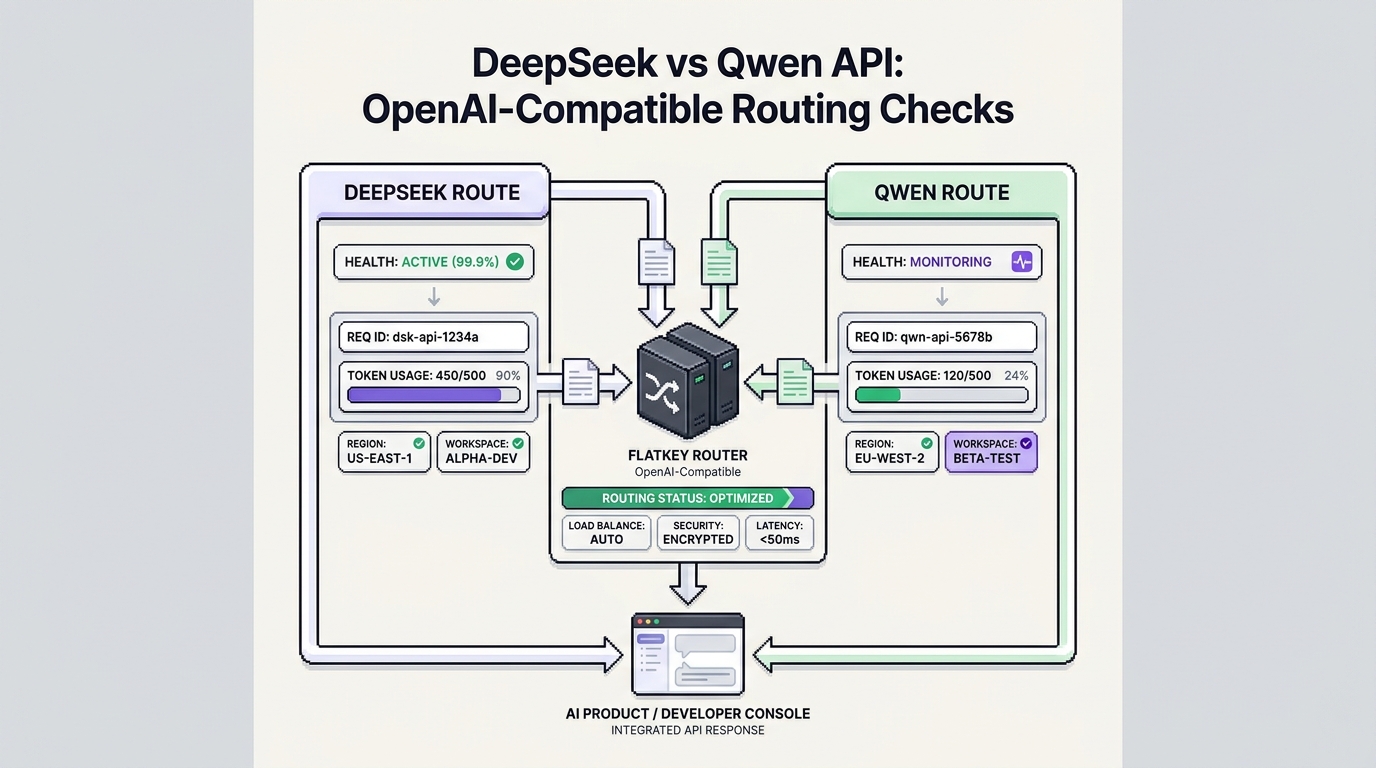
Die Frage DeepSeek vs Qwen API: OpenAI-Compatible Routing Checks ist nicht nur ein Modellvergleich. Für ein Produktionsteam ist sie eine Frage der Route-Bereitschaft: welche Endpunktfamilie Ihr Client aufruft, welchem Konto der Schlüssel gehört, welche Modell-ID aktuell ist, welche Funktionen sich so verhalten, wie Ihr Parser es erwartet, und wo Sie die Nutzung einsehen können, nachdem der Traffic umgestellt wurde.
Dieser Rahmen ist wichtig, weil beide Anbieter auf SDK-Ebene vertraut wirken können. DeepSeek dokumentiert eine OpenAI-kompatible API-Oberfläche mit https://api.deepseek.com als Base-URL im OpenAI-Format. Alibaba Cloud Model Studio dokumentiert OpenAI-kompativen Qwen-Zugriff, aber seine Base-URL kann von Region und Workspace abhängen. Wenn Sie Flatkey verwenden, kann Ihre Anwendung die OpenAI-SDK-Struktur beibehalten und auf https://router.flatkey.ai/v1 verweisen, aber Sie müssen dennoch die genaue DeepSeek- oder Qwen-Route prüfen, bevor Sie sie als produktionsreif einstufen.
Nutzen Sie diesen Leitfaden DeepSeek vs Qwen API: OpenAI-Compatible Routing Checks als praktische Checkliste, bevor Sie Workloads umstellen, Fallbacks hinzufügen oder ein gemeinsames Gateway standardisieren.
Kurzantwort: DeepSeek-vs-Qwen-API-Routing-Checks
| Routenwahl | Wann bevorzugen | Vor dem Start prüfen |
|---|---|---|
| Direkte DeepSeek-API | Sie benötigen DeepSeek-natives Verhalten, die aktuellen Modell-IDs von DeepSeek und einen fokussierten OpenAI-kompatiblen Endpunkt. | Base-URL, Modell-ID, Alias-Lebenszyklus, JSON-Ausgabe, Tool-Aufrufe, Streaming, Vision-Unterstützung, Kontextlänge, Parallelität, 429-Handling und Preiseinheiten. |
| Direkte Qwen-API über Model Studio | Sie arbeiten bereits innerhalb von Alibaba Cloud, benötigen Qwen-Modellfamilien oder müssen Region und Workspace-Setup direkt steuern. | Region-Endpunkt, workspace-spezifische Domain, regionsgebundener API-Schlüssel, ausgewählte Qwen-Familie, Tool-/Streaming-Kompatibilität, Token-Tiers, Cache-Regeln und Authentifizierungsfehler. |
| Flatkey-Gateway-Route | Sie möchten einen Schlüssel, eine OpenAI-kompatible Base-URL, gemeinsame Nutzungsübersicht und einfacheres Routing über mehrere Modellfamilien hinweg. | Aktuelle Flatkey-Modellzeile, Endpunktfamilie, Routenintegrität, Request-Log, Token-/Kostenfelder, Feature-Weiterleitung, Fallback-Richtlinie und Rollback-Route. |
Die praktische Antwort auf DeepSeek vs Qwen API: OpenAI-Compatible Routing Checks ist oft hybrid. Verwenden Sie direkte Anbieter-Routen, wenn Sie anbieterspezifische Kontrollen benötigen, die Sie über ein Gateway noch nicht verifiziert haben. Verwenden Sie Flatkey, wenn das größere operative Problem verstreute Anbieter-Schlüssel, fragmentierte Abrechnung und wiederholte SDK-Änderungen über Teams oder Agenten hinweg sind.
Anbieterfakten, die zuerst geprüft werden sollten
Beginnen Sie jede Prüfung DeepSeek vs Qwen API: OpenAI-Compatible Routing Checks mit der aktuellen Anbieterdokumentation, nicht mit einer alten Modellliste.
DeepSeek dokumentiert derzeit, dass seine API ein mit OpenAI und Anthropic kompatibles Format verwendet. In der Dokumentation für den ersten Aufruf werden https://api.deepseek.com für Aufrufe im OpenAI-Format und https://api.deepseek.com/anthropic für Aufrufe im Anthropic-Format aufgeführt. In der aktuellen Tabelle zu Modellen und Preisen sind deepseek-flash und deepseek-v4-pro als aktive Zeilen aufgeführt, zusammen mit Modellversionen, Funktionsunterstützung, Kontextlänge, maximaler Ausgabe und Parallelitätslimits auf derselben Seite.
Der Lifecycle-Hinweis von DeepSeek ist wichtig: Alte Namen wie deepseek-v4-flash und deepseek-v4-flash-vision-exp werden zwar weiterhin akzeptiert, aber DeepSeek sagt, dass diese ausgemusterten Namen vom neueren Flash-Modell bedient und zum Flash-Preis abgerechnet werden. Wenn Ihr Code, Ihre Gateway-Richtlinie oder Ihr Auswertungsblatt noch einen alten Alias verwendet, aktualisieren Sie die Routenprüfung, bevor Sie die Ausgaben vergleichen.
Qwen über Alibaba Cloud Model Studio beginnt mit einem anderen Vertrag. Model Studio sagt, dass Qwen-Modelle OpenAI-kompatible Schnittstellen unterstützen und dass bestehender OpenAI-Code durch Änderung von API-Schlüssel, Base URL und Modellname migriert werden kann. Die gleiche Dokumentation knüpft die Base URL jedoch an die Region und, für mehrere Regionen, an eine arbeitsbereichsspezifische Domain. Außerdem heißt es dort, dass ein Model-Studio-API-Schlüssel an die Region gebunden ist, in der er erstellt wurde; der Aufruf eines Endpunkts in einer anderen Region mit diesem Schlüssel kann einen HTTP-401-Authentifizierungsfehler zurückgeben.
Das ist der Kernunterschied. Bei DeepSeek lautet die erste Frage meist „welche aktuelle DeepSeek-Modell-ID und welcher Funktionsmodus?“. Bei Qwen lautet die erste Frage oft „welche Region, welche Workspace-Domain, welcher API-Schlüssel und welche Modellfamilie?“
OpenAI-kompatibel bedeutet nicht identisch
Der Ausdruck „OpenAI-kompatibel“ ist ein Migrationsbeschleuniger. Er ist kein Versprechen, dass jeder Endpunkt, jedes Feld, jeder Stream, jeder Fehler oder jeder Sonderfall bei Tool-Aufrufen identisch funktioniert.
| Prüfung | DeepSeek direkte Route | Qwen direkte Route | Flatkey-Route |
|---|---|---|---|
| Basis-URL | Die Base URL im OpenAI-Format ist https://api.deepseek.com. |
Die Base URL im Kompatibilitätsmodus variiert je nach Region und kann {WorkspaceId} enthalten. |
Die OpenAI-kompatible Base URL ist https://router.flatkey.ai/v1. |
| Chat-Endpunkt | Direkte cURL-Beispiele verwenden /chat/completions. |
Beispiele im Kompatibilitätsmodus verwenden /chat/completions. |
OpenAI-kompatibler Traffic verwendet /v1/chat/completions. |
| Modell-IDs | Die aktuellen Dokus konzentrieren sich auf deepseek-flash und deepseek-v4-pro; Legacy-Flash-Namen werden akzeptiert, aber weitergemappt. |
Die aktuellen Dokus zeigen Qwen-Zeilen wie qwen3.8-max, qwen3.7-plus und qwen3.8-flash, mit familienabhängigem Verhalten. |
Verwenden Sie die exakte Modell-ID, die im Flatkey-Modellverzeichnis oder in der Account-Route sichtbar ist. |
| Streaming | Testen Sie gestreamte Chunks, Leerlauf-Wartezeiten, Abbrüche und den abschließenden Usage-Umgang. | Model-Studio-Beispiele zeigen stream=True und stream_options={"include_usage": True}. |
Stellen Sie sicher, dass Ihr SDK-Parser Chunks und die finale Usage über das Gateway verarbeitet. |
| Tool-Aufrufe | DeepSeek dokumentiert Tool-Aufrufe als unterstützte Funktion für aktuelle Zeilen. | Model Studio dokumentiert Function Calling, weist aber auch darauf hin, dass tools nicht gleichzeitig mit stream=True im Abschnitt der OpenAI-kompatiblen Parameter verwendet werden kann. |
Führen Sie einen echten Tool-Call-Test durch, bevor ein Agent von der Route abhängt. |
| JSON-Ausgabe | DeepSeek listet die Unterstützung für JSON-Ausgabe bei aktuellen Zeilen auf. | Die kompatiblen Qwen-Parameter enthalten Hinweise zur Response-Formatierung und modellspezifische Support-Notizen. | Testen Sie das Schema-Parsing, das Verhalten bei ungültigem JSON und Fallbacks. |
| Vision/Audio | Die Tabelle von DeepSeek markiert Vision-Support für deepseek-flash und keinen für deepseek-v4-pro. |
Model Studio führt Qwen-VL und Qwen-Omni als unterstützte Modellfamilien auf, weist aber darauf hin, dass Qwen-Audio das OpenAI-kompatible Protokoll nicht unterstützt und stattdessen DashScope verwendet werden sollte. | Nehmen Sie nicht an, dass Multimodalität nach einem reinen Text-Chat-Test gleichwertig ist. |
| Kapazität/Fehler | DeepSeek dokumentiert gleichzeitige Verbindungen auf Kontoebene und HTTP 429 bei Überschreitung. | Qwen-Region-/Key-Mismatches können HTTP 401 zurückgeben; Quotas und Throttles sollten pro Region/Konto getestet werden. | Protokollieren Sie Provider-Klasse, Statuscode, Retry, Fallback-Grund, Latenz, Tokens und Kosten. |
Dies ist die zentrale Regel für DeepSeek vs Qwen API: OpenAI-kompatible Routing-Checks: Belegen Sie die Route, die Sie tatsächlich ausführen werden, nicht die, die ein Providernamen impliziert.
Preischecks, bevor Sie Routen vergleichen
Eine Route kann kompatibel sein und dennoch für die Workload finanziell falsch. Vergleichen Sie DeepSeek vs Qwen API: OpenAI-kompatible Routing-Checks nicht nur anhand einer Schlagzeile zu Input-Tokens.
Die aktuelle Preis-Dokumentation von DeepSeek rechnet in Einheiten von einer Million Tokens und trennt Input bei Cache-Treffer, Input bei Cache-Miss und Output-Tokens. Sie unterscheidet außerdem zwischen Peak- und Off-Peak-Tarifen und platziert Parallelitätsgrenzen neben den Modellzeilen. Die Dokumentation zu Ratenlimits sagt, dass die Parallelität auf Kontoebene berechnet wird und überschüssige Parallelität HTTP 429 zurückgibt. Dadurch ist eine Kostenprüfung bei DeepSeek nur dann unkompliziert, wenn Ihre Logs Input, Output, Cache-Verhalten, Anfragedauer und 429-Rate getrennt erfassen.
Model Studio sagt, dass Aufrufe der Modell-API standardmäßig nach Verbrauch abgerechnet werden, und dass das Preisdokument Standardpreise auflistet, während Promotions separat in der Konsole behandelt werden. Außerdem heißt es dort, dass einige Modelle eine gestaffelte Preisgestaltung auf Basis der Gesamtzahl der Input-Tokens in einer einzelnen Anfrage verwenden und dass Kontext-Cache- und Batch-Rabatte eigene Regeln haben. Das bedeutet, dass eine kurze Chat-Anfrage, eine 100K-Token-Retrieval-Anfrage, eine gecachte Anfrage mit wiederholtem Kontext und ein Batch-Job in unterschiedliche Qwen-Kostenkategorien fallen können.
Verwenden Sie diese Kosten-Normalisierungstabelle, bevor Sie eine Route freigeben:
| Kostenfeld | Warum es die Entscheidung verändert | Was zu protokollieren ist |
|---|---|---|
| Input-Tokens | Qwen-Tiers und DeepSeek-Input bei Cache-Miss können die effektiven Kosten verändern. | Prompt-Tokens, Input-Tier, Cache-Miss-Tokens, Modell-ID. |
| Gecachte Tokens | Cache-Rabatte helfen nur, wenn die Arbeitslast stabilen Kontext wiederholt und die Route Belege liefert. | Cache-Hit-Tokens, Cache-Write-Tokens, Cache-Richtlinie, Anfragenfamilie. |
| Output-Tokens | Lange Antworten sowie Reasoning-/Thinking-Ausgaben können die Rechnung dominieren. | Completion-Tokens, Reasoning-/Thinking-Tokens, falls zurückgegeben, Output-Limit. |
| Peak-/Off-Peak- oder Promotionsstatus | Veröffentlichte Anbieterseiten können Standardpreise von zeitbasierten oder Console-Promotions trennen. | Abrechnungszeitpunkt, Datum der Preisquelle, Route-Eigentümer. |
| Kosten für Retry/Fallback | Fehlgeschlagene Versuche und Fallback-Versuche können scheinbare Token-Einsparungen zunichtemachen. | Anzahl der Versuche, Grund für Retry, Fallback-Modell, Flag für akzeptierte Antwort. |
Für Flatkey gilt dieselbe Disziplin: Prüfen Sie das aktuelle Modellverzeichnis und die Preisseite und verifizieren Sie dann die Nutzung auf Anfragenebene in den Logs. Ein öffentlicher Modellhinweis ist hilfreich für die Entdeckung. Eine Produktionsentscheidung benötigt einen erfolgreichen Routentest und ein lesbares Abrechnungsprotokoll.
Flatkey-Routen-Checkliste
Flatkey verändert den Betriebsablauf rund um DeepSeek vs Qwen API: OpenAI-kompatible Routing-Checks. Es kann Teams ermöglichen, eine einzige OpenAI-kompatible Client-Oberfläche, einen einzigen Flatkey-Schlüssel und eine einzige Nutzungsauswertung über unterstützte Modelle und Tools hinweg beizubehalten. Der Flatkey-Quickstart zeigt den OpenAI-kompatiblen Anfragepfad, und der OpenAI-SDK-Guide zeigt das base_url-Setup. Flatkey sollte die anbieterspezifischen Anforderungen nicht verbergen.
Verwenden Sie diese Reihenfolge, bevor eine Flatkey-Route Produktionsverkehr erhält:
- Öffnen Sie das aktuelle Flatkey-Modellverzeichnis und suchen Sie nach der exakten DeepSeek- oder Qwen-Modell-ID.
- Bestätigen Sie, dass die Endpoint-Familie für die Workload geeignet ist, in der Regel eine OpenAI-kompatible Chat-API für diesen Artikel.
- Bestätigen Sie, dass das Modell im aktuellen Account-Route erscheint und nicht nur in einem alten Artikel oder Screenshot.
- Senden Sie eine einfache Chat-Anfrage über
https://router.flatkey.ai/v1/chat/completions. - Senden Sie dieselbe einfache Anfrage über die direkte Provider-Route, wenn Sie direkte Zugangsdaten haben.
- Wiederholen Sie den Test mit Streaming, einem Tool-Call, einem JSON-Output-Test, einem langen Kontextbeispiel und einem erzwungenen Fehler.
- Speichern Sie Request-ID, Provider-Klasse, Modell-ID, Statuscode, Latenz, Nutzungsfelder, Kostenfelder, Fallback-Grund, Schlüsselinhaber und Rollback-Modell.
Hier ist der minimale Flatkey-Smoke-Test:
curl -X POST "https://router.flatkey.ai/v1/chat/completions" \
  -H "Authorization: Bearer $FLATKEY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "your-verified-deepseek-or-qwen-model-id",
    "messages": [
      {
        "role": "user",
        "content": "Return one sentence confirming this route is alive."
      }
    ]
  }'
Wenn diese Anfrage mit model-not-found, unsupported endpoint, HTTP 401, HTTP 429, Timeout oder Parser-Fehler fehlschlägt, war der Test trotzdem hilfreich. Er zeigt Ihnen, dass Account, Modell-ID, Endpoint-Familie, Schlüsselbereich, Kontingent oder Anforderungsform vor echtem Traffic korrigiert werden müssen.
DeepSeek-Route-Checks
Verwenden Sie diese Checkliste, wenn DeepSeek die Kandidatenroute ist:
| Check | Erfolgsbedingung |
|---|---|
| Aktuelle Modell-ID | Die Route verwendet deepseek-flash oder deepseek-v4-pro, oder das Team hat das Mapping-Verhalten für den Legacy-Namen von DeepSeek ausdrücklich akzeptiert. |
| Endpoint-Familie | Die App verwendet die beabsichtigte DeepSeek-Endpoint-Familie: OpenAI-Format oder Anthropic-Format. |
| Funktionsunterstützung | JSON-Output, Tool-Calls, Responses API, Anthropic API, Beta-Prefix-Completion, FIM und Vision werden nur dort getestet, wo die Workload sie nutzt. |
| Thinking-/Non-Thinking-Verhalten | Der ausgewählte Modus ist für Auswertung und Logging ausreichend eindeutig. |
| Parallelität | Verhalten auf Account-Ebene hinsichtlich Parallelität und pro Benutzer-Isolierung ist verstanden; 429-Behandlung wird getestet. |
| Verhalten bei langen Anfragen | Timeout, Streaming, Keep-Alive und Max-Output-Verhalten werden mit realen Workload-Größen getestet. |
| Nutzung und Kosten | Input, Output, Cache Hit/Miss, Peak-/Off-Peak-Status, Retries und akzeptierte Antwort werden protokolliert. |
DeepSeek ist der klarere direkte Provider-Pfad, wenn Ihr Produkt DeepSeek-natives Verhalten möchte und die obigen Route-Checks bestehen. Es ist nicht automatisch sicherer, nur weil die Base-URL einfach ist.
Qwen-Route-Checks
Verwenden Sie diese Checkliste, wenn Qwen über Model Studio die Kandidatenroute ist:
| Prüfung | Bestehensbedingung |
|---|---|
| Region | Die zulässige Region der Workload entspricht dem Model-Studio-Endpunkt, den Sie aufrufen. |
| Workspace-Domain | {WorkspaceId} wird bei Bedarf durch die echte Workspace-ID ersetzt, und alte/globale Domains werden nicht blind übernommen. |
| API-Key-Lokalität | Der API-Schlüssel wurde in derselben Region wie der Endpunkt erstellt; Fehler durch Regionsabweichungen werden getrennt von Fehlern durch ungültige Schlüssel klassifiziert. |
| Modellfamilie | Die ausgewählte Qwen-Modellfamilie unterstützt die Anfrageform, die Kontextlänge und den Ausgabemodus, den Ihre App verwendet. |
| Tool- und Streaming-Verhalten | Function Calling und Streaming werden separat getestet, insbesondere weil Model Studio darauf hinweist, dass tools nicht gleichzeitig mit stream=True verwendet werden können. |
| Multimodales Protokoll | Qwen-VL, Qwen-Omni und Qwen-Audio werden nach Protokoll geprüft; Qwen-Audio wird nicht als OpenAI-kompatibler Chat-Route behandelt. |
| Preiseinheit | Eingabe-Token-Tier, Ausgabestokens, Kontext-Cache, Berechtigung für Batch-Rabatt und Promotionsstatus werden protokolliert. |
Qwen ist oft der stärkere direkte Weg, wenn das Team bereits auf Alibaba Cloud läuft oder das Regions-/Kontomodell von Model Studio benötigt. Es erfordert mehr Beleg für die Einrichtung, weil Region, Workspace und Key-Scope Teil des API-Vertrags sind.
Entscheidungsmatrix
Verwenden Sie diese Matrix, wenn ein Stakeholder nach einem Gewinner fragt.
| Entscheidungsbereich | DeepSeek API bevorzugen | Qwen API bevorzugen | Flatkey bevorzugen |
|---|---|---|---|
| Direkte Einrichtung | Sie möchten ein fokussiertes DeepSeek-Konto und die aktuelle DeepSeek-Modellfamilie. | Sie nutzen bereits Alibaba Cloud Model Studio. | Sie möchten eine einzige OpenAI-kompatible Basis-URL über mehrere Modellfamilien hinweg. |
| Regionale Kontrolle | Direkte DeepSeek-Kontrollen reichen für die Workload aus. | Region, Workspace und regionale API-Key-Besitzverhältnisse sind wichtig. | Sie möchten Richtlinien, Protokolle und geteilte Team-Verantwortung auf Gateway-Ebene. |
| Tool-/JSON-Verhalten | Die Tool-Aufrufe und die JSON-Ausgabe von DeepSeek bestehen Ihre Parser-Tests. | Qwen-Function-Calling und strukturierte Ausgabe bestehen Ihre Parser-Tests. | Dieselben Tests bestehen über den exakten Flatkey-Route. |
| Multimodales Routing | Sie benötigen nur die DeepSeek-Funktionen, die von der ausgewählten Zeile unterstützt werden. | Sie benötigen Qwen-VL, Qwen-Omni oder eine andere Model-Studio-Familie und haben deren Protokoll geprüft. | Sie möchten Text-, Bild-, Video- oder Tool-Routen in einer Betriebsschicht vergleichen. |
| Kapazität | Die Concurrent-Nutzung auf DeepSeek-Kontoebene passt zur Workload. | Die Quoten und die regionale Verfügbarkeit von Model Studio passen zur Workload. | Sie möchten eine beobachtbare Retry-/Fallback-Policy über Anbieter hinweg. |
| Finanzprüfung | DeepSeek-Cache-/Peak-/Ausgabeeinheiten lassen sich für die Workload leicht modellieren. | Qwen-Tiers, Cache, Batch und Console-Preise passen zur Workload. | Die Finanzabteilung benötigt eine einheitliche Nutzungsansicht und einen einheitlichen Billing-/Aufladeverlauf über alle Routen hinweg. |
Es gibt keinen universellen Gewinner bei DeepSeek vs Qwen API: OpenAI-Compatible Routing Checks. Entscheidend ist der Pfad, der zu Workload, Region, Parser, Kostenmodell und Betriebsvertrag passt.
Migrationsplan für Teams, die bereits produktiv sind
Führen Sie die Umstellung in Stufen durch, damit Modellqualität und Routing-Bereitschaft getrennt bleiben.
- Aktuellen Pfad als Basis festhalten: Speichern Sie Modell-IDs, Prompts, Parser-Erwartungen, Latenz, Token-Nutzung, Fehlerklassen, Kosten und Verantwortliche.
- Aktuelle Dokus erneut prüfen: Prüfen Sie die Seiten zu DeepSeek-Modell/Preisen, Erstaufruf, Funktionen und Rate Limits; prüfen Sie bei Qwen die Seiten zu OpenAI-Kompatibilität, Modell, Preisen und Funktionen.
- Direkte-Provider-Tests ausführen: Verwenden Sie dieselben Prompts und Parser gegen direktes DeepSeek und direktes Qwen, wenn Sie Zugangsdaten haben.
- Flatkey-Tests nach der Routing-Abfrage ausführen: Bestätigen Sie, dass das exakte Modell in Flatkey erscheint, und testen Sie dann über
https://router.flatkey.ai/v1. - Verhalten vergleichen, nicht nur Antworten: Prüfen Sie Chunks, Tool-Call-JSON, Gültigkeit der JSON-Ausgabe, Kontextfehler, 401/429-Verhalten, Timeout-Verhalten und Usage-Felder.
- Niedrigrisiko-Traffic zuerst umstellen: Beginnen Sie mit internen Tools, Eval-Jobs, Batch-Zusammenfassungen oder einem kleinen nicht kritischen Produktbereich.
- Nach der Rückprüfung hochstufen: Bezeichnen Sie die Migration erst dann als abgeschlossen, wenn Produkt, Plattform und Finance dieselben Routing-Nachweise prüfen können.
Dieser gestufte Plan verhindert einen häufigen Fehler: ein Modell zum Sieger zu erklären, während der Pfad selbst noch nicht verifiziert ist.
Häufige Fehler
| Fehler | Warum er schadet | Besserer Check |
|---|---|---|
| Alte DeepSeek-Aliase ohne Datumsprüfung verwenden | Alias-Zuordnungen können Verhaltensänderungen verdecken und Kostenprüfungen verwirren. | Prüfen Sie vor der Migration die aktuellen Modellnamen und das Verhalten alter Namen. |
| Alle Qwen-Endpunkte als einen Endpunkt behandeln | Region, Workspace-Domain und lokale API-Key-Zuordnung können entscheiden, ob der Aufruf funktioniert. | Dokumentieren Sie Endpunkt-Region, Workspace-ID und Schlüsselregion. |
| Nur einen Token-Preis vergleichen | Cache-Treffer, Cache-Miss, Ausgabelänge, Thinking Mode, Eingabetiers, Retries und Promotions verändern die echten Kosten. | Prüfen Sie die Kosten pro akzeptierter Antwort je Workload. |
| Tool-Parität annehmen | Form des Tool-Calls und Streaming-Verhalten können sich je nach Anbieter und Modell unterscheiden. | Testen Sie einen echten Tool-Call und einen Streaming-Lauf über jeden Pfad. |
| Einen Gateway-Pfad aus einem Kataloghinweis veröffentlichen | Öffentliche Katalogentdeckung ist nicht dasselbe wie die Pfad-Bereitschaft auf Kontoebene. | Führen Sie einen Live-Flatkey-Pfad-Test aus und speichern Sie den Request-Nachweis. |
Abschließende Empfehlung
Für DeepSeek vs Qwen API: OpenAI-Compatible Routing Checks beginnen Sie mit der Wahrheit des Providers und enden mit dem Routing-Nachweis.
Verwenden Sie DeepSeek direkt, wenn Ihr Workload zur aktuellen Modellfamilie von DeepSeek, zum OpenAI-kompatiblen Endpunkt, zum Funktionsumfang, zu den Preis-Einheiten und zum Parallelitätsverhalten passt. Verwenden Sie Qwen direkt, wenn Sie Model Studio's Qwen-Familien, regionale Endpunkte, Workspace-Domains oder Alibaba-Cloud-Kontrollen für das Konto benötigen. Verwenden Sie Flatkey, wenn das größere Problem ein einziger Key, eine einzige OpenAI-kompatible Base-URL, gemeinsame Usage-Nachweise, Quotenprüfung und einheitliche Abrechnung über Modelle hinweg ist.
Der nächste Schritt ist kein Slogan. Prüfen Sie die aktuellen Provider-Dokumentationen, sehen Sie in Flatkeys Modellverzeichnis und Preisseite nach, führen Sie die obigen Smoke-Tests aus und holen Sie sich dann einen Flatkey-Key, wenn Sie bereit sind, einen Workflow für DeepSeek vs Qwen API: OpenAI-kompatible Routing-Checks über ein einziges Gateway zu verifizieren. Für angrenzende Rollout-Arbeiten kombinieren Sie diese Checkliste mit dem Flatkey-API-Quickstart, dem Workflow der einheitlichen KI-API, dem Migrationsleitfaden für OpenAI-API-Alternativen, dem Routing regionaler LLM-Provider und den Metriken für AI-Routing-APIs.
FAQ
Ist DeepSeek vs Qwen API nur eine Entscheidung über die Modellqualität?
Nein. DeepSeek vs Qwen API: OpenAI-kompatible Routing-Checks umfassen auch Endpoint-Form, Modell-Aliase, Region, Workspace, API-Key-Lokalität, Token-Tiers, Cache-Verhalten, Tool-Aufrufe, JSON-Ausgabe, Verhalten des Streaming-Parsers, Rate Limits, Logs und Nachweise für die Abrechnung.
Welche API ist günstiger, DeepSeek oder Qwen?
Das hängt vom genauen Modell, der Prompt-Länge, der Ausgabelänge, dem Cache-Verhalten, dem Token-Tier, dem Thinking-Modus, Retries, der Route und dem Zeitpunkt der Abrechnung ab. Verwenden Sie die aktuellen offiziellen Preis-Seiten und Ihre tatsächlichen Nutzungsprotokolle, statt einen statischen Sieger zu übernehmen.
Kann ich mit beiden Providern ein OpenAI-SDK verwenden?
Ja. DeepSeek und Model Studio dokumentieren beide eine OpenAI-kompatible Nutzung, aber die Basis-URL, Modellnamen, zusätzlichen Parameter, Feature-Einschränkungen und die Kontoeinrichtung unterscheiden sich. Flatkey unterstützt das OpenAI-SDK-Muster außerdem über https://router.flatkey.ai/v1 für unterstützte Modelle.
Unterstützt Qwens OpenAI-kompatibler Route jedes Qwen-Modellfamilie?
Nein. Alibaba Cloud Model Studio gibt an, dass unterstützte OpenAI-kompatible Modelle die Qwen-Large-Language-Modelle, Qwen-VL, Qwen-Coder, Qwen-Omni, Qwen-Math, DeepSeek, Kimi, GLM und MiniMax umfassen, sagt aber separat, dass Qwen-Audio das OpenAI-kompatible Protokoll nicht unterstützt und stattdessen DashScope verwenden sollte.
Was ist der erste Flatkey-Test für das Routing von DeepSeek vs Qwen API?
Beginnen Sie mit einer einfachen Chat-Completion über https://router.flatkey.ai/v1 und prüfen Sie dann Modell-ID, Status, Usage-Felder, Preiseinheit, Streaming, Tool-Aufrufe, JSON-Ausgabe, Fehlerverhalten, Fallback und Rollback-Pfad.


