
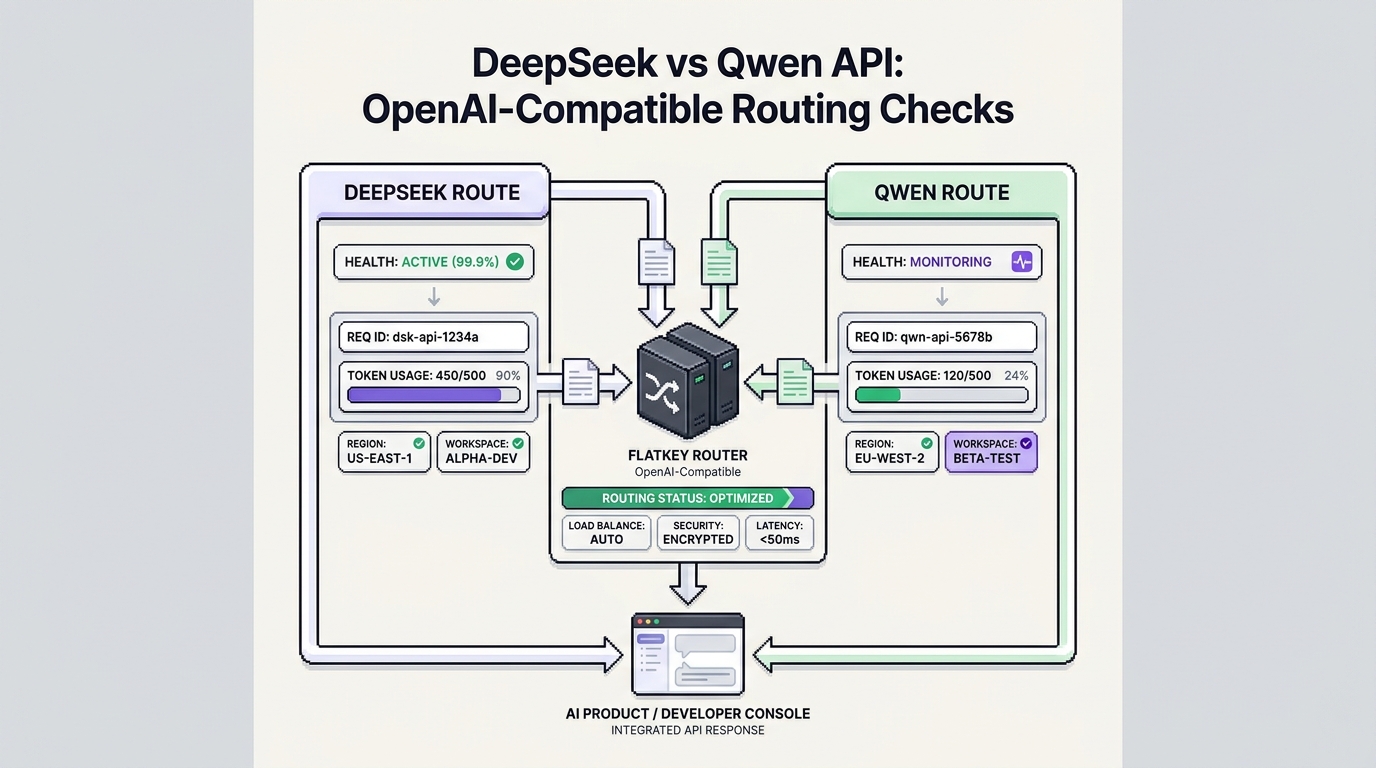
Câu hỏi DeepSeek vs Qwen API: Kiểm tra định tuyến tương thích OpenAI không chỉ là so sánh mô hình. Với một đội ngũ vận hành sản phẩm, đây là câu hỏi về mức độ sẵn sàng định tuyến: ứng dụng của bạn gọi họ endpoint nào, tài khoản nào sở hữu khóa, ID mô hình nào đang là hiện tại, những tính năng nào hoạt động đúng như bộ phân tích của bạn mong đợi, và bạn có thể xem mức sử dụng ở đâu sau khi lưu lượng được chuyển sang.
Cách đặt vấn đề này rất quan trọng vì cả hai nhà cung cấp đều có thể trông khá quen thuộc ở lớp SDK. DeepSeek tài liệu hóa giao diện API tương thích OpenAI với https://api.deepseek.com là base URL theo định dạng OpenAI. Alibaba Cloud Model Studio tài liệu hóa quyền truy cập Qwen tương thích OpenAI, nhưng base URL của nó có thể phụ thuộc vào khu vực và workspace. Nếu bạn dùng Flatkey, ứng dụng của bạn có thể giữ nguyên cấu trúc SDK OpenAI và trỏ tới https://router.flatkey.ai/v1, nhưng bạn vẫn cần xác minh chính xác tuyến DeepSeek hoặc Qwen trước khi coi nó là sẵn sàng cho production.
Hãy dùng hướng dẫn DeepSeek vs Qwen API: Kiểm tra định tuyến tương thích OpenAI này như một checklist thực tế trước khi bạn chuyển khối lượng công việc, thêm cơ chế dự phòng, hoặc chuẩn hóa một cổng gateway dùng chung.
Câu trả lời nhanh: Kiểm tra định tuyến API DeepSeek vs Qwen
| Lựa chọn tuyến | Nên chọn khi | Kiểm tra trước khi triển khai |
|---|---|---|
| API DeepSeek trực tiếp | Bạn cần hành vi gốc của DeepSeek, ID mô hình hiện tại của DeepSeek, và một endpoint tương thích OpenAI tập trung. | Base URL, ID mô hình, vòng đời alias, đầu ra JSON, gọi công cụ, streaming, hỗ trợ vision, độ dài ngữ cảnh, đồng thời, xử lý 429, và đơn vị giá. |
| API Qwen trực tiếp qua Model Studio | Bạn đã vận hành trong Alibaba Cloud, cần các họ mô hình Qwen, hoặc phải kiểm soát trực tiếp cấu hình khu vực và workspace. | Endpoint khu vực, domain theo workspace, API key gắn với khu vực, họ Qwen đã chọn, khả năng tương thích với công cụ/streaming, các bậc token, quy tắc cache, và lỗi xác thực. |
| Tuyến gateway Flatkey | Bạn muốn một khóa, một base URL tương thích OpenAI, xem xét mức sử dụng dùng chung, và định tuyến đơn giản hơn trên nhiều họ mô hình. | Dòng mô hình hiện tại trên Flatkey, họ endpoint, tình trạng hoạt động của tuyến, log yêu cầu, các trường token/chi phí, chuyển tiếp tính năng, chính sách fallback, và tuyến rollback. |
Câu trả lời thực tế cho DeepSeek vs Qwen API: Kiểm tra định tuyến tương thích OpenAI thường là mô hình lai. Hãy dùng tuyến nhà cung cấp trực tiếp khi bạn cần các điều khiển đặc thù của nhà cung cấp mà bạn chưa chứng minh được thông qua gateway. Hãy dùng Flatkey khi vấn đề vận hành lớn hơn là khóa nhà cung cấp bị phân tán, thanh toán bị phân mảnh, và phải thay đổi SDK lặp đi lặp lại giữa các nhóm hoặc agent.
Các thông tin nhà cung cấp cần kiểm tra trước tiên
Hãy bắt đầu mọi lần rà soát DeepSeek vs Qwen API: Kiểm tra định tuyến tương thích OpenAI bằng tài liệu hiện tại của nhà cung cấp, không phải danh sách mô hình cũ.
DeepSeek hiện tại ghi nhận rằng API của họ sử dụng định dạng tương thích với OpenAI và Anthropic. Tài liệu gọi đầu tiên của họ liệt kê https://api.deepseek.com cho các lệnh gọi theo định dạng OpenAI và https://api.deepseek.com/anthropic cho các lệnh gọi theo định dạng Anthropic. Bảng mô hình và giá hiện tại của họ liệt kê deepseek-flash và deepseek-v4-pro là các dòng đang hoạt động, cùng với phiên bản mô hình, hỗ trợ tính năng, độ dài ngữ cảnh, đầu ra tối đa và giới hạn đồng thời trên cùng một trang.
Lưu ý về vòng đời của DeepSeek rất quan trọng: các tên cũ như deepseek-v4-flash và deepseek-v4-flash-vision-exp vẫn được chấp nhận, nhưng DeepSeek cho biết các tên đã ngừng này được phục vụ bởi mô hình Flash mới hơn và được tính phí theo giá Flash. Nếu mã, chính sách gateway hoặc bảng đánh giá của bạn vẫn dùng bí danh cũ, hãy cập nhật kiểm tra định tuyến trước khi bạn so sánh đầu ra.
Qwen thông qua Alibaba Cloud Model Studio bắt đầu từ một hợp đồng khác. Model Studio cho biết các mô hình Qwen hỗ trợ giao diện tương thích OpenAI và rằng mã OpenAI hiện có có thể chuyển sang bằng cách thay đổi API key, base URL và tên mô hình. Nhưng cùng tài liệu đó lại gắn base URL với khu vực và, đối với một số khu vực, với miền riêng theo workspace. Tài liệu cũng cho biết API key của Model Studio được ràng buộc với khu vực nơi nó được tạo; gọi endpoint của khu vực khác bằng key đó có thể trả về lỗi xác thực HTTP 401.
Đó là khác biệt cốt lõi. Với DeepSeek, câu hỏi đầu tiên thường là "đâu là ID mô hình DeepSeek hiện tại và chế độ tính năng nào?" Với Qwen, câu hỏi đầu tiên thường là "khu vực nào, miền workspace nào, API key nào và họ mô hình nào?"
Tương thích OpenAI không có nghĩa là giống hệt
Cụm từ "OpenAI-compatible" là một chất xúc tác cho việc di chuyển. Nó không phải là lời hứa rằng mọi endpoint, trường dữ liệu, luồng stream, lỗi hay trường hợp biên khi gọi công cụ đều hoạt động giống hệt nhau.
| Kiểm tra | Tuyến trực tiếp DeepSeek | Tuyến trực tiếp Qwen | Tuyến Flatkey |
|---|---|---|---|
| Base URL | Base URL theo định dạng OpenAI là https://api.deepseek.com. |
Base URL ở chế độ tương thích thay đổi theo khu vực và có thể bao gồm {WorkspaceId}. |
Base URL tương thích OpenAI là https://router.flatkey.ai/v1. |
| Chat endpoint | Các ví dụ cURL trực tiếp dùng /chat/completions. |
Các ví dụ ở chế độ tương thích dùng /chat/completions. |
Lưu lượng tương thích OpenAI dùng /v1/chat/completions. |
| Model IDs | Tài liệu hiện tại tập trung vào deepseek-flash và deepseek-v4-pro; các tên Flash cũ vẫn được chấp nhận nhưng sẽ được ánh xạ về phía trước. |
Tài liệu hiện tại hiển thị các dòng Qwen như qwen3.8-max, qwen3.7-plus, và qwen3.8-flash, với hành vi riêng theo từng họ model. |
Hãy dùng đúng ID model hiển thị trong thư mục model của Flatkey hoặc route của tài khoản. |
| Streaming | Kiểm thử các chunk được stream, thời gian chờ khi idle, hủy yêu cầu, và xử lý usage cuối cùng. | Các ví dụ Model Studio hiển thị stream=True và stream_options={"include_usage": True}. |
Xác nhận parser của SDK xử lý được các chunk và usage cuối qua gateway. |
| Tool calls | DeepSeek ghi nhận tool calls là một tính năng được hỗ trợ cho các dòng hiện tại. | Model Studio ghi nhận function calling, nhưng cũng lưu ý rằng tools không thể được dùng đồng thời với stream=True trong phần tham số tương thích OpenAI. |
Hãy chạy một bài kiểm thử tool call thực tế trước khi một agent phụ thuộc vào route này. |
| JSON output | DeepSeek liệt kê hỗ trợ xuất JSON cho các dòng hiện tại. | Tham số tương thích Qwen bao gồm định dạng phản hồi và các lưu ý hỗ trợ theo từng model. | Kiểm thử phân tích schema, hành vi JSON không hợp lệ, và cơ chế fallback. |
| Vision/audio | Bảng của DeepSeek đánh dấu hỗ trợ vision cho deepseek-flash và không hỗ trợ cho deepseek-v4-pro. |
Model Studio liệt kê Qwen-VL và Qwen-Omni là các họ model được hỗ trợ, nhưng cho biết Qwen-Audio không hỗ trợ giao thức tương thích OpenAI và nên dùng DashScope. | Đừng mặc định suy ra sự tương đương đa phương thức chỉ từ một lượt chat văn bản. |
| Capacity/errors | DeepSeek ghi nhận concurrency ở cấp tài khoản và HTTP 429 khi vượt quá giới hạn. | Lệch khu vực/key của Qwen có thể trả về HTTP 401; quota và throttle nên được kiểm thử theo từng khu vực/tài khoản. | Ghi log loại nhà cung cấp, mã trạng thái, retry, lý do fallback, độ trễ, số token, và chi phí. |
Đây là quy tắc trọng tâm của DeepSeek vs Qwen API: OpenAI-Compatible Routing Checks: hãy chứng minh route mà bạn sẽ thực sự chạy, chứ không phải route được ngụ ý bởi tên nhà cung cấp.
Kiểm tra giá trước khi bạn so sánh các route
Một route có thể tương thích nhưng vẫn sai về mặt chi phí đối với workload. Đừng so sánh DeepSeek vs Qwen API: OpenAI-Compatible Routing Checks chỉ bằng một tiêu đề token đầu vào.
Tài liệu giá hiện tại của DeepSeek tính phí theo đơn vị một triệu token và tách riêng token đầu vào trúng cache, token đầu vào không trúng cache và token đầu ra. Tài liệu này cũng phân biệt mức giá giờ cao điểm và ngoài giờ cao điểm, đồng thời đặt giới hạn đồng thời cạnh các hàng mô hình. Tài liệu giới hạn tốc độ của họ cho biết concurrency được tính ở cấp tài khoản và khi vượt quá concurrency sẽ trả về HTTP 429. Điều đó khiến việc rà soát chi phí của DeepSeek chỉ thực sự đơn giản nếu log của bạn tách riêng đầu vào, đầu ra, hành vi cache, thời lượng yêu cầu và tỷ lệ 429.
Model Studio cho biết các cuộc gọi API mô hình mặc định là trả tiền theo mức sử dụng và tài liệu giá của họ liệt kê giá chuẩn, còn các chương trình khuyến mãi được xử lý riêng trong console. Tài liệu cũng nêu rằng một số mô hình dùng giá theo bậc dựa trên tổng số token đầu vào trong một yêu cầu duy nhất, và rằng cache ngữ cảnh cùng chiết khấu batch có quy tắc riêng. Điều đó có nghĩa là một yêu cầu chat ngắn, một yêu cầu truy xuất 100K token, một yêu cầu lặp lại ngữ cảnh đã được cache và một job batch có thể thuộc các nhóm chi phí Qwen khác nhau.
Hãy dùng bảng chuẩn hóa chi phí này trước khi đưa một tuyến vào sản xuất:
| Trường chi phí | Vì sao nó làm thay đổi quyết định | Những gì cần ghi log |
|---|---|---|
| Token đầu vào | Các bậc của Qwen và token đầu vào không trúng cache của DeepSeek có thể làm thay đổi chi phí thực tế. | Token prompt, bậc đầu vào, token không trúng cache, ID mô hình. |
| Token đã cache | Chiết khấu cache chỉ có ích khi khối lượng công việc lặp lại ngữ cảnh ổn định và tuyến đường cung cấp được bằng chứng. | Token trúng cache, token ghi cache, chính sách cache, họ yêu cầu. |
| Token đầu ra | Câu trả lời dài và token suy luận/suy nghĩ có thể chiếm phần lớn hóa đơn. | Token hoàn thành, token suy luận/suy nghĩ nếu được trả về, giới hạn đầu ra. |
| Trạng thái giờ cao điểm/ngoài giờ cao điểm hoặc khuyến mãi | Các trang công khai của nhà cung cấp có thể tách giá chuẩn khỏi các chương trình khuyến mãi theo thời gian hoặc trong console. | Thời điểm tính phí, ngày nguồn giá, chủ sở hữu tuyến. |
| Chi phí thử lại/dự phòng | Các lần thử thất bại và các lần dự phòng có thể xóa sạch khoản tiết kiệm token nhìn thấy được. | Số lần thử, lý do thử lại, mô hình dự phòng, cờ phản hồi được chấp nhận. |
Đối với Flatkey, hãy giữ cùng kỷ luật: kiểm tra thư mục mô hình và trang giá hiện tại, rồi xác minh mức sử dụng ở cấp yêu cầu trong log. Một đề cập mô hình công khai hữu ích cho việc khám phá. Một quyết định sản xuất cần một bài kiểm tra tuyến thành công và một sổ cái dễ đọc.
Danh sách kiểm tra tuyến Flatkey
Flatkey thay đổi quy trình vận hành xoay quanh DeepSeek vs Qwen API: Kiểm tra định tuyến tương thích OpenAI. Nó có thể cho phép các nhóm giữ một bề mặt client tương thích OpenAI, một khóa Flatkey và một lớp rà soát mức sử dụng duy nhất trên các mô hình và công cụ được hỗ trợ. Hướng dẫn nhanh của Flatkey cho thấy đường dẫn yêu cầu tương thích OpenAI, và hướng dẫn OpenAI SDK cho thấy thiết lập base_url. Flatkey không nên che giấu các yêu cầu đặc thù của từng nhà cung cấp.
Hãy dùng trình tự này trước khi một tuyến Flatkey nhận lưu lượng sản xuất:
- Mở thư mục model Flatkey hiện tại và tìm đúng model ID DeepSeek hoặc Qwen.
- Xác nhận họ endpoint phù hợp với khối lượng công việc, thường là chat tương thích OpenAI cho bài viết này.
- Xác nhận model xuất hiện trong route của tài khoản hiện tại, không chỉ trong một bài viết cũ hoặc ảnh chụp màn hình.
- Gửi một yêu cầu chat thuần túy qua
https://router.flatkey.ai/v1/chat/completions. - Gửi cùng một yêu cầu thuần túy qua route nhà cung cấp trực tiếp khi bạn có thông tin xác thực trực tiếp.
- Lặp lại với streaming, một lệnh gọi tool, một bài kiểm tra đầu ra JSON, một mẫu long-context và một lỗi cưỡng bức.
- Lưu request ID, provider class, model ID, status code, latency, usage fields, cost fields, fallback reason, key owner, và rollback model.
Đây là bài smoke test tối thiểu của Flatkey:
curl -X POST "https://router.flatkey.ai/v1/chat/completions" \
  -H "Authorization: Bearer $FLATKEY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "your-verified-deepseek-or-qwen-model-id",
    "messages": [
      {
        "role": "user",
        "content": "Return one sentence confirming this route is alive."
      }
    ]
  }'
Nếu yêu cầu đó thất bại với model-not-found, unsupported endpoint, HTTP 401, HTTP 429, timeout, hoặc parser failure, thì bài kiểm tra vẫn có ích. Nó cho bạn biết tài khoản, model ID, họ endpoint, phạm vi key, quota, hoặc dạng yêu cầu cần được chỉnh sửa trước khi lưu lượng thực chạy qua.
Kiểm tra tuyến DeepSeek
Sử dụng checklist này khi DeepSeek là route ứng viên:
| Check | Pass condition |
|---|---|
| Current model ID | Route sử dụng deepseek-flash hoặc deepseek-v4-pro, hoặc đội ngũ đã chấp nhận rõ ràng hành vi ánh xạ tên cũ của DeepSeek. |
| Endpoint family | Ứng dụng gọi đúng họ endpoint DeepSeek dự kiến: định dạng OpenAI hoặc định dạng Anthropic. |
| Feature support | JSON output, tool calls, Responses API, Anthropic API, beta prefix completion, FIM, và vision chỉ được kiểm tra ở nơi khối lượng công việc sử dụng chúng. |
| Thinking/non-thinking behavior | Chế độ được chọn đủ rõ ràng cho việc đánh giá và logging. |
| Concurrency | Hành vi đồng thời ở cấp tài khoản và cô lập theo người dùng được hiểu rõ; kiểm tra xử lý 429. |
| Long request behavior | Timeout, streaming, keep-alive, và hành vi max-output được kiểm tra với kích thước khối lượng công việc thực tế. |
| Usage and cost | Input, output, cache hit/miss, trạng thái peak/off-peak, retries, và accepted response được ghi log. |
DeepSeek là đường đi trực tiếp sạch hơn khi sản phẩm của bạn muốn hành vi native của DeepSeek và các kiểm tra route ở trên đều đạt. Nó không tự động an toàn hơn chỉ vì base URL đơn giản.
Kiểm tra tuyến Qwen
Sử dụng checklist này khi Qwen qua Model Studio là route ứng viên:
| Kiểm tra | Điều kiện đạt |
|---|---|
| Khu vực | Khu vực được phép của workload khớp với endpoint Model Studio mà bạn gọi. |
| Miền workspace | {WorkspaceId} được thay bằng ID workspace thực tế khi cần, và các miền cũ/toàn cục không được chuyển tiếp một cách máy móc. |
| Tính cục bộ của API key | API key được tạo ở cùng khu vực với endpoint; lỗi do không khớp khu vực được phân loại riêng với lỗi do key không hợp lệ. |
| Dòng model | Dòng model Qwen đã chọn hỗ trợ dạng yêu cầu, độ dài ngữ cảnh và chế độ đầu ra mà ứng dụng của bạn sử dụng. |
| Hành vi công cụ và streaming | Gọi hàm và streaming được kiểm thử riêng, đặc biệt vì Model Studio lưu ý rằng tools không thể dùng đồng thời với stream=True. |
| Giao thức đa phương thức | Qwen-VL, Qwen-Omni và Qwen-Audio được kiểm tra theo giao thức; Qwen-Audio không được xem là một tuyến chat tương thích OpenAI. |
| Đơn vị tính giá | Bậc token đầu vào, token đầu ra, cache ngữ cảnh, điều kiện đủ điều kiện giảm giá batch và trạng thái khuyến mãi đều được ghi lại. |
Qwen thường là tuyến trực tiếp mạnh hơn khi nhóm đã chạy trên Alibaba Cloud hoặc cần mô hình khu vực/tài khoản của Model Studio. Nó cần nhiều bằng chứng thiết lập hơn vì khu vực, workspace và phạm vi của key là một phần của hợp đồng API.
Ma trận quyết định
Sử dụng ma trận này khi một bên liên quan hỏi đâu là lựa chọn tốt hơn.
| Hạng mục quyết định | Ưu tiên DeepSeek API | Ưu tiên Qwen API | Ưu tiên Flatkey |
|---|---|---|---|
| Thiết lập trực tiếp | Bạn muốn một tài khoản DeepSeek tập trung và dòng model DeepSeek hiện tại. | Bạn đã dùng Alibaba Cloud Model Studio. | Bạn muốn một base URL tương thích OpenAI cho nhiều dòng model. |
| Kiểm soát theo khu vực | Kiểm soát ở cấp tài khoản DeepSeek là đủ cho workload. | Khu vực, workspace và quyền sở hữu API key theo khu vực là quan trọng. | Bạn muốn chính sách, nhật ký và quyền sở hữu chung của nhóm ở cấp gateway. |
| Hành vi công cụ/JSON | Lệnh gọi công cụ và đầu ra JSON của DeepSeek vượt qua các bài kiểm thử parser của bạn. | Gọi hàm và đầu ra có cấu trúc của Qwen vượt qua các bài kiểm thử parser của bạn. | Các bài kiểm thử tương tự đi qua đúng tuyến Flatkey. |
| Định tuyến đa phương thức | Bạn chỉ cần các tính năng DeepSeek được hỗ trợ bởi hàng đã chọn. | Bạn cần Qwen-VL, Qwen-Omni hoặc một dòng Model Studio khác và đã kiểm tra giao thức của nó. | Bạn muốn so sánh tuyến văn bản, hình ảnh, video hoặc công cụ trong một lớp vận hành. |
| Năng lực | Mức đồng thời ở cấp tài khoản DeepSeek phù hợp với workload. | Hạn ngạch Model Studio và tình trạng khu vực phù hợp với workload. | Bạn muốn chính sách retry/fallback có thể quan sát được giữa các nhà cung cấp. |
| Rà soát tài chính | Các đơn vị cache/peak/output của DeepSeek dễ mô hình hóa cho workload. | Các bậc giá, cache, batch và giá trên console của Qwen phù hợp với workload. | Bộ phận tài chính cần một chế độ xem sử dụng và một dấu vết thanh toán/nạp tiền duy nhất trên mọi tuyến. |
Không có một “người thắng” chung cho DeepSeek vs Qwen API: Kiểm tra định tuyến tương thích OpenAI. Có một tuyến phù hợp với khối lượng công việc, khu vực, bộ phân tích cú pháp, mô hình chi phí và hợp đồng vận hành.
Kế hoạch di chuyển cho các đội đã triển khai
Di chuyển theo từng giai đoạn để chất lượng mô hình và mức độ sẵn sàng của tuyến được tách biệt.
- Thiết lập đường cơ sở cho tuyến hiện tại: Lưu model ID, prompt, kỳ vọng của bộ phân tích cú pháp, độ trễ, mức sử dụng token, lớp lỗi, chi phí và người phụ trách.
- Mở lại tài liệu hiện tại: Kiểm tra các trang DeepSeek về model/giá, first-call, tính năng và giới hạn tốc độ; kiểm tra các trang Qwen tương thích OpenAI, model, giá và tính năng.
- Chạy kiểm thử trực tiếp với nhà cung cấp: Dùng cùng prompt và bộ phân tích cú pháp với DeepSeek trực tiếp và Qwen trực tiếp nếu bạn có thông tin xác thực.
- Chạy kiểm thử Flatkey sau khi tra cứu tuyến: Xác nhận model chính xác có xuất hiện trong Flatkey, rồi kiểm thử qua
https://router.flatkey.ai/v1. - So sánh hành vi, không chỉ câu trả lời: Xem lại các chunk, JSON gọi công cụ, tính hợp lệ của đầu ra JSON, lỗi ngữ cảnh, hành vi 401/429, hành vi timeout và các trường usage.
- Chuyển lưu lượng ít rủi ro trước: Bắt đầu với công cụ nội bộ, job đánh giá, tóm tắt theo lô hoặc một phần nhỏ không quan trọng của sản phẩm.
- Triển khai rộng sau khi đối chiếu lại: Đừng coi việc di chuyển là hoàn tất cho đến khi sản phẩm, nền tảng và tài chính đều có thể kiểm tra cùng một bằng chứng về tuyến.
Kế hoạch theo giai đoạn này ngăn một lỗi phổ biến: tuyên bố một model là kẻ thắng trong khi chính tuyến vẫn chưa được kiểm chứng.
Các lỗi thường gặp
| Lỗi | Vì sao gây hại | Kiểm tra tốt hơn |
|---|---|---|
| Dùng các alias DeepSeek cũ mà không kiểm tra ngày | Ánh xạ alias có thể che giấu thay đổi hành vi và làm rối việc xem xét chi phí. | Xác minh tên model hiện tại và hành vi của tên cũ trước khi di chuyển. |
| Coi mọi endpoint Qwen là một endpoint | Khu vực, domain workspace và vị trí của API key có thể quyết định việc cuộc gọi có hoạt động hay không. | Ghi lại khu vực endpoint, workspace ID và khu vực của key. |
| So sánh một mức giá token | Tỷ lệ cache hit, cache miss, độ dài đầu ra, chế độ thinking, các bậc đầu vào, retry và khuyến mãi đều làm thay đổi chi phí thực. | Xem xét chi phí trên mỗi phản hồi được chấp nhận theo từng khối lượng công việc. |
| Giả định tính tương đương của công cụ | Dạng của tool-call và hành vi streaming có thể khác nhau theo nhà cung cấp và model. | Kiểm thử một lần gọi công cụ thực tế và một lần chạy streaming qua từng tuyến. |
| Công bố một tuyến gateway chỉ từ một đề cập trong catalog | Khám phá từ catalog công khai không giống với mức độ sẵn sàng của tuyến ở cấp tài khoản. | Chạy kiểm thử tuyến Flatkey trực tiếp và lưu bằng chứng request. |
Khuyến nghị cuối cùng
Đối với DeepSeek vs Qwen API: Kiểm tra định tuyến tương thích OpenAI, hãy bắt đầu từ sự thật của nhà cung cấp và kết thúc bằng bằng chứng về tuyến.
Dùng DeepSeek trực tiếp khi khối lượng công việc của bạn phù hợp với họ model hiện tại của DeepSeek, endpoint tương thích OpenAI, bộ tính năng, đơn vị giá và hành vi đồng thời. Dùng Qwen trực tiếp khi bạn cần các họ Qwen của Model Studio, endpoint theo khu vực, domain workspace hoặc các kiểm soát tài khoản của Alibaba Cloud. Dùng Flatkey khi vấn đề lớn hơn là một key, một base URL tương thích OpenAI, bằng chứng sử dụng chung, xem xét hạn ngạch và hóa đơn hợp nhất trên nhiều model.
Bước tiếp theo không phải là một khẩu hiệu. Hãy kiểm tra tài liệu của nhà cung cấp hiện tại, kiểm tra thư mục mô hình và trang giá của Flatkey, chạy các bài kiểm tra smoke ở trên, rồi lấy một key Flatkey khi bạn sẵn sàng xác minh quy trình DeepSeek vs Qwen API: Kiểm tra định tuyến tương thích OpenAI thông qua một cổng duy nhất. Với các công việc triển khai liên quan, hãy ghép danh sách kiểm tra này với quickstart Flatkey API, quy trình unified AI API, hướng dẫn di chuyển sang giải pháp thay thế OpenAI API, định tuyến nhà cung cấp LLM theo khu vực, và các chỉ số API định tuyến AI.
Câu hỏi thường gặp
DeepSeek vs Qwen API chỉ là một quyết định về chất lượng mô hình thôi sao?
Không. DeepSeek vs Qwen API: Kiểm tra định tuyến tương thích OpenAI còn bao gồm dạng endpoint, bí danh mô hình, khu vực, workspace, vị trí địa lý của API key, các tầng token, hành vi cache, lời gọi công cụ, đầu ra JSON, hành vi trình phân tích luồng, giới hạn tốc độ, log và bằng chứng thanh toán.
API nào rẻ hơn, DeepSeek hay Qwen?
Điều đó phụ thuộc vào mô hình cụ thể, độ dài prompt, độ dài đầu ra, hành vi cache, tầng token, chế độ suy luận, lần thử lại, tuyến định tuyến và thời điểm tính phí. Hãy dùng các trang giá chính thức hiện tại và log sử dụng thực tế của bạn thay vì sao chép một “người thắng” cố định.
Tôi có thể dùng SDK OpenAI với cả hai nhà cung cấp không?
Có. DeepSeek và Model Studio đều ghi nhận cách dùng tương thích OpenAI, nhưng base URL, tên mô hình, tham số bổ sung, các lưu ý về tính năng và thiết lập tài khoản là khác nhau. Flatkey cũng hỗ trợ mẫu SDK OpenAI thông qua https://router.flatkey.ai/v1 cho các mô hình được hỗ trợ.
Đường dẫn tương thích OpenAI của Qwen có hỗ trợ mọi họ mô hình Qwen không?
Không. Alibaba Cloud Model Studio cho biết các mô hình tương thích OpenAI được hỗ trợ bao gồm các mô hình ngôn ngữ lớn Qwen, Qwen-VL, Qwen-Coder, Qwen-Omni, Qwen-Math, DeepSeek, Kimi, GLM và MiniMax, nhưng cũng nêu riêng rằng Qwen-Audio không hỗ trợ giao thức tương thích OpenAI và nên dùng DashScope thay thế.
Kiểm tra đầu tiên của Flatkey cho định tuyến DeepSeek vs Qwen API là gì?
Bắt đầu bằng một lần hoàn tất chat đơn giản qua https://router.flatkey.ai/v1, sau đó xác minh ID mô hình, trạng thái, các trường usage, đơn vị giá, streaming, lời gọi công cụ, đầu ra JSON, hành vi lỗi, fallback và đường dẫn rollback.


